Para agentes con contexto largo, Neon en high ofrece aquí la mejor relación calidad-precio cuando importa reducir las respuestas erróneas; Astra y Sol siguen siendo más baratos por tarea. Este análisis del día de lanzamiento reúne especificaciones oficiales, clasificaciones y pruebas independientes. No he probado Neon personalmente.
Neon apunta a agentes: más rápido que Carbon, con una concesión clara
Google presentó Gemini 4 Neon el 18 de noviembre de 2026 bajo el identificador gemini-4-neon. Según Google y 9to5Google, es el modelo intermedio de la familia Gemini 4, situado entre Hydrogen y Carbon. Google asegura que completa los trabajos de extremo a extremo más rápido que Carbon y con menor coste por tarea; miembros de DeepMind también lo describen como más barato y veloz que Carbon (@_mohansolo). Alcanza el puesto #3 del Artificial Analysis Index, con 61 en xhigh, y el #2 de Agent Arena, con 1336 puntos en más de 4.200 sesiones. Los materiales de lanzamiento consultados no publican resultados de Opus 5.5 y Fable 5.2 en ese mismo tablero, así que la comparación directa se apoya en rangos de índices y pruebas con las mismas tareas.
Precio, contexto y disponibilidad
Neon cuesta $3 por millón de tokens de entrada, $15 de salida y $0.15 por entrada en caché, según Google. Su ventana de contexto es de 1,048,576 tokens y cada respuesta está limitada a 65,536 tokens. Los niveles de razonamiento low, medium, high (el predeterminado) y xhigh se facturan como salida: los niveles superiores pueden gastar más tokens de razonamiento y elevar la factura. El valor predeterminado high figura en el desglose de niveles de DataCamp y en las notas sobre la API de SpringPrompt.
Es de pago y no incluye nivel gratuito, según la comprobación de API de eesel. De acuerdo con Google y 9to5Google, está disponible mediante API de pago en AI Studio, Gemini for business, Antigravity (Pro/Ultra), la app Gemini (Pro/Ultra, sustituye a Argon) y Android Studio; también en Cursor, donde logra un 63.7% en CursorBench con el esfuerzo predeterminado frente al 57.3% de Hydrogen, según Cursor.
| Modelo | Entrada / salida por 1M | Razonamiento predeterminado |
|---|---|---|
| Gemini 4 Neon | $3 / $15, caché $0.15 | high |
| Gemini 4 Hydrogen | $1.50 / $7.50 | high |
| Gemini 4 Carbon | $2 / $10 hasta el 30 de noviembre; después $4 / $20 | medium |
| Claude Opus 5.5 | $4 / $20, configuración máxima probada | máximo probado |
| GPT-6.2 Sol | $2 / $10, configuración máxima probada | máximo probado |
Los precios de los rivales y las etiquetas de mejor configuración proceden de la tabla comparativa de eesel. A partir del 1 de diciembre, Neon será un 25% más barato por token que Carbon. Más detalles: precios de Neon.
La API permite fijar el nivel de razonamiento; para cuota gestionada, usa la app o Antigravity. Los informes sobre cuotas son solo señales anecdóticas para planificar: alrededor del 1–3% de la cuota Pro por chat, frente a cerca del 5% en una ejecución de 10 minutos con 3 subagentes, según reportes de usuarios.
Benchmarks frente a Opus 5.5, Fable 5.2 y Sol
Son cifras comunicadas por los proveedores a través de Google y recopiladas por eesel y DataCamp.
| Prueba | Neon | Rival | Conclusión |
|---|---|---|---|
| Vals Index | 70.9%, #2 | Fable ~71.3% | Cerca de la cabeza |
| AutomationBench | 56.3%, #1 | Opus 42.5%, Sol 41.3% | Lidera en agentes |
| GraphWalks 256K–1M | 95.2% | Opus 66.8%, Sol 80.1% | Lidera con contexto largo; prueba primero tu archivo más largo, ya que algunos usuarios de Argon informan de resúmenes excesivos (thread) |
| Terminal-Bench 4.1 | 65.2% | Opus 65.8% | Empate técnico; Opus +0.6 |
| FrontierCode 2.0 | 46.2% | Opus 47.3% | Opus +1.1 |
| CursorBench 4.1 | 63.7–65.4% | Opus 58.1% | Neon lidera con el esfuerzo predeterminado |
El coste por tarea cambia la lectura de los precios por token, según Artificial Analysis a través de eesel:
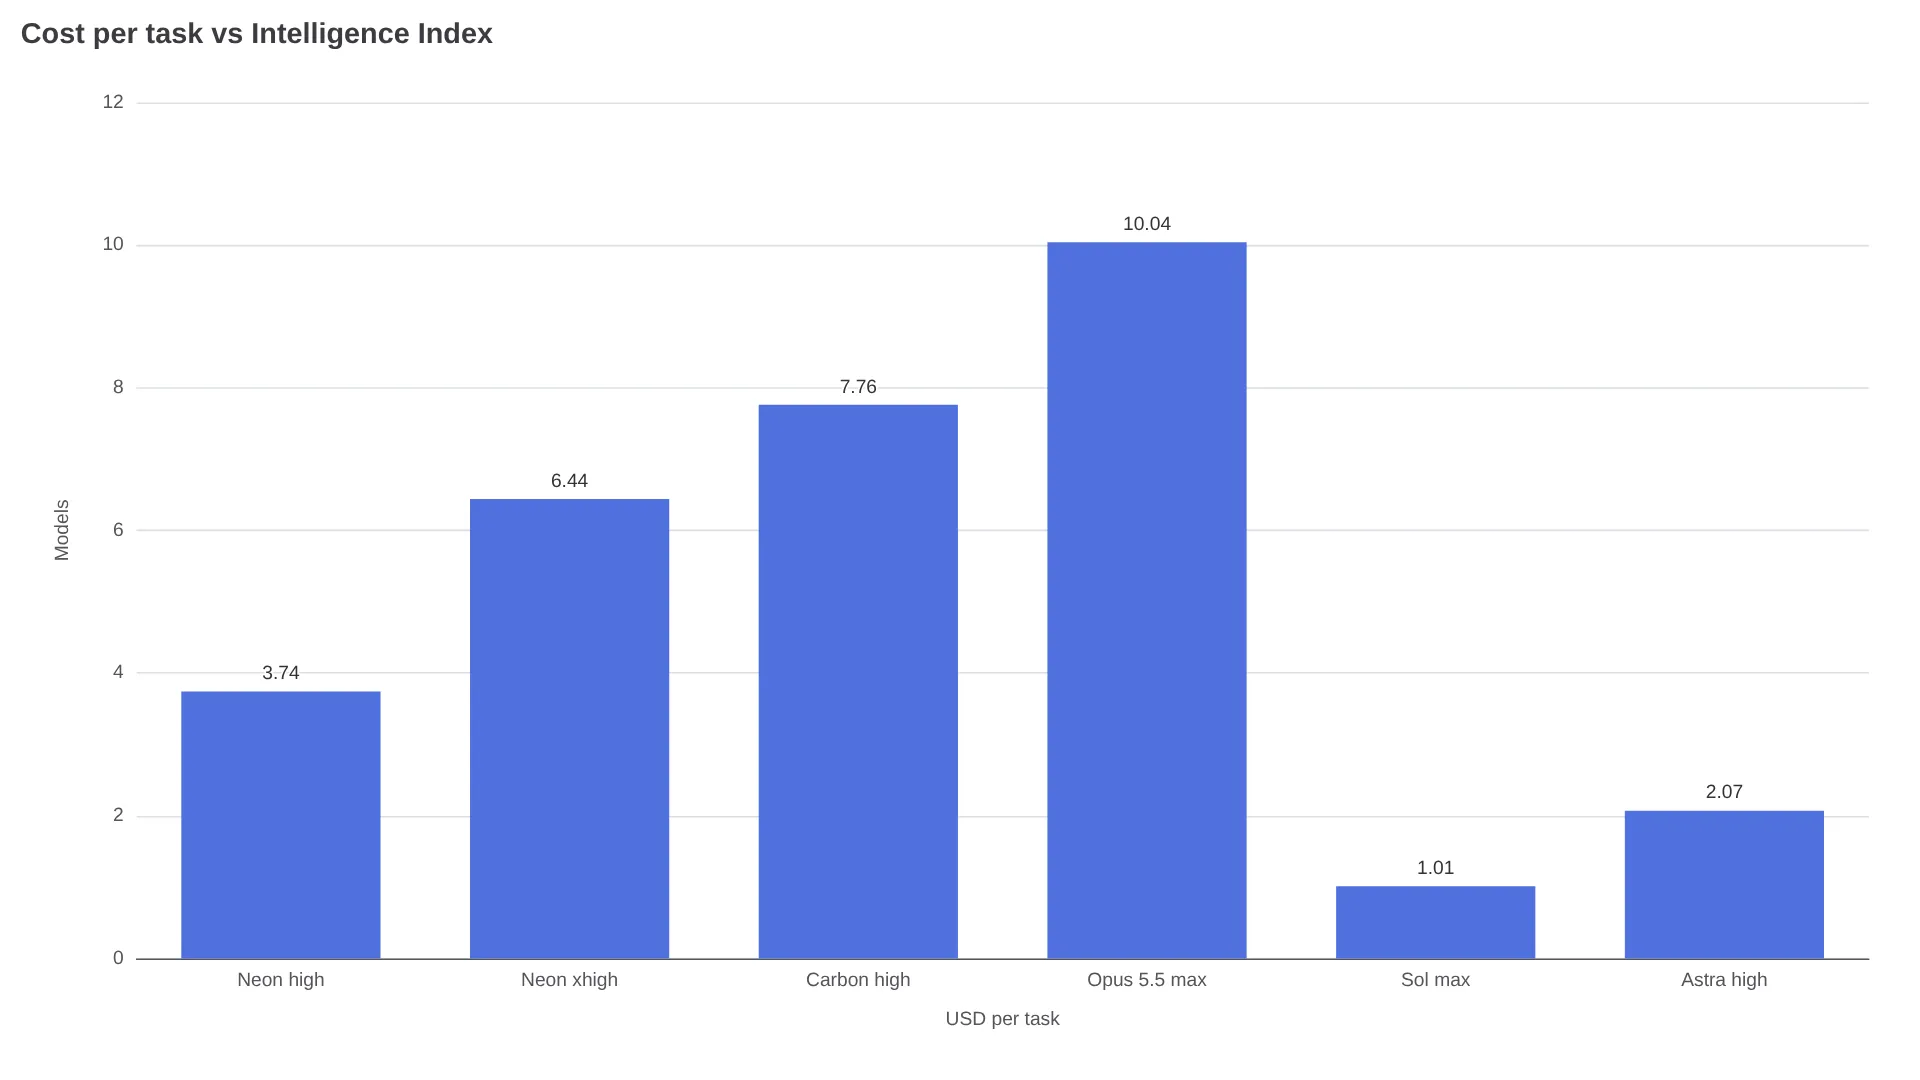
Neon en high obtiene 59.6 por $3.74 en 14.8 min; Carbon en high, 60.0 por $7.76 en 37.2 min; Opus en máximo, 59.1 por $10.04; Astra en high, 60.1 por $2.07; y Sol en máximo, 57.3 por $1.01. Neon en xhigh llega a 61.4 por $6.44 en 21.5 min. Usa high salvo que 1.8 puntos justifiquen $2.70 y 6.7 minutos adicionales.
Neon frente a Fable 5.2: los primeros informes apuntan a repartir funciones
En el SWE-sweep con arnés del proveedor (Antigravity harness), Neon logra 39.0%, frente al 10.1% de Opus y al 8.3% de Sol. En el arnés compartido mini-SWE, registra 12.8%, frente al 11.6% de Sol y al 3.6% de Opus, según DataCamp. Buena parte de la diferencia llamativa se explica por el arnés, no únicamente por el modelo.
"Uso Fable 5.2 como orquestador y desarrollador, con Neon como agentes de programación, y es la mejor combinación que he utilizado." — u/1969Stingray (thread)
De forma anecdótica, los usuarios prefieren Fable para orquestar y Neon para implementar; compruébalo en tu repositorio. En AA-Omniscience, Neon registra un 14% de respuestas erróneas en lugar de declinar, frente al 50% de Opus, el 55% de Sol y el 58% de Astra y Fable; sin embargo, su cobertura de respuestas correctas es del 59–60%, frente al 66% de Astra y el 77% de Fable, según eesel.
Pruebas prácticas: ajedrez, fichas de producto y 105 bugs reales
| Prueba | Resultado | Límite |
|---|---|---|
Página de ajedrez, 3 ejecuciones en medium (DataCamp) | Neon 3/3 por $0.83–$1.06; Carbon 1/3, dos alcanzaron el límite de 65K; 16 partidas, cero movimientos ilegales | Una sola tarea; Carbon probablemente terminaría con el modo en segundo plano |
| CatalogBench factual (SpringPrompt) | 78.6% listo para publicar x3, 1.º de 35; extrae especificaciones del embalaje | Ventas 32.1%, presentaciones 24.º y encuestas 22.º con presupuesto |
| 105 bugs replantados (@PawelHuryn) | Neon en xhigh 63 frente a Astra 62.7, Fable 58 y Carbon 57.3 | Un único evaluador |
SpringPrompt utilizó OpenRouter en medium, mientras que la API de Google usa high por defecto, por lo que la verbosidad varía. Hay informes aislados de filtraciones en AI Studio (thread). Para chat, las mediciones de eesel sitúan a Neon en xhigh en 56.5 s hasta el primer token; para respuestas interactivas, es preferible medium o Hydrogen.
Qué modelo elegir según la carga de trabajo
| Carga de trabajo | Elección | Motivo |
|---|---|---|
| Agentes complejos, documentos largos y refactorizaciones | Neon high | 59.6 por $3.74, #2 en Agent Arena, 3/3 en ajedrez |
| Desarrollos con el horizonte más largo | Carbon, según el posicionamiento de la familia de Google | Google reserva Carbon para los proyectos más difíciles; aquí no hay una prueba con la misma tarea que lo demuestre |
| Orquestación + programación | Fable al mando + programadores Neon | Combinación anecdótica anterior; valídala primero |
| Menor factura por tarea | Sol máximo $1.01; Astra high $2.07 puntúa más alto | Ambos tuvieron tasas superiores de respuestas erróneas en AA-Omniscience |
| Chat interactivo | Hydrogen o Neon medium | La latencia hasta el primer token de xhigh es demasiado alta para chat |
| Uso regulado | Espera a la documentación | El informe de seguridad completo seguía pendiente el 19 de noviembre; aprueba solo conforme a la documentación que exijas |
Pruébalo tú mismo en una tarde
Ejecuta el mismo prompt, los mismos archivos y el mismo presupuesto de razonamiento con Neon en high, tu opción predeterminada actual y una alternativa barata. Registra éxito, coste, tiempo y respuestas erróneas. Esa comparación vale más para tu cola de trabajo que cualquier clasificación. Cálculos del lado de Opus: review de Opus 5.5, review de Fable 5.2.