Si pagas por tokens, elegir entre Gemini 4 Neon y Carbon depende tanto del calendario como del modelo: Carbon será más barato durante los próximos 11 días, pero Neon costará un 25% menos a partir del 1 de diciembre. Google lanzó Gemini 4 Neon el 18 de noviembre de 2026 con un precio de $3 por cada millón de tokens de entrada y $15 por cada millón de salida. Ofrece una ventana de 1 millón de tokens y no tiene nivel gratuito.
El cambio de precios del 30 de noviembre lo cambia todo
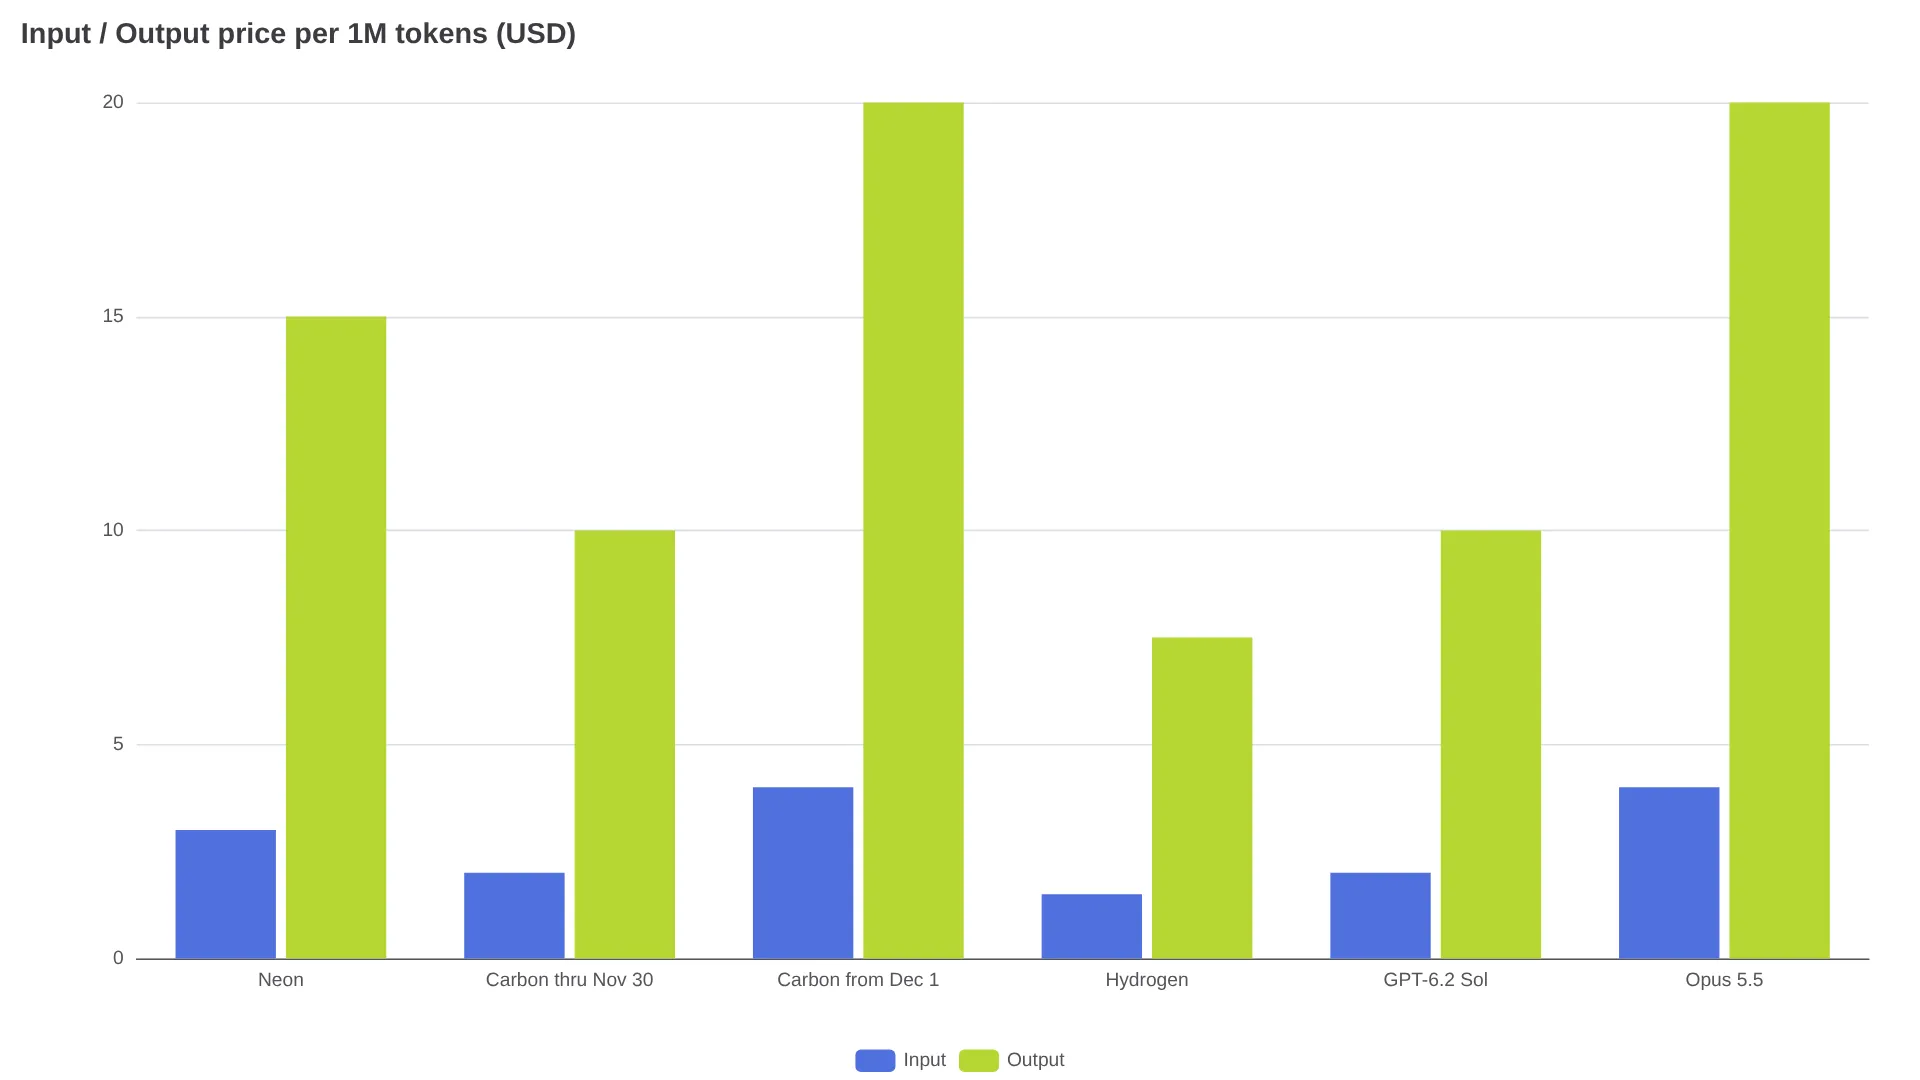
El precio de la API de Gemini 4 Neon solo se entiende mirando el calendario. Hasta el 30 de noviembre de 2026, Gemini 4 Carbon cuesta $2 por millón de tokens de entrada y $10 por millón de salida gracias a su precio promocional de lanzamiento. Desde el 1 de diciembre, Carbon y Argon pasarán a $4/$20, así que Neon, con sus $3/$15, será exactamente un 25% más barato por token (comparativa de precios). Hasta el 30 de noviembre, en cambio, Neon es un 50% más caro que Carbon con las tarifas promocionales.
Google plantea la comparación en términos de coste por tarea: asegura que Neon reduce un 32% el coste por tarea frente a Carbon con el nivel de razonamiento alto y al menos un 36% frente a competidores no identificados en xhigh (análisis del lanzamiento). Para hacer números, usa las tarifas publicadas de $3/$15; las cifras por tarea proceden de Google y no incluyen una referencia base identificada.
Qué lugar ocupa Neon en la familia Gemini 4
Gemini 4 Neon es la opción intermedia: queda por encima de Hydrogen en profundidad de razonamiento y se acerca a la calidad de Carbon, pero con una ejecución más rápida, según la posición del modelo en OpenRouter. Carbon era la opción de referencia para programación avanzada, Argon el modelo insignia para razonamiento matemático y científico, y Hydrogen el modelo económico para grandes volúmenes, con un precio de $1.50/$7.50 (índice de precios). Neon admite cuatro niveles de razonamiento —low, medium, high y xhigh—, con high como configuración predeterminada (especificaciones del proveedor).
Según el anuncio de Google y el desglose del lanzamiento, la disponibilidad inicial era la siguiente:
| Superficie | Acceso a Neon |
|---|---|
| Gemini API | Desarrolladores de pago, con el ID de modelo gemini-4-neon (ficha del catálogo) |
| AI Studio / Gemini app / Antigravity | Nivel de pago, además de Google AI Pro y Ultra |
Conviene tomar con cautela la etiqueta Neon de Antigravity. Usuarios del hilo de Antigravity aseguran que la entrada del orquestador todavía puede resolver a un prompt de sistema de Carbon en algunas sesiones; una respuesta lo resume así: «es solo el orquestador, no Neon» (hilo). Hasta que Google publique la correspondencia con los identificadores de compilación, calcula la factura usando el ID del modelo de la API, no la etiqueta de la interfaz.
Qué incluyen realmente los $3/$15
Las tarifas estándar son $3.00 por millón de tokens de entrada, $15.00 por millón de salida y $0.15 por millón de tokens de entrada almacenados en caché (anuncio oficial). Se mantienen sin cambios en toda la ventana de contexto de 1.048.576 tokens (comprobación de precios). Índices externos sitúan Batch en $1.50/$7.50, Flex en $1.50/$7.50 y Priority en $5.40/$27.00 (especificaciones y tabla del proveedor), pero Google todavía no había publicado las tarifas Batch, Flex y Priority de Neon en su página general de precios durante el lanzamiento. Hasta que esa página se actualice, considera que Neon solo está disponible en Standard (análisis del lanzamiento).
La fórmula es sencilla: coste = entrada nueva / 1M × $3 + entrada en caché / 1M × $0.15 + salida, incluido el razonamiento, / 1M × $15.
Tres reglas de facturación cambian bastante el precio que sugiere la tarifa base (análisis del lanzamiento y referencia de precios):
- Los tokens de razonamiento se facturan como salida. Con un precio de $15, la salida domina cualquier factura.
- La caché es implícita y solo se activa con prompts de al menos 4.096 tokens; la entrada almacenada que cumple los requisitos disfruta de un descuento del 95%. No existe una caché explícita mediante
cachedContentsni una tarifa por escribir en caché. - La salida síncrona está limitada a 65.536 tokens (especificaciones). Para respuestas más largas hace falta usar ejecución en segundo plano.
Los prompts cortos, de menos de 4.096 tokens, no obtienen ningún beneficio de la caché (referencia de precios). Un bot de soporte con 1.200 tokens de entrada no puede usar en ningún caso la tarifa de $0.15.
Cuánto cuestan dos cargas de trabajo reales
Los siguientes cálculos parten de cantidades fijas de tokens y no incluyen reintentos ni una longitud de razonamiento variable. La proporción de salida es el factor decisivo. Todas las filas usan los mismos porcentajes de caché y las tarifas propias de cada modelo según la tabla de precios del lanzamiento.
Sesión de programación: 50 llamadas, 80.000 tokens de entrada por llamada, un 90% procedente de la caché y 2.500 tokens de salida por llamada, incluido el razonamiento. Totales: 400.000 tokens de entrada nueva, 3,6 millones en caché y 125.000 de salida.
| Modelo | Coste de la sesión |
|---|---|
| Gemini 4 Neon $3/$15 | $3.62 ($1.20 de entrada nueva + $0.54 en caché + $1.88 de salida = $3.615) |
| Carbon hasta el 30 de noviembre $2/$10 | $2.41 |
| Carbon desde el 1 de diciembre $4/$20 | $4.82 |
| Hydrogen $1.50/$7.50 | $1.81 |
| GPT-6.2 Sol $2/$10 | $2.41 |
Soporte a escala: 10.000 conversaciones al día durante 30 días, con 6.000 tokens de entrada por conversación, un 75% apto para caché y 500 tokens de salida por conversación. Totales: 450 millones de tokens de entrada nueva, 1.350 millones en caché y 150 millones de salida.
| Modelo | Coste mensual |
|---|---|
| Gemini 4 Neon $3/$15 | $3,802.50 (de los cuales $2,250 corresponden a la salida) |
| Carbon hasta el 30 de noviembre $2/$10 | $2,535.00 |
| Carbon desde el 1 de diciembre $4/$20 | $5,070.00 |
| Hydrogen $1.50/$7.50 | $1,901.25 |
| GPT-6.2 Sol $2/$10 | $2,535.00 |
Neon cuesta el doble por token que Hydrogen y un 50% más que Sol a $2/$10. Para ganar en coste por tarea, Neon tendría que completarlas usando menos tokens o menos reintentos. Las cifras citadas de los benchmarks —puesto número 3 con un 61 en Intelligence Index y puesto número 1 en Coding Agent Index— proceden de los proveedores y no demuestran un menor coste real por tarea (recopilación de benchmarks).
El precio de los tokens no es tu cuota
Los porcentajes que muestra la aplicación no se convierten directamente en dólares de la API. Un usuario de Pro cuenta que las sesiones de Neon con contexto largo consumen entre un 1% y un 2% por mensaje:
También probé a cambiar a Neon conversaciones existentes con mucho contexto y veo un consumo del 1-2% por mensaje. Parece que este modelo sí podría ser utilizable en el plan Pro. — u/biblecrumble (hilo)
La cuota de la aplicación depende de ventanas de cinco horas, el nivel de razonamiento y las llamadas a herramientas. La facturación de la API cuenta todos los tokens procesados, incluidos los de razonamiento, además del grounding de Search, que se cobra por separado en cada consulta (análisis del lanzamiento). Calcula el trabajo de la API en dólares usando las tablas anteriores y estima el margen de la suscripción a partir de tus propias pruebas en high y xhigh.
Cambia en una línea, pero corrige estas tres cosas
Si usas Carbon, Argon o Hydrogen, la migración consiste en cambiar el ID del modelo por gemini-4-neon (análisis del lanzamiento). Aun así, hay tres detalles que pueden romper las llamadas (análisis del lanzamiento):
- Define
thinking_levelde forma explícita. Neon usa high por defecto. - Elimina los campos
cached_content. La caché explícita no es compatible. - Elimina
temperature,top_pytop_k. Los valores fuera de rango devuelven HTTP 400; los demás se ignoran.
También conviene aumentar max_output_tokens hasta acercarlo a 65.536 o usar ejecución en segundo plano para las respuestas largas.
¿Cambiar ya o aprovechar Carbon primero?
| Situación | Elección |
|---|---|
| Hay que publicar antes del 30 de noviembre y se necesita el máximo razonamiento | Seguir con Carbon a $2/$10 y probar Neon en paralelo |
| Agentes en producción en diciembre, con contexto largo | Neon a $3/$15 es el candidato por precio de lista; valida antes el éxito de las tareas y los reintentos |
| Chat sencillo de gran volumen | Seguir con Hydrogen a $1.50/$7.50, la única opción de este grupo con nivel gratuito (índice de precios) |
| Precio de lista más bajo entre los modelos avanzados hoy | GPT-6.2 Sol a $2/$10, si tu stack permite usar OpenAI |
| Necesitas dejar constancia del uso de Batch | Esperar: Batch de Neon no está publicado |
Preguntas frecuentes
¿Cuánto cuesta la API de Gemini 4 Neon?
$3 por millón de tokens de entrada, $15 por millón de salida y $0.15 por millón de tokens de entrada en caché, según Google.
¿Cuáles son los límites de contexto y salida?
1.048.576 tokens de entrada y 65.536 tokens de salida síncrona.
¿Tiene nivel gratuito?
No. Neon es solo de pago; Hydrogen mantiene un nivel gratuito.
¿Están disponibles Batch, Flex o Priority?
Google no los había publicado durante el lanzamiento. Los listados de terceros muestran $1.50/$7.50 para Batch y Flex, y $5.40/$27 para Priority; confírmalo antes de preparar el presupuesto.
¿Cómo funciona la caché?
Solo de forma implícita, con un mínimo de 4.096 tokens y un descuento del 95% para la entrada almacenada que cumple los requisitos.
¿Cuál es el ID del modelo?
gemini-4-neon.
Neon frente a Hydrogen y Carbon: ¿cuál conviene usar?
Hydrogen para grandes volúmenes baratos; Carbon hasta el 30 de noviembre para obtener los tokens avanzados más baratos; Neon desde el 1 de diciembre para razonamiento avanzado, un 25% por debajo de la tarifa de Carbon de $4/$20.
¿Cuánto cuesta una petición con 2.000 tokens de entrada y 500 de salida?
$0.0135 a precio de lista, antes de aplicar la caché. El razonamiento se factura como salida.