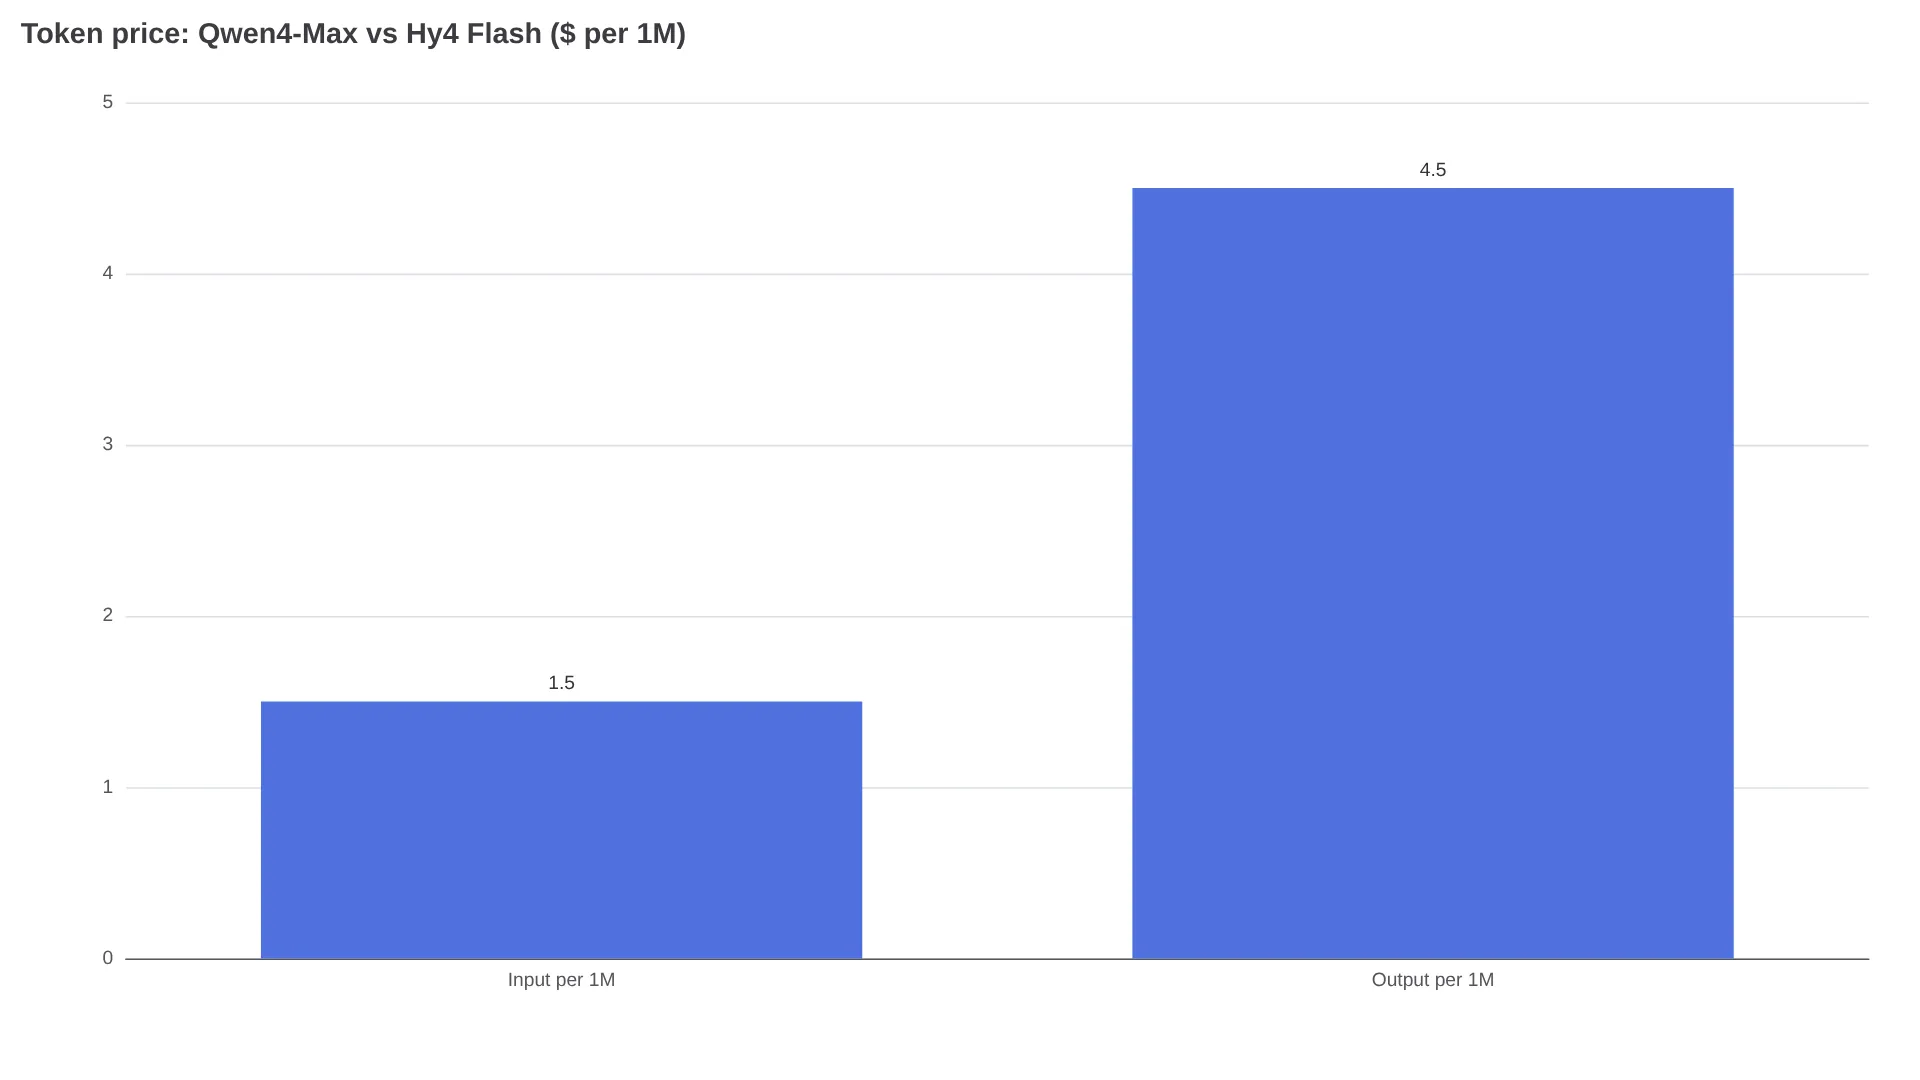
En benchmarks citados de programación compleja y flujos de trabajo, Qwen4-Max supera a Hy4 Flash; en coste por intento, sin embargo, Hy4 Flash juega en otra liga. QwenCloud publica $1.50/$4.50 por millón de tokens para Qwen4-Max, frente a los $0.070/$0.281 de Hy4 Flash en Tencent: aproximadamente 21 veces más en entrada y 16 veces más en salida. Pero la factura de un agente no la determina solo la tarifa visible: pesan los tokens de razonamiento, los reintentos y el uso de caché. Este análisis de precios de la API de Qwen4 Max compara su contexto de 1M, sus backbones de 2.4T frente a 224B y las afirmaciones de los proveedores sobre coste por tarea, para decidir qué modelo encaja en cada carga de trabajo.
Precios por token, cara a cara
| Concepto | Qwen4-Max (Singapur / internacional) | Hy4 Flash (TokenHub internacional) |
|---|---|---|
| Entrada por 1M | $1.50 | $0.070 |
| Salida por 1M (incluye razonamiento) | $4.50 | $0.281 |
| Lectura de entrada en caché por 1M | $0.075 | $0.003 |
| Creación explícita de caché por 1M | $1.875 (5 min) / $3.00 (1 h) | No se desglosa por separado |
| Combinado: 0.5M de entrada + 0.5M de salida | $3.00 | ~$0.176 |
| ID del modelo | qwen4-max a través de QwenCloud | Hy4 Flash a través de Tencent |
Una sesión de programación agéntica con 60,000 tokens de entrada y 4,000 de salida deja clara la diferencia. En Qwen4-Max, son $0.09 de entrada más $0.018 de salida: unos $0.108 por intento. En Hy4 Flash, $0.0042 más $0.0011: alrededor de $0.0053 por intento, cerca de 20 veces menos antes de contar reintentos. Si toda la entrada procede de caché, esos mismos 60k tokens cuestan $0.0045 en Qwen4-Max y $0.00018 en Hy4 Flash, antes de la salida. QwenCloud factura el razonamiento como salida; Hy4 Flash cobra los tokens de salida a $0.281 por millón, así que acortar las respuestas reduce directamente los tokens facturados.
Qué anticipan sus arquitecturas sobre la factura
Qwen4-Max es un modelo MoE de 2.4T parámetros, con 71B de parámetros activos por token (Offloop, DataCamp); Hy4 Flash es un modelo LatentMoE de 224B, con 12B activos, inferencia de 4 bits y una velocidad declarada de más de 150 tokens por segundo (Tencent). Para la factura importa el volumen de salida real: en las pruebas, Qwen4-Max alcanzó 127M tokens de salida frente a una mediana de 78.6M entre sus pares (DataCamp), mientras que el postentrenamiento de Hy4 Flash redujo la longitud media de salida un 50% (Tencent).
La tarifa que terminarás pagando
QwenCloud Singapur cobra $1.50 por entrada, $4.50 por salida y $0.075 por lectura en caché. Admite hasta 991,808 tokens de entrada sin pensamiento y 983,616 con pensamiento, además de 131,072 tokens de salida con pensamiento desactivado y 262,144 combinados (QwenCloud). Otros despliegues —Virginia, Fráncfort, Tokio y Hong Kong— indican $1.413 / $4.24 / $0.071 (tabla regional a través de Offloop).
Las nuevas cuentas de pago por uso de Singapur promocionan una asignación gratuita de 1 millón de tokens, con condiciones aplicables (a través de Xenospectrum). La ruta Token Plan de qwen4-max-preview se retirará el 25 de noviembre de 2026 y nunca cubrió backends de producción (notas de migración).
Hy4 Flash publica $0.070 / $0.281 / $0.003 para el modelo flash, frente a $0.834 / $2.501 / $0.042 del buque insignia Hy4 completo (Tencent). Hasta el 30 de noviembre de 2026, TokenHub costaba la mitad (~$0.035 efectivos por entrada) (Tencent). Consulta OpenRouter para ver la disponibilidad. Más información: precios de Hy4 Flash.
Los tres factores que cambian la factura real
Primero, el razonamiento comparte presupuesto con la salida y se cobra como salida. Qwen4-Max usa high de forma predeterminada, con un presupuesto de pensamiento de 131,072 tokens; las alternativas son xhigh y low. La prueba SVG de Simon Willison mediante OpenRouter, resumida en Offloop, utilizó 6,362 tokens con high frente a 26,295 con xhigh para el mismo prompt: 4.1 veces más tokens facturables. En modo pensamiento, fijar max_completion_tokens en 10,000 implica un total de 10,000 tokens entre razonamiento y respuesta.
Segundo, la verbosidad y los reintentos se acumulan. Las cifras recopiladas por Alibaba y publicadas a través de Offloop sitúan a Qwen4-Max en unos 105,000 tokens de salida por tarea de benchmark, frente a 171,000 de Qwen3.8-Max: una reducción del 39%, aunque todavía muy por encima de la mediana de sus pares. Un benchmark de Reddit en entorno sandbox (56 tareas, dos intentos por cada una, 112 intentos en total, hilo) registró 64 intentos exitosos para Qwen4-Max Preview y 61 para DeepSeek V4.1 Flash, pero 16 timeouts frente a 4 y unos 13 minutos por tarea frente a 7. Cada timeout que se reintenta genera otra petición facturable.
"los 16 timeouts de qwen pesan mucho en ese 64 frente a 61." — u/the_crooked_badger, hilo de r/DeepSeek
Tercero, reutilizar caché beneficia a los agentes de contexto largo. La lectura en caché de Qwen4-Max cuesta $0.075, un 95% menos que la entrada normal; un comentarista del hilo de r/Qwen_AI informó de 112M de entrada en caché frente a 14M sin caché. La lectura de caché de Hy4 Flash, a $0.003, sigue siendo 25 veces más barata, aunque su peso baja cuando los bucles adicionales de razonamiento dominan la factura. Como lo resumió @MarcosRGjr: "Ignora el precio por token. A los agentes se les cobra por tarea" (publicación).
Coste por tarea: lo que dicen los proveedores y las referencias externas
Son afirmaciones de proveedores frente a indicadores externos; no una comparativa directa verificada.
| Afirmación | Cifra | Base |
|---|---|---|
| Alibaba Work360, Qwen4-Max frente a Qwen3.8-Max (interno del proveedor, a través de DataCamp) | $1.67 frente a $4.43 por tarea intentada | Suite de 721 campos, ~35% menos tokens con high |
| Gráfico de Alibaba con filas AA, Qwen4-Max frente a Qwen3.8-Max (recopilado por el proveedor, a través de Offloop) | $3.27 frente a $10.02 por tarea de benchmark | xhigh, 105K frente a 171K tokens de salida |
| Tencent WorkIndex, Hy4 Flash frente a Hy4 completo (interno del proveedor, a través de Tencent y desglose) | ¥0.2 frente a ¥5.7 por tarea | Suite ofimática de 8 conjuntos |
| Prueba ciega de Tencent, Hy4 Flash frente a Claude Haiku 5.5 (ejecutada por el proveedor, a través de Tencent) | ¥0.26, 2.79/4 frente a ¥4.73, 2.81/4 | 85 usuarios, 259 tareas, 6.7 frente a 6.8 min |
Work360 otorga a Qwen4-Max 52.69 puntos frente a 47.74 de Qwen3.8-Max; el Intelligence Index sube de 34 a 43, aunque sigue por detrás de Kimi K3.1 Pro, con 46, y Opus 5.5, con 59 (Offloop, LLM Leaderboard).
Los resultados externos reproducidos en gráficos de los proveedores ponen límites a esas afirmaciones. Pruebas afiliadas a Vals, recogidas en la guía de LLM Leaderboard, midieron un 63.20% para Qwen4-Max a $9.33 por prueba, frente al 63.94% de GPT-6.1 Sol a $3.61. Terminal-Bench 4.0 sitúa a Qwen4-Max en 48.5% y a Hy4 Flash en 19.2% en el gráfico de Tencent (Hy4 completo: 44.4%); ProgramBench muestra 31.5 frente a 16.0 (Offloop). AutomationBench-AA marca 72.5% para Qwen4-Max (DataCamp), frente a 52.2 para la automatización con Hy4 Flash (Tokenstrom).
El coste esperado por éxito equivale al coste por intento dividido entre la probabilidad de éxito. Solo como ilustración: $0.108 / 0.485 ≈ $0.22 para Qwen4-Max, frente a $0.0053 / 0.192 ≈ $0.028 para Hy4 Flash; una diferencia de unas 8 veces. Las tasas de los benchmarks no son tasas de reintento en producción. Con estos volúmenes de tokens, Qwen4-Max necesita una probabilidad de éxito aproximadamente 20 veces mayor, o ahorros equivalentes en herramientas, latencia y correcciones, para ganar solo por coste.
Elige por carga de trabajo y valida con 30 tareas reales
| Perfil del agente | Opción predeterminada recomendada | Motivo |
|---|---|---|
| Programación compleja de largo recorrido y trabajo de terminal | Qwen4-Max en high | Una mayor tasa de éxito (48.5 frente a 19.2, 31.5 frente a 16.0) puede justificar el sobrecoste cuando fallar o reparar es caro |
| Bucles ofimáticos de gran volumen: presentaciones, documentos, reparación de hojas de cálculo y uso de ordenador | Hy4 Flash | ¥0.2 frente a ¥5.7 en WorkIndex, paridad con Claude Haiku 5.5 (2.79 frente a 2.81) a cerca de una dieciochoava parte del coste |
| Canalizaciones con caché y extracción por lotes | Hy4 Flash como opción predeterminada; Qwen4-Max si la repetición demuestra ahorro de calidad | Compara $0.003 frente a $0.075 en lecturas de caché, más el coste de corrección en tus documentos |
Antes de decidir, reproduce 30 de tus tareas en ambos modelos. Cuenta los tokens de razonamiento y salida por cada éxito, y registra llamadas a herramientas, timeouts, correcciones y tiempo mediano junto al coste.
Preguntas frecuentes
¿Cuánto cuesta la API de Qwen4 Max por millón de tokens?
QwenCloud Singapur publica $1.50 por entrada y $4.50 por salida, con $0.075 por lecturas en caché. Otras regiones indican $1.413 / $4.24 / $0.071. Hy4 Flash publica $0.070 por entrada, $0.281 por salida y $0.003 por caché.
¿Los tokens de razonamiento o pensamiento se cobran como salida?
Qwen4-Max factura el pensamiento a $4.50 dentro de un presupuesto compartido de 262,144 tokens. Las salidas de Hy4 Flash se cobran a $0.281, por lo que respuestas más cortas reducen los tokens facturados.
¿Cuál es el límite de contexto utilizable, más allá del 1M anunciado?
QwenCloud documenta 991,808 tokens de entrada sin pensamiento y 983,616 con pensamiento, 131,072 de salida con pensamiento desactivado y 262,144 combinados. Tencent indica 1M de contexto para Hy4 Flash. Deja un margen de seguridad.
¿Qwen4-Max o Hy4 Flash es más barato por tarea agéntica completada?
Por intento, Hy4 Flash es aproximadamente 20 veces más barato; Tencent afirma que cuesta una vigésima parte de Hy4 completo por tarea y una octava parte de DeepSeek-V4.1-Flash-1017 a precio máximo (Tencent). En el cálculo ilustrativo anterior sigue siendo unas 8 veces más barato por éxito esperado, pero Qwen4-Max puede ganar cuando reduce los fallos y las correcciones lo suficiente para compensar el precio por token.