La API de Qwen4 Max ya funciona con pago por uso, no solo como una vista previa del Token Plan: cuesta $1.50 por 1M de tokens de entrada y $4.50 por 1M de salida, con una ventana de contexto de 1M de tokens. Puedes empezar a trabajar con qwen4-max, pero ten en cuenta que qwen4-max-preview dejará de estar disponible el 25 de noviembre de 2026.
API de Qwen4-Max, en resumen: disponible desde el 16 de noviembre de 2026
Alibaba lanzó Qwen4-Max con disponibilidad general el 16 de noviembre de 2026 en Alibaba Cloud Model Studio, bajo el identificador qwen4-max. Antes hubo una vista previa exclusiva para Token Plan desde el 11 de noviembre. @Alibaba_Qwen presentó el modelo como una nueva arquitectura MoE con visión nativa y una ventana de contexto de 1M de tokens; la API ya está activa en QwenCloud. La documentación de QwenCloud replica la de Model Studio para el acceso internacional, así que debes utilizar el endpoint de Model Studio correspondiente a tu región (documentación de QwenCloud).
| Elemento | Qwen4-Max (qwen4-max) |
|---|---|
| Estado | Disponible de forma general desde el 16 de noviembre de 2026; la vista previa qwen4-max-preview funciona del 11 al 25 de noviembre de 2026 y después se retirará |
| Entrada / salida | $1.50 / $4.50 por 1M de tokens (Singapur internacional) |
| Lectura de caché | $0.075 por 1M de tokens |
| Otras regiones | $1.413 / $4.24 por 1M de tokens en EE. UU. (Virginia), Fráncfort, Tokio y Hong Kong |
| Contexto | 1M de tokens; la entrada máxima indicada es de 991K tokens |
| Salida máxima | 131,072 tokens sin razonamiento; 262,144 tokens para razonamiento más respuesta |
| Modos de entrada | Texto, imágenes y vídeo |
| Tipo de API | Compatible con OpenAI y Anthropic; llamadas a herramientas, salida JSON estructurada, búsqueda web, caché, procesamiento por lotes y ajuste fino |
| Regiones | Singapur, EE. UU. (Virginia), Fráncfort, Tokio, Hong Kong y Pekín; los trabajos por lotes solo están disponibles en Pekín |
| Prueba | Las cuentas nuevas de Singapur reciben 1M de tokens gratis durante 90 días |
Los precios y límites anteriores proceden de la documentación de Alibaba Cloud Model Studio, según la información publicada el 16 de noviembre de 2026 (precios y documentación de QwenCloud). Por ejemplo, 100K tokens de entrada más 10K de salida en Singapur cuestan aproximadamente $0.15 + $0.045 = $0.195.
Qué cambia realmente frente a Qwen3.8-Max
El anuncio de Qwen, que cita cifras de Artificial Analysis, sitúa a Qwen4-Max en 43 puntos del Intelligence Index: 9 puntos por encima de Qwen3.8-Max (xhigh) y 3 por debajo de Kimi K3.1 Pro. Además, el coste medio por tarea es de $3.27, aproximadamente un tercio del de Qwen3.8-Max, con un 39% menos de tokens de salida.
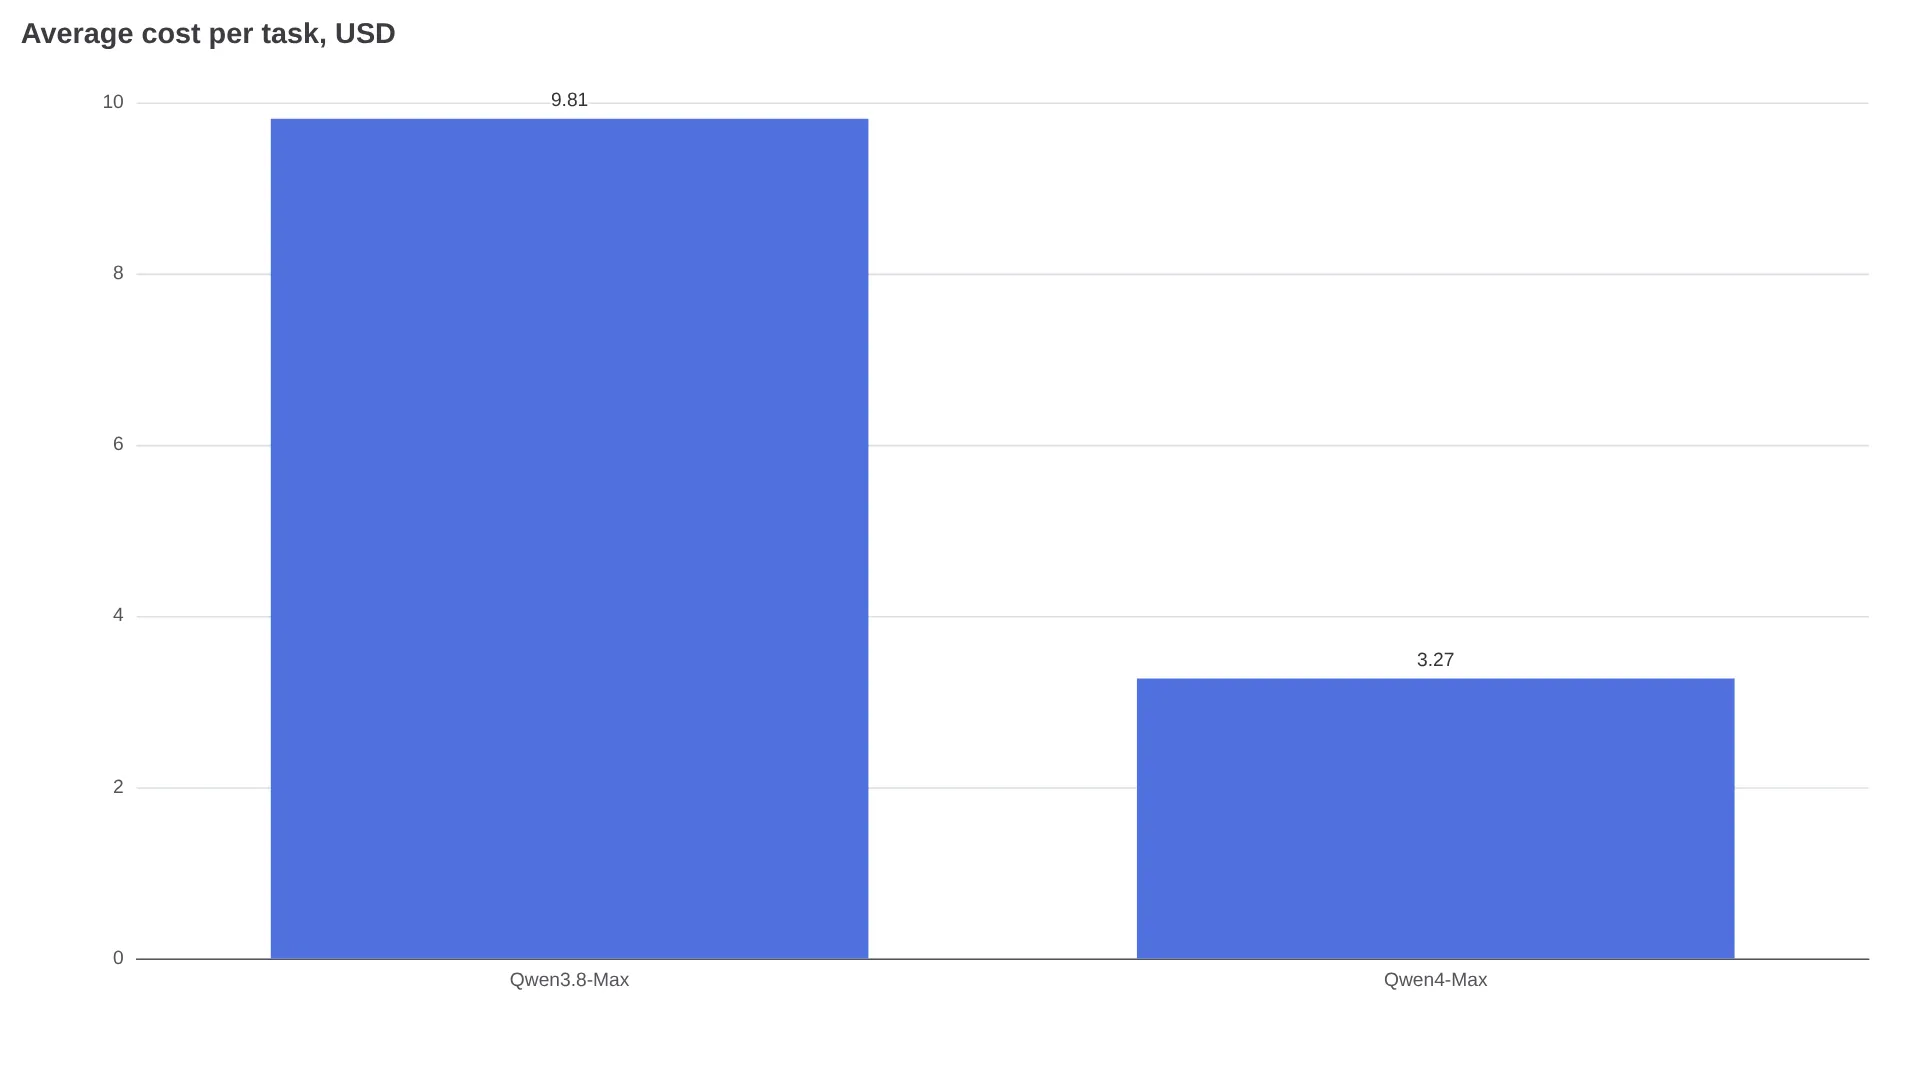
El ahorro llega por dos vías: el precio por token de la tabla anterior y un menor consumo de tokens por tarea, de hasta aproximadamente un 50% menos en la evaluación interna de Qwen. Los trabajos que recorren 1M de tokens y reutilizan la caché son los que más se benefician, ya que las lecturas implícitas de caché cuestan $0.075 por 1M y, según Qwen, son un 70% más baratas que las de Qwen3.8-Max.
Por dentro, Qwen4-Max utiliza una arquitectura MoE con visión nativa, 2.4T de parámetros totales, 71B activos y 328B de embeddings de N-gramas. Aunque el blog de Qwen cita las puntuaciones de Artificial Analysis, AI First Look y AICoder señalan que el 16 de noviembre todavía no estaban disponibles las tablas completas de benchmarks ni los listados públicos del ranking de AA.
Si quieres consultar el modelo anterior: precio de la API de Qwen3.8-Max y Qwen3.8-Max frente a Kimi K3.
Especificaciones y límites que influyen en la factura
El titular de 1M de tokens no es lo único importante. Hay tres límites que conviene vigilar.
Contexto total frente a entrada utilizable. La ventana es de 1M de tokens, pero QwenCloud fija la entrada máxima en 991K tokens. Deja margen de seguridad y comprueba cómo recupera información en la zona intermedia del contexto si vas a usarlo para tareas intensivas de recuperación.
La salida y el razonamiento comparten presupuesto. Sin razonamiento, la salida máxima es de 131,072 tokens. Cuando el razonamiento está activo, razonamiento y respuesta comparten un presupuesto de 262,144 tokens, así que una cadena de pensamiento extensa deja menos espacio para la respuesta. Según el resumen de especificaciones de la vista previa de XenoSpectrum, la versión preview permitía 393,216 tokens compartidos entre razonamiento y respuesta. No traslad es esos límites de la preview directamente a producción.
El modo de razonamiento predeterminado también cambió. El razonamiento viene activado de forma predeterminada. En el modelo GA, el nivel inicial es high, aunque también están disponibles low y xhigh; en la preview, el valor predeterminado era xhigh, según la tabla de especificaciones de AI First Look. Si la latencia es demasiado alta, prueba primero a reducir reasoning_effort a low.
La entrada multimodal admite texto, imágenes y vídeo. En la preview, los límites de envío de vídeo eran de 2 horas, 2 GB y 64 vídeos por solicitud, según el resumen de especificaciones de la preview de XenoSpectrum. Son límites de envío, no una garantía de comprensión. Comprueba por tu cuenta cómo responde con tus propios archivos de vídeo largos.
Para controlar costes, solicita una salida JSON estructurada que limite las respuestas innecesariamente largas y reutiliza los contextos extensos mediante lecturas de caché ($0.075 por 1M en Singapur). Las notas de lanzamiento de AICoder también indican un precio de $1.875 por 1M para crear una caché explícita durante cinco minutos, allí donde esta opción está disponible.
Cómo llamar a qwen4-max con el SDK de OpenAI
Model Studio admite los formatos de Chat Completions y Responses de OpenAI, además de Messages API de Anthropic, según la documentación del modelo de Alibaba Cloud. Usa qwen4-max con los backends de pago por uso; qwen4-max-preview está limitado a Token Plan.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("QWEN_API_KEY"),
    # Singapore/international endpoint:
    base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1",
    # China/Beijing endpoint: https://dashscope.aliyuncs.com/compatible-mode/v1
)

resp = client.chat.completions.create(
    model="qwen4-max",
    messages=[
        {"role": "user", "content": "Summarize this release in 3 bullets."}
    ],
    extra_body={"reasoning_effort": "high"},
)
print(resp.choices[0].message.content)
La clave y el endpoint deben pertenecer a la misma región de Model Studio. Puedes solicitar response_format={"type": "json_object"} o un esquema JSON cuando sea compatible, y conviene validar las salidas estructuradas de gran tamaño.
Pago por uso, Token Plan o aplicaciones de chat: qué opción elegir
| Opción | Más adecuada para | Principal limitación |
|---|---|---|
Pago por uso de Model Studio (qwen4-max) | Aplicaciones, backends y procesamiento por lotes | Facturación por token; comprueba el endpoint regional y la clave |
Token Plan (qwen4-max-preview) | Programación interactiva en Claude Code, Cline, Cursor y OpenCode | Solo uso interactivo; no permite automatización en producción, scripts por lotes ni integrar la clave en un backend; únicamente región de Singapur; termina el 25 de noviembre de 2026 a las 24:00 UTC+8 |
| Qwen Chat, QwenWork, QwenStudio y Qoder | Probar prompts, trabajar con documentación y usar un IDE agéntico sin configurar claves | La disponibilidad y las tasas de crédito aparecen en la aplicación; no constituyen un contrato de API |
Token Plan es una bolsa mensual de créditos para desarrollo interactivo. El desglose de Token Plan de Apidog recoge niveles individuales que van de Lite, a $3 de oferta / $8 de precio de lista con 20,000 créditos, a Pro, a $43 de oferta / $51 de precio de lista con 200,000 créditos; las claves empiezan por sb-sp-. Compartir claves, ejecutar trabajos en segundo plano o integrar la clave en un backend publicado incumple las condiciones. Para probar prompts, Apidog y XenoSpectrum mencionan Qwen Chat, QwenWork, QwenStudio y Qoder como vías de evaluación; la disponibilidad aparece en la aplicación y varía según la cuenta.
Haz la migración antes del 25 de noviembre de 2026:
- Cambia el nombre de modelo de
qwen4-max-previewaqwen4-max. - Sustituye la URL base y la clave de Token Plan por una clave de pago por uso de Model Studio y el endpoint regional correspondiente.
- Vuelve a probar los valores predeterminados del razonamiento (
xhighpasa ahigh). - Vuelve a medir los presupuestos de salida (límite compartido de 393K en la preview frente a límites GA de 131K/262K).
Qué cuentan los primeros usuarios: rápido para proyectos nuevos, irregular con agentes
Las pruebas de muestra reducida recopiladas por AI First Look describen proyectos funcionales creados con un solo prompt. En un caso, superó 20 de 20 pruebas ocultas en unos 2.5 minutos, frente a los 17 minutos de Qwen3.8-Max. Sin embargo, el mismo resumen menciona una prueba con un juego en la que Qwen4-Max terminó antes, aunque quedó segundo en la valoración general.
Estos fallos aparecen constantemente cuando intento generar código.
— @bijanbowen, publicación (primera impresión de un usuario real, 16 de noviembre de 2026; captura de errores repetidos al generar código)
Un resumen temprano de pruebas realizadas por usuarios chinos (@weconomypistis) consideró que el precio y el coste por tarea eran la gran ventaja, pero situó las operaciones de terminal y de agentes un paso por detrás de Kimi, con respuestas más lentas.
Preguntas frecuentes
¿Qwen4-Max tiene pesos abiertos?
No. Qwen4-Max solo está disponible como servicio alojado y, a 16 de noviembre, no se habían anunciado sus pesos, según el seguimiento de AI First Look. Qwen afirma que más adelante publicará los pesos abiertos de modelos Qwen4 más pequeños, según el anuncio de Qwen4-Max, pero todavía no hay fecha, tamaños ni licencia.