 AIREITER
A primera vista, las dos APIs parecen cobrar lo mismo: $0.10 por 1M de tokens de entrada. En la práctica, un documento de políticas repetido puede costar $520 en una y $70 en la otra. OpenAI Decisions API encaja mejor con transcripciones de agentes y contexto reutilizado; Gemini Decisions API, con audio, vídeo y listas de hasta 1.000 reglas.
El mismo precio anunciado, una factura muy distinta
OpenAI Decisions API y Gemini Decisions API cobran $0.10 por 1M de tokens de entrada sin caché y no facturan los tokens de salida. OpenAI Decisions API alcanzó la disponibilidad general el 22 de octubre de 2026 con el modelo gpt-6-luna, mientras que Gemini Decisions API se lanzó el 11 de noviembre de 2026 en v1beta con el modelo gemini-decision-1. La opción más barata depende de cuánto se repita la entrada y de su modalidad, no del logotipo.
| Dimensión | OpenAI Decisions API | Gemini Decisions API |
|---|---|---|
| Modelo | gpt-6-luna | gemini-decision-1 |
| Estado | GA desde el 22 de octubre de 2026 (documentación de OpenAI) | Preview v1beta desde el 11 de noviembre de 2026 (anuncio de Google) |
| Preguntas por solicitud | 1–400 (documentación de OpenAI) | 1–1.000 (anuncio de Google) |
| Ventana de contexto | Multiplicador 2x para contexto largo por encima de 272K tokens | 262.144 tokens |
| Entradas | Texto, imágenes, input_json, conversaciones y llamadas a herramientas | Texto, imágenes, audio, vídeo y PDF |
| Coste de salida | $0 | $0 |
| Entrada en caché | $0.01 por 1M de tokens, prefijo ≥1.024 tokens | No compatible |
| Plan gratuito | No se indica un plan gratuito independiente | Sí, en AI Studio, 200 RPM / 50K TPM / 10K RPD |
| Latencia publicada | Aproximadamente 10 veces más rápida que Responses API | 50–100 ms de cómputo del modelo, 150–250 ms de extremo a extremo hasta 16K tokens |
| Empresa | ZDR, HIPAA y regiones de EE. UU./UE (+10%) | Compatibilidad con Cloud próximamente |
Así es una solicitud en la práctica
OpenAI Decisions API utiliza POST /v1/decisions con un array ordenado de preguntas, cada una con un name opcional. Gemini Decisions API usa client.decisions.create() con un mapa cuyas claves son identificadores elegidos por el desarrollador. Las dos admiten tres tipos de pregunta, aunque sus nombres y límites no coinciden.
Los tipos de pregunta de OpenAI son predicate (probabilidad de 0 a 1), choice (categorías sin orden) y score (niveles ordenados del 2 al 10 con una media ponderada por probabilidad), según la guía de OpenAI. Gemini ofrece noul (sí/no, probabilidad de 0.01 a 0.99), choice (de 2 a 255 opciones) y score (de 2 a 255 niveles, con 2–10 como rango recomendado), según el anuncio de Google. Las preguntas de una misma solicitud son independientes en ambas APIs; la lógica encadenada requiere código de aplicación o una segunda llamada.
Tres detalles que rompen una migración
Gemini ordena alfabéticamente las claves de choice antes de puntuar. Por eso, una opción comodín llamada none_of_the_above puede aparecer antes que shipping (comportamiento documentado). OpenAI devuelve el name de la pregunta en el array de respuestas, mientras que Gemini devuelve un mapa cuyas claves son los ID de las preguntas. noul de Gemini nunca devuelve un valor superior a 0.99, así que un umbral >0.99 nunca se activa.
La gestión de rechazos también cambia. OpenAI puede devolver un refusal para una pregunta y responder aun así al resto, según la guía de OpenAI. Gemini rechaza la solicitud completa con HTTP 400 cuando detecta activadores de seguridad o contenido prohibido, mediante códigos como safety y prohibited_content.
"Una cosa curiosa es que parece que Decisions y la generación de texto normal utilizan rutas de inferencia y caché independientes." — u/Balance- en r/OpenAI
Si necesitas admitir ambos endpoints, prepara un adaptador fino. Normaliza los ID de las preguntas, cambia los nombres de las claves de Gemini para evitar sorpresas por desempates alfabéticos y limita los umbrales a ≤0.99 en Gemini.
Qué acepta cada API y qué te obliga a construir
Gemini Decisions API acepta texto, imágenes, audio, vídeo y PDF de forma nativa dentro de una misma entrada. OpenAI Decisions API admite texto, imágenes, input_json, historial de conversaciones, llamadas a funciones y resultados de herramientas, pero no archivos ni audio. La diferencia determina si puedes prescindir del preprocesado o si tendrás que incorporarlo.
Una grabación de una llamada junto con los metadatos de la cuenta puede ir directamente a Gemini, sin transcripción. Lo mismo ocurre con un PDF escaneado de una reclamación acompañado de fotos de los daños, sin necesidad de OCR. Una transcripción de agente con llamadas a herramientas llega de forma nativa a OpenAI, con coincidencia mediante call_id, mientras que en Gemini tendrás que aplanar esa misma transcripción a texto. OpenAI también permite incluir imágenes dentro de instructions de una pregunta para comparar candidatos con una referencia.
El recuento de tokens de imagen varía según el proveedor. En una prueba práctica independiente (System Design Academy), una foto de un huevo de 224×224 contó como 523 tokens de entrada en OpenAI con tres preguntas, frente a una estimación de 390 tokens en Gemini Low (257 tokens de imagen), 663 en Medium y 1.223 en High, es decir, $0.039, $0.066 y $0.122 por cada 1.000 fotos.
Las cifras de latencia proceden de los propios proveedores. Google afirma ofrecer entre 150 y 250 ms de extremo a extremo y una escalabilidad casi plana de 1 a 100 preguntas hasta 16K tokens. OpenAI habla de una velocidad aproximadamente 10 veces superior a Responses API, pero no publica una cifra absoluta. Los testimonios de usuarios son más variados:
"Velocidad y coste. Las respuestas llegan casi al instante y cuestan una fracción." — u/zyeus-guy en r/OpenAI
Probé Gemini Decision 1 con el plan gratuito: 30/30 en enrutamiento, con una mediana de ~0,24 s y repeticiones deterministas, pero eligió con mucha seguridad una categoría incorrecta cuando faltaba "other". — prueba práctica en r/GeminiAI
Usa la latencia anunciada por el proveedor como un máximo que tus pruebas deberían superar, no como un SLA de producción.
Cuánto cuestan realmente 1M de solicitudes
En ambas APIs, la entrada compartida se factura una sola vez por solicitud. Añadir preguntas solo suma los tokens de sus instrucciones. La diferencia aparece cuando se repite la entrada entre solicitudes: OpenAI aplica caché y Gemini factura el contenido completo.
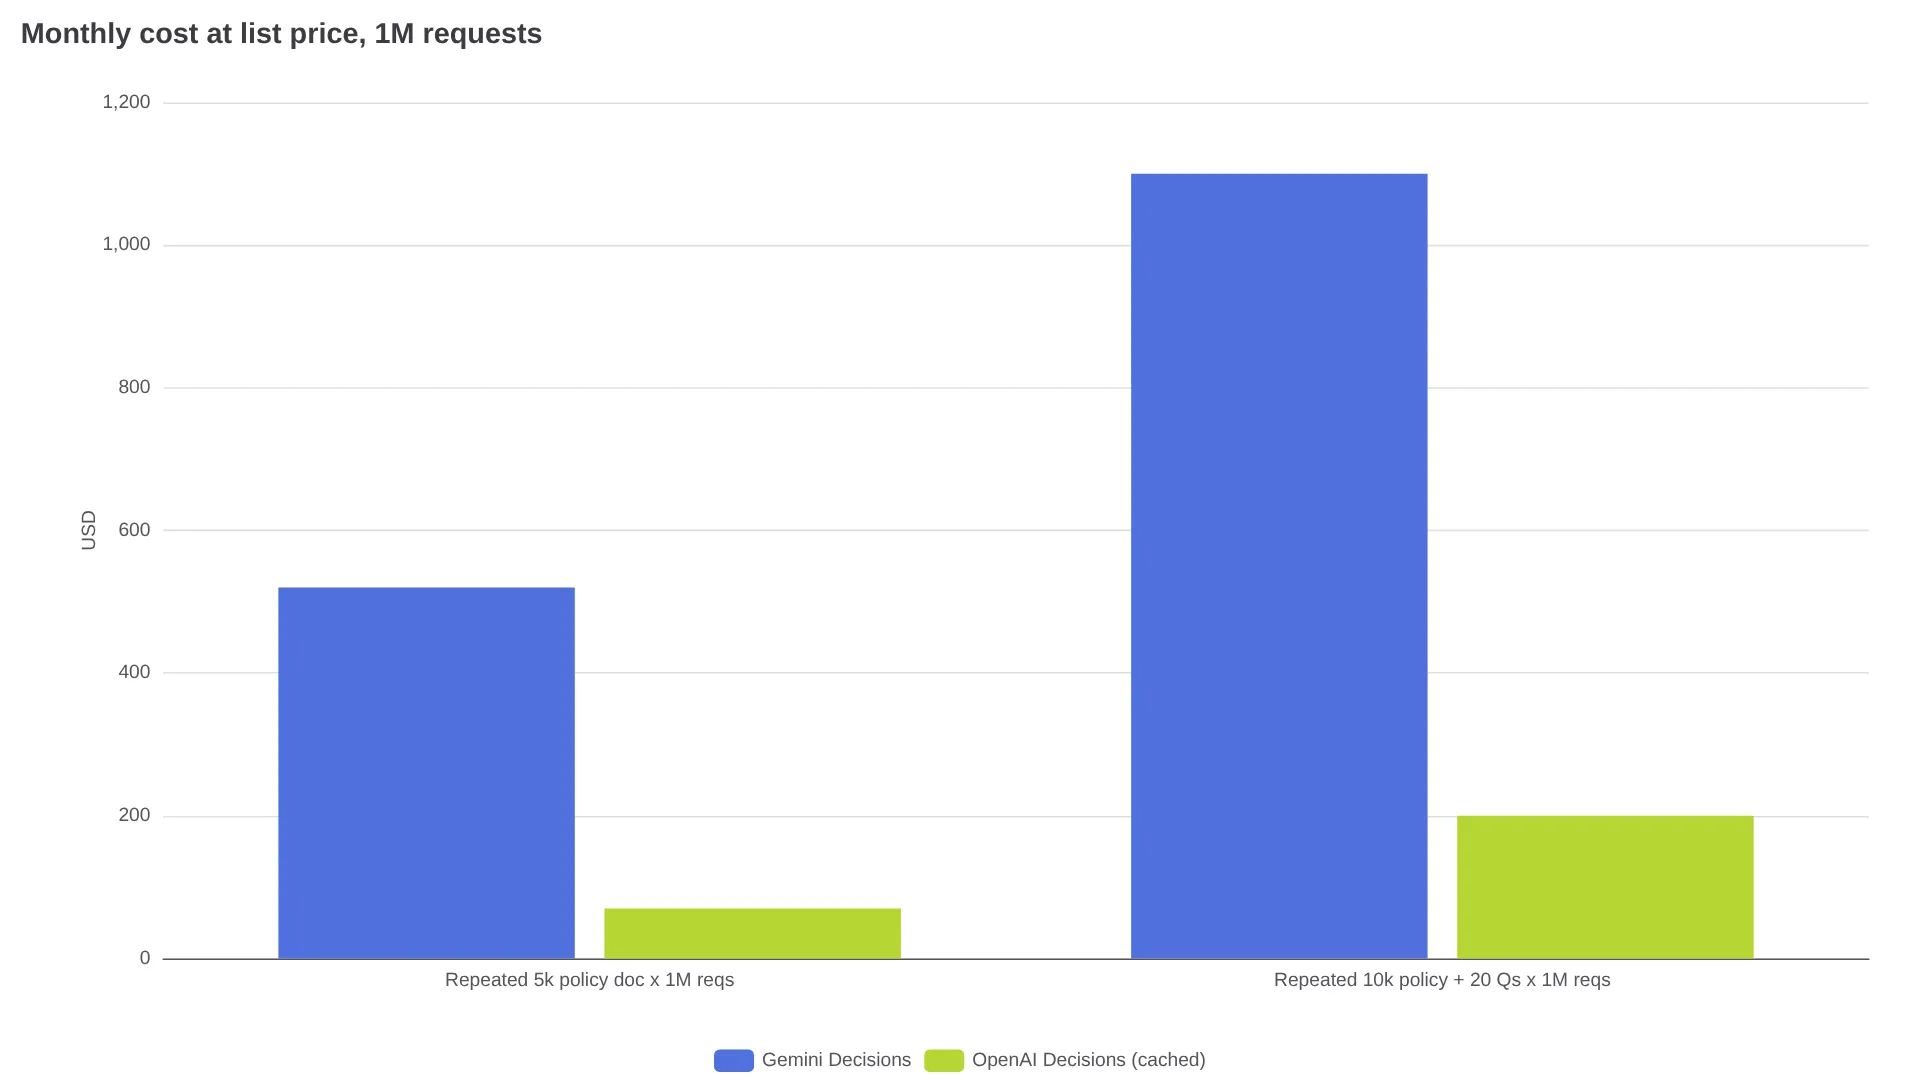
Este cálculo ilustrativo, basado en las tarifas públicas y en el patrón publicado por Apidog y BaristaLabs, supone que OpenAI consigue aciertos de caché antes de aplicar los cargos de escritura:
- 1M de tickets con la misma política de 5.000 tokens más 200 tokens nuevos: aproximadamente $520 en Gemini y $70 en OpenAI con caché.
- 1M de solicitudes con la misma política de 10.000 tokens más 20 preguntas de ~50 tokens: aproximadamente $1.100 en Gemini y $200 en OpenAI con caché, más las escrituras.
Cuando la entrada es nueva y única, la diferencia desaparece: un mensaje de 400 tokens sin prefijo reutilizable cuesta lo mismo en ambas, con una tarifa de $0.10 por 1M. Agrupar las comprobaciones importa más que elegir un modelo: una solicitud con 20 comprobaciones sobre un registro de 4.000 tokens cuesta aproximadamente $0.50 por cada 1.000 registros, mientras que 20 solicitudes separadas cuestan unos $8.10.
Las conversaciones largas que vuelven a leer el historial en cada turno favorecen la caché. Según un modelo de 30 turnos, un router que lee 124.680 tokens cuesta aproximadamente $12.47 por cada 1.000 chats en Gemini Decision 1 sin caché, frente a unos $6.31 en un modelo con caché.
¿Es fiable el número que devuelve?
En la tabla publicada por Google y resumida por AIToolsReview, Decision 1 supera a Luna en todas las pruebas compartidas: obtiene un ECE top-1 de 0.0250 frente a 0.0721 de Luna y 0.0494 de Jev 1.14. En la división pública de JevBench, los resultados son 92.2% para Decision 1, 90.9% para Luna y 90.0% para Jev 1.14. El coste total de la suite fue de $0.88 para Decision 1, $0.68 para Jev y $0.93 para Luna.
Un resumen independiente de Artificial Analysis citado en la misma revisión concede a Decision 1 un Decision Index de 66, empatado con Jev 1.14 y en el puesto 9 de 18, aproximadamente 7 puntos por detrás de Drex Max v1.1. En When2Call obtiene un 75.2% para Decision 1, frente al 80.8% de Jev y el 94.6% de Drex Max, con un coste de $345 por 1M de tareas y 211 ms para Decision 1, frente a $156 y 92 ms para Jev.
Para automatizar acciones mediante umbrales, la calibración importa más que la precisión llamativa de un titular. Una confianza de 0.90 debería acertar aproximadamente 9 de cada 10 veces en la distribución de producción. Valida los umbrales con 200–500 casos etiquetados y mide la precisión por intervalos de confianza.
"Confianza: las probabilidades calibradas al estilo de Jev no son algo que devuelva cualquier endpoint compatible con OpenAI." — u/xapep en r/LLMDevs
Se repiten dos fallos. Las primeras pruebas de usuarios detectan un sesgo hacia la primera opción en OpenAI (@NatashaTheRobot), mientras que la prueba práctica de Gemini muestra que, si falta una opción comodín, el modelo elige la categoría menos mala en vez de abstenerse. Puedes mitigar ambos problemas con una opción other, un predicado independiente para comprobar el alcance, descripciones breves y diferenciadas y revisión humana por debajo del umbral.
Checklist antes de llevarlo a producción
OpenAI está en GA, ofrece caché, informes de uso mediante GET /v1/organization/usage/decisions, ZDR y HIPAA para clientes elegibles, además de procesamiento regional en EE. UU. y la UE con un incremento del 10%. Gemini sigue en v1beta y la compatibilidad con Cloud llegará próximamente. Ambos proveedores enumeran integraciones con frameworks como OpenRouter, LangChain, Vercel y LiteLLM.
Las reglas de caché condicionan la arquitectura. OpenAI reutiliza un prefijo de entrada compartida de al menos 1.024 tokens; el contenido de las preguntas no cuenta para alcanzar ese mínimo. Gemini no dispone de caché de contexto ni de niveles Batch, Flex o Priority. El plan gratuito favorece la creación de prototipos en Gemini, pero el contenido del nivel gratuito puede utilizarse para mejorar los productos de Google, así que usa claves de pago para los datos reales de clientes. Registra la distribución de confianzas durante una semana antes de automatizar acciones de alto impacto.
Elige según la carga de trabajo, no por el logotipo
Si tienes un ciclo de enrutamiento de agentes con llamadas a herramientas e instrucciones repetidas, la opción lógica es OpenAI Decisions API. Los requisitos de ZDR, HIPAA o residencia de datos en la UE también apuntan en esa dirección.
Para decisiones basadas en grabaciones de llamadas, clips de vídeo o PDF escaneados con cientos de comprobaciones, Gemini Decisions API encaja mejor. La entrada nativa de audio, vídeo y PDF elimina las fases de transcripción y OCR, y sus 1.000 preguntas por solicitud cubren listas de reglas que superan las 400. Ten en cuenta los límites de presupuesto: 100 MB en línea por solicitud, 50 MB por PDF y 15 MB por URL externa.
Con texto corto y único y menos de 400 preguntas, hay empate al precio de lista. Haz el prototipo en el nivel gratuito de Gemini con datos sintéticos y después repite los mismos 200–500 casos etiquetados en ambas APIs. Compara la precisión por intervalos, la latencia p50/p95, los tokens por solicitud y el coste mensual.
| Carga de trabajo | Elección |
|---|---|
| Documento de políticas repetido de 5K–10K, QPS alto | OpenAI Decisions API; la caché ahorra un 80% o más |
| Enrutamiento de agentes con historial de llamadas a herramientas, voz GPT-Live | OpenAI Decisions API |
| Decisiones sobre audio, vídeo o PDF, con >400 reglas | Gemini Decisions API |
| Texto corto y único, <400 preguntas | Empate: elige el stack que ya utilizas |
| Prototipado gratuito | Gemini AI Studio y después vuelve a evaluar con el plan de pago |
¿Gemini es más barato que OpenAI?
El precio de lista está empatado: $0.10 por 1M y sin coste de salida. OpenAI gana con contexto repetido en caché; Gemini, para crear prototipos gratis.
¿Puede OpenAI leer audio, vídeo o PDF?
No. Solo admite texto, imágenes, JSON y conversaciones con llamadas a herramientas; Gemini procesa audio, vídeo y PDF de forma nativa.
¿Cuántas preguntas admite cada solicitud?
Gemini admite de 1 a 1.000 dentro de 262.144 tokens; OpenAI, de 1 a 400.
¿Está Gemini listo para producción?
Gemini está en v1beta y la compatibilidad con Cloud está pendiente; OpenAI está en GA y ofrece ZDR, HIPAA y procesamiento regional.
¿Sigo necesitando Jev o un clasificador local?
Jev publica un precio de $0.042 por 1M y lidera algunas pruebas de selección de herramientas; inclúyelo en la comparativa cuando el coste por tarea sea el factor dominante.
¿Qué hago con una confianza baja?
Define los umbrales a partir de datos etiquetados, ejecuta automáticamente por encima del umbral, envía la franja intermedia a un modelo más grande y deriva los bloqueos a revisión humana, siempre con una opción other.
Lecturas relacionadas: