 AIREITER
Google lanzó Gemini Decisions API el 11 de noviembre de 2026. Su modelo Gemini Decision 1 evalúa decisiones con opciones cerradas en una sola llamada. La clave para saber si supera a OpenAI en tu caso no está solo en el precio: también hay que mirar cómo se factura la caché.
Cuánto cuesta una llamada a Gemini Decisions API
Gemini Decisions API cuesta $0.10 por cada 1 millón de tokens de entrada y no cobra tokens de salida. La entrada multimodal compartida se factura una sola vez por solicitud, independientemente del número de preguntas evaluadas. Cada pregunta adicional solo suma sus propios tokens de instrucciones y criterios.
Google presenta Gemini Decision 1 como casi 5 veces más barato que Gemini 3.5 Flash-Lite con Interactions API en un conjunto de benchmarks compartido. No hay cargos por tokens de salida, facturación variable por tokens de razonamiento ni costes separados de transcripción de audio u OCR. Para crear prototipos, Google AI Studio ofrece un nivel gratuito de la API.
| Carga de trabajo (500 tokens de entrada facturables por solicitud) | Solicitudes mensuales | Tokens de entrada | Coste a $0.10/1M |
|---|---|---|---|
| Enrutamiento de intención en soporte | 10,000 | 5M | $0.50 |
| Filtro de moderación | 100,000 | 50M | $5.00 |
| Capa de selección de herramientas para agentes | 1,000,000 | 500M | $50.00 |
La fórmula es requests x average billed input tokens / 1,000,000 x $0.10. Como la evidencia compartida se factura una sola vez, incluir 50 comprobaciones independientes sobre el mismo ticket en una única solicitud solo añade los tokens específicos de cada pregunta. El ahorro procede del procesamiento por lotes, no de un descuento por pregunta.
Qué puede decidir Gemini Decision 1
Gemini Decision 1 (ID de modelo gemini-decision-1) es un clasificador y evaluador diseñado para este fin, no un modelo conversacional. Una solicitud admite una única entrada multimodal compartida de hasta 256K tokens y hasta 1.000 preguntas independientes. Cada respuesta incluye probabilidades y una puntuación de confianza entre 0 y 1.
Las modalidades de entrada incluyen texto, imágenes, audio, vídeo y PDF dentro de un mismo bloque compartido, utilizando el mismo formato de bloque Content que Interactions API. La resolución de imágenes y vídeos se puede ajustar, así que reducir la evidencia a miniaturas antes de subirla controla directamente el coste en tokens. Los tres tipos de pregunta pueden combinarse en una sola llamada:
| Tipo | Estructura | Qué devuelve | Ideal para |
|---|---|---|---|
noul (sí/no) | Una condición con descripciones opcionales de verdadero/falso | Probabilidad de que se cumpla la condición | Comprobaciones de políticas, detección de derrames y filtros de relevancia |
choice (opción múltiple) | Entre 2 y 255 opciones con nombre y criterios | Opción ganadora y probabilidades normalizadas de cada candidata | Enrutamiento de modelos, colas y selección de la siguiente acción |
score (rúbrica ordenada) | Niveles ordenados que comienzan en 0 | Puntuación ponderada continua y probabilidades por nivel | Gravedad, urgencia y calidad de leads |
Google informa de un tiempo de cómputo mediano del modelo de 50–100 ms y una latencia de extremo a extremo de 150–250 ms. Las mediciones cubren entradas multimodales y contextos de hasta 16K tokens, y Google afirma que la latencia se mantiene prácticamente plana entre 1 y 100 preguntas por solicitud. En benchmarks de enrutamiento de agentes, razonamiento, clasificación y comprensión multimodal, la compañía asegura que Gemini Decision 1 lidera el conjunto y ofrece el menor error de calibración. Hasta que aparezcan mediciones independientes, conviene tratar ambas afirmaciones como benchmarks del fabricante.
Gemini Decisions API frente a OpenAI Decisions API
La comparación más cercana es Decisions API de OpenAI, lanzada unas semanas antes con el mismo precio anunciado. Gemini Decisions API iguala a OpenAI en $0.10 por cada 1 millón de tokens de entrada y salidas tipadas gratuitas, pero se distancia en capacidad, modalidades y caché.
| Aspecto | Gemini Decisions API | OpenAI Decisions API |
|---|---|---|
| Modelo | gemini-decision-1 | Clase gpt-6-luna |
| Precio anunciado | $0.10 / 1M de entrada, $0 de salida | $0.10 / 1M de entrada, $0 de salida |
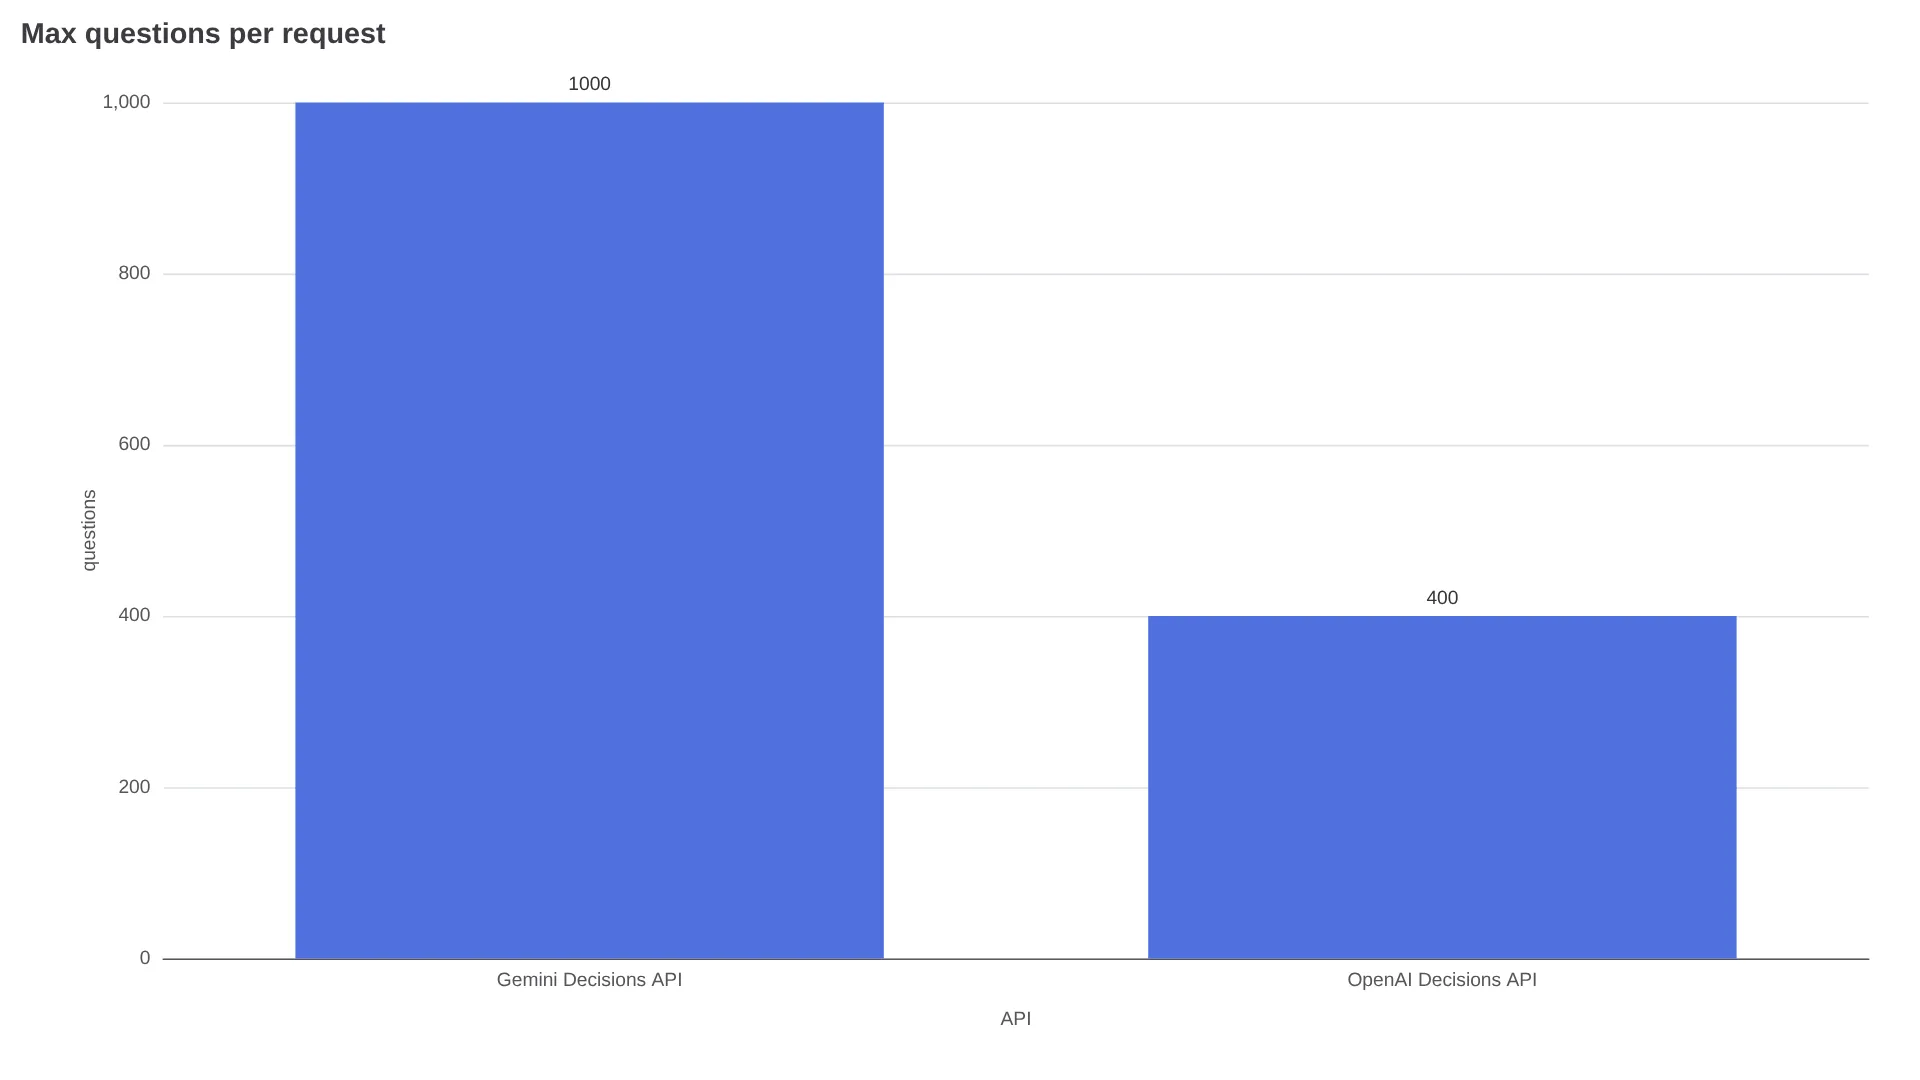
| Máximo de preguntas por solicitud | 1,000 | 400 |
| Tipos de pregunta | sí/no, opción (2–255), puntuación con rúbrica | predicado, opción, puntuación (2–10 niveles) |
| Modalidades de entrada | Texto, imágenes, audio, vídeo y PDF (contexto de 256K) | Texto, imágenes (URL y base64), JSON nativo, historial de conversación y salidas de herramientas; sin audio ni archivos |
| Latencia anunciada | 150–250 ms de extremo a extremo, 50–100 ms de cómputo del modelo | Aproximadamente 10 veces más rápida que Responses (sin p50/p95 publicados) |
| Caché de prompts | No anunciada en la publicación de lanzamiento | Sí: mínimo de prefijo de 1.024 tokens, $0.01/1M de lecturas desde caché |
| Nivel gratuito | Sí, nivel sin coste en AI Studio | No hay un nivel gratuito específico documentado |
| Informes de uso | Uso estándar de Gemini API | GET /v1/organization/usage/decisions con clave de administrador |
La columna de Gemini se basa en la publicación de lanzamiento de Google; la de OpenAI, en la guía de precios de OpenAI Decisions API de AIReiter, que cita documentación oficial de OpenAI.
De la tabla salen tres conclusiones prácticas.
- Elige Gemini Decisions API cuando la evidencia sea multimodal. Puedes combinar una grabación de una llamada con metadatos de la cuenta, o un PDF escaneado de una reclamación con fotos de los daños, en una sola pasada. Con OpenAI, normalmente tendrías que preprocesar esos elementos por separado.
- También encaja mejor en cargas con muchas comprobaciones. Frente a las 400 de OpenAI, sus 1.000 preguntas independientes por solicitud permiten analizar en un mismo ticket la intención de un reembolso, el departamento de destino, la urgencia y decenas de predicados de políticas sin un segundo viaje de red.
- OpenAI conserva una ventaja cuando se reutilizan políticas extensas. La caché reduce el coste de las lecturas a $0.01/1M, algo relevante si cada solicitud vuelve a enviar un documento de políticas de 5.000 tokens y las preguntas son cortas.
Dónde encaja Gemini Decisions API en producción
Según el anuncio de lanzamiento, Google utiliza el endpoint en Notebook para el enrutamiento, Stitch para wireframes, CC para elegir emojis y Search para la seguridad de MCP. El patrón es sencillo: un bloque de evidencia compartido, muchas opciones acotadas y código que decide el siguiente paso a partir de la confianza devuelta. Pero hay una advertencia importante de un ingeniero:
"Lo barato no es lo importante; lo importante es acotar el espacio de salida. La confianza no equivale a precisión: calibra el sistema con muestras reales del negocio y fija umbrales de abstención antes de ponerlo en producción." — @david1989_zhu (traducido del chino)
Construye un conjunto etiquetado con datos reales, incluidos los casos ambiguos; representa las tasas de falsos positivos y falsos negativos para distintos umbrales; y ofrece una ruta explícita de abstención que envíe los resultados de baja confianza a revisión humana. Las tareas que quedan fuera de este contrato —extracción abierta, generación de explicaciones o llamadas a herramientas que necesitan argumentos— siguen correspondiendo a Interactions API, Responses API o function calling.
Cómo llamar a Gemini Decision 1
El endpoint está disponible a través de Gemini API en Google AI Studio, con el modelo gemini-decision-1 y client.decisions.create en los SDK de google-genai. La documentación de Decisions API incluye guías para Python, JavaScript y REST. El ejemplo oficial del contador de la sala de descanso comprueba una foto y una nota de texto frente a los tres tipos de pregunta en una sola solicitud:
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    input=[
        {"type": "image", "uri": "https://storage.googleapis.com/generativeai-downloads/images/spill.jpg", "mime_type": "image/jpeg"},
        {"type": "text", "text": "Breakroom counter check before the 9 AM client meeting."},
    ],
    questions={
        "has_spill": {"type": "noul", "instructions": "Is there an uncleaned liquid spill on the counter?"},
        "next_action": {"type": "choice", "instructions": "Which cleanup action fits the scene?",
            "criteria": {"wipe_with_cloth": "Small counter spill with cloth nearby.",
                         "dispatch_janitorial": "Large floor hazard, broken glass, or active leak.",
                         "ready_for_meeting": "Counter is clean and ready."}},
        "severity": {"type": "score", "instructions": "Rate the severity of the counter mess.",
            "criteria": ["Clean and ready.", "Minor localized spill.", "Major spill or safety hazard."]},
    },
)
print(result)
Google enumera integraciones con OpenRouter, LangChain, Vercel, LiteLLM, Pydantic AI, Pipecat, LiveKit y OpenCode, además de soporte para Google Cloud próximamente. Si ya has construido sobre el endpoint de OpenAI, la estrategia de migración es clara: empieza por trasladar las barreras multimodales y las cargas con muchas comprobaciones; mantén en OpenAI las cargas con políticas largas cuando se apliquen descuentos de caché; y vuelve a calibrar los umbrales desde cero. Las escalas de confianza no son transferibles entre proveedores.
| Tu carga de trabajo | Usa esto |
|---|---|
| Clasificar, enrutar o puntuar con opciones cerradas | Gemini Decisions API |
| La evidencia incluye audio, vídeo o PDF | Gemini Decisions API |
| Más de 400 comprobaciones independientes por elemento | Gemini Decisions API |
| Se reenvía una política extensa en cada llamada | Prueba primero las lecturas desde caché de OpenAI |
| Necesitas explicaciones, extracción o argumentos para herramientas | Interactions / Responses / function calling |
| Acciones destructivas o relacionadas con cumplimiento | Decisions solo como filtro y con revisión humana |
¿Tiene Gemini Decisions API un nivel gratuito?
Sí. Google AI Studio ofrece un nivel sin coste para crear prototipos.
¿Admite caché de prompts Gemini Decisions API?
La publicación de lanzamiento no menciona ninguna opción de caché a fecha del 12 de noviembre de 2026.
¿Cuántas preguntas caben en una solicitud de Gemini Decisions API?
Hasta 1.000 preguntas independientes sobre una única entrada compartida de hasta 256K tokens.
¿Qué latencia debería presupuestar el código de producción?
Presupuesta 250 ms de extremo a extremo hasta que hayas medido tu propio p95 regional.
¿Sigo necesitando Interactions API?
Sí, para redactar texto, extraer campos arbitrarios, explicar decisiones o generar argumentos para herramientas.