 AIREITER
Una decisión de enrutamiento de 500 tokens cuesta $0.00005 con la tarifa estándar. Eso hace que la API Decisions de OpenAI sea lo bastante barata para usarla como filtro a gran escala, pero no necesariamente lo bastante fiable para acciones de alto impacto: sus probabilidades deben calibrarse con tus propios datos etiquetados.
La factura empieza en fracciones de céntimo, no en una tarifa por llamada
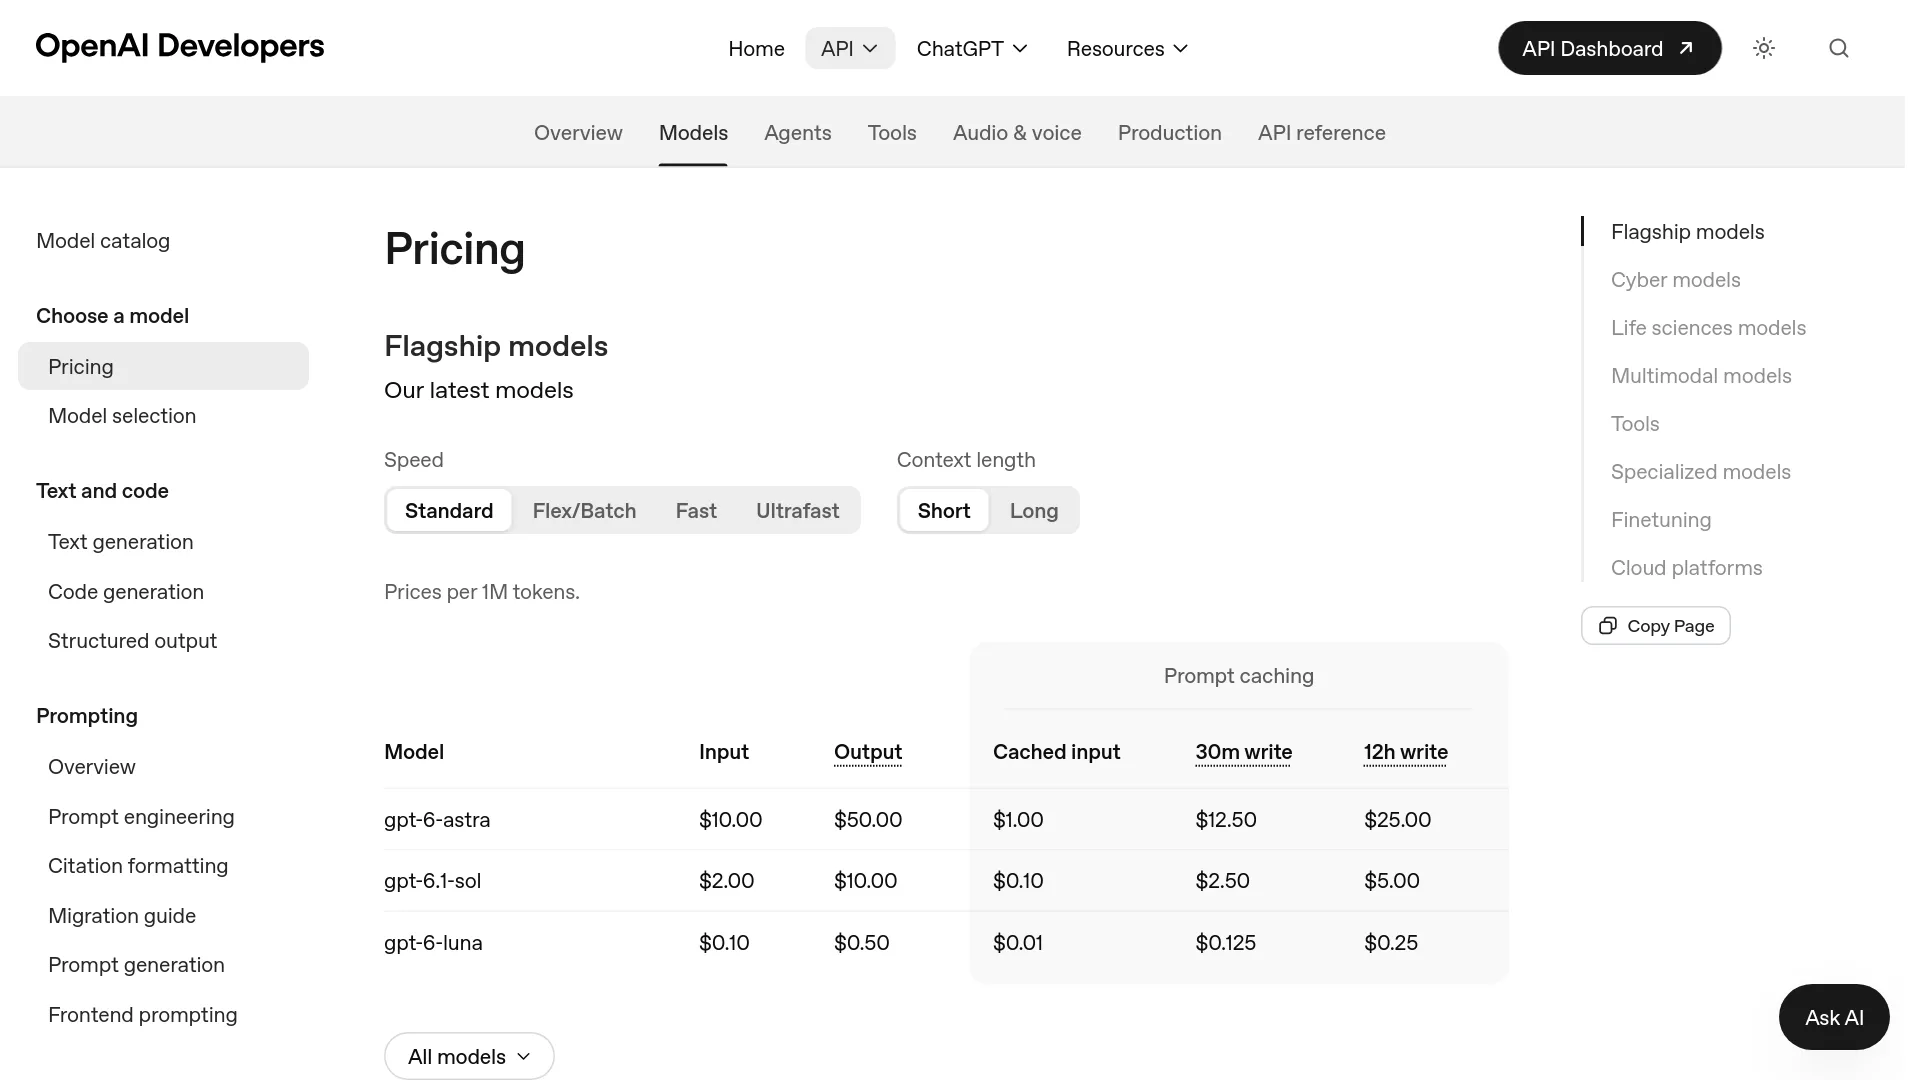
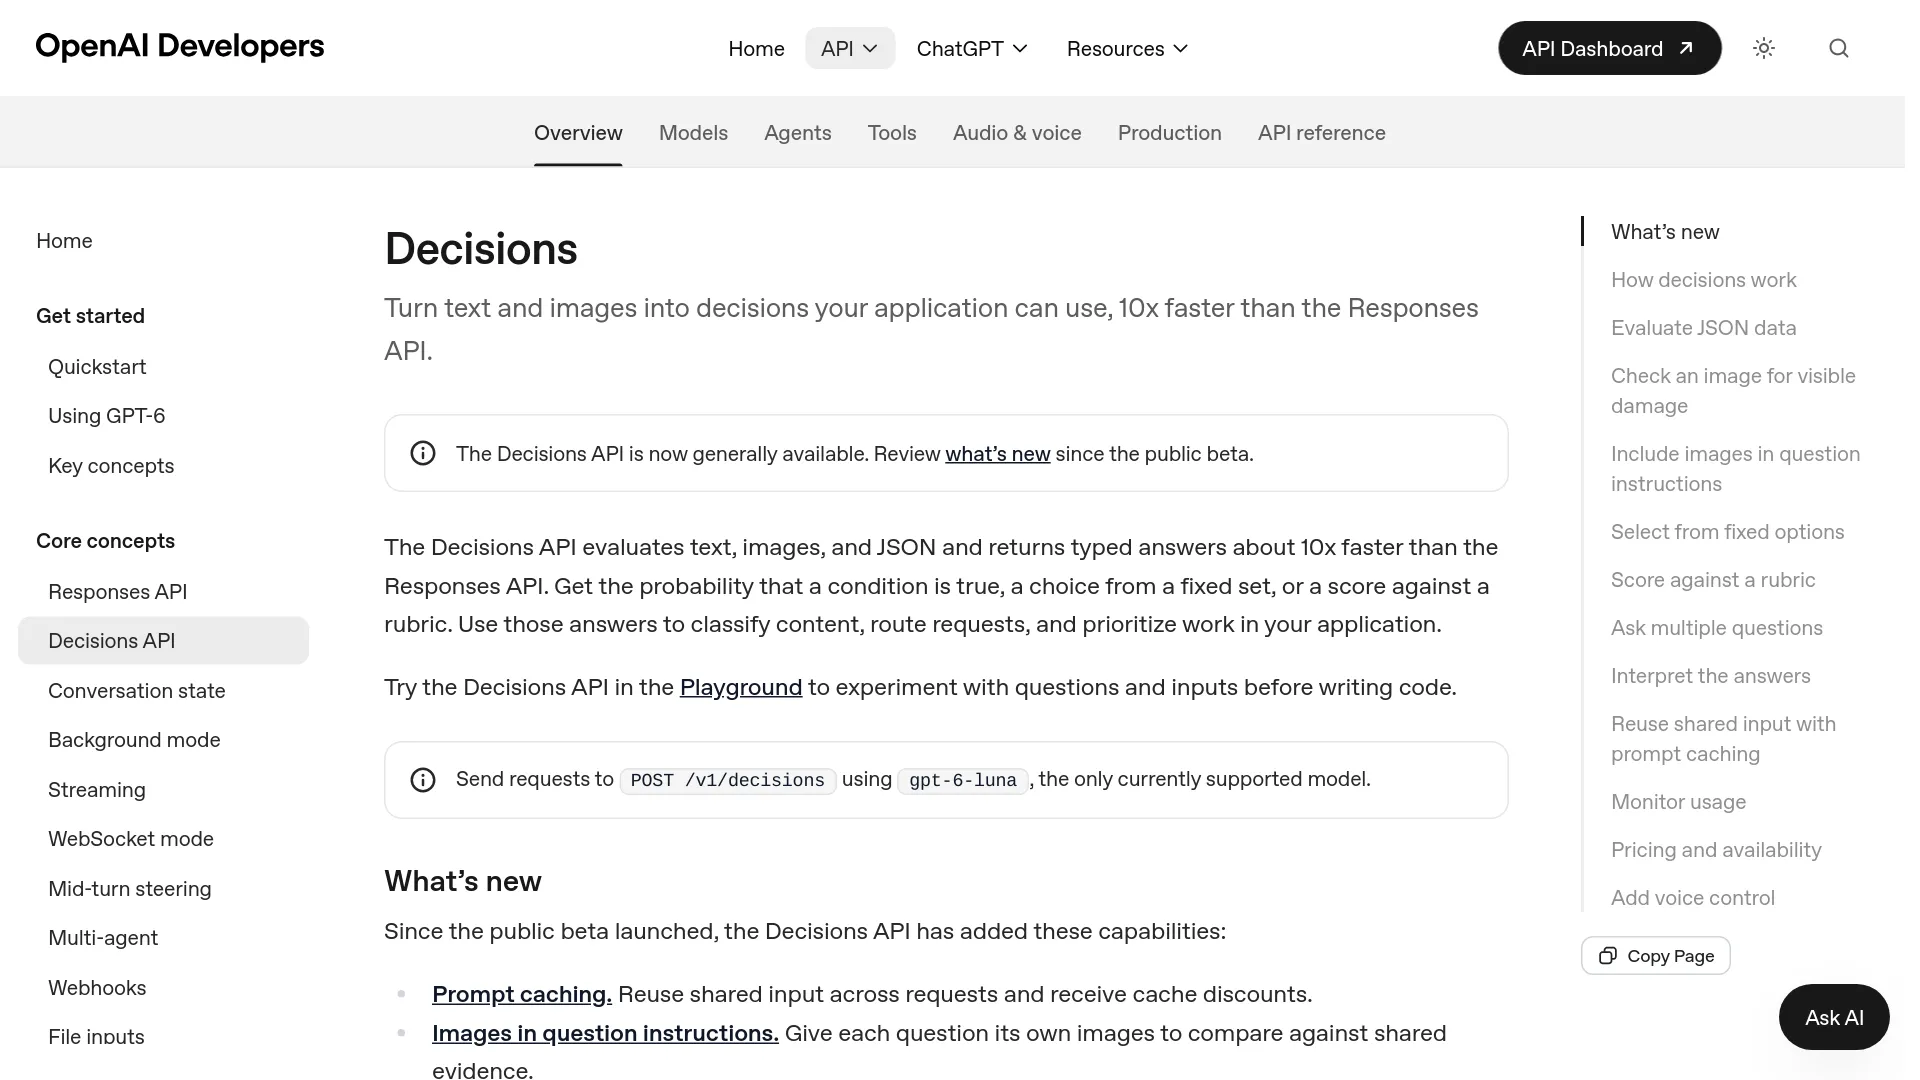
El precio de la API Decisions de OpenAI es de $0.10 por cada 1 millón de tokens de entrada no almacenados en caché, mientras que los tokens de salida son gratuitos. OpenAI describe ahora este endpoint como disponible de forma general, impulsado únicamente por gpt-6-luna y accesible mediante POST /v1/decisions en la guía actual de Decisions.
La tabla de precios publicada no contempla una tarifa adicional por solicitud. La fórmula básica es:
coste mensual = solicitudes × tokens de entrada facturables de media ÷ 1,000,000 × $0.10
Ejemplos con 10.000, 100.000 y 1 millón de solicitudes
Para una carga de trabajo con una media de 500 tokens de entrada por solicitud:
| Solicitudes mensuales | Tokens de entrada | Coste estándar de entrada | Coste por solicitud |
|---|---|---|---|
| 10,000 | 5 millones | $0.50 | $0.00005 |
| 100,000 | 50 millones | $5.00 | $0.00005 |
| 1,000,000 | 500 millones | $50.00 | $0.00005 |
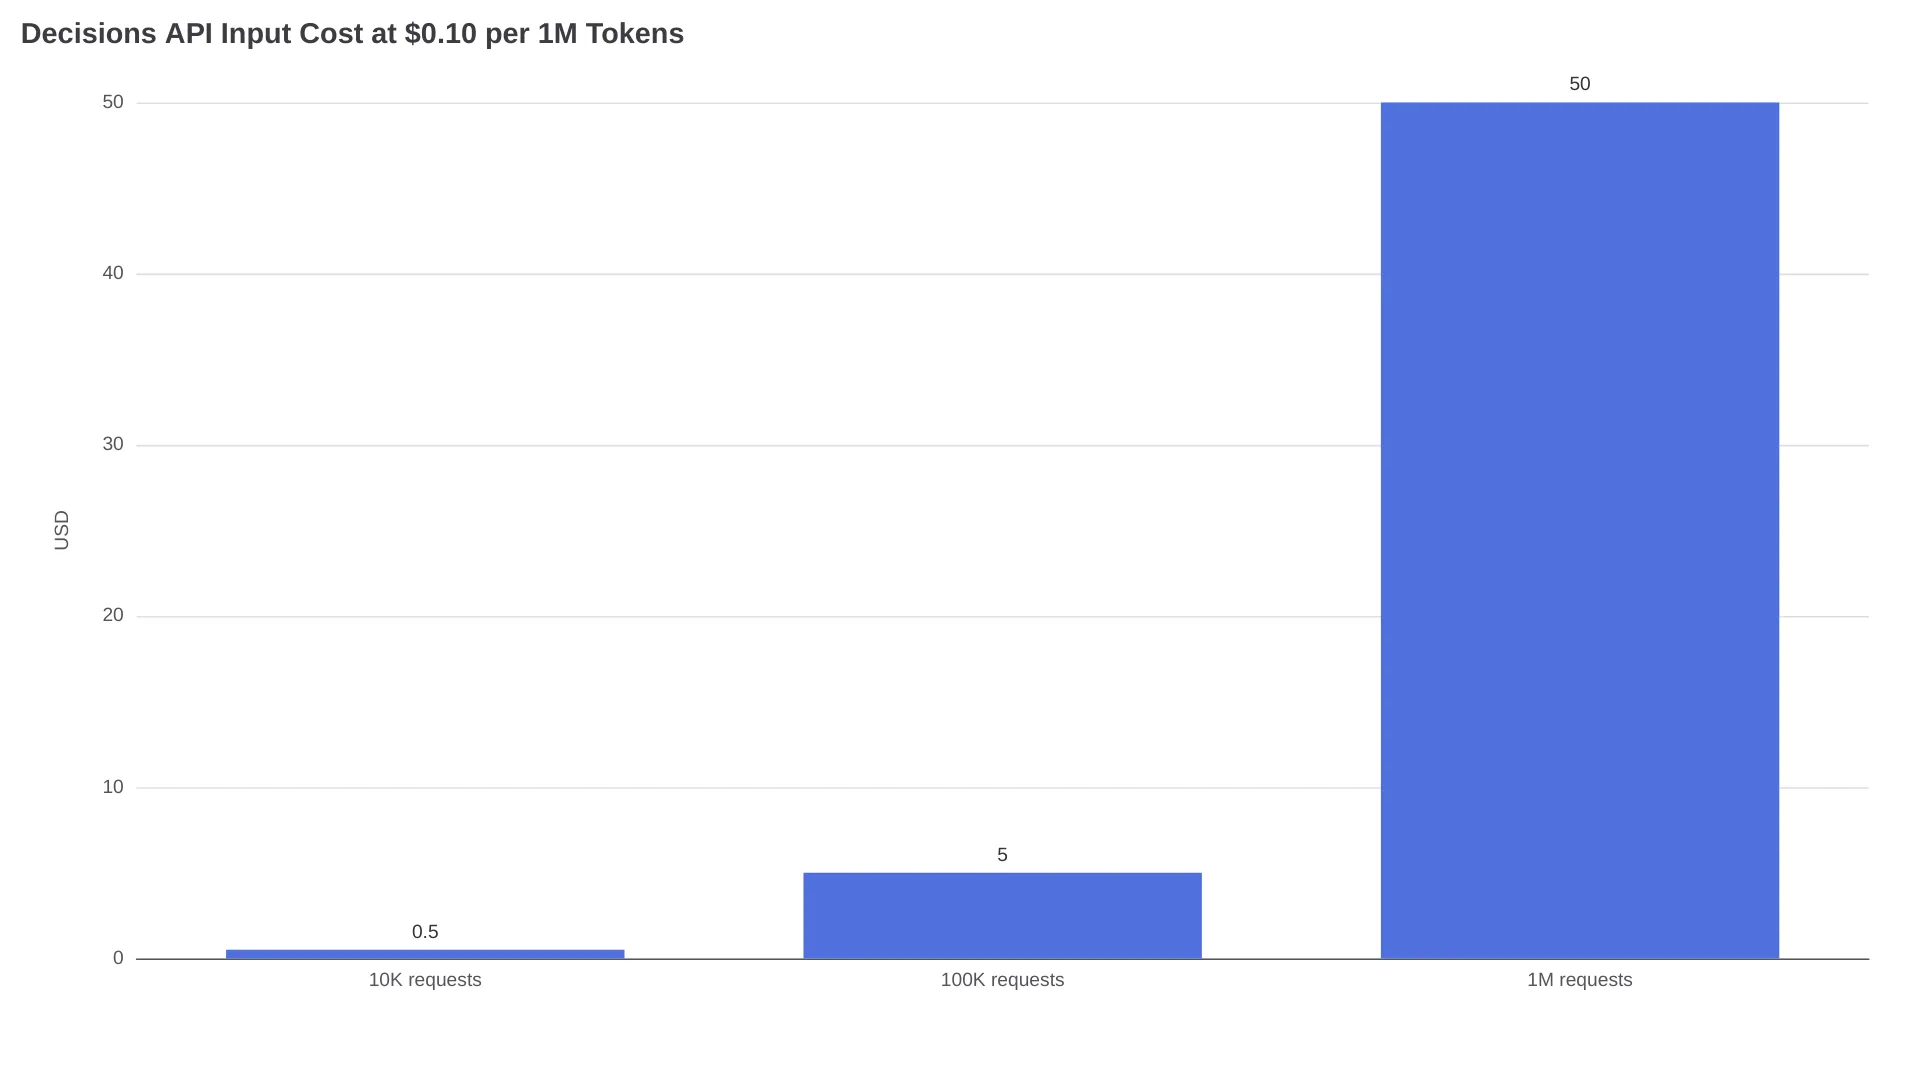
Las salidas de tipo predicate, choice y score no añaden ningún cargo por tokens de salida. Un JSON equivalente generado con Responses se factura según la tarifa de salida del modelo; la tabla de precios de OpenAI sitúa la salida estándar de gpt-6-luna en $0.50 por millón de tokens.
Lecturas y escrituras de caché, procesamiento regional y contexto largo
El precio de referencia de $0.10 no es la única tarifa de entrada posible. La guía actual indica que las lecturas de la caché de prompts tienen un precio reducido, mientras que las escrituras usan las tarifas estándar de escritura en caché de gpt-6-luna. La tabla de tarifas de OpenAI fija la entrada estándar almacenada en caché de Luna en $0.01 por millón de tokens, la escritura en caché durante 30 minutos en $0.125 y la escritura durante 12 horas en $0.25 por millón de tokens.
La caché solo empieza a aplicarse cuando el prefijo compartido reutilizable contiene al menos 1,024 tokens. Las preguntas no cuentan para alcanzar ese mínimo y las imágenes específicas de cada pregunta quedan fuera del prefijo reutilizable. Las lecturas y escrituras de caché ya están incluidas en usage.input_tokens; volver a sumarlas duplicaría el uso contabilizado, según la sección sobre caché de prompts.
Los endpoints regionales o con residencia de datos pueden aplicar un recargo del 10% en los modelos nuevos que cumplan los requisitos. La sección oficial sobre precios y disponibilidad también advierte de que pueden aplicarse multiplicadores por contexto largo. Consulta la tabla de tarifas vigente antes de comprometer una carga de trabajo sujeta a requisitos de cumplimiento, porque ambos modificadores pueden alterar el cálculo sencillo de $0.10.
Un endpoint limitado a propósito
La API Decisions convierte la información recibida en uno de tres resultados tipados. Es un clasificador y un sistema de puntuación, no una alternativa más barata a un endpoint de respuestas de propósito general.
| Tipo de pregunta | Devuelve | Buen uso | Mal uso |
|---|---|---|---|
predicate | Probabilidad de 0 a 1 | Filtro de fraude, comprobación de daños visibles, filtro de relevancia | Una explicación escrita de la decisión |
choice | Una opción proporcionada, probabilidades de las opciones y confianza | Enrutamiento de colas, categoría de documentos, siguiente acción | Una categoría desconocida o generada dinámicamente |
score | Puntuación ponderada, probabilidades por nivel y confianza | Gravedad, urgencia, calidad de un lead | Extraer nombres, fechas o campos arbitrarios |
Una puntuación admite entre 2 y 10 niveles ordenados. Cada solicitud puede incluir entre 1 y 400 preguntas, pero solo conviene agrupar preguntas independientes. Si la segunda pregunta depende de la respuesta a la primera, OpenAI recomienda hacer una segunda solicitud después de recibir la primera respuesta.
Varias preguntas independientes pueden reutilizar la misma información. Por ejemplo, un único ticket de soporte puede analizarse para detectar intención de reembolso, enviarse al departamento adecuado y puntuar su urgencia sin reenviar el ticket tres veces. La guía de uso señala que num_model_requests cuenta la solicitud, no sus preguntas.
Qué ha cambiado desde la beta pública
La lista actual de novedades sustituye varios límites de la etapa de lanzamiento:
- El límite de preguntas aumentó de 200 a 400.
- La caché de prompts está disponible para entradas compartidas.
- Las entradas pueden incluir JSON nativo, historial de conversación, registros de llamadas a funciones y resultados de herramientas correspondientes.
- Las imágenes pueden utilizar URLs públicas HTTP/HTTPS o base64 inline;
file_id, audio, archivos y referencias a elementos siguen sin estar disponibles. - Los informes de la organización están disponibles en
GET /v1/organization/usage/decisions; requieren una clave de administrador conapi.usage.ready permiten agrupar los resultados por proyecto, clave de API o modelo.
Elige Decisions o Responses según el formato de salida
Usa la API Decisions cuando el código de la aplicación ya conoce el formato de respuesta permitido. Recurre a Responses cuando el modelo tenga que componer información, y a las llamadas a funciones cuando deba seleccionar una herramienta y proporcionar sus argumentos.
| Necesidad | Opción predeterminada | Motivo |
|---|---|---|
| Filtro sí/no con probabilidad | Decisions | Salida predicate nativa; no hay cargo por una respuesta generada |
| Seleccionar una ruta conocida | Decisions | Devuelve la probabilidad de cada opción y la confianza |
| Clasificar según una rúbrica ordenada | Decisions | Puntuación ponderada y distribución por niveles nativas |
| Devolver campos JSON arbitrarios | Responses con Structured Outputs | Decisions no admite un esquema JSON de salida personalizado |
| Explicar por qué se rechazó un elemento | Responses | Decisions no genera explicaciones en prosa |
| Elegir una herramienta y crear sus argumentos | Function calling | Decisions selecciona una respuesta, pero no genera argumentos para herramientas |
Con 100.000 llamadas de 400 tokens de entrada cada una, la entrada de Decisions cuesta $4. Si una llamada equivalente a Responses genera 30 tokens de salida por llamada, las tarifas publicadas de Luna se traducen en $4 de entrada más $1.50 de salida, es decir, $5.50 antes de contar los tokens de razonamiento. La elección del endpoint sigue dependiendo de si la aplicación necesita campos generados o explicaciones.
Ambos endpoints reciben ahora descuentos por las lecturas de caché. Mide los tokens servidos desde la caché en el objeto de uso de la respuesta en lugar de estimarlos a partir de la longitud del prompt.
Los errores baratos también salen caros
Una factura reducida de tokens no compensa el coste de aprobar algo por error, ejecutar una acción de moderación incorrecta o enviar un pago a la ruta equivocada. La guía de OpenAI para interpretar las respuestas recomienda fijar los umbrales con ejemplos etiquetados y ponderar de forma distinta el coste de los falsos positivos y los falsos negativos.
La comunidad de desarrolladores también ha señalado este riesgo. En un hilo de Reddit orientado a la producción sobre las API de decisiones, u/Ctbhatia escribió:
“un filtro que dice omitir es mejor que uno que se equivoca.” Fuente: u/Ctbhatia en r/LLMDevs
La confianza y las probabilidades de la API son señales, no una garantía de calibración publicada. Un resultado con una confianza de 0.90 no debe interpretarse como correcto el 90% de las veces hasta comprobar esa relación con datos representativos.
OpenAI afirma en la guía oficial que Decisions es aproximadamente 10 veces más rápida que Responses, pero no publica datos p50, p95, región, tamaño de la carga ni configuración de comparación. Haz las pruebas desde la región de despliegue prevista antes de fijar un presupuesto de latencia.
Control de producción: calibra, abstente y después automatiza
- Crea un conjunto etiquetado a partir de la carga de trabajo real, incluidos los casos ambiguos y los fallos más costosos.
- Ejecuta las mismas preguntas sobre ese conjunto y representa las tasas de falsos positivos y falsos negativos con distintos umbrales.
- Añade una vía explícita de abstención en el código de la aplicación. Las respuestas con poca confianza o contradictorias deberían pasar a revisión humana en lugar de forzar una ruta.
- Supervisa el uso de tokens y el número de solicitudes con
GET /v1/organization/usage/decisionsy audita una muestra de los resultados automatizados después del lanzamiento.
Tabla para decidir el despliegue
La API Decisions de OpenAI es la opción predeterminada adecuada para evaluaciones breves, acotadas y de gran volumen dentro de un stack existente de OpenAI. El precio, por sí solo, no es motivo suficiente para migrar.
| Carga de trabajo | Recomendación | Condición principal |
|---|---|---|
| Enrutamiento de soporte o leads | Usa Decisions | Las categorías son fijas y hay ejemplos etiquetados disponibles |
| Detección de daños en imágenes | Prueba Decisions | Compara la precisión con imágenes; ahora admite URLs alojadas |
| Política larga más elemento breve | Prueba ambos endpoints | Verifica los tokens reales servidos desde la caché y la latencia |
| Cumplimiento o acción destructiva | Usa Decisions solo como filtro | Exige abstención, revisión y umbrales asimétricos |
| Extracción más explicación | Usa Responses | Una llamada más completa puede evitar una segunda solicitud de generación |
| Selección de herramientas con argumentos | Usa function calling | El formato de salida encaja directamente con la acción |
| Carga de trabajo en la UE o regulada | Considera Decisions | Confirma los requisitos, la residencia y el recargo regional |
Preguntas frecuentes sobre los precios de la API Decisions de OpenAI
¿La API Decisions se cobra por solicitud o por token?
Se cobra por los tokens de entrada, no por solicitud. La entrada estándar no almacenada en caché cuesta actualmente $0.10 por 1 millón de tokens, sujeta a las condiciones de caché y a los modificadores regionales o de contexto largo que correspondan.
¿Los tokens de salida de la API Decisions son gratuitos?
Sí. La guía oficial de Decisions indica que los tokens de salida no se cobran.
¿Existe un nivel gratuito?
La documentación actual de Decisions de OpenAI no menciona un nivel gratuito específico. Los créditos de la cuenta o las condiciones contractuales pueden seguir afectando a lo que paga una organización.
¿La caché de prompts funciona con la API Decisions?
Sí. Los prefijos de entrada compartida de al menos 1,024 tokens pueden cumplir los requisitos, y OpenAI sitúa por defecto un punto de corte implícito al final de la entrada compartida. El contenido de las preguntas y las imágenes específicas de cada pregunta no forman parte de ese prefijo reutilizable.
¿Decisions es más barata que la API Responses?
Por lo general, sí, en clasificaciones breves y acotadas que no necesitan texto generado. La ventaja puede reducirse cuando Responses produce muy poca salida o desaparecer si el flujo necesita una segunda llamada para extraer información o generar una explicación.
¿Cuántas preguntas caben en una solicitud?
El límite actual es de 1 a 400 preguntas. Las preguntas independientes pueden compartir la entrada; las dependientes requieren solicitudes separadas.
¿Se admiten imágenes y cómo se cobran?
Sí. Decisions acepta URLs de imágenes alojadas mediante HTTP/HTTPS e imágenes base64 inline, y la entrada visual contribuye al uso de entrada facturable. Las referencias de imágenes mediante file_id no son compatibles.
¿El procesamiento regional cuesta más?
Puede costar más. La página de precios de OpenAI aplica un recargo del 10% a los endpoints regionales y con residencia de datos que cumplan los requisitos en modelos nuevos; verifica la tarifa vigente para la región de destino antes del despliegue.