 AIREITER
Qwen3.8-Max ya está disponible de forma general con una tarifa de $2 por millón de tokens de entrada y $6 por millón de tokens de salida. Solo por salida, queda al menos cuatro veces por debajo de Claude Opus 4.8, Claude Fable 5 y GPT-5.6 Sol. Hay una salvedad importante: llega con reasoning_effort configurado en xhigh, así que el precio anunciado puede alejarse de la factura real desde la primera petición.
Tarifas por token de Qwen3.8-Max
Qwen3.8-Max es un modelo mixture-of-experts de 2.4 billones de parámetros, con 95.000 millones de parámetros activos por token. Sustituye a Qwen3.7-Max como modelo insignia de Alibaba. Estas son las tarifas que publica la página del modelo de Alibaba, actualizada el 2 de agosto de 2026:
| Concepto | Precio por 1M de tokens |
|---|---|
| Entrada | $2.00 |
| Salida | $6.00 |
| Entrada (caché implícita) | $0.25 |
| Creación de caché explícita | $2.50 |
| Lectura de caché explícita | $0.17 |
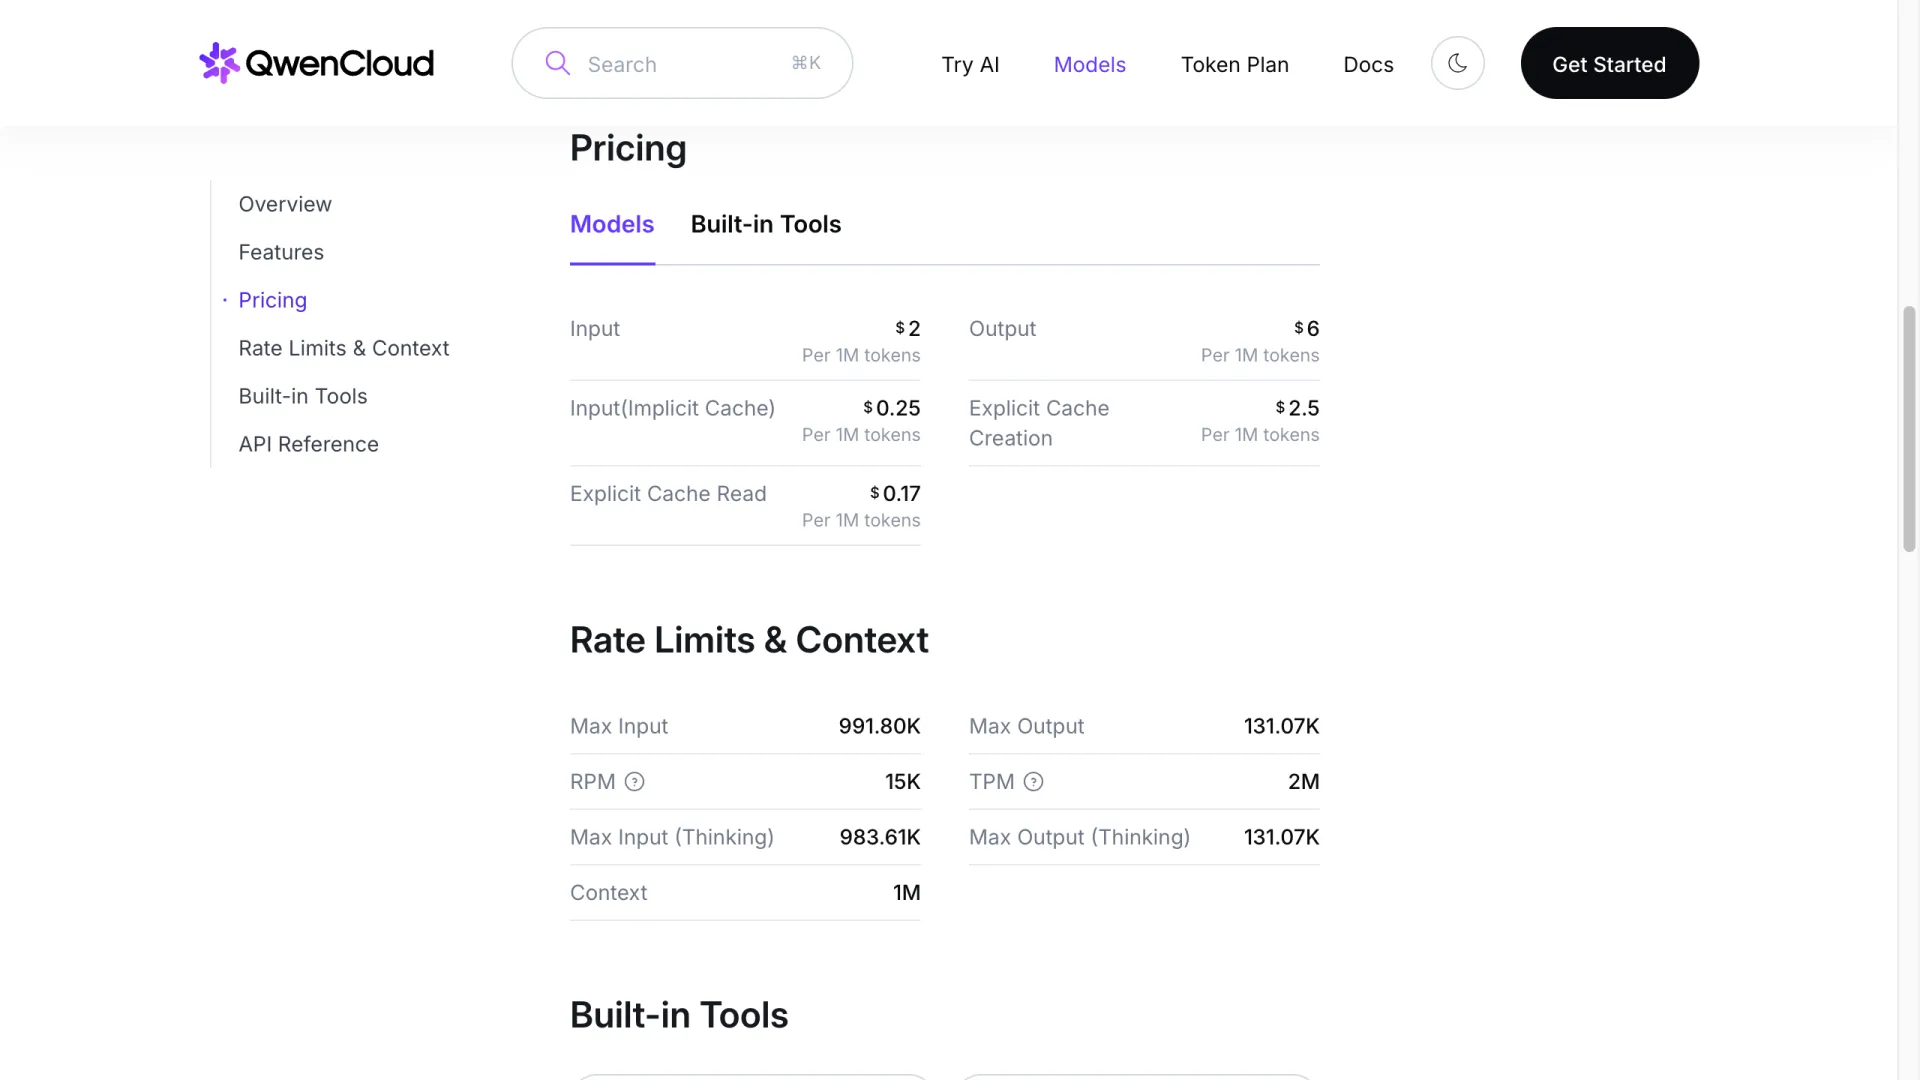
La caché implícita no requiere implementación: los prefijos repetidos se cobran automáticamente a $0.25, una octava parte de la tarifa estándar de entrada. La caché explícita sí exige decidir si merece la pena. Cuesta $2.50 escribirla y $0.17 leerla; mejora frente a una entrada sin caché a partir de la segunda lectura, pero no supera los $0.25 de la caché implícita hasta aproximadamente la trigésima lectura del mismo prefijo. Para la mayoría de aplicaciones, lo razonable es no tocar la caché explícita.
Hay un límite relevante: la API está abierta, pero los pesos no. La publicación de lanzamiento de Alibaba indica que los pesos de Qwen3.8-Max llegarán a Hugging Face y ModelScope la semana que viene. Es el primer compromiso de calendario tras semanas de un «próximamente» sin fecha. A 3 de agosto, la barra lateral de la página del modelo seguía mostrando Open Source: No.
El precio de salida de $6 no cuenta toda la historia
La documentación de lanzamiento de Alibaba ofrece tres niveles para reasoning_effort y establece xhigh como predeterminado. Es el más profundo, por encima de medium, que «equilibra precisión y velocidad», y low, «optimizado para velocidad y coste». Además, preserve_thinking viene activado por defecto en todos los escenarios. Los tokens de razonamiento se facturan como tokens de salida, de modo que ambas opciones llevan gasto a la tarifa de $6 antes incluso de escribir un prompt.
En otras palabras, los dos controles que determinan el coste efectivo vienen configurados en contra del ahorro, aunque los dos se cambian con un parámetro de la petición. Pasar a medium o low marca la diferencia entre pagar $6 por millón por razonamiento profundo que quizá no necesitas, o reservarlo para las tareas que realmente lo justifican.
Uno de los primeros usuarios fue tajante en el título de un hilo de r/LocalLLaMA:
Primeras impresiones de Qwen 3.8 max: el modelo es normalito y su razonamiento es pésimo
No es un resultado de benchmark, sino un motivo para probar cada nivel de esfuerzo con tu propia carga de trabajo antes de adoptar la configuración predeterminada.
Sin recargo por contexto largo: dónde se nota
La página de Qwen3.8-Max muestra una única tarifa de entrada y otra de salida, sin tramos según el tamaño del contexto. Gemini 3.1 Pro y GPT-5.6 Sol, en cambio, pasan a una banda más cara al superar un umbral de contexto:
| Modelo | Entrada (ctx. corto) | Salida (ctx. corto) | Entrada (ctx. largo) | Salida (ctx. largo) |
|---|---|---|---|---|
| Qwen3.8-Max | $2.00 | $6.00 | $2.00 (hasta 1M) | $6.00 (hasta 1M) |
| Gemini 3.1 Pro | $2.00 (≤200K) | $12.00 | $4.00 (>200K) | $18.00 |
| GPT-5.6 Sol | $5.00 | $30.00 | $10.00 | $45.00 |
Gemini 3.1 Pro iguala exactamente el precio de entrada de Qwen3.8-Max hasta los 200K tokens y luego lo duplica. GPT-5.6 Sol duplica la entrada y aumenta la salida en un 50% al entrar en su tramo de contexto largo, sobre una tabla de precios que ya había sido reestructurada.
Por tanto, la diferencia crece con la longitud del contexto en lugar de mantenerse estable. Un prompt de 400K tokens supone $0.80 de entrada en Qwen3.8-Max, $1.60 en Gemini 3.1 Pro y $4.00 en GPT-5.6 Sol. Es una diferencia que se acumula en pipelines documentales, sesiones largas de agentes y análisis de repositorios completos. En turnos cortos de chat apenas importa.
Cómo queda en precio frente a los rivales comparados por Alibaba
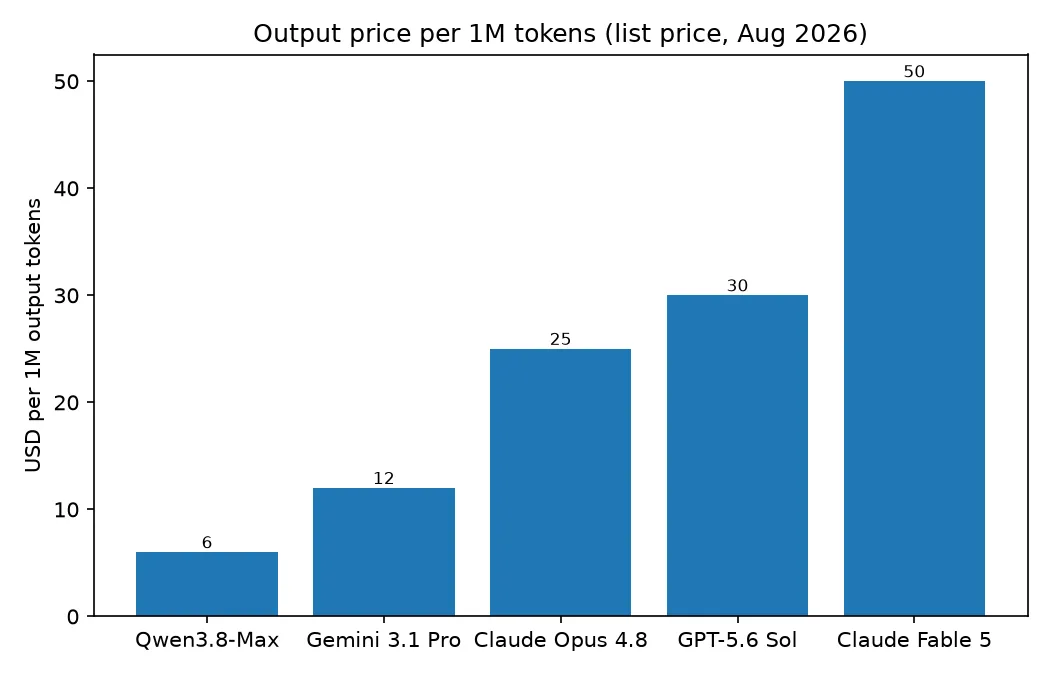
Los $6 de salida de Qwen3.8-Max son menos de una cuarta parte de los $25 de Claude Opus 4.8 y una quinta parte de los $30 de GPT-5.6 Sol. Claude Fable 5, con $50, cuesta más de ocho veces esa tarifa. Que compense asumir esa brecha dependerá de las capacidades, y Alibaba publicó una tabla de 28 benchmarks para defender que sí lo hace:
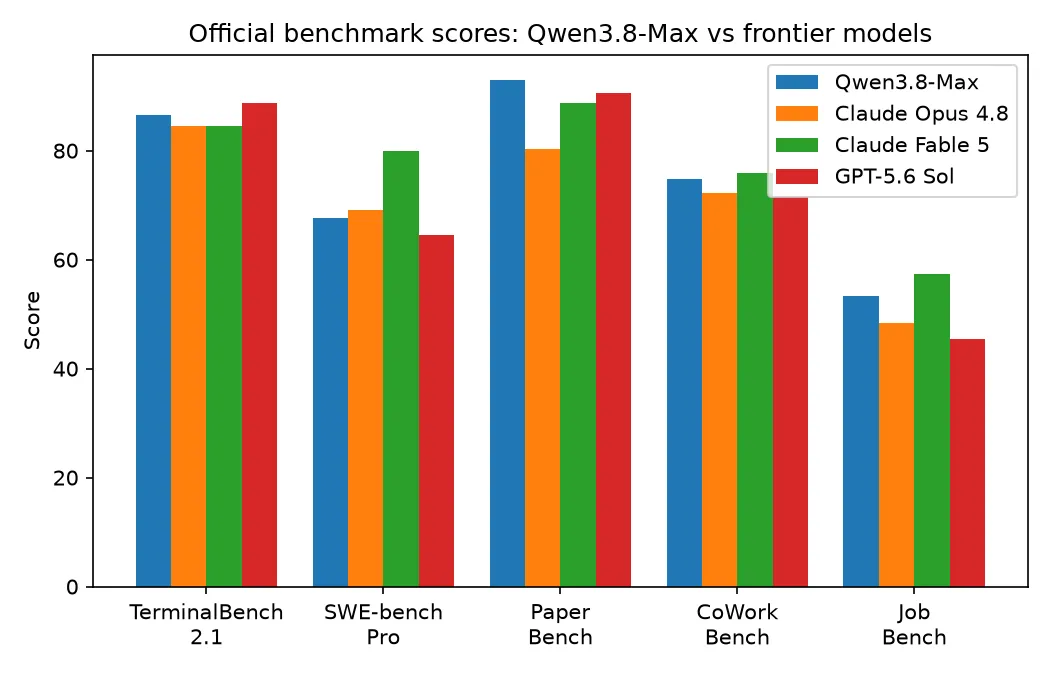
Lidera PaperBench con 93.0, frente a 90.5 de GPT-5.6 Sol y 88.8 de Fable 5; también encabeza JobBench con 53.4 frente a los 48.4 de Opus 4.8, y supera por poco a ambos Claude en Terminal Bench 2.1, con 86.6. En SWE-bench Pro pierde claramente: el 80.0 de Fable 5 está a más de doce puntos de su 67.7. Todas estas cifras proceden de pruebas realizadas y publicadas por el propio proveedor en esa misma página.
La decisión queda bastante delimitada. En trabajo agéntico con mucha salida —bucles largos de llamadas a herramientas, generación de documentos o el tipo de reproducción de investigación que mide PaperBench—, un descuento de salida de entre 4 y 8 veces cambia por completo la economía de ejecutar el sistema. En ingeniería de software a escala de repositorio, el terreno que explora SWE-bench Pro, el descuento implica una caída real de capacidad; ahí sigue teniendo sentido pagar las tarifas de Fable 5.
Probarlo con tu propia carga de trabajo es sencillo: la publicación de lanzamiento de Alibaba documenta llamadas chat-completions y responses compatibles con OpenAI, además de una interfaz compatible con Anthropic. Son las mismas dos formas de petición que aceptan Claude Opus 4.8 y GPT-5.6 Sol.
Qué conviene cambiar hoy en tu código
El identificador del modelo es qwen3.8-max. A 3 de agosto es la única entrada 3.8 del catálogo de modelos de Alibaba: el identificador de vista previa qwen3.8-max-preview ha desaparecido. Revisa tu proveedor de relay antes de dar por hecho que el descuento de preview se mantuvo tras la disponibilidad general.
Ambas interfaces están disponibles desde tres URL base regionales: Pekín, Singapur y Virginia, EE. UU. Estos son los límites que probablemente alcanzarás antes:
| Límite | Valor |
|---|---|
| Ventana de contexto | 1M |
| Entrada máxima | 991.80K |
| Entrada máxima (con razonamiento) | 983.61K |
| Salida máxima | 131.07K |
| Peticiones por minuto | 15K |
| Tokens por minuto | 2M |
Fíjate en la diferencia de aproximadamente 8K tokens entre ambos límites de entrada: activar el razonamiento reduce el margen de entrada, además de añadir tokens de salida. Y si los pesos llegan finalmente la semana que viene, la cifra de 95B parámetros activos será el punto de partida para comparar el autoalojamiento con los $2/$6 de la API.
Preguntas frecuentes
¿La API de Qwen es gratuita?
No. Qwen3.8-Max se factura por token: $2 por millón de tokens de entrada y $6 por millón de tokens de salida. La suscripción Token Plan que se vende en la plataforma API de Alibaba es un producto independiente basado en créditos, distinto de la facturación por token de la API.
¿Cuánto cuesta Qwen Max?
En la generación actual, cuesta $2 por millón de tokens de entrada y $6 por millón de tokens de salida, con caché implícita de prefijo a $0.25. Las entradas antiguas de qwen-max en la documentación de Alibaba Cloud se refieren a generaciones anteriores y tienen tarifas distintas.
¿Qwen3.8-Max cobra más por la ventana de contexto de 1M?
No. La entrada y la salida cuestan lo mismo con 5K tokens que con 900K, la diferencia estructural más clara frente a GPT-5.6 Sol y Gemini 3.1 Pro.
¿Qwen3.8-Max es más barato que Qwen3.7-Max?
No se puede responder a partir de las páginas oficiales. La página del modelo Qwen3.7-Max muestra sus cifras por token como -- bajo un marcador de 50% de descuento, en vez de publicar las tarifas; por tanto, no existe una cifra oficial con la que compararlo.
Lecturas relacionadas
- Precios de Claude Fable 5: el tramo de $10/$50 frente al que se compara
- Cómo reducir el coste de tokens de Claude Fable 5: los mismos controles de esfuerzo y caché en otro proveedor