Google lanzó dos modelos Gemini 4 con solo tres días de diferencia: Carbon el 10 de noviembre de 2026 y Hydrogen el 12 de noviembre. La explicación rápida suele ser «Carbon es más inteligente y Hydrogen es más rápido». El problema es que esa simplificación puede salir cara. En un benchmark de vídeo con información contextual, Hydrogen —un 25 % más barato— acabó generando una factura de $35.35, frente a los $27.94 de Carbon, porque produjo 2,6 veces más tokens de salida.
Los dos modelos están disponibles como gemini-4-carbon y gemini-4-hydrogen a través de Gemini API y AI Studio. También comparten una ventana de contexto unificada de 1.048.576 tokens y aceptan texto, imágenes, audio, vídeo y PDF, con salida de texto (comparativa en directo de OpenRouter). Carbon es el modelo de razonamiento para tareas complejas y de largo recorrido; Hydrogen, su derivado optimizado para la velocidad y la ejecución cotidiana. Según Google, en el anuncio de Carbon y el anuncio de Hydrogen, Hydrogen también puede encargarse de ejecutar el plan creado por Carbon.
El modelo más barato terminó costando más
La prueba pública de extremo a extremo que usamos aquí es el benchmark de Agnify para preguntas y respuestas sobre vídeo con información contextual: identificar el objeto solicitado, delimitarlo en fotogramas clave y seguirlo durante el vídeo. Incluye 300 preguntas, 1,9 horas de vídeo y los mismos 7,6 millones de tokens de entrada para cada modelo. El resultado principal es un empate que deja en evidencia las cuentas basadas únicamente en el precio por token.
| Modelo | HOTA | Objeto correcto | Coste de ejecución | Coste / hora de vídeo |
|---|---|---|---|---|
| GPT-6.1 Terra | 0.6169 | 94.3% | — | $8.19 |
| Gemini 4 Carbon | 0.6016 | 94.3% | $27.94 | $14.60, $29.20 desde el 1 de diciembre |
| Gemini 4 Hydrogen | 0.6006 | 95.1% | $35.35 | ~$18.50 fijo |
| Claude Opus 5.5 | 0.5944 | 92.7% | — | $43 |
Carbon y Hydrogen se separan por solo 0.001 puntos HOTA, con intervalos de confianza superpuestos. Estadísticamente, están empatados entre sí y también con Terra, Sol y Opus 5.5 en esa misma muestra. Sin embargo, Hydrogen generó 3,19 millones de tokens de salida, frente a los 1,23 millones de Carbon, con medianas de la fase 3 de 387 frente a 47 tokens para las cajas de un solo objeto. En un caso con letras de espuma, Hydrogen consumió 62.138 tokens, marcó la letra equivocada y obtuvo 0.36 puntos; Carbon usó 80 tokens y logró 0.70. El informe completo de Agnify calcula que limitar la verbosidad de la fase 3 de Hydrogen al nivel de Carbon reduciría su ejecución a unos $24.
La conclusión de la guía de Vercel sobre cargas de trabajo es aplicable tal cual: que dos modelos cobren lo mismo por token no significa que tengan el mismo coste por tarea. Hay que medir el coste por tarea aceptada, incluidos los reintentos, no solo el coste por millón de tokens.
Qué ha lanzado realmente Google
La guía de Vercel presenta Argon como el punto de partida generalista para tareas de síntesis y trabajo con información (Vercel). Frente a esa referencia, Carbon es el siguiente escalón para depuración difícil y ciencia abierta, mientras que Hydrogen está pensado para trabajos rutinarios y acotados a gran volumen. Los detalles de Argon están en nuestras guías Carbon frente a Argon y Hydrogen frente a Argon.
La arquitectura más interesante está en combinar ambos modelos. El modo Orchestrator de Antigravity permite que Carbon elabore un plan de solo lectura, pase después las ediciones de archivos y las pruebas a Hydrogen y recupere el control si la ejecución se atasca, tal como explican el análisis de enrutamiento eve de Vercel y la introducción a Hydrogen de DataCamp. Esta combinación ofrece, según los datos publicados, una reducción del 24 % en la cuota y una finalización un 19 % más rápida, manteniendo un éxito en Terminal-Bench cercano al de Carbon: se paga una vez al modelo avanzado por diseñar el plan y al modelo rápido por ejecutar el volumen.
Los dos modelos tienen pesos cerrados (OnlySOTA) y ofrecen entrada multimodal, salida de texto y soporte para razonamiento (OpenRouter). Carbon dispone de niveles de razonamiento low, medium y high, con medium como opción predeterminada. Hydrogen añade xhigh y parte de high. Que los niveles tengan el mismo nombre no significa que utilicen la misma capacidad de cómputo en ambos modelos, así que conviene registrar el modelo y el nivel en cada prueba.
El cambio del 1 de diciembre altera las cuentas
La tarifa anunciada para Carbon es promocional. La de Hydrogen es fija, y esa diferencia condiciona más decisiones de compra que cualquier benchmark.
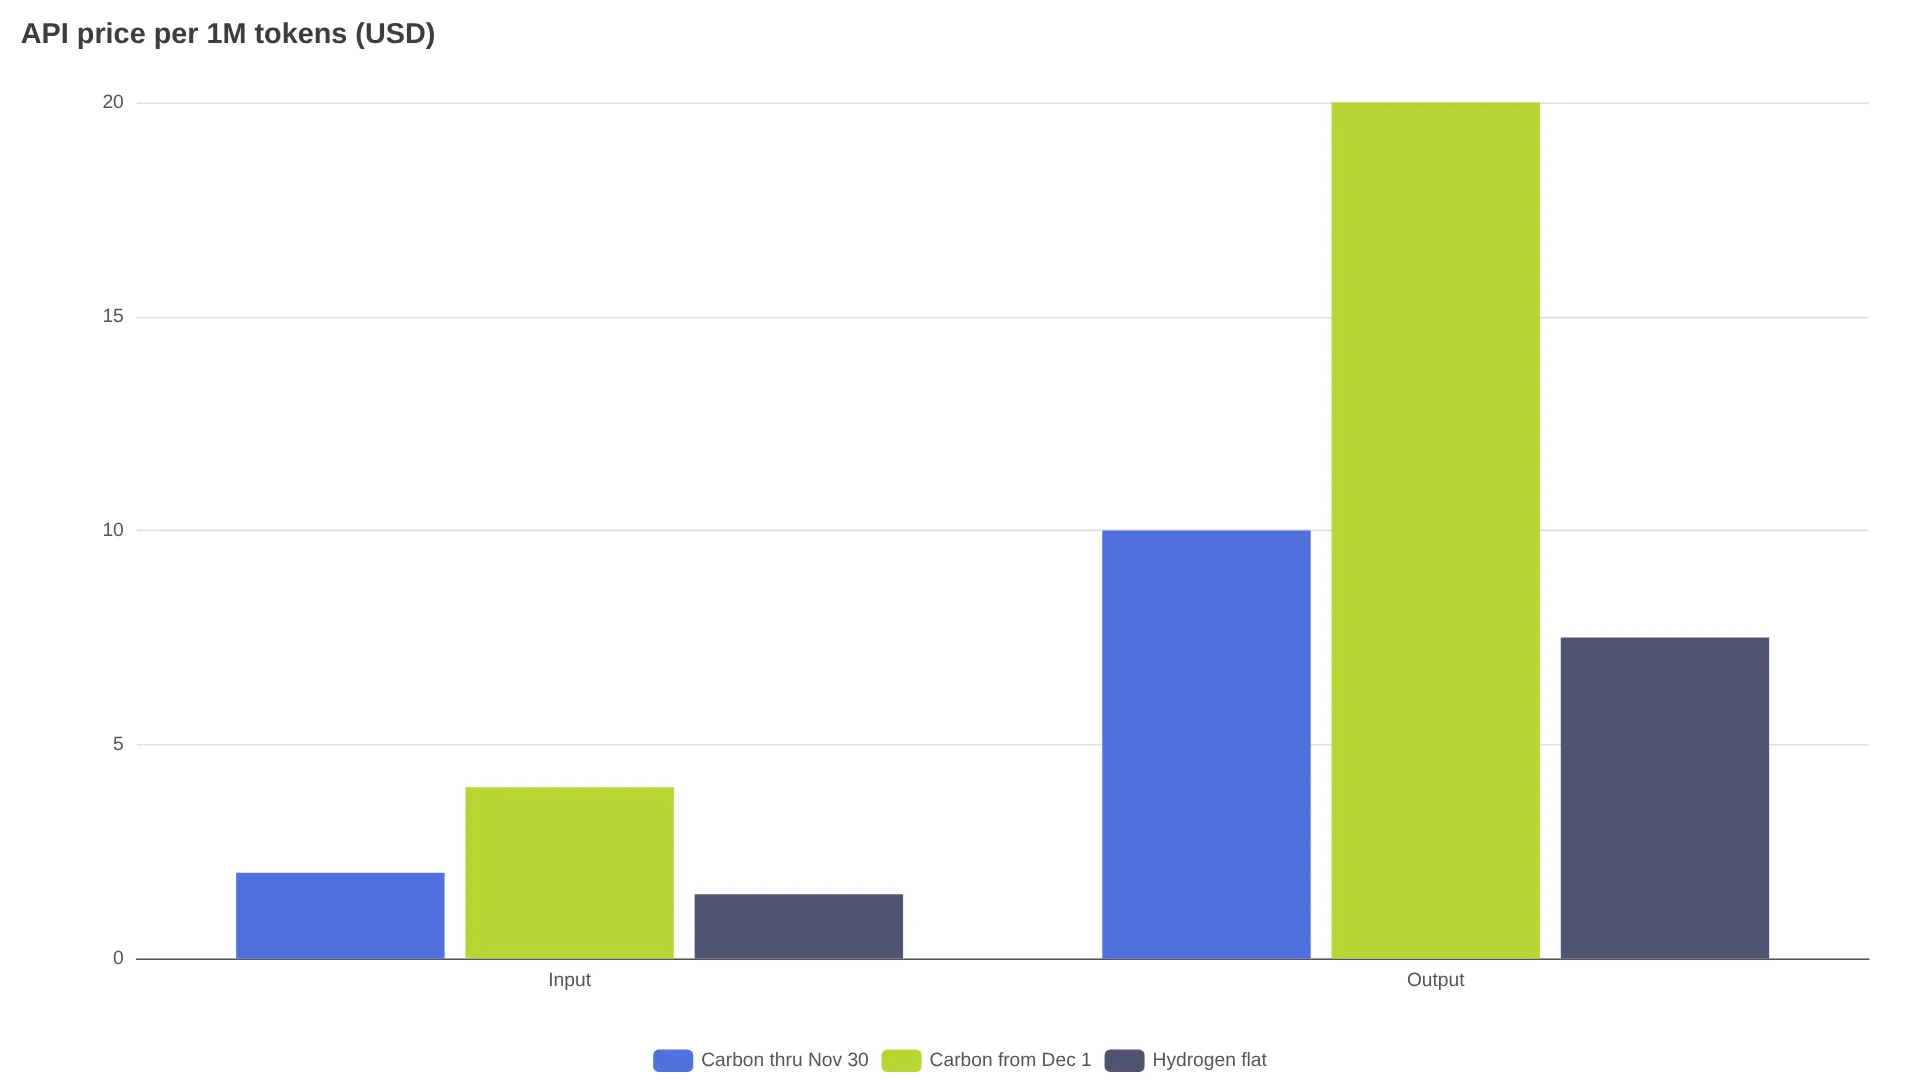
| Tramo | Carbon hasta el 30 de noviembre | Carbon desde el 1 de diciembre | Hydrogen |
|---|---|---|---|
| Entrada / 1M | $2.00 | $4.00 | $1.50 |
| Salida / 1M | $10.00 | $20.00 | $7.50 |
| Entrada en caché / 1M | $0.10 | $0.20 | $0.075 |
| Batch de entrada+salida | $1.00 / $5.00 | $2.00 / $10.00 | depende del proveedor |
| Prioridad de entrada+salida | $3.60 / $18.00 | $7.20 / $36.00 | depende del proveedor |
Fuentes de precios: las tarifas de lanzamiento de Google recogidas por las notas de LiteLLM del día del lanzamiento y las tablas de precios de Cloud; las tarifas fijas de Hydrogen proceden de DataCamp y la documentación de AI Studio. El precio de salida incluye los tokens de razonamiento, por lo que el razonamiento más profundo de Carbon se cobra dos veces: por los tokens utilizados y por la duplicación de tarifas de diciembre.
Hasta noviembre, la ejecución de vídeo de Carbon era un 9 % más barata que la de Argon con tarifas idénticas por token, porque utilizaba menos tokens. Desde diciembre, Hydrogen será más barato en cualquier carga de trabajo con una verbosidad similar. Con una mezcla de 3:1 entre entrada y salida (OnlySOTA), Hydrogen cuesta $3.00/M frente a $4.00/M de Carbon en noviembre, y $8.00/M desde diciembre. Para ofrecer ambos modelos bajo una misma clave, la página de Gemini 4 Carbon API permite dirigir las peticiones a cualquiera de los dos.
La velocidad y el razonamiento definen la experiencia del agente
Las medianas en directo de la comparativa de OpenRouter son claras: Carbon registra una latencia p50 de 11,32 s a 57 tokens/s, mientras que Hydrogen se queda en 1,68 s a 144 tokens/s. Hydrogen ofrece aproximadamente 6,7 veces menos tiempo hasta la primera respuesta y 2,5 veces más rendimiento, una diferencia decisiva en la sensación de uso de un agente interactivo.
| Nivel de Hydrogen | Coste por tarea | Índice de inteligencia | Uso |
|---|---|---|---|
low | ~$0.29 | 27 | Tareas sencillas de gran volumen |
medium | ~$0.80 | 41 | Trabajo rutinario donde importa la velocidad |
high (predeterminado) | ~$1.87 | 51 | La mayoría de tareas de programación y trabajo agéntico |
xhigh | ~$3.16 | 54 | Solo problemas difíciles de varios pasos |
Estimaciones de Artificial Analysis recogidas por DataCamp. Pasar de high a xhigh cuesta un 69 % más por tarea para ganar 3 puntos de índice y puede hacer que el modelo piense demasiado en prompts sencillos.
Algunos detalles de la API que conviene tener en cuenta (DataCamp):
thinking_budgetyMINIMALdevuelven HTTP 400; hay que usarthinking_leveltemperaturese ignora- La salida síncrona está limitada a 65.536 tokens (Carbon tiene un límite inferior de 32.768 según la prueba de Agnify)
- Hydrogen está en disponibilidad general a corto plazo y requiere un aviso de retirada de al menos 45 días
Los benchmarks se dividen por tarea, no por trofeos
| Fuente | Carbon | Hydrogen | Comparativa |
|---|---|---|---|
| Índice de inteligencia (OnlySOTA) | 60.0, n.º 2/57 | 53.9, n.º 7/57 | — |
| Arena Agent | 0.164, n.º 3/65 | 0.149, n.º 5/65 | — |
| Terminal-Bench 4.0 (OnlySOTA) | 64.5 %, n.º 3/59 | 56.4 %, n.º 12/59 | Sonnet 5.5 64 % (AA independiente) |
| Arena Code | 1768, n.º 4/157 | 1704, n.º 11/157 | — |
| Arena Text | 1526, n.º 1/421 | 1490, n.º 15/421 | — |
| Agents' Last Exam (DataCamp) | 77.4% | 71.6% | Argon 69.0% |
| Alucinaciones AA-Omniscience | — | 8% | 5 veces menos afirmaciones inventadas que Flash 3.8 (Google vía DataCamp) |
OnlySOTA agrega clasificaciones de terceros en lugar de ejecutar sus propias pruebas (OnlySOTA). En la tabla ajustada de Terminal-Bench 4.1 de Google, difundida por DataCamp, Hydrogen obtiene 57.0 %, frente al 18.2 % de Flash y el 63.9 % de Sonnet. La conclusión es sencilla: Hydrogen es competitivo en programación agéntica, pero no es la mejor opción para cargas centradas en el terminal.
El acceso es ahora mismo el principal obstáculo
Los identificadores de modelo son estables (gemini-4-carbon, gemini-4-hydrogen). Hydrogen aparece documentado para todos los niveles de API, incluido el gratuito, aunque con una cuota limitada (DataCamp, documentación de AI Studio). Carbon requiere una API de pago y está restringido a Ultra (anuncio de Carbon). En la práctica, el despliegue ha sido irregular: Hydrogen aparece, desaparece y sustituye automáticamente a Flash según la aplicación y la cuenta (hilo de lanzamiento en r/GeminiAI). Los detalles están en nuestro seguimiento de precios y disponibilidad de Hydrogen.
También conviene incluir en el cálculo de cualquier migración los informes sobre cuotas:
«Ayer los límites eran más generosos. Tengo Pro de pago. Hoy los prompts —por ejemplo, escribir un capítulo de unas 6-7.000 palabras— consumen alrededor de un 4-5 % cada uno. Ayer, cuando apareció Hydrogen, tres capítulos suponían aproximadamente un 2 % de la cuota de 5 horas. El límite de 5 horas es de risa» — u/Neat_Reaction9164, r/GeminiAI
«Hoy he estado programando con él y con Sonnet, y Hydrogen ha funcionado francamente bien y ha sido sorprendentemente eficiente, mientras que Sonnet ha dado resultados irregulares y ha alcanzado los límites de uso... Todavía es demasiado pronto para juzgarlo» — u/mmmtv, r/GeminiAI
Prueba la ruta exacta que vayas a utilizar en producción —AI Studio, Antigravity, Cursor o API—, porque el nivel, la integración y el nivel de razonamiento pueden cambiar de forma importante la cuota efectiva. Si automatizas el enrutamiento, cuenta también la llamada de decisión en la latencia y el coste: el patrón eve de Vercel utiliza google/gemini-decision-1 en cada turno y deja Argon como alternativa.
Elige según tu carga de trabajo
Tres perfiles cubren la mayoría de usos habituales de una API:
- Usa Hydrogen para el volumen diario. Ediciones rutinarias de código con diferencias fáciles de revisar, extracción con formato establecido, preguntas y respuestas sobre una única fuente y clasificación masiva. Fija
high, prueba las regresiones enmediumy reservaxhighpara los casos de varios pasos que demuestren necesitarlo. - Deja el 10 % más difícil para Carbon. Explicaciones enfrentadas, análisis de causa raíz donde un parche pueda ocultar el síntoma, experimentos contradictorios que necesiten una prueba discriminatoria y conjuntos documentales en los que las enmiendas prevalezcan sobre las propuestas. Asume la latencia y el precio de diciembre.
- Combina los dos. Carbon diseña el plan en modo de solo lectura, Hydrogen ejecuta las ediciones y las pruebas, y Carbon retoma el control si la ejecución se atasca. Esta configuración ofrece, según los datos publicados, una reducción del 24 % en la cuota y una finalización un 19 % más rápida.
El punto de incertidumbre sigue siendo el riesgo de verbosidad. En la prueba de Agnify, el nivel predeterminado high de Hydrogen generó entre 89 y 201 tokens de razonamiento, mientras que el nivel predeterminado de Carbon produjo entre 51 y 64. Configura límites de salida y mide los tokens generados con tus propios prompts. De momento, calcula el presupuesto de Hydrogen según los tokens emitidos, no según los tokens tarifados.
Preguntas frecuentes
¿Carbon razona mejor que Hydrogen?
Sí. Índice 60.0 frente a 53.9; Terminal-Bench 4.0, 64.5 % frente a 56.4 %; Arena Text, n.º 1 frente a n.º 15. En vídeo, sin embargo, empatan: 0.6016 frente a 0.6006 HOTA.
¿Cuál es más barato?
Hydrogen, con $1.50/$7.50 por cada 1M, sin cambios. Carbon cuesta $2/$10 hasta el 30 de noviembre y $4/$20 desde el 1 de diciembre.
¿Cuál es más rápido?
Hydrogen: 1,68 s frente a 11,32 s de latencia mediana, y 144 frente a 57 tokens/s de rendimiento.
¿Comparten ventana de contexto?
Sí, 1.048.576 tokens unificados en ambos modelos.
¿Puede Carbon crear el plan mientras Hydrogen lo ejecuta?
Sí, mediante Antigravity Orchestrator o el enrutamiento por turno con gemini-decision-1.
¿Qué nivel de razonamiento conviene usar?
Carbon medium y Hydrogen high; reserva xhigh para los casos en los que la tasa de aceptación aumente de forma medible.