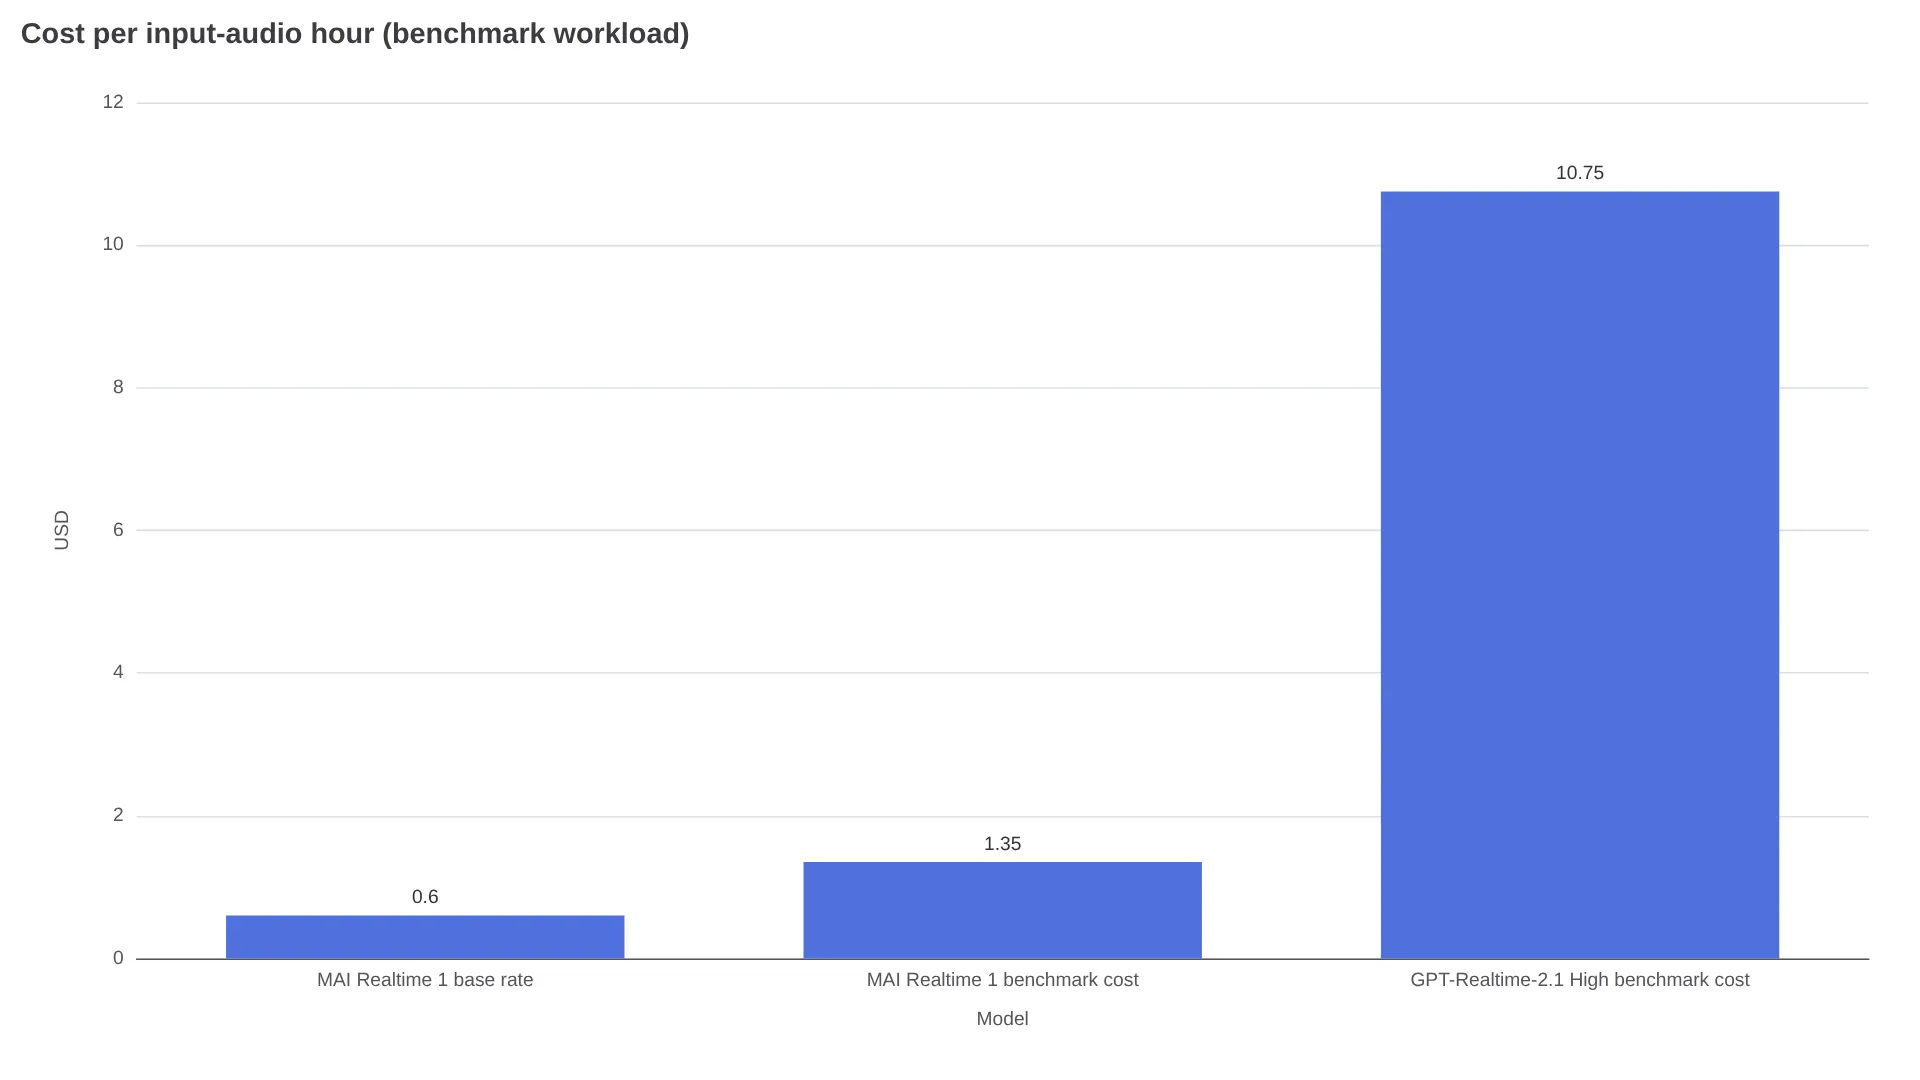
Con un coste de $1,35 por hora de audio de entrada normalizado según el benchmark de Microsoft, MAI Realtime 1 resulta aproximadamente un 87% más barato que la configuración GPT-Realtime-2.1 High, listada a $10,75. Pero los $0,01 por minuto solo cubren el audio: el razonamiento se factura aparte.
Microsoft presentó MAI Realtime 1, su primer modelo de voz a voz, el 17 de noviembre de 2026 durante Ignite. Está disponible en preview limitada a través de Microsoft Foundry, previo registro y sin facturación hasta la preview pública, y cuenta con una breve demo en MAI Labs.
Los $0,01 por minuto cubren el audio, no la respuesta
La tabla oficial de precios de Microsoft AI contempla tres conceptos:
| Concepto | Precio |
|---|---|
| Voz a voz base | $0,01 por minuto de audio |
| Entrada de razonamiento | $1 por 1M de tokens |
| Salida de razonamiento | $5 por 1M de tokens |
Sin contar el razonamiento, 60 minutos cuestan $0,60 y $1 alcanza para 100 minutos de audio. Microsoft habla de precios «a partir de» porque las llamadas que recurren al motor de razonamiento profundo suman cargos por tokens.
No se sabe con qué frecuencia se activa el razonamiento. Microsoft explica que un sistema conversacional rápido resuelve los turnos rutinarios y deriva las peticiones más complejas a un razonamiento más potente, pero no publica tokens por minuto, ni aclara si el cómputo por minuto incluye el audio del usuario y el del modelo, ni especifica reglas de redondeo. Considera ese céntimo como un mínimo, no como la factura final.
«Las comparaciones de rendimiento, latencia y coste varían según la aplicación y la metodología». — Microsoft AI, anuncio de MAI Realtime 1
Por qué el benchmark de Microsoft da $1,35 por hora, y no $0,60
Los $0,60 por hora corresponden al audio sin más. Los $1,35 representan el coste de una carga de trabajo normalizada para el benchmark de Microsoft; los detalles de medición publicados no permiten reconstruir la diferencia con una estimación de tokens por minuto. Las cifras siguientes proceden del desglose de Magica sobre los datos de Microsoft.
| Configuración del modelo | Razonamiento por voz (Big Bench Audio, 40 preguntas) | Finalización agéntica (τ-Voice) | Coste por hora de audio de entrada |
|---|---|---|---|
| MAI Realtime 1 | 98,9% | 57,5% | $1,35 |
| GPT-Realtime-2.1 High | 95,8% | 45,7% | $10,75 |
| Gemini 3.8 Live | — | 30,1% | $0,84 |
| Gemini 3.8 Live Extended Thinking (High) | — | 68,6% | $3,50 |
| Phonic 1 (High) | — | 79,9% | $4,20 |
MAI supera a la configuración GPT indicada en ambas pruebas por cerca de una octava parte de su coste de referencia. También aventaja al Gemini más barato en 27,4 puntos de finalización, aunque queda 11,1 puntos por detrás de Extended Thinking y 22,4 de Phonic 1 High.
Todas las cifras anteriores deben leerse como datos de proveedores: Microsoft evaluó MAI internamente y atribuyó las cifras de los competidores a Artificial Analysis. El segmento Big Bench Audio solo reúne 40 preguntas seleccionadas, y la finalización en τ-Voice es una puntuación de benchmark, no una tasa medida de resolución en atención al cliente.
Qué ofrece Realtime 1 durante una llamada
MAI Realtime 1 admite gestión de interrupciones, uso de herramientas y razonamiento enrutado para agentes telefónicos, además de tolerancia al ruido de fondo y personalidades controladas mediante prompts. Está orientado a telefonía y soporte, no al chat de consumo. Microsoft lo describe como compatible con OpenAI Realtime API para facilitar las pruebas y la migración, aunque pueden existir diferencias en endpoints, esquemas de herramientas, voces y gestión de errores.
Aún no se han publicado los idiomas y voces compatibles, la latencia exacta, el tamaño de la ventana de contexto, los límites de tasa y concurrencia, las regiones ni la política de retención.
Cómo probarlo hoy: MAI Labs frente a la preview de Foundry
Demo de MAI Labs: prueba pública para uso personal no comercial, con sesiones de hasta unos 2 minutos y para usuarios mayores de 18 años. Sirve para valorar la calidad de voz y la gestión de interrupciones, pero no para pruebas de carga. Preview limitada de Foundry: es la vía empresarial. Regístrate mediante el formulario de interés de la página del modelo MAI Realtime 1, espera la aprobación y desarrolla contra el endpoint Realtime compatible con OpenAI. No habrá cargos hasta que comience la preview pública, cuya fecha todavía no se ha anunciado.
Si esta semana necesitas SLA de producción, regiones o un compromiso de disponibilidad general, este modelo aún no se puede contratar. Úsalo solo para prototipos.
Calcula el coste de tus primeras 1.000 llamadas antes de decidir
El precio por minuto puede ocultar la decisión real. Parte de una fórmula y termina el cálculo por caso resuelto:
Cost = audio minutes x $0.01 + input reasoning tokens / 1M x $1 + output reasoning tokens / 1M x $5
Ejemplo: una llamada de soporte de 4 minutos cuesta $0,04 en audio. Si consume 2.000 tokens de entrada y 500 de salida para razonamiento, hay que sumar $0,002 + $0,0025 = $0,0045, para un total aproximado de $0,0445 por llamada. Con 1.000 llamadas y una tasa de reintento del 15%, unos 1.150 equivalentes de llamadas facturadas costarían aproximadamente $51,18. Si se resuelven 600 de las 1.000 originales, el coste por caso resuelto sería de unos $0,085. La duración de los reintentos y el consumo de tokens varían según el flujo, así que sustituye estos datos por tu propio perfil de reintentos.
Usa $1,35 por hora de audio de entrada como referencia del benchmark del proveedor hasta que tus propias pruebas revelen el coste de los tokens de razonamiento y de la medición; no es un techo. Tu carga de trabajo puede quedar por encima o por debajo de esa referencia según comportamientos de razonamiento y medición que no se han publicado, así que mídelo durante la preview.
| Tu situación | Recomendación |
|---|---|
| Ya usas OpenAI Realtime, tienes presión de costes y haces consultas sencillas | Prueba MAI Realtime 1 en paralelo; la compatibilidad reduce el trabajo de migración |
| Tareas complejas de varios pasos donde la tasa de finalización pesa más que el coste bruto | Compáralo con opciones Extended Thinking o de la clase Phonic antes de cambiar solo por precio |
| Necesitas ahora disponibilidad general, SLA o idiomas y regiones publicados | Espera; mantente con tu proveedor actual y revísalo cuando llegue la preview pública |
Preguntas frecuentes
¿Cómo se mide el minuto de audio?
Microsoft solo indica «por minuto de audio», sin publicar un desglose entre usuario y modelo ni reglas de redondeo. Planifica como si se contabilizara todo el audio hasta que la tabla de precios lo aclare.
¿Qué permite probar realmente la preview?
La demo de Labs permite evaluar la calidad de voz y la gestión de interrupciones en sesiones cortas. Solo la preview cerrada de Foundry expone el endpoint compatible con OpenAI para llamadas a herramientas y pruebas de carga, y sigue sin facturación.
¿Cuándo conviene revisar este precio?
Cuando Microsoft anuncie una fecha para la preview pública y publique la tabla de precios de Foundry con detalles de medición, idiomas y regiones. Hasta entonces, considera todas las cifras de este artículo como precios de preview.