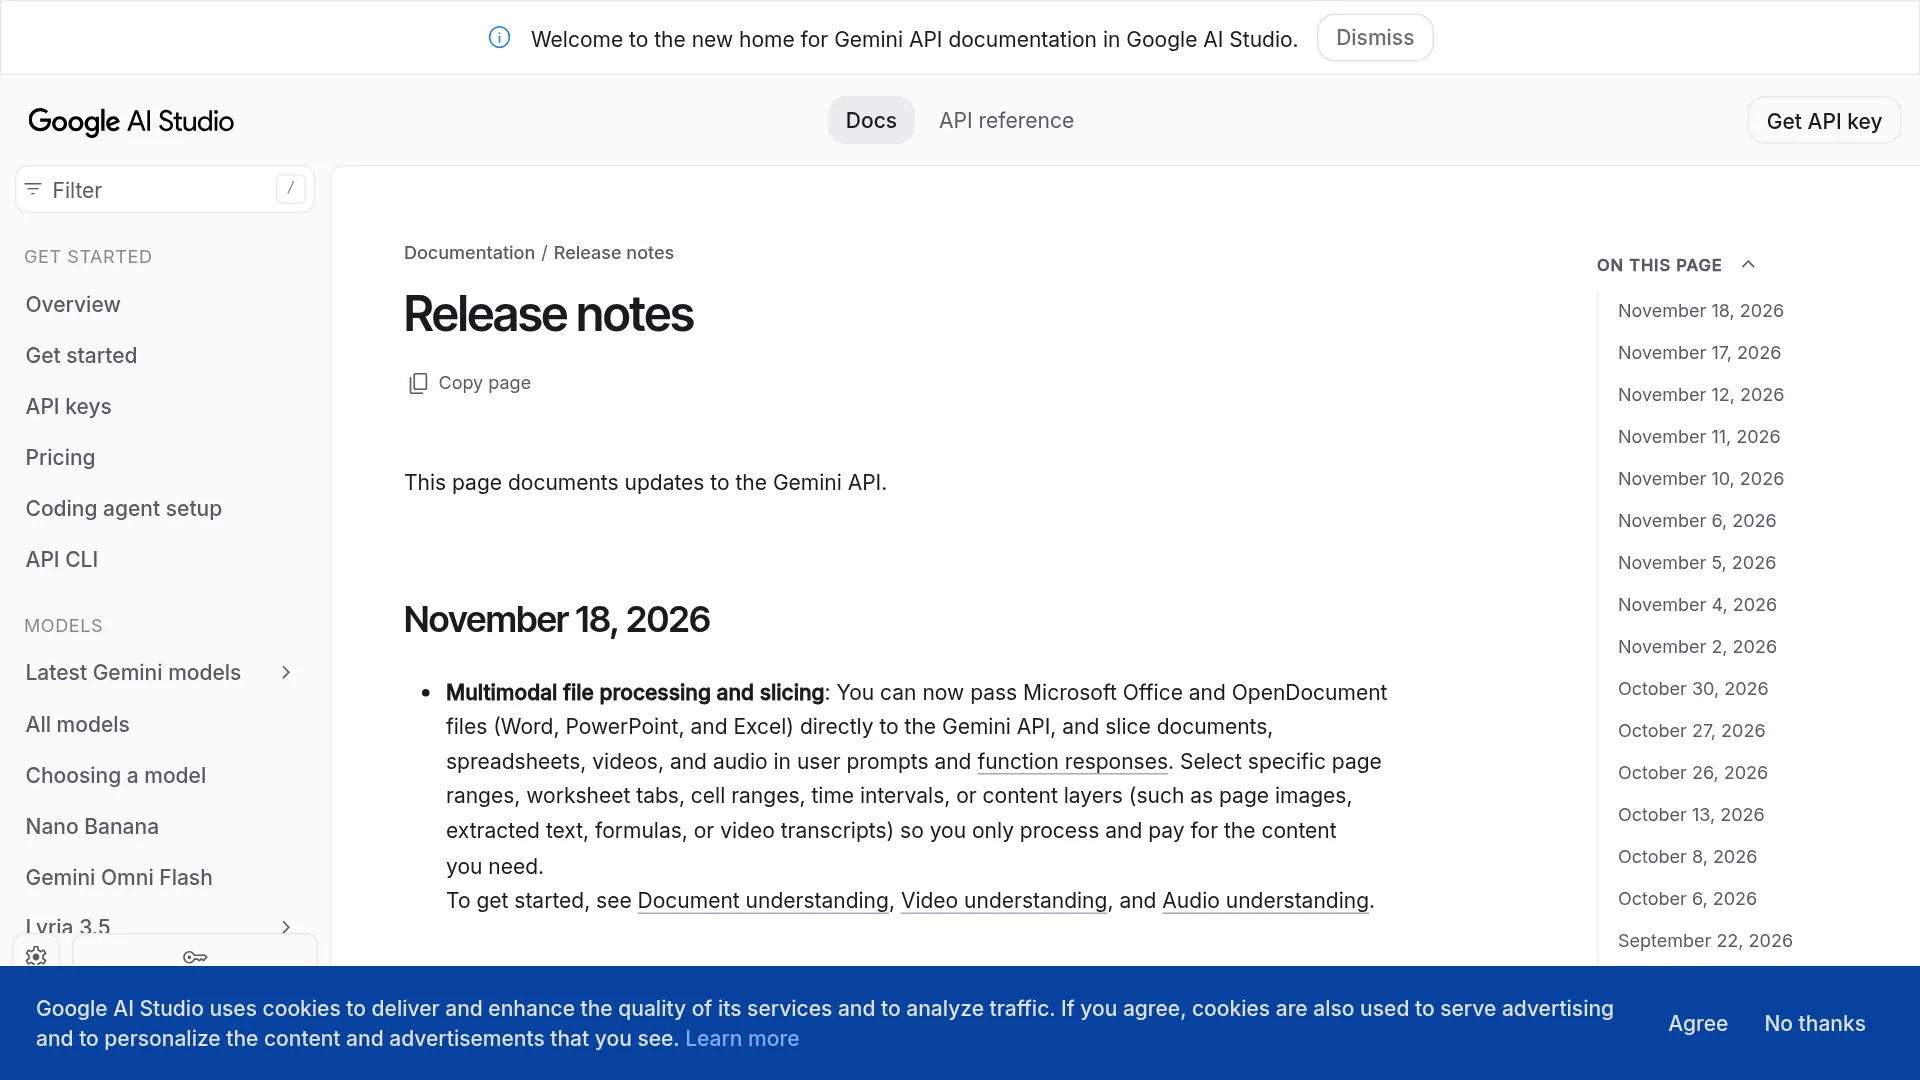
Convertir cada libro de Excel a CSV antes de llamar a Gemini API ya no es imprescindible. Desde el 18 de noviembre de 2026, Gemini API acepta directamente archivos de Word, Excel y PowerPoint. Según Google, puedes «procesar y pagar solo» por el fragmento que selecciones (registro de cambios de Google AI Studio).
El ahorro no es automático: hay que indicar selectores explícitos. De lo contrario, es posible que se procese el archivo completo, como señala el lector @zg0820.
El problema del antiguo flujo de Excel
El comportamiento documentado hasta ahora solo leía la primera hoja de cálculo de un XLSX como CSV. Eso obligaba a reordenar pestañas o dividir los libros:
«La documentación sigue diciendo que de un XLSX solo se lee la primera hoja, como CSV». — @aitrackerbot
La entrada del 18 de noviembre sustituye ese apaño por entrada directa de archivos de Office y OpenDocument, además de segmentación de contenido tanto en prompts como en respuestas de funciones (análisis de DocsWatch).
Qué incorpora realmente la actualización del 18 de noviembre
La novedad añade dos capacidades a la ampliación del 5 de noviembre, que ya incluía PPT, ODP y ODS:
- Entrada directa de Office y OpenDocument. Puedes enviar archivos de Word, PowerPoint y Excel sin convertirlos antes a PDF o texto.
- Segmentación de contenido. Permite seleccionar rangos de páginas, pestañas de hojas, rangos de celdas A1, intervalos temporales o capas de contenido como imágenes de página, texto extraído, fórmulas y transcripciones.
La segmentación funciona tanto en prompts como en partes de FunctionResponse. Así, una herramienta puede devolver un único rango de una hoja en vez de un libro entero (resumen de AI Index).
Archivos compatibles y modelos que los admiten
La página de requisitos de entrada de Firebase, actualizada el 18 de noviembre de 2026 UTC, vincula el soporte de Office a los modelos Gemini 4.x (documentación de Firebase AI Logic):
| Familia | Extensiones | Tipo MIME |
|---|---|---|
| Word | .doc, .docx, .dotx | application/msword, application/vnd.openxmlformats-officedocument.wordprocessingml.document, application/vnd.openxmlformats-officedocument.wordprocessingml.template |
| PowerPoint | .ppt, .pptx | application/vnd.ms-powerpoint, application/vnd.openxmlformats-officedocument.presentationml.presentation |
| Excel | .xls, .xlsx | application/vnd.ms-excel, application/vnd.openxmlformats-officedocument.spreadsheetml.sheet |
| OpenDocument | .odt, .odp, .ods | application/vnd.oasis.opendocument.text, application/vnd.oasis.opendocument.presentation, application/vnd.oasis.opendocument.spreadsheet |
| Base | .pdf, .txt | application/pdf, text/plain |
Límites oficiales, que la segmentación no amplía:
- 50 MB por archivo, 1.000 páginas por archivo y 3.000 archivos de documentos por solicitud.
- 20 MB de tamaño total de solicitud para datos base64 en línea; los archivos mayores requieren URL de Cloud Storage.
Conviene separar una nota no verificada de la comunidad: un lector del registro de cambios informa de un límite específico para Office de alrededor de 2.000 páginas o diapositivas (@lawson_ste3476). Google no lo ha documentado, así que no deberías diseñar tu solución basándote en ello.
Word y PowerPoint: rangos de páginas y elección de capa
DocumentMetadata se ha observado en los documentos públicos de Discovery de v1beta/v1alpha, pero no en la versión estable v1 (informe sobre el esquema de ORIENS):
startPage: primera página, indexada desde 1 e incluida.endPage: última página, indexada desde 1 e incluida.contentLayers:PAGE_IMAGE(imagen renderizada; se ha informado como valor predeterminado cuando hay metadatos pero las capas están vacías) oPAGE_TEXT(texto extraído).
Elige PAGE_IMAGE para diseños, diapositivas y páginas escaneadas; usa PAGE_TEXT para texto consultable, como contratos. Firebase documenta el modelo subyacente: los PDF se tratan como imágenes, cada página cuenta como una imagen y las imágenes de 384 px o menos en ambos lados cuestan 258 tokens (documentación de Firebase AI Logic).
Excel: hojas, rangos de celdas y tres modos de capa
Según el esquema de Discovery, SpreadsheetMetadata se adjunta a la parte de archivo enviada mediante inline_data o file_data, ya sea en un Part de entrada o en un FunctionResponsePart (informe sobre el esquema de ORIENS):
sheetIndex: orden de la hoja dentro del libro, indexado desde 1. El texto de Discoveryv1betaindica que, si se omite, se usan todas las hojas; el texto de los SDK de Python y JavaScript habla de la primera hoja. Indícalo siempre.visibleCells: rango A1, por ejemploA1:G35; si se omite, se usa el área ocupada de la hoja seleccionada.contentLayers:DATA(valores, combinaciones y formato),FORMULAS(expresiones y resultados calculados) yVISUAL(imagen renderizada). El valor predeterminado informado es[DATA, FORMULAS].
Para auditorías, utiliza DATA junto con FORMULAS; para el diseño y el contexto de celdas combinadas, añade VISUAL; para una consulta puntual, limita al máximo el rango de visibleCells.
Envía solo el fragmento: ejemplo REST en Python
Los nombres de campo siguientes corresponden a la revisión de Discovery 20261116. La estructura es beta y no aparece en la versión estable v1, así que compruébala con el SDK que tengas instalado antes de usarla en producción.
import os
from google import genai
import requests

client = genai.Client()  # reads GEMINI_API_KEY
workbook = client.files.upload(
    file="q3_revenue.xlsx",
    config={"mime_type": "application/vnd.openxmlformats-officedocument.spreadsheetml.sheet"},
)

api_key = os.environ["GEMINI_API_KEY"]
url = f"https://generativelanguage.googleapis.com/v1beta/models/gemini-4-hydrogen:generateContent?key={api_key}"
payload = {
    "contents": [{
        "parts": [
            {
                "fileData": {
                    "fileUri": workbook.uri,
                    "mimeType": "application/vnd.openxmlformats-officedocument.spreadsheetml.sheet",
                },
                "spreadsheetMetadata": {
                    "sheetIndex": 2,
                    "visibleCells": "A1:G35",
                    "contentLayers": ["DATA", "FORMULAS"],
                },
            },
            {"text": "Summarize revenue variance in this range using computed values."},
        ]
    }]
}
r = requests.post(url, json=payload, timeout=120)
r.raise_for_status()
print(r.json()["candidates"][0]["content"]["parts"][0]["text"])
Para Word, sustituye esa parte por "documentMetadata": {"startPage": 12, "endPage": 18, "contentLayers": ["PAGE_TEXT"]} y usa el tipo MIME de .docx. PowerPoint utiliza la misma estructura de documentMetadata con el tipo MIME de .pptx y los números de página de las diapositivas.
Cómo calcular el ahorro real de la segmentación
No existe un SKU independiente para la segmentación en el registro de cambios ni en las notas de precios de Firebase. El ahorro equivale a los tokens de entrada que dejas de procesar, aplicando las tarifas estándar. El registro de cambios sitúa gemini-4-hydrogen en $1.50 por 1M de tokens de entrada.
Estimación ilustrativa para un informe de 200 páginas en el que solo interesan las páginas 12–18. La cifra de 800 tokens por página de texto es una hipótesis de este ejemplo, no una tarifa documentada:
- Antes: 200 páginas como imágenes x 258 tokens mínimos por imagen de página = 51.600 tokens de entrada. Coste: 51.600 / 1.000.000 x $1.50 = $0.0774.
- Después: 7 páginas como texto extraído x 800 tokens asumidos = 5.600 tokens de entrada. Coste: 5.600 / 1.000.000 x $1.50 = $0.0084.
- Ahorro: aproximadamente un 89% en la entrada de esta solicitud, antes de los tokens de salida. Sustituye estas cifras por la densidad de páginas que midas en tus archivos.
Mide el tamaño de los rangos con tus propios libros: muchas llamadas segmentadas y pequeñas pueden acabar costando más que un único rango bien elegido (@zg0820).
Checklist para verificar y migrar tu flujo
Que una carga se complete correctamente no demuestra que el análisis también lo haya hecho. Verifica cada pipeline:
- Confirma el análisis. Pide el número de filas, el nombre de la hoja o el número de páginas y compáralo con el archivo original.
- Define todos los selectores.
sheetIndex,visibleCellso el rango de páginas, ycontentLayers. - Relaciona la capa con la pregunta. Los gráficos y el diseño requieren
VISUALoPAGE_IMAGE; las auditorías,DATAjunto conFORMULAS; las búsquedas,PAGE_TEXT. - Prueba los límites de rango en staging. El esquema no especifica si una página o rango no válido genera un error, se ajusta al límite o no devuelve nada.
- Respeta los límites de carga. Un archivo de 60 MB seguirá fallando con un límite de 50 MB. Para datos en línea de más de 20 MB, usa URL de Cloud Storage.
- Migra en este orden. Sustituye los divisores de Excel por
sheetIndexmásvisibleCells; cambia los rasterizadores de informes por rangos de páginas conPAGE_TEXTy reservaPAGE_IMAGEpara el diseño; pasa de devoluciones de herramientas con archivos completos a respuestas de función segmentadas.
Las fuentes citadas no especifican cómo se gestionan las filas ocultas, las celdas combinadas, los gráficos, las imágenes incrustadas ni los archivos protegidos por contraseña, habilitados para macros o dañados. Ni el anuncio de segmentación ni la página de requisitos de entrada de Firebase enlazada arriba lo aclaran. Compruébalo con tus propias plantillas.
Preguntas frecuentes
¿También puedo segmentar contenido dentro de respuestas de funciones?
Sí. Las herramientas pueden devolver una URI de archivo junto con SpreadsheetMetadata o DocumentMetadata, de modo que el modelo solo vea el extracto. Es especialmente útil en flujos documentales con agentes.
¿Qué versión de la API admite la segmentación?
Se ha observado en la revisión de Discovery 20261116 de v1beta y v1alpha, pero no en la versión estable v1. Fija las versiones y pruébalas con el modelo objetivo antes de pasar a producción.
¿Por qué Gemini dice que no puede ver el archivo que he subido?
Comprueba el tipo MIME, el tamaño y los selectores explícitos frente a la tabla y los límites anteriores. Después, pide al modelo que repita los nombres de las hojas o el número de páginas para confirmar que el archivo se ha analizado.
Lectura relacionada: guía de Gemini 4 Carbon vs Hydrogen API para elegir el modelo de un pipeline de Office.