Un agente puede conocer cientos de herramientas sin arrastrar todos sus esquemas de parámetros en cada prompt. Esa es la propuesta de Tool Retrieval en Gemini API: carga el esquema completo solo cuando la tarea lo requiere. Pero tiene letra pequeña: cada búsqueda implica otra pasada del modelo, por lo que los flujos que buscan en todos los turnos pueden acabar pagando más, no menos.
Google lanzó la función en vista previa el 19 de noviembre de 2026, exclusivamente dentro de Interactions API, según su anuncio. Añade la herramienta tool_search y la marca defer_loading: true. Las herramientas diferidas muestran su nombre y descripción, mientras que el JSON de parámetros queda fuera del contexto. No hay un cargo independiente: se aplican las tarifas habituales de entrada, entrada en caché y salida.
Cómo 200 herramientas podían consumir 164.000 tokens antes de la primera llamada
El coste del prompt depende más del tamaño de los esquemas que del número de herramientas. Por eso, un catálogo grande puede terminar dominando el contexto.
Un análisis técnico independiente de la documentación de Google plantea una diferencia ilustrativa: aproximadamente 164.000 tokens de entrada sin diferir frente a unos 23.650 con Tool Retrieval para una biblioteca de 200 herramientas de la que solo se ejecutan unas pocas en cada solicitud. Son cifras redondeadas de ese análisis, no un benchmark: la idea es dejar de pagar por los esquemas que nunca llegas a usar.
El segundo problema es la precisión. Cuando hay decenas de esquemas parecidos compitiendo en el contexto, el modelo dispone de más opciones para equivocarse. Google presenta Tool Retrieval como una ayuda tanto para reducir la carga de tokens como para mejorar la selección. No ha publicado ninguna cifra de precisión, así que conviene tratar esa parte como una hipótesis que validar con tus propias tareas.
Así funciona Gemini Tool Retrieval: tool_search y defer_loading
La configuración se resume en dos fragmentos de declaración: una entrada tool_search de {"type": "tool_search"} y "defer_loading": true en cada herramienta diferida; el desglose de la documentación muestra la estructura completa de la solicitud. El modelo sigue viendo el nombre y la descripción de cada herramienta diferida. Según el explicador sobre defer_loading, si defines short_description, eso es lo que ve el modelo; si no, recibe la primera frase de la descripción completa.
El flujo del lado del servidor ocurre íntegramente en una sola solicitud:
- El modelo emite
tool_search_call; por ejemplo, solicitaissue_refund. - La API devuelve
tool_search_resultcon el esquema completo. - El modelo emite la
function_callreal (el ejemplo de reembolso de Google usaorder_id: "A-1042"yamount: 40con el modelogemini-4-hydrogen). - Tu código ejecuta la llamada y devuelve
function_result.
Registra todo en interaction.steps. Si se carga la herramienta equivocada, revisa primero la traza en busca de nombres o descripciones demasiado vagos.
Servidor frente a cliente: una solicitud o una vuelta adicional
| Modo | Quién busca | Índice necesario | Vueltas adicionales | Mejor caso de uso |
|---|---|---|---|---|
| Lado servidor (predeterminado) | Gemini | Ninguno — "There's no index to build or host." | Ninguna, en la misma solicitud | Bibliotecas grandes y mayormente estáticas; servidores MCP completos |
Lado cliente ("execution": "client") | Tu aplicación | Tu registro o índice de embeddings | Una por búsqueda | Permisos por usuario, registros privados, herramientas añadidas durante la conversación |
La recuperación del lado servidor no necesita un índice alojado y se completa en la misma respuesta; según el desglose de la documentación, establecer defer_loading: true en una herramienta mcp_server difiere todas las herramientas que expone ese servidor.
El modo cliente usa tool_search con "execution": "client" (el ejemplo se llama search_tools y exige una cadena query). Tu aplicación devuelve las coincidencias en un function_result y después continúa con client.interactions.create, incluyendo previous_interaction_id. Según el mismo desglose, solo se permite un tool_search por solicitud y ambos modos no se pueden mezclar.
Elige el modo cliente cuando la autorización sea por usuario o puedan aparecer integraciones durante la conversación: una búsqueda del lado servidor sobre un catálogo compartido no aplica por sí misma filtros de permisos por usuario, según el análisis citado. Ese desglose también señala que el modo cliente permite incorporar herramientas a mitad de conversación sin declararlas todas de antemano.
La cuenta de Tool Retrieval en Gemini: 26 tokens ahora y otra pasada completa después
Tool Retrieval no tiene un cargo independiente, según el anuncio de Google: "Tool Retrieval has no separate charge." Aun así, quedan cuatro costes medidos, según el desglose de economía de tokens:
- Bloque de búsqueda:
tool_searchañade un pequeño bloque fijo de tokens de entrada a cada solicitud. - Metadatos diferidos: el análisis citado estima unos 26 tokens por cada línea de nombre y descripción diferidos.
- Pasada adicional: cada búsqueda del lado servidor ejecuta otra pasada del modelo sobre el contexto actual, facturada mediante
total_tool_use_tokenspor un volumen aproximado a la entrada del prompt menos los aciertos de caché, según ese análisis. - Esquemas cargados: cada esquema recuperado sigue facturándose como entrada durante el resto de la conversación y no se puede descargar.
| Carga de trabajo (estimaciones ilustrativas del análisis citado) | Sin recuperación | Con recuperación | Veredicto |
|---|---|---|---|
| 200 herramientas, pocas usadas por tarea | ~164.000 tokens | ~23.650 tokens | Ahorra |
| 10 herramientas, 30k de contexto, búsqueda en casi todos los turnos | ~68.000 tokens | ~92.830 tokens | Cuesta más |
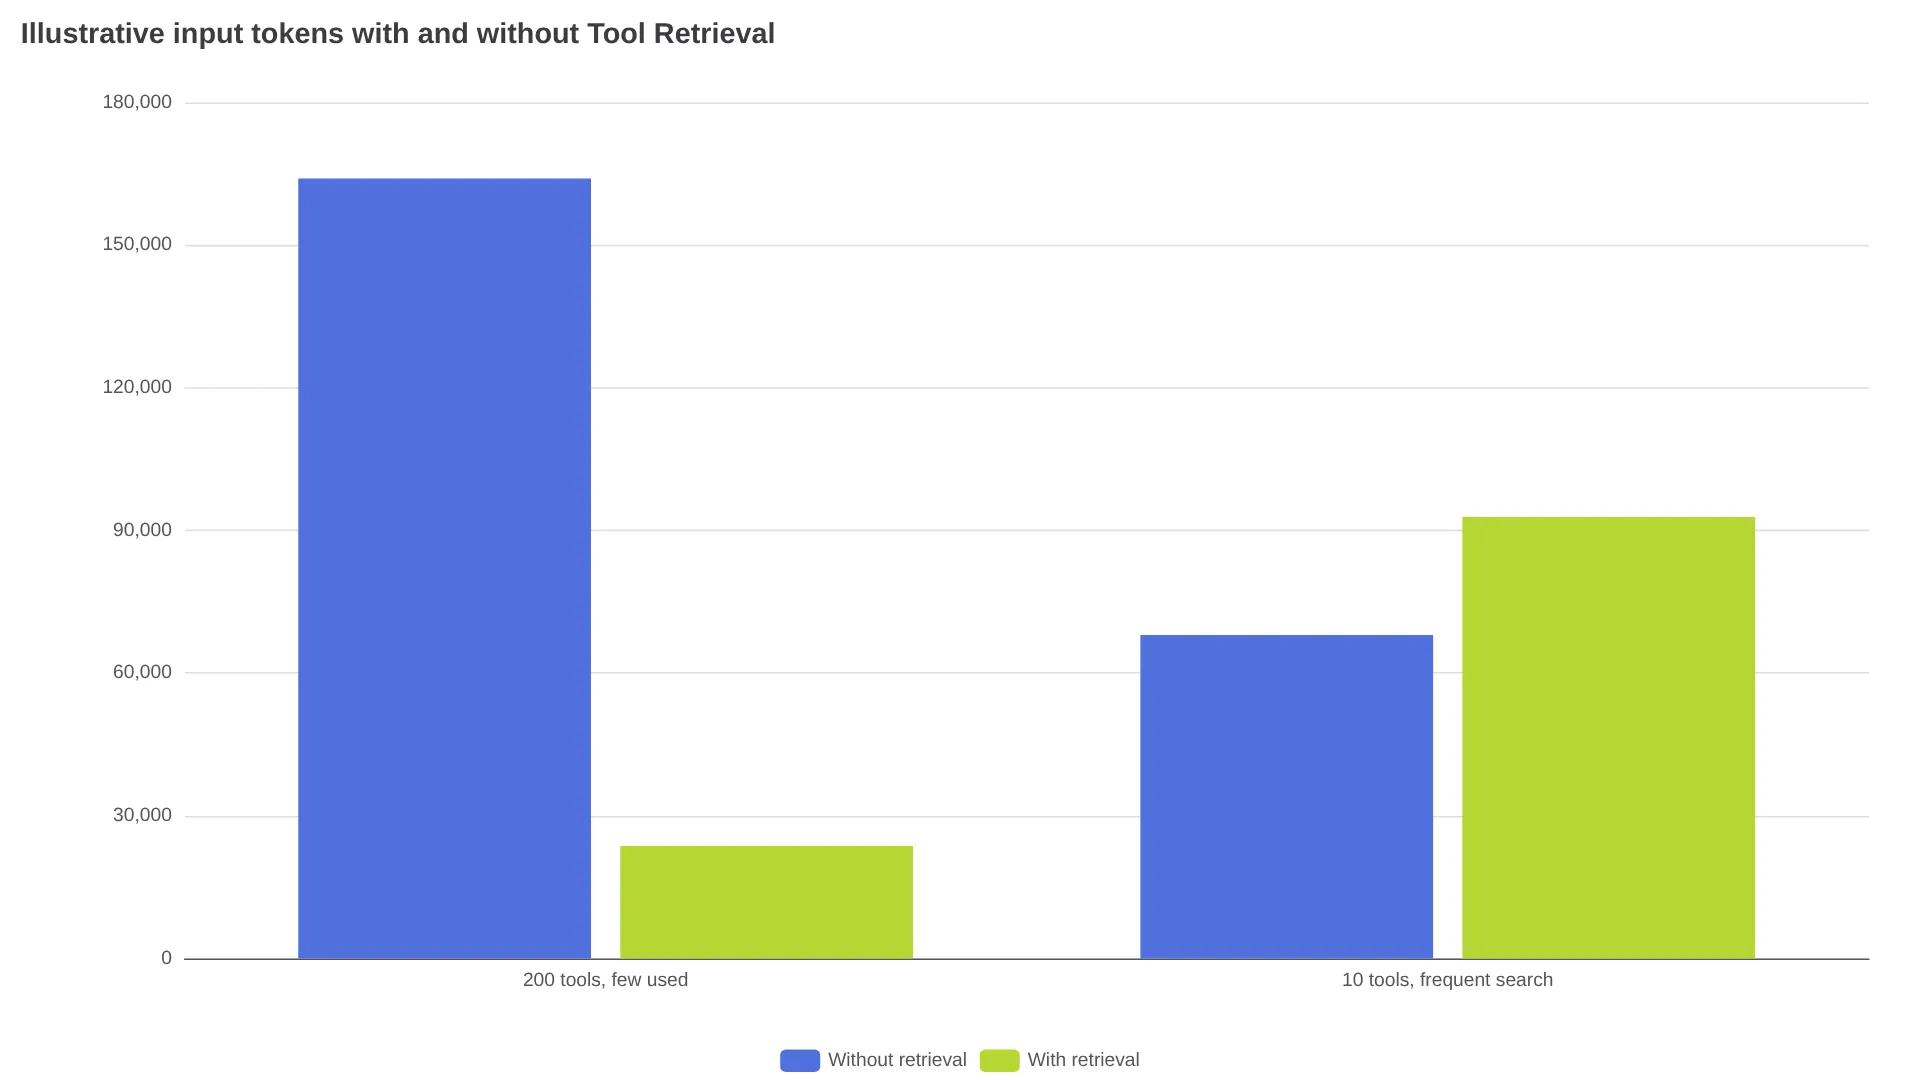
La recomendación de Google en ese mismo anuncio es clara: "Measure it against your own traffic."
"In server-side mode... every server-side search adds another model pass over the current context... So a big library where each task uses a few tools can benefit. A small library with a long conversation and frequent searches can cost more." — @tekroch
Diferir herramientas puede estabilizar el prefijo almacenado en caché, pero también puede dejar el prompt por debajo del umbral de tamaño para la caché. Según el análisis citado, sigue la tasa de aciertos de caché junto con los tokens de entrada.
Cuándo diferir herramientas y cuándo mantenerlas cargadas
En bibliotecas pequeñas, mide primero la carga estática: la frecuencia de búsqueda y el tamaño de los esquemas importan más que cualquier umbral de número de herramientas. Con catálogos grandes que usan entre 1 y 3 herramientas por tarea, difiere del lado servidor las menos habituales y deja sin diferir las de uso frecuente, es decir, las que aparecen en la mayoría de solicitudes. Para herramientas por usuario o que surgen durante el chat, usa el modo cliente y cuenta con una vuelta adicional por cada búsqueda.
Las notas de implementación citadas recogen tres fallos que debes contemplar:
- No difieras referencias directas: no difieras una herramienta nombrada en las instrucciones de sistema o en la salida de otra herramienta; el modelo podría llamarla sin buscarla y el siguiente turno puede fallar.
- Conserva los parámetros completos: las funciones diferidas siguen necesitando
parameterscompletos en la solicitud; solo el nombre y la descripción pueden devolver un esquema vacío e imposible de invocar. - Repite el estado en aplicaciones sin estado: devuelve sin cambios
tool_search_call,tool_search_result, las firmas y el array completotoolsen cada turno.
La calidad de la descripción decide la recuperación: el modelo elige entre nombres y descripciones antes de ver ningún esquema. "Search customer invoices by date range" se recupera bien; "Invoice helper" compite con demasiadas opciones. Diferir no es una frontera de seguridad: los nombres y descripciones de MCP diferidos siguen visibles como entrada del prompt, y las herramientas cargadas se ejecutan con los permisos que les hayas concedido, según el análisis de seguridad.
Las limitaciones de la vista previa
Solo está en vista previa, en Interactions API y sobre la superficie v1beta. No admite generateContent; según el desglose de la documentación, usar defer_loading con un modelo no compatible devuelve HTTP 400.
La cobertura de modelos es por ahora más limitada de lo que sugiere el titular: el anuncio habla de Gemini 3.6 y posteriores, incluidos todos los modelos Gemini 4, mientras que el desglose citado indica que la documentación activa enumera actualmente gemini-4-hydrogen, gemini-4-argon, gemini-3.8-flash y gemini-3.6-flash. Confirma tu modelo en la documentación antes de asumir que los modelos relacionados también funcionan. No se ha anunciado fecha para disponibilidad general. Anthropic lanzó la misma idea de defer_loading como beta en noviembre de 2025; las diferencias de Google son el diferimiento de MCP del lado servidor y el modo cliente, según la cobertura del lanzamiento.
| Forma de tu biblioteca | Modo recomendado | Primera acción |
|---|---|---|
| Pequeña y estable | Carga estática | Mide los tokens de esquema antes de añadir complejidad |
| 50–200 herramientas, pocas usadas por tarea | Diferimiento del lado servidor | Difiere las menos usadas y mantén cargadas las herramientas frecuentes |
| Herramientas por usuario o durante el chat | Recuperación del lado cliente | Crea una búsqueda que tenga en cuenta los permisos |
| Todas las herramientas se usan en todos los turnos | Carga estática | La sobrecarga de búsqueda probablemente supera el ahorro |
Lanza primero una parte de las herramientas de cola larga y compara tokens de entrada, total_tool_use_tokens, latencia y éxito de tarea, con y sin diferimiento, en tareas idénticas.
Preguntas frecuentes
¿Tool Retrieval funciona con generateContent?
No. Solo funciona con Interactions API en v1beta.
¿Qué modelos son compatibles?
Se anunció para Gemini 3.6 y posteriores, incluido Gemini 4; el desglose citado indica que la documentación activa lo limita actualmente a modelos que incluyen gemini-4-hydrogen y gemini-3.6-flash. Consulta la documentación para tu modelo exacto.
¿Puede aumentar mi factura?
Sí. La carga de trabajo ilustrativa citada de 10 herramientas sube de ~68.000 a ~92.830 tokens cuando se realizan búsquedas en casi todos los turnos.