 AIREITER
Resolver una incidencia con un agente de programación que inspecciona archivos, ejecuta pruebas y repite el ciclo puede consumir entre 50.000 y 200.000 tokens. Con una tarifa de salida de $30/M, GPT-5.6 Sol supone entre $1.50 y $6 solo en tokens de salida por tarea. DeepSeek V4 Pro figura a $0.87/M de salida, aproximadamente 1/34 del coste, aunque su fiabilidad en procesos de varios pasos no se ha evaluado de forma independiente con la misma profundidad que Claude o GPT. A continuación comparamos seis modelos según benchmarks de programación publicados, precios de API verificados, límites de contexto y el flujo de trabajo de agente para el que mejor encajan.
Los seis LLM a tener en cuenta para agentes de programación en 2026
Cada modelo combina cifras de benchmarks procedentes de fuentes oficiales o clasificaciones públicas con precios de API verificados en agosto de 2026. Cuando el modelo concreto no cuenta con una puntuación publicada, se indica la variante disponible más cercana como referencia.
1. Claude Opus 5 — El referente en calidad
Claude Opus 5 mantiene a la familia Claude en cabeza de la clasificación oficial de SWE-bench Verified. Claude 4.5 Opus, su predecesor, obtuvo un 76.8% con el harness mini-SWE-agent; es una referencia útil para anticipar el nivel de Opus 5, aunque todavía no se han publicado resultados de SWE-bench Verified específicos para Opus 5. Ofrece una ventana de contexto de 1 millón de tokens y una salida máxima de 128K tokens. Con $5/M de entrada y $25/M de salida, es la alternativa convencional más cara de esta lista. Merece la pena cuando el tiempo humano que se pierde por fallar una refactorización de varios archivos cuesta más que los tokens. Para modificaciones rutinarias a gran escala, no es la opción adecuada.
2. GPT-5.6 Sol — Especialista en tareas de terminal
GPT-5.6 Sol (ID de modelo gpt-5.6-sol) cuesta $5/M de entrada y $30/M de salida, y dispone de una ventana de contexto de 1.05 millones de tokens. En la comparativa de benchmarks publicada por xAI, GPT-5.6 Sol Max lidera Terminal-Bench v3.0 con un 34.6% frente al 26% de Grok 4.6, y alcanza un 73% en DeepSWE v1.1. Son los benchmarks más relevantes para los bucles de agentes orientados a la terminal. La contrapartida está en el precio: con $30/M de salida, Sol es el modelo más caro de esta selección. OpenAI también informa de puntuaciones de SWE-bench Pro del 64.6% para Sol y del 63.4% para Terra, su variante intermedia, una opción a considerar si buscas un modelo de OpenAI más asequible para tareas menos exigentes.
3. Grok 4.6 — Gran relación calidad-precio para agentes persistentes
Grok 4.6, lanzado el 12 de agosto de 2026, está pensado para flujos de agentes que se prolongan en el tiempo. Según el anuncio de xAI, iguala a GPT-5.6 Sol Max en el Artificial Analysis Intelligence Index, con 61 puntos, y lo supera en CursorBench v3.2 (69.9% frente a 67.2%), FrontierCode v1.1 (61.3% frente a 60.6%) y APEX-Agents (57.5% frente a 56.7%). Con $2/M de entrada y $6/M de salida, ofrece un rendimiento de benchmark comparable al de GPT-5.6 Sol Max por cerca de una quinta parte del coste de salida. Su punto débil es la ejecución pura en terminal: logra un 26% en Terminal-Bench v3.0, bastante por detrás del 34.6% de Sol Max. Si tu flujo se centra en un IDE, como Cursor o Grok Build, en lugar de priorizar la terminal, Grok 4.6 es la opción de esta lista con mejor calidad por dólar. La variante "fast" duplica las tarifas a $4/$12 a cambio de menor latencia. Su ventana de contexto es de 500K tokens.
4. DeepSeek V4 Pro — El modelo de batalla para presupuestos ajustados
DeepSeek V4 Pro es el modelo de nivel frontera más económico disponible por API: $0.435/M de entrada y $0.87/M de salida; la entrada en caché baja hasta $0.003625/M. Su ventana de contexto de 1 millón de tokens y una salida máxima de 384K tokens lo hacen viable para tareas a escala de repositorio. No existe un benchmark público de agentes en varios pasos que evalúe DeepSeek V4 Pro frente a Claude o GPT con la misma profundidad de harness, así que conviene validar la fiabilidad de las llamadas a herramientas en sesiones largas dentro de tu propia configuración antes de usarlo para refactorizaciones complejas. Para equipos con presupuesto limitado o como modelo de primera pasada en una arquitectura con enrutamiento, las cifras son muy atractivas. En las refactorizaciones más difíciles, donde la fiabilidad importa más que el precio por token, habrá que escalar a otro modelo.
5. Gemini 3.1 Pro — Para leer repositorios completos
La versión Preview de Gemini 3.1 Pro de Google cuesta $2/M de entrada y $12/M de salida para prompts de menos de 200K tokens; por encima de ese umbral, las tarifas suben a $4/$18. Su gran baza es la capacidad de contexto: la ventana de 2 millones de tokens de Gemini es la mayor entre los modelos de esta lista, por lo que resulta adecuada para cargar una base de código completa de una vez. Como aproximación al nivel esperable de 3.1 Pro, Gemini 3 Flash obtuvo un 75.8% en SWE-bench Verified en una instantánea de junio de 2026 de Tembo, solo por detrás de Claude 4.5 Opus. La consistencia de Gemini al llamar herramientas en bucles de agentes largos no se ha evaluado con la misma profundidad que Claude o GPT; pruébalo con tu harness antes de desplegarlo en flujos de varios pasos.
6. Kimi K3 — La alternativa de pesos abiertos para agentes
Kimi K3, de Moonshot AI, logró un 70.8% en SWE-bench Verified en la misma instantánea de junio de 2026, por debajo de GLM-5 (72.8%) y MiniMax M2.5 (75.8%) dentro de los modelos de pesos abiertos. Al ser un modelo open-weight, los equipos cuyo código no puede salir de su red pueden autoalojarlo. La API alojada de Moonshot también ofrece K3, aunque el precio concreto depende de la configuración de despliegue. Para instalaciones locales con GPU suficiente, K3 junto a un harness ligero como OpenCode permite crear un agente de programación competente sin coste de API por token.
Precios de API y coste por incidencia resuelta
El precio por token cuenta solo una parte de la historia. La métrica relevante es el coste por tarea completada: cuánto cuesta resolver una incidencia real de GitHub mediante un bucle de agente.
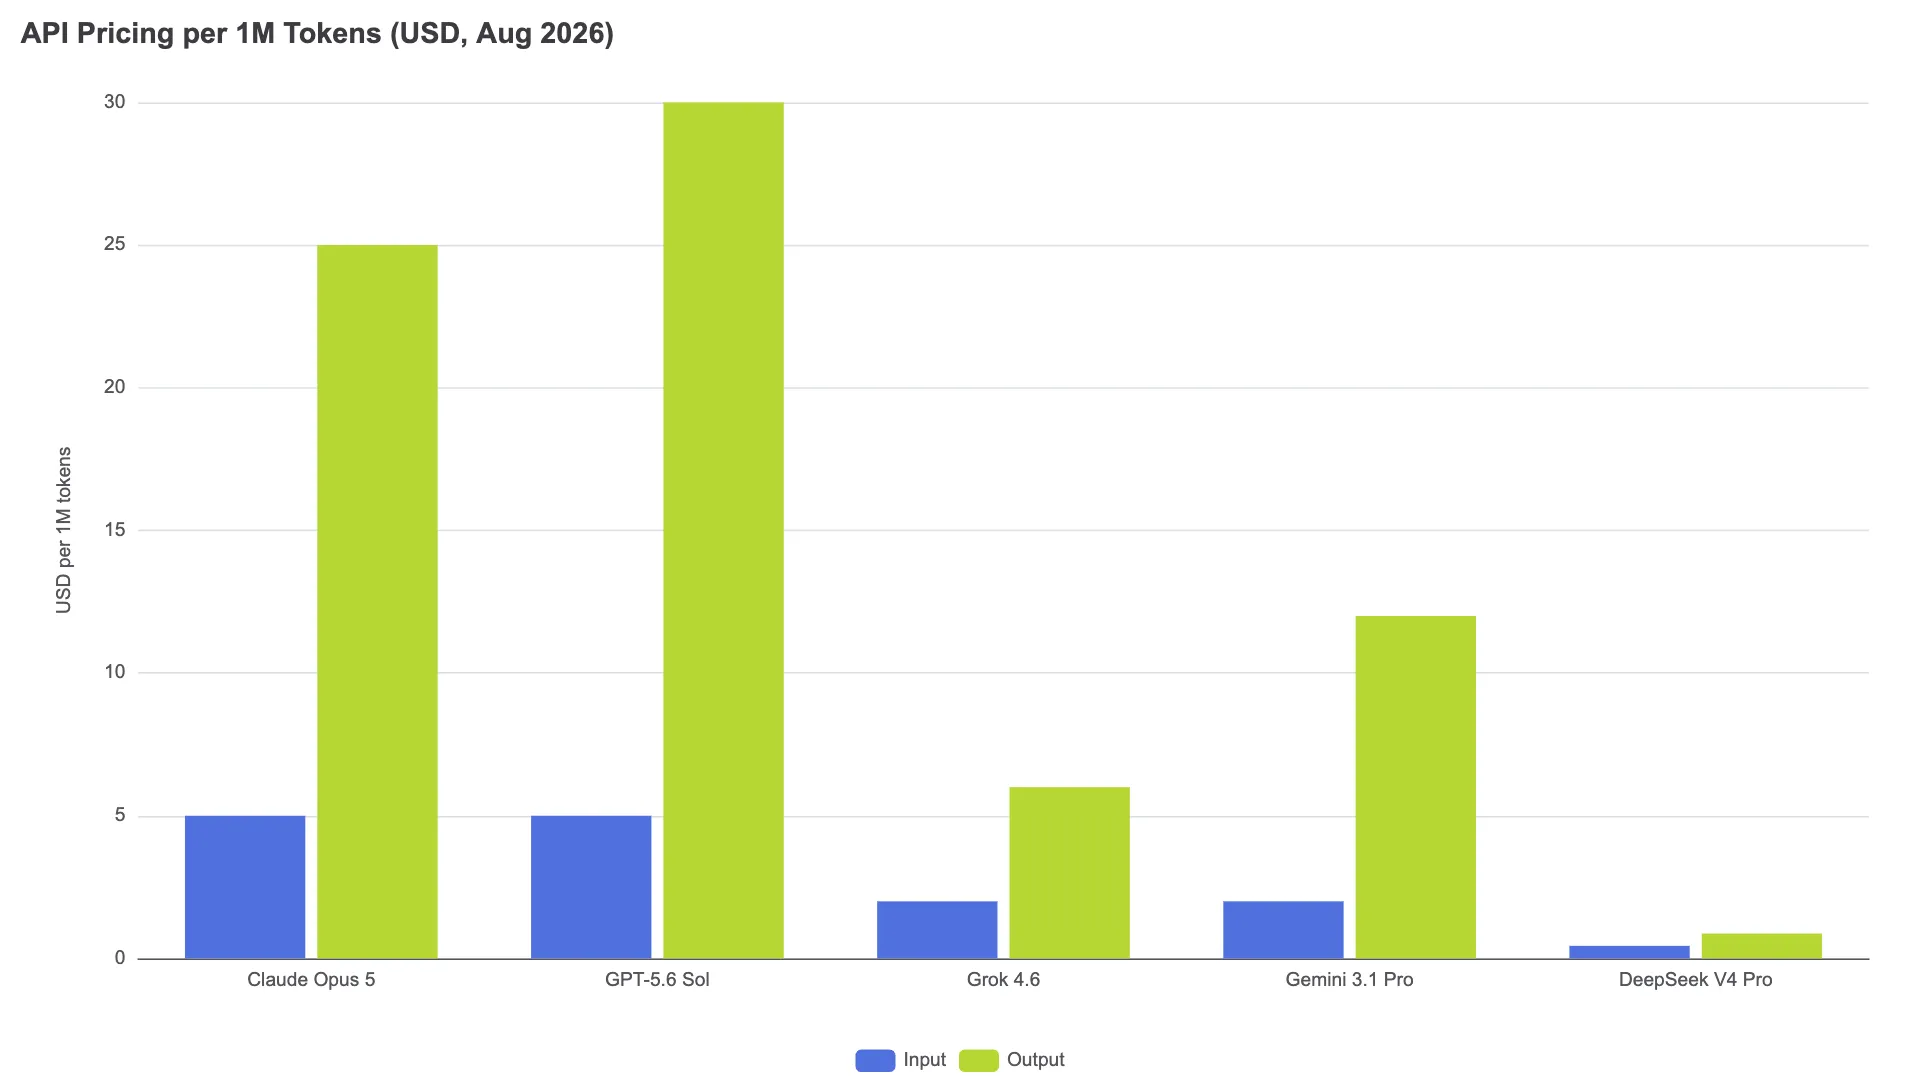
Un bucle de agente habitual —leer archivos, planificar, editar, ejecutar pruebas y corregir fallos— consume aproximadamente entre 50K y 200K tokens por incidencia resuelta; los tokens de salida representan entre el 30% y el 50% del total. Son estimaciones del sector obtenidas de los análisis de bucles de agentes de Tembo y otras fuentes; el consumo real dependerá del tamaño del repositorio, la duración de la suite de pruebas y la eficiencia del harness. Tomando un punto medio de 125K tokens totales, con 75K de entrada y 50K de salida, este sería el coste de resolver una incidencia con cada modelo:
| Modelo | Coste de entrada | Coste de salida | Total por tarea |
|---|---|---|---|
| Claude Opus 5 | $0.375 | $1.25 | $1.63 |
| GPT-5.6 Sol | $0.375 | $1.50 | $1.88 |
| Grok 4.6 | $0.15 | $0.30 | $0.45 |
| Gemini 3.1 Pro | $0.15 | $0.60 | $0.75 |
| DeepSeek V4 Pro | $0.033 | $0.044 | $0.077 |
Kimi K3 no aparece en la tabla porque su coste depende por completo de si utilizas la API alojada de Moonshot o lo autoalojas en tus propias GPU; no hay un precio de lista único que permita compararlo. Grok 4.6 encuentra un punto especialmente atractivo con $0.45 por tarea: iguala la puntuación de GPT-5.6 Sol Max en el Artificial Analysis Intelligence Index por cerca de una cuarta parte del coste por tarea de Sol.
Estas estimaciones no incluyen reintentos, descuentos por tokens en caché, sobrecoste de llamadas a herramientas ni infraestructura. En la práctica, un modelo que requiera más reintentos o correcciones humanas por tarea costará más de lo que indica su tarifa por token. Por eso, una estrategia de enrutamiento —asignar el trabajo rutinario a DeepSeek o Grok y elevar las refactorizaciones difíciles a Opus— puede rendir mejor que apostar por un único modelo.
Qué modelo elegir según el trabajo del agente
No hay un modelo único que encaje en todos los flujos. Esta es la asignación más adecuada según el tipo de trabajo.
Ciclos rápidos y cambios rutinarios. Usa Gemini 3.5 Flash ($1.50/$9 por M de tokens) o Claude Sonnet 5 para tareas frecuentes y de bajo riesgo: explicar errores, añadir funciones pequeñas, crear esqueletos de pruebas o actualizar documentación.
Refactorización profunda y arquitectura. Claude Opus 5 es la elección cuando el trabajo implica cambios en varios archivos, dependencias entre módulos o decisiones de arquitectura en las que una mala interpretación puede costar horas de depuración. Su precisión al seguir instrucciones y su coherencia de contexto sostenida en sesiones largas son sus principales diferencias.
Agentes autónomos de larga duración. Grok 4.6 se diseñó precisamente para este escenario. Según el anuncio de xAI, su desarrollo se centró en trayectorias de agente sostenidas y en comportamientos de autoverificación. Con $0.45 por tarea, puedes dejarlo trabajar durante más tiempo sin la presión de coste que generan los $1.88 por tarea de GPT-5.6 Sol. Para flujos con mucho peso de terminal, la ventaja de GPT-5.6 Sol en Terminal-Bench (34.6%) lo convierte en la alternativa más segura.
Presupuesto limitado y autoalojamiento. DeepSeek V4 Pro por API es la opción predeterminada para equipos sensibles al coste, con $0.077 por tarea. Si tu organización no puede enviar código a API externas, autoaloja un modelo de pesos abiertos como Kimi K3 (70.8% en SWE-bench Verified) o MiniMax M2.5 (75.8%). Los modelos open-weight han recortado la distancia con los líderes de pesos cerrados hasta situarse a pocos puntos porcentuales en SWE-bench Verified.
El límite puede estar en el harness, no en el modelo
El harness que utiliza tu agente —Claude Code, Codex CLI, Cursor o una herramienta open source como OpenCode— controla cuatro aspectos que el modelo no puede resolver por sí mismo: la gestión de contexto, incluido cuándo compactarlo y qué conservar; las definiciones y el enrutamiento de herramientas; los patrones de recuperación ante errores; y los flujos de revisión y aprobación. Como señala el análisis de Tembo, la puntuación de un modelo en un entorno controlado como mini-SWE-agent puede no reflejar su tasa real de resolución en una configuración distinta. Por eso, para comparar modelos resultan más útiles los benchmarks que mantienen constante el harness que las cifras publicadas por proveedores, donde se mezclan las mejoras del modelo y del propio harness.
Antes de cambiar de modelo, revisa tu harness. Comprueba si el agente compacta bien el contexto, si las definiciones de herramientas son claras y si la recuperación de errores reintenta con criterio en lugar de entrar en bucles.
Preguntas frecuentes
¿Qué LLM es el más barato para agentes de programación?
DeepSeek V4 Pro, con $0.435/M de entrada y $0.87/M de salida, es la opción de nivel frontera más económica y cuesta aproximadamente $0.08 por tarea de agente resuelta.
¿Cómo pruebo modelos para agentes de programación en mi propio repositorio?
Selecciona entre 20 y 30 incidencias representativas de tu backlog real, combinando correcciones de errores, nuevas funciones y refactorizaciones. Ejecuta cada modelo con el harness que hayas elegido sobre las mismas tareas. Mide tres aspectos: tasa de resolución —¿el parche del agente supera tus pruebas?—, consumo de tokens por tarea y tiempo hasta completarla. Esta evaluación específica de tu repositorio predice mejor el resultado que cualquier benchmark público.