 AIREITER
Con un precio de $0.04 por millón de tokens de entrada, la API alojada sigue siendo el camino más directo. Pero los nuevos checkpoints de pesos abiertos ya hacen viable la inferencia local, aunque la diferencia de calidad entre los modelos de 3B y 600M es considerable.
Las tres variantes de Liquid d1 sirven para cosas distintas
Liquid AI ofrece ahora tres opciones relevantes: el servicio propietario alojado d1, el modelo de pesos abiertos d1-3B y el experimental, también de pesos abiertos, d1-omni-600M. Liquid AI no ha confirmado que su modelo alojado sea idéntico a ninguno de los checkpoints descargables, así que las cifras de benchmarks y latencia deben atribuirse siempre al modelo concreto que las produjo.
| Opción | Acceso y precio | Entradas | Contexto publicado | Mejor uso |
|---|---|---|---|---|
d1 alojado | Liquid API; $0.04 por 1M de tokens de entrada, sin cargo por tokens de salida | Texto e imágenes directamente desde Liquid | 66K según Vercel | Integración rápida, factura de inferencia mínima y sin operar modelos |
d1-3B | Pesos descargables; sin tarifa del modelo por token | Texto, JSON e imágenes | 32,768 tokens | Mejor calidad local, visión y evaluación para producción |
d1-omni-600M | Pesos experimentales descargables; sin tarifa del modelo por token | Texto más imagen, o texto más audio | 16,384 tokens | Huella reducida, experimentos con comandos de voz y dispositivos edge limitados |
Los tres responden preguntas tipadas en vez de redactar texto. noul devuelve una probabilidad de sí, choice entrega probabilidades para opciones con nombre y score devuelve una posición ponderada por probabilidad sobre una rúbrica ordenada. Son modelos adecuados para enrutamiento, moderación, inspección, guardrails y puntuación; no sustituyen a un modelo de chat o de programación.
La recomendación es clara: usa el d1 alojado para un piloto, elige d1-3B cuando los datos deban permanecer en local o la latencia no pueda asumir un salto de red, y considera d1-omni-600M un experimento salvo que el audio o la huella sean la restricción decisiva.
Precio de la API frente al coste local
La API d1 de Liquid AI cuesta $0.04 por millón de tokens de entrada y no cobra por tokens de salida, porque devuelve decisiones en lugar de texto generado. Una carga de trabajo de 100 millones de tokens de entrada cuesta $4 antes de posibles tarifas de gateway; mil millones de tokens de entrada cuestan $40.
A $0.04/M de tokens, el autoalojamiento rara vez compensa solo por coste de inferencia. El despliegue local tiene sentido por privacidad, uso sin conexión, latencia en el dispositivo, personalización o utilización sostenida.
Los dos checkpoints abiertos no tienen un precio oficial alojado por token. Sus páginas de Hugging Face no mostraban ningún proveedor de inferencia en el momento de la revisión, por lo que el precio del d1 alojado no debe presentarse como si fuera el de d1-3B o d1-omni-600M.
El servicio alojado también factura las imágenes como entrada. Liquid AI especifica 1.5 tokens por parche de 32×32 píxeles, por lo que una imagen de 1024×1024 equivale a 1,536 tokens antes del texto de la pregunta. A $0.04/M, la parte correspondiente a la imagen cuesta aproximadamente $0.00006144; cada pregunta se factura como un prompt independiente e incluye su imagen asociada.
Que los pesos sean abiertos no implica uso sin límites ni sin coste
Ambos repositorios usan la licencia lfm1.0 de Liquid AI, no Apache 2.0 ni MIT. Los términos generales de precios de Liquid AI indican que sus modelos descargables son gratuitos para uso comercial por empresas con menos de $10 millones de ingresos anuales; las organizaciones más grandes deberían comprobar las condiciones comerciales vigentes en vez de asumir que la expresión “open-weight” concede ese permiso.
Al presupuestar una instalación local, cuenta también la compra de GPU o dispositivos, la capacidad ociosa, la monitorización, las actualizaciones y el tiempo del equipo. La factura alojada es variable y muy baja; el coste local es mayoritariamente fijo.
d1-3B prioriza calidad; omni reduce la huella
El anuncio de Open d1 oficial informa de una puntuación Decision Index v0.2.1 de 48.57 para d1-3B y de 15.95 para d1-omni-600M. Liquid AI ejecutó ambos modelos con el evaluador oficial, pero los resultados no fueron envíos oficiales a la clasificación.
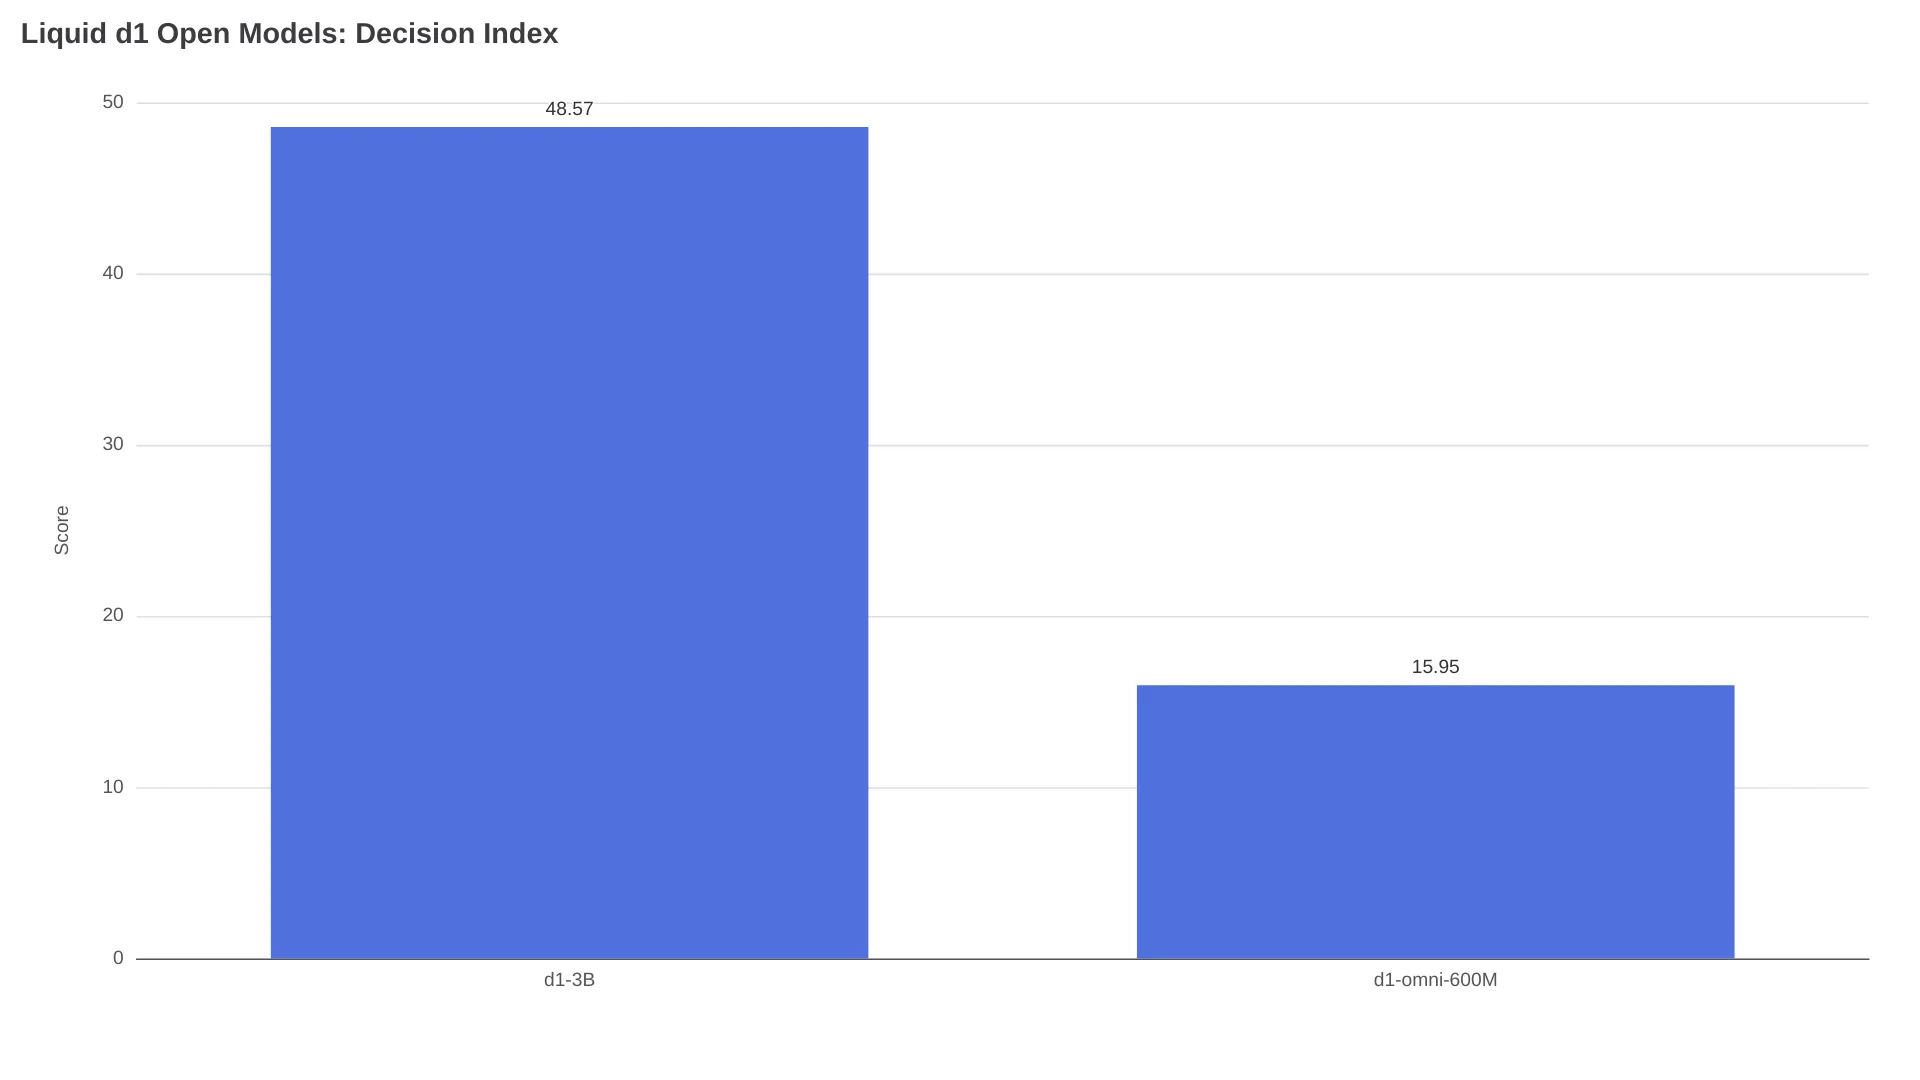
El modelo pequeño no rinde mal en todos los casos. En siete benchmarks públicos de texto, Liquid AI informa de medias de 82.9 para d1-3B y 78.4 para d1-omni-600M. Omni quedó por delante en Civil Comments (95.8 frente a 93.0) y PAWS-X (79.5 frente a 76.9), mientras que 3B lideró las otras cinco tareas listadas. La brecha mucho mayor en Decision Index indica que algunos buenos resultados de clasificación no convierten al checkpoint de 600M en un sustituto general de 3B.
| Especificación | d1-3B | d1-omni-600M |
|---|---|---|
| Número detallado de parámetros | 3.12B | 587M |
| Tamaño del repositorio/pesos a precisión completa | Repositorio de 6.27 GB; pesos de 6.25 GB | Modelo F32, aproximadamente 0.6B de parámetros |
| Contexto | 32,768 | 16,384 compartidos entre modalidades |
| Límite de texto con imágenes | Dentro del contexto del modelo | El estado y el texto de la pregunta se recortan a 896 tokens con imágenes |
| Audio | No | Un clip mono de 16 kHz, de hasta 30 segundos |
| Imagen y audio a la vez | No aplicable | No compatible; genera ValueError |
| Tabla oficial de velocidad | Sí | No; lanzamiento temprano de investigación |
La ficha del modelo d1-omni-600M indica que fue entrenado en float32. Float16 conservó la respuesta principal en 243 filas de texto, 214 de imagen y 416 de audio, mientras que bfloat16 cambió la respuesta principal en el 0.8% de las filas de texto y el 1.7% de las de audio. Por tanto, el dtype debe validarse: no es solo un ajuste de optimización.
El despliegue local se instala rápido, pero requiere mucha validación
Ambas fichas de modelo exponen system_one para un estado y system_one_batch para solicitudes agrupadas. El camino más corto con d1-3B utiliza Transformers 5.14 o posterior, PyTorch, TorchVision, Pillow y código personalizado suministrado por el repositorio.
- Instala las dependencias documentadas:
pip install "transformers>=5.14" torch torchvision pillow- Carga el modelo permitiendo la ejecución de código remoto del repositorio:
import torch
from transformers import AutoModel

model_id = "LiquidAI/d1-3B"
device = "cuda" if torch.cuda.is_available() else "cpu"
dtype = torch.bfloat16 if device == "cuda" else torch.float32

model = AutoModel.from_pretrained(
    model_id,
    trust_remote_code=True,
    torch_dtype=dtype,
).to(device)- Envía decisiones con nombre, no un prompt de chat:
questions = {
    "queue": {
        "type": "choice",
        "instructions": "Which team should handle this ticket?",
        "criteria": {
            "billing": "Charges, invoices, and refunds",
            "technical": "Application or website faults",
            "fraud": "Suspected unauthorized use",
        },
    }
}

result = model.system_one(
    "I was charged twice this month; refund one charge.",
    questions,
)
print(result["answers"]["queue"])
trust_remote_code=True implica que el Python del repositorio se ejecuta en el proceso de serving. Antes de llegar a producción, fija un commit revisado en lugar de cargar una rama cambiante. El repositorio d1-3B también enlaza cuantizaciones para runtimes compatibles con llama.cpp, Ollama y LM Studio; un artefacto cuantizado de la comunidad supone una decisión distinta de cadena de suministro y precisión frente a los pesos BF16 oficiales.
La ficha del modelo d1-3B informa de tiempos en llamadas en caliente de 8 ms para una pregunta en una RTX 4090, 30 ms en un Apple M5 Pro y 50 ms en un Jetson Orin Nano. Un estado de 3.4K tokens tardó 102 ms, 640 ms y 1,640 ms en esos mismos dispositivos. Las cifras de GPU son medianas de 20 ejecuciones; el resultado de 8 ms en la 4090 usó grafos CUDA compilados, y una nueva forma de entrada asume sobrecarga de compilación o selección de kernel.
No existe una tabla oficial de velocidad para d1-omni-600M. Un port para navegador informó de aproximadamente 180 ms por comentario para cuatro decisiones:
“I didn't test it against other machines yet, just my MBP M4 Pro.” — u/FinancialAd1961 on Reddit
Ese resultado en un único dispositivo demuestra que puede ejecutarse en navegador, no su rendimiento en distintos navegadores, GPU, cuantizaciones o tamaños de lote.
La API es más sencilla, pero la identidad del modelo sigue importando
El acceso alojado directo utiliza el modelo d1 en https://api.liquid.ai/decisions/v1/systemone. Vercel usa liquid/d1; su página lista un contexto de 66K y la misma tarifa de entrada de $0.04/M. El anuncio de Liquid del 5 de octubre señalaba que Vercel y OpenRouter solo admitían texto en ese momento, mientras que la API directa de Liquid aceptaba imágenes.
Los checkpoints abiertos usan métodos locales de Python con los mismos conceptos de decisión, pero una interfaz parecida no demuestra equivalencia de comportamiento. Sus probabilidades pueden diferir lo suficiente como para mover un caso a través de un umbral de automatización. Registra el ID exacto del modelo, la revisión, el dtype, la probabilidad y el umbral en cada rama evaluada.
Por ello, una migración debería seguir cuatro pasos:
- Crea un conjunto etiquetado a partir de la distribución real de producción, incluidos los errores ambiguos y costosos.
- Ejecuta los mismos estados, esquema de preguntas y criterios en cada candidato.
- Elige los umbrales según el coste de falsos positivos y falsos negativos, no a partir de una puntuación global de benchmark.
- Ejecuta el ganador en sombra antes de permitir acciones destructivas, financieras, de control de acceso o de seguridad.
¿Qué Liquid d1 deberías elegir?
La API alojada es la recomendación predeterminada para la mayoría de equipos. Su precio por token es demasiado bajo como para que un piloto pequeño justifique un proyecto de serving local, y evita el trabajo de drivers, cuantización, calentamiento y capacidad.
| Requisito | Elección | Motivo |
|---|---|---|
| Camino más rápido a producción | d1 alojado | Endpoint gestionado y precio de entrada explícito |
| Los datos no pueden salir del dispositivo o la red | d1-3B | El checkpoint abierto más sólido y ejecución local |
| Mejor calidad publicada de decisión entre los modelos abiertos | d1-3B | 48.57 en Decision Index frente a 15.95 |
| Clasificación de comandos de audio | d1-omni-600M | Es la única opción aquí con audio, limitado a 30 segundos |
| Huella experimental más pequeña | d1-omni-600M | 587M de parámetros, pero sin tabla oficial de latencia |
| Explicaciones abiertas o acciones generadas | Ninguno | Añade un modelo generativo después de la etapa de decisión |
Elige d1-3B antes que omni salvo que la huella de 600M o la ruta de audio sean imprescindibles. Una reducción de parámetros de cinco veces resulta atractiva, pero no elimina la brecha de 32.62 puntos en Decision Index ni el estatus experimental de omni.
Preguntas frecuentes sobre Liquid AI d1
¿Liquid AI d1 es gratis?
El servicio alojado d1 cuesta $0.04 por millón de tokens de entrada y no cobra por tokens de salida. Los checkpoints abiertos pueden descargarse sin tarifa por token, pero siguen aplicándose los términos comerciales de LFM 1.0 y los costes de computación local.
¿d1-3B y d1-omni-600M son el mismo modelo que la API d1 alojada?
Liquid AI no ha documentado que ninguno de los checkpoints sea idéntico al d1 alojado. Trátalos como productos relacionados con IDs de modelo, contextos, benchmarks y rutas de despliegue independientes.
¿Puedo ejecutar Liquid d1 con Ollama?
La página de d1-3B enlaza cuantizaciones destinadas a llama.cpp, Ollama, LM Studio y aplicaciones compatibles. Comprueba el cuantizador, la revisión de origen, el soporte para la API de decisiones y la precisión antes de sustituir la ruta oficial de Transformers.
¿d1-3B admite audio?
No. d1-3B acepta texto, JSON e imágenes. d1-omni-600M acepta texto más imágenes o texto más un clip de audio de hasta 30 segundos, pero no puede aceptar imágenes y audio en la misma solicitud.
¿Cuánta VRAM necesita d1 local?
Liquid publica un archivo de pesos BF16 de 6.25 GB para d1-3B, pero no proporciona un requisito universal de VRAM. La sobrecarga de ejecución, el estado del codificador de imágenes, la longitud de contexto, el tamaño de lote, la precisión y la cuantización modifican el total; mide la configuración prevista en lugar de equiparar el tamaño del archivo con el pico de VRAM.
Elijas la ruta que elijas, valida los umbrales de probabilidad con datos de producción etiquetados antes de automatizar decisiones relevantes.
Lectura relacionada: el análisis de la API alojada Liquid AI d1 explica con más detalle el endpoint directo, la facturación de imágenes y el contrato de solicitudes tipadas.