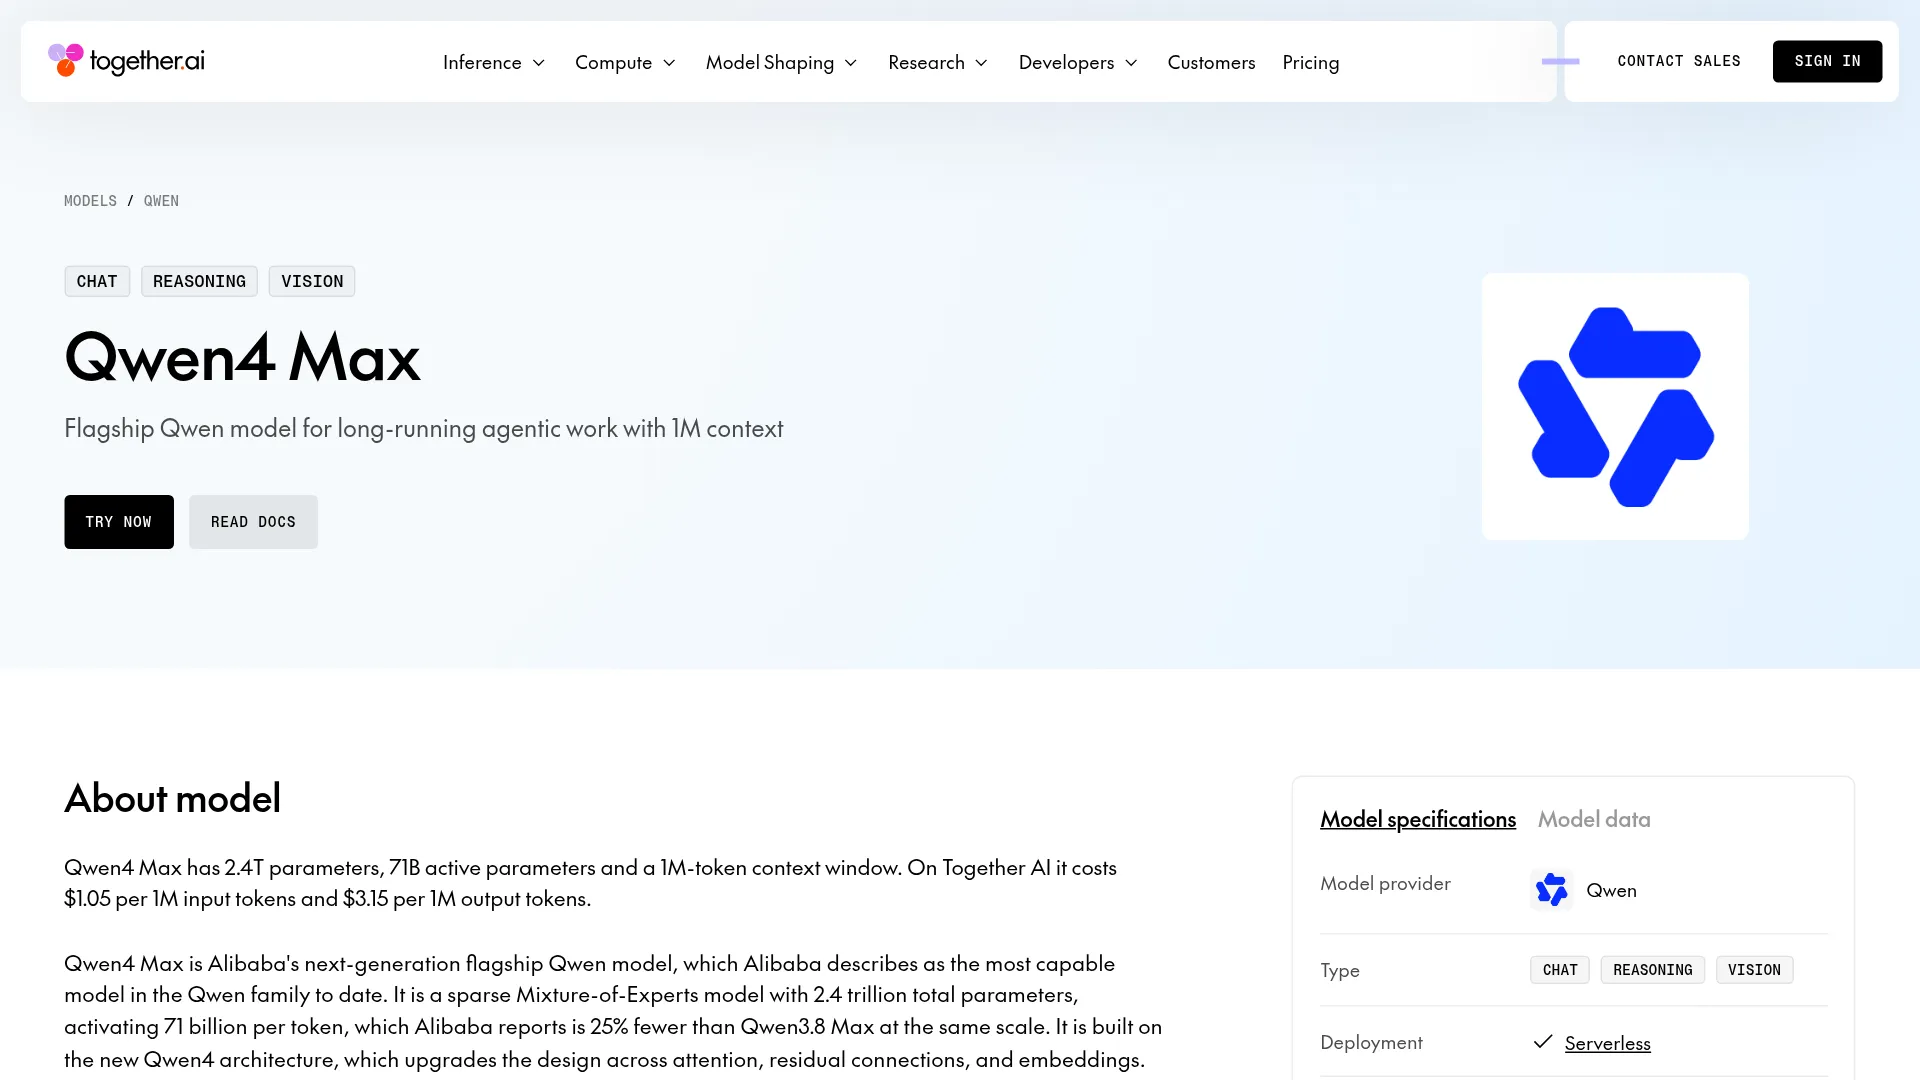
Together AI ofrece Qwen4 Max a $1.05 por cada millón de tokens de entrada y $3.15 por cada millón de tokens de salida. La promoción está vigente hasta el 22 de noviembre de 2026; conviene comprobar la página en directo para confirmar el cambio, ya que después las tarifas pasan a ser de $1.50 y $4.50. Durante la promoción es la opción más barata. Cuando termine, la igualdad de precios hará que la caché, la latencia y el enrutamiento sean los factores decisivos.
El endpoint Qwen/Qwen4-Max, el contexto de 1M y los precios promocionales aparecen en la página del modelo de Together AI y en su artículo de lanzamiento, publicado el 21 de noviembre de 2026.
Qué costó $0.69: 344 archivos en una sola petición
Together AI envió los 344 archivos de Tornado —652,519 tokens de entrada— junto con un informe sobre un fallo de WebSocket en una única petición, sin recuperación de información ni herramientas (artículo de lanzamiento de Together AI). Qwen4 Max detectó el problema, propuso un parche y superó tanto las pruebas nuevas como las 1.673 pruebas existentes. El primer token llegó en 54 segundos y la respuesta terminó en 72 segundos (artículo de lanzamiento de Together AI).
La ejecución costó aproximadamente $0.69 con la promoción o $0.98 con la tarifa estándar, casi todo por la entrada. Al reutilizar unos 630.000 tokens en caché, el coste de entrada bajó de unos $0.66 a $0.03 y la latencia hasta el primer token pasó de 54 a 8 segundos. Eso sí, la caché funciona como una prestación de mejor esfuerzo (artículo de lanzamiento de Together AI).
"tested it via Alibaba's Token Plan, it performed better than DeepSeek 4.1Flash (on couple of coding tasks + remote instance work) but it took forever to finish." — u/FlounderRecent en r/Qwen_AI
Precios de Together AI, de un vistazo
Together AI publica la fecha de finalización, pero no la hora ni la zona horaria del cambio (página del modelo); compruébalo antes de lanzar una ejecución grande. El coste se calcula así: entrada / 1M x tarifa de entrada + salida y razonamiento / 1M x tarifa de salida, aplicando la tarifa de caché a la entrada almacenada en caché.
| Tarifa | Entrada / 1M | Entrada en caché / 1M | Salida / 1M |
|---|---|---|---|
| Promoción de Together AI (hasta el 22 de noviembre de 2026) | $1.05 | $0.0525 | $3.15 |
| Tarifa estándar de Together AI | $1.50 | $0.075 | $4.50 |
La entrada en caché cuesta el 5 % de la entrada normal. Los tokens de razonamiento cuentan como tokens de salida (artículo de lanzamiento de Together AI).
| Carga de trabajo | Entrada | Salida | Coste promocional | Coste estándar |
|---|---|---|---|---|
| Sesión de programación agéntica | 60,000 | 4,000 | $0.0756 | $0.108 |
| Petición sobre el repositorio completo de Tornado | 652,519 | ~2,000 estimados | ~$0.69 | ~$0.98 |
| Repetición en caché de un prompt de ~630k | ~630,000 en caché | pequeña | ~$0.03 de entrada | ~$0.047 de entrada |
La salida de la fila de Tornado es aproximada porque los tokens de razonamiento facturados varían según el nivel de esfuerzo.
Contexto de 1M en Together AI: la cifra anunciada frente a la entrada realmente utilizable
Qwen4 Max anuncia 1M de tokens compartidos entre el prompt, el razonamiento y la salida. Una captura de un gateway sitúa la entrada utilizable en unos 984k (Sovyron); Vercel limita la salida a 384k y contabiliza el razonamiento dentro de ese límite. Si la entrada supera los 900k, deja un margen aproximado de 100k.
Tres detalles de Together AI que pueden hacer fallar la primera petición
1. Las peticiones sin streaming devuelven streaming_required. Together AI solo acepta streaming (artículo de lanzamiento). Las peticiones sin streaming responden con HTTP 400. La solución es añadir "stream": true o stream=True.
2. El razonamiento viene activado y se factura como salida. El stream separa delta.reasoning de delta.content (artículo de lanzamiento). Para extracciones sencillas y baratas, desactívalo:
response = client.chat.completions.create(
    model="Qwen/Qwen4-Max",
    messages=messages,
    stream=True,
    reasoning={"enabled": False},
)
"reasoning_effort": "max" aumenta el esfuerzo dedicado a tareas más complejas (artículo de lanzamiento).
3. Solo serverless, caché de mejor esfuerzo y cero secretos en el prompt. No hay fine-tuning ni endpoint dedicado (artículo de lanzamiento). La caché es automática, pero no está garantizada. El ejemplo enumera todos los archivos controlados por git ls-files (artículo de lanzamiento), así que elimina cualquier secreto antes de enviar un repositorio completo.
Together frente a QwenCloud y OpenRouter: dónde invocarlo
| Proveedor | Entrada / 1M | Salida / 1M | Lectura de caché / 1M | Notas |
|---|---|---|---|---|
| Together AI en promoción | $1.05 | $3.15 | $0.0525 | Hasta el 22 de noviembre; Qwen/Qwen4-Max, solo serverless y solo streaming |
| Together AI tarifa estándar | $1.50 | $4.50 | $0.075 | El mismo endpoint después de la promoción |
| QwenCloud | $1.50 | $4.50 | $0.075 | Ruta directa de Qwen con la tarifa de Singapur citada |
| OpenRouter mediante Ailyre / CloudTweaks | $1.425 | $4.275 | ~$0.071 | Enrutamiento global; capturas del 20 al 22 de noviembre |
| Deep Infra / Novita AI mediante Sovyron | $1.413 | $4.24 | ~$0.071 | La tarifa no promocional más baja en la captura de Sovyron del 17 de noviembre |
| Vercel AI Gateway | $1.50 | $4.50 | $0.08 lectura / $1.88 escritura | Captura publicada: 3.3 s de latencia, 52 tok/s, 93 % de aciertos de caché; crédito de $5 |
Mientras dure la promoción, Together AI es la opción más barata para prompts repetidos. Después, las capturas citadas sitúan a Deep Infra o Novita AI entre las alternativas no promocionales más económicas, mientras que OpenRouter y Vercel cobran una pequeña prima a cambio de enrutamiento y herramientas.
Cómo iniciar una petición con streaming en Together AI
curl -X POST "https://api.together.ai/v1/chat/completions" \
  -H "Authorization: Bearer $TOGETHER_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"model": "Qwen/Qwen4-Max", "messages": [{"role": "user", "content": "Hi"}], "stream": true}'from together import Together
client = Together()
response = client.chat.completions.create(
model="Qwen/Qwen4-Max",
messages=[{"role": "user", "content": "Explain this diff in 3 bullets."}],
stream=True,
)
for chunk in response:
print(chunk.choices[0].delta.content or "", end="")Patrón para un repositorio completo: incluir los archivos del repositorio como entradas === FILE: path === en el mensaje de sistema, añadir el informe del fallo en el mensaje de usuario y transmitir después el parche (artículo de lanzamiento).
¿Conviene enrutar Qwen4 Max a través de Together AI?
| Carga de trabajo | Ruta recomendada esta semana | Motivo |
|---|---|---|
| Triaje del repositorio completo (300-650k de entrada) | Promoción de Together AI | Pasada de unos $0.69; sin pipeline de recuperación |
| Iteraciones repetidas sobre la misma base de código | Together AI (cualquier tarifa) | La repetición bajó de ~$0.66 a ~$0.03; el TTFT, de 54 a 8 s |
| Trazas de razonamiento con mucha salida | La tarifa de salida verificada más baja; desactiva el razonamiento cuando la calidad lo permita | El razonamiento se factura como salida a $3.15-$4.50 |
| Cargas sensibles a la región | Consulta la documentación regional de QwenCloud antes de enrutar | Together AI no ofrece endpoint dedicado ni fine-tuning |
| Pruebas de failover y playground | OpenRouter / Vercel AI Gateway | Enrutamiento, reintentos y crédito de $5 de Vercel |
En la prueba citada con Tornado, el prompt en frío de 650k tardó 54 segundos en entregar el primer token. Eso encaja mejor con tareas por lotes o de ejecución nocturna que con ciclos interactivos dentro del IDE. La caché ayudó en la repetición, no en la primera pasada, así que hay que presupuestar ese arranque en frío.
Preguntas frecuentes
¿Cuál es el ID exacto del modelo en Together AI?
Qwen/Qwen4-Max en https://api.together.ai/v1/chat/completions.
¿Puedo hacer fine-tuning de Qwen4 Max en Together AI?
No. En el momento de la publicación solo estaba disponible mediante serverless, sin fine-tuning ni endpoint dedicado (artículo de lanzamiento).
¿Cuándo termina la promoción de Together AI?
Está vigente hasta el 22 de noviembre de 2026 y no se ha publicado una hora concreta para el cambio; consulta la página del modelo antes de lanzar una ejecución grande.
¿Together AI es más barato que QwenCloud Singapur?
Durante la promoción, sí ($1.05/$3.15 frente a $1.50/$4.50). Después, las tarifas coinciden y la decisión depende de la caché, la latencia y el enrutamiento.