 AIREITER
OpenRouter anunció al lanzar su dashboard una tasa de aciertos de caché del 82,8% en toda la plataforma (@OpenRouter). Sin embargo, los hilos de la comunidad describen otra realidad: tasas inferiores al 1% (@miolini) y facturas entre 10 y 32 veces por encima de lo esperado (r/openrouter). El prompt caching de OpenRouter puede rebajar el coste de entrada, pero primero hay que corregir cuatro fallos concretos. El factor más decisivo es mantener las peticiones consecutivas en un mismo proveedor que ya tenga la caché caliente. Antes de nada, un límite innegociable: si el prompt no alcanza el mínimo de tokens del proveedor, no se almacenará en caché por mucho que ajustes la configuración.
Qué considera OpenRouter un acierto de caché
El prompt caching reutiliza un prefijo estable que el proveedor ya procesó. Así, los tokens de entrada repetidos se cobran con descuento en lugar de a precio completo. La caché reside en el endpoint concreto del proveedor que atendió la petición original; por eso el enrutamiento importa tanto como la estructura del prompt. No debe confundirse con el response caching, que devuelve gratis una petición completa idéntica antes incluso de que intervenga el routing.
| Prompt caching | Response caching | |
|---|---|---|
| Qué reutiliza | El prefijo estable de cualquier petición | Una petición idéntica byte a byte (SHA-256 del cuerpo normalizado) |
| Cómo activarlo | En gran parte automático; cache_control para Anthropic, Qwen y Gemini | Cabecera X-OpenRouter-Cache: true o preset |
| Coste | Tokens en caché a 0,1–0,5x del precio de entrada | Los aciertos son gratis; los fallos se facturan normalmente |
| Duración | Lo habitual son 3–5 min, hasta 1 h en Anthropic | 300 s por defecto, intervalo de 1–86.400 s |
| Qué lo bloquea | Cambio de prefijo, cambio de proveedor o mínimo de tokens | Cualquier cambio en el JSON, rotación de API key o ZDR de la cuenta |
El response caching resulta especialmente útil para reintentos, pruebas unitarias y llamadas idénticas repetidas dentro de flujos de agentes. El orden de las propiedades JSON forma parte de la clave de caché, por lo que un cambio inocente en la serialización ya cuenta como fallo. La referencia principal sobre el funcionamiento en el lado del proveedor es la guía de prompt caching de OpenRouter:
Cuánto cuesta el prompt caching de OpenRouter según el proveedor
Las lecturas desde caché cuestan una fracción del precio normal de entrada en todos los casos, pero la escritura que crea esa caché puede llevar recargo. En Anthropic es 1,25x la entrada normal con el TTL predeterminado de 5 minutos y 2x con la opción de 1 hora. La caché compensa cuando el mismo prefijo se vuelve a leer suficientes veces como para amortizar esa escritura; en una petición aislada, activar caching puede salir más caro que no usarlo. En Claude Sonnet 4.6, los datos de entrada cacheados cuestan $0.30/M frente a $3.00/M de entrada nueva, según los ejemplos numéricos de OpenRouter.
Estos son los multiplicadores de escritura y lectura por proveedor, de la misma fuente:
| Proveedor | Escritura de caché | Lectura de caché | Notas |
|---|---|---|---|
| Anthropic | 1,25x (5 min) / 2x (1 h) | 0,1x | TTL seleccionable por breakpoint |
| OpenAI, anterior a GPT-5.6 | Gratis | 0,25–0,5x | Automático a partir de 1.024 tokens |
| OpenAI GPT-5.6+ | 1,25x | 0,25–0,5x | Ahora admite breakpoints explícitos |
| Google Gemini | Gratis | 0,25x | Implícito en 2.5+, TTL de ~3–5 min |
| Grok | Gratis | 0,25x | Automático |
| Moonshot | Gratis | 0,25x | Automático |
| Groq | Gratis | 0,5x | Solo modelos Kimi K2 |
| DeepSeek | 1,0x | 0,1x | Las escrituras se cobran como entrada normal |
| Alibaba Qwen | 1,25x | 0,1x | Requiere cache_control explícito |
| Z.AI | Gratis | ~0,2x | El almacenamiento en caché figura como gratuito por tiempo limitado |
El tutorial de OpenRouter calcula 10.000 tokens repetidos durante seis turnos: 6,0x el coste de un único turno sin caché, 1,75x con la caché de Anthropic de 5 minutos y sticky routing, y 2,25x con un proveedor de escritura gratuita y lecturas a 0,25x. El cálculo no incluye mensajes que crecen ni tokens de salida.
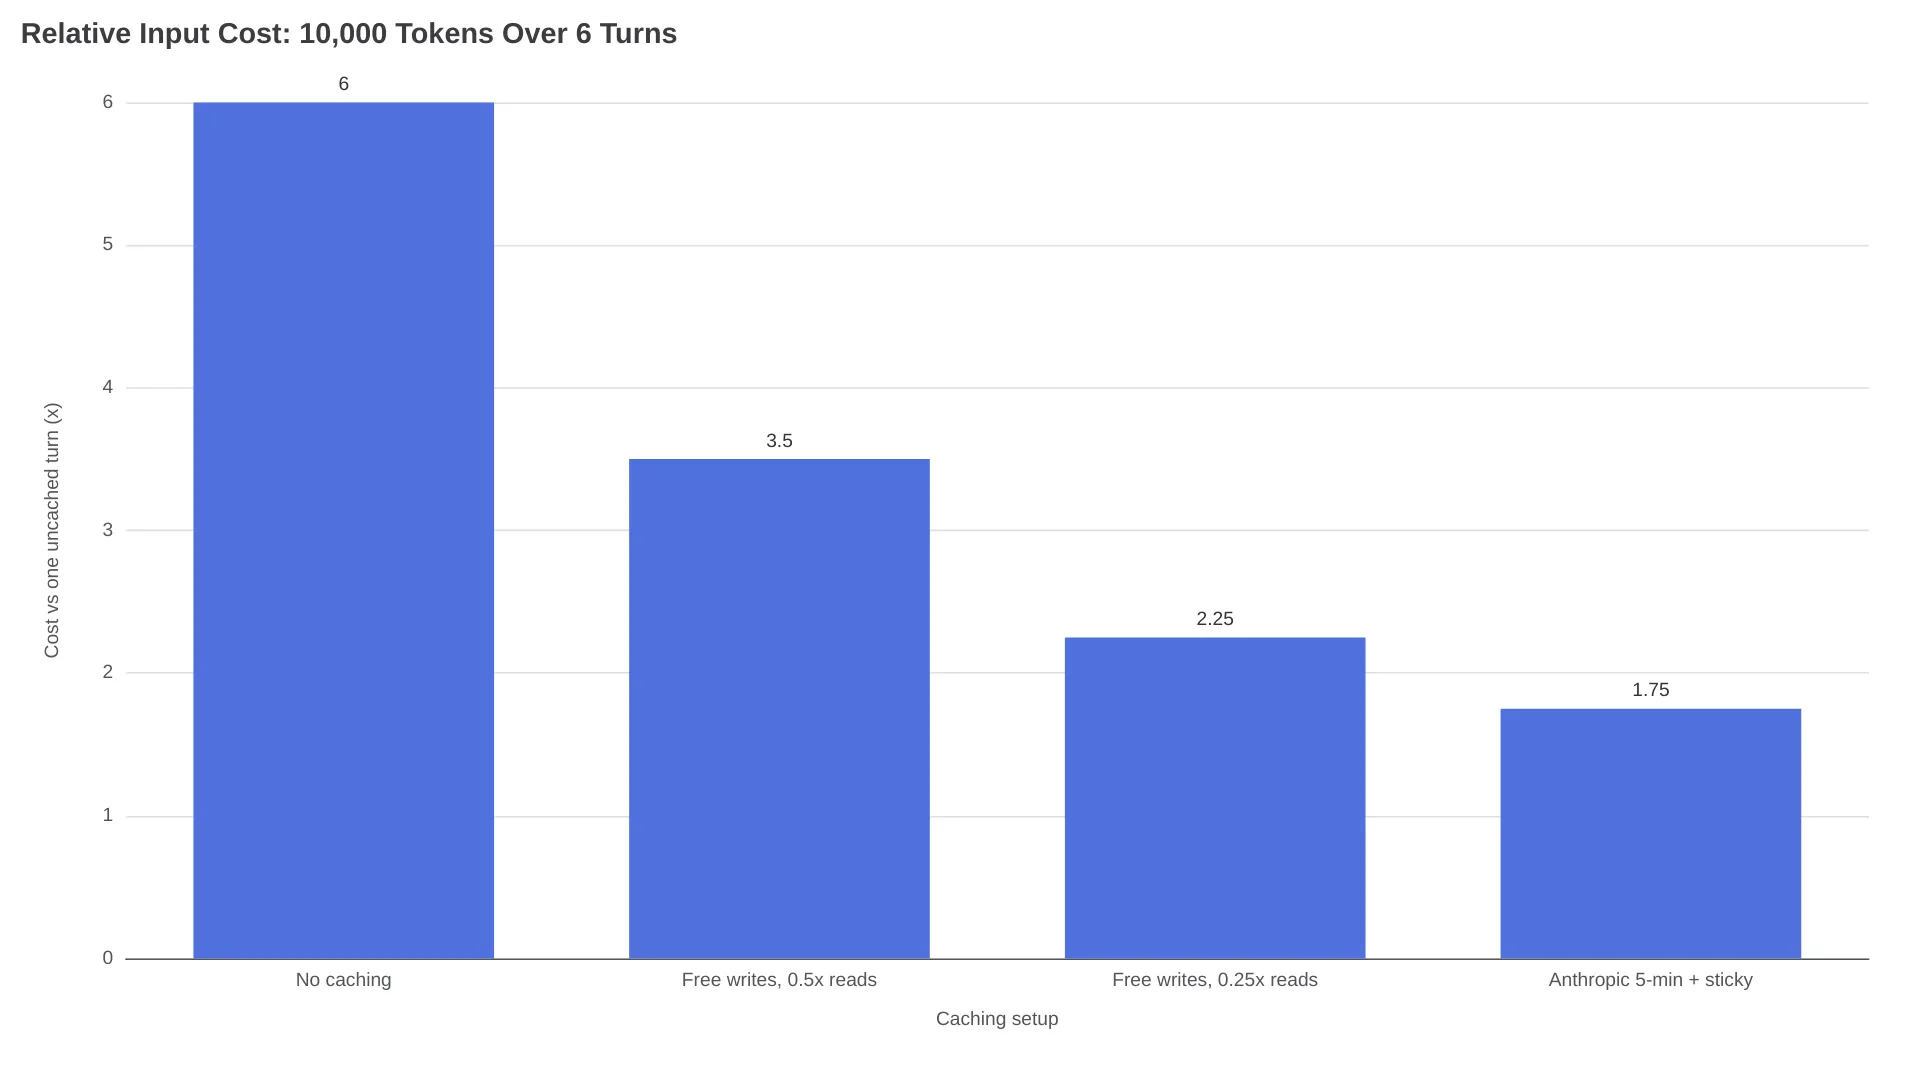
La escritura cara de Anthropic gana en seis turnos porque sus lecturas a 0,1x pesan más desde el segundo turno, y la diferencia aumenta conforme se acumulan turnos. El resultado solo cambia si el TTL de 5 minutos expira entre turnos: vuelves a pagar la escritura de 1,25x en cada petición, hasta 7,5x en seis turnos, peor que no usar caché. En cambio, un proveedor de escritura gratuita a 1,0x de entrada simplemente iguala el 6,0x sin caché.
Antes de depurar, mide: tres datos que confirman un acierto
Cada respuesta de OpenRouter deja el veredicto en su objeto usage: cached_tokens, cache_write_tokens y cache_discount. La semántica de estos campos está documentada en la guía de caching de OpenRouter. Consultarlos antes de tocar nada permite distinguir un fallo de caché real de una sorpresa de precios. Si cached_tokens es mayor que cero, la petición encontró una caché caliente; si es cero, no lo hizo, independientemente de lo que muestre el dashboard de Activity.
"usage": {
  "prompt_tokens": 10339,
  "prompt_tokens_details": {
    "cached_tokens": 10318,
    "cache_write_tokens": 0
  }
}
Esa respuesta tiene un acierto del 99,8%: 10.318 de los 10.339 tokens del prompt procedían de caché. cache_write_tokens aparece en la primera petición que genera caché; cache_discount indica el ahorro y puede ser negativo en las escrituras de Anthropic, ya que el recargo de escritura de 1,25x es un coste real que las lecturas posteriores recuperan. También puedes obtener estos datos en el detalle de generación de Activity —nuestra guía del dashboard de actividad explica dónde encontrarlos— o desde /api/v1/generation.
Los metadatos en bruto son la fuente de verdad, no la interfaz. Un usuario de SillyTavern persiguió un problema de caché inexistente hasta revisar directamente los logs:
"Los metadatos raw de OpenRouter dicen sin rodeos
native_tokens_cached: 0[y]usage_cache: null." — u/HauntingWeakness
Si esos tres valores permanecen en cero día tras día, una de las cuatro causas siguientes está acabando con tu caché.
Las cuatro razones por las que una caché caliente se enfría
La documentación de OpenRouter y los informes de la comunidad apuntan a cuatro motivos habituales detrás de las tasas de acierto desplomadas: prompts por debajo del mínimo, expiración del TTL entre turnos, cambios en el prefijo y deriva entre proveedores. Cada uno deja una señal distinta en los logs y exige una corrección diferente.
1. El prompt no alcanza el mínimo del proveedor
Los proveedores compatibles con prompt caching aplican un mínimo de tokens específico por modelo. Un system prompt de 900 tokens nunca entrará en caché en ningún modelo Claude, y añadir relleno para forzarlo está expresamente desaconsejado: «No rellenes la petición con texto de relleno solo para conseguirlo», advierte el tutorial de OpenRouter. Los mínimos varían hasta por un factor de cuatro dentro del catálogo:
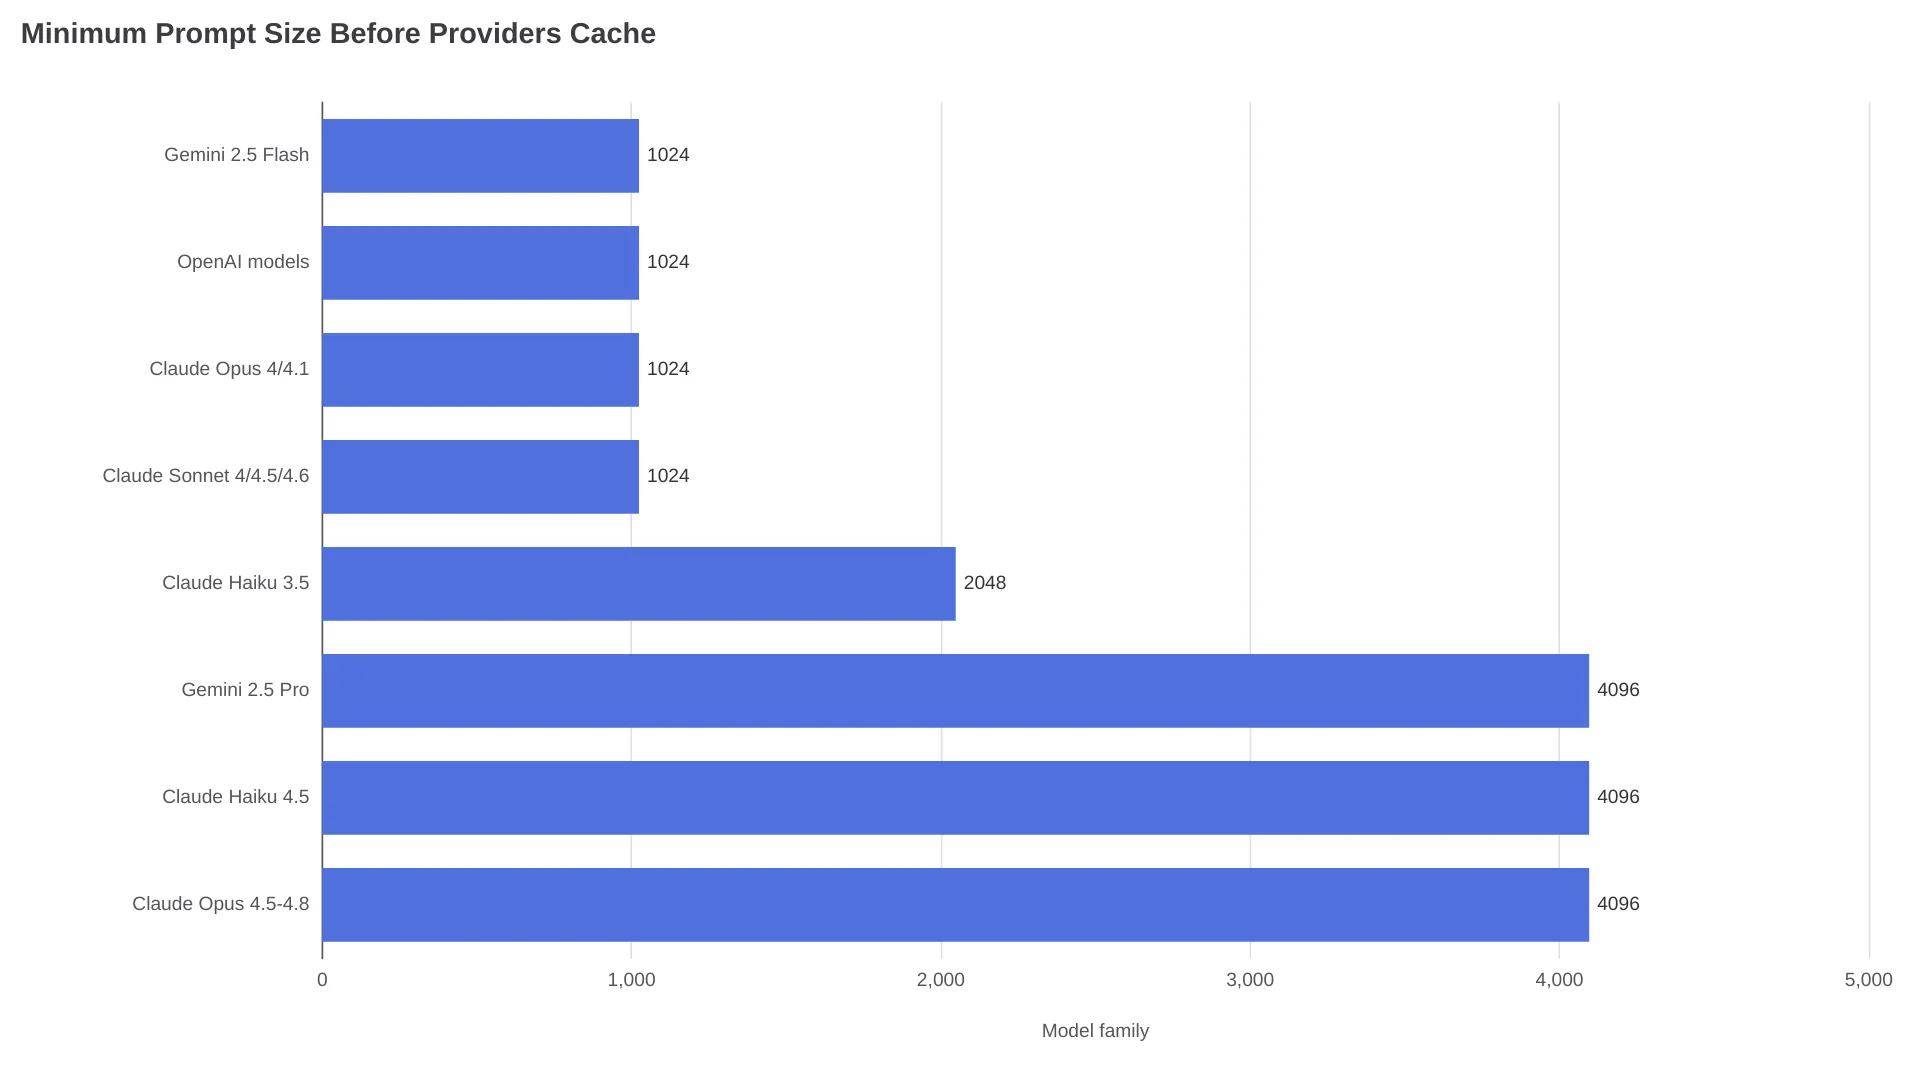
Según las notas de proveedores de OpenRouter, Claude Opus 4.5–4.8 y Haiku 4.5 necesitan 4.096 tokens antes de cachear nada; Sonnet 4/4.5/4.6 y Opus 4/4.1 requieren 1.024; Gemini 2.5 Pro se sitúa en 4.096, mientras que Gemini 2.5 Flash necesita 1.024; los modelos de OpenAI empiezan a cachear desde 1.024. Una carga de trabajo con prompts cortos en Opus 4.8 no es cacheable por su propia estructura. La solución pasa por reunir el material estático —esquemas de herramientas, documentos de referencia y few-shots— en un único prefijo, o cambiar a un modelo con un mínimo inferior.
2. La caché caducó entre turnos
La caché predeterminada de Anthropic dura 5 minutos; el TTL de 1 hora eleva la escritura a 2x. La caché implícita de Gemini permanece aproximadamente 3–5 minutos y, un detalle importante, las lecturas no reinician el temporizador, según el tutorial de OpenRouter. La sesión sticky que te mantiene en el mismo proveedor desaparece tras 10 minutos de inactividad. Los bucles de agentes que pasan 5–6 minutos razonando entre llamadas agotan todas esas ventanas:
"OpenRouter [es] genial para probar modelos. Para agentes en producción es discretamente terrible. ¿El secreto incómodo? El caching es prácticamente cero en cargas de trabajo reales." — @ran_cohenn, al describir intervalos de 5–6 minutos en agentes que hacen expirar la afinidad sticky y provocan fallos completos de caché más costosas escrituras de caché
El TTL de 1 hora de Anthropic, con escritura a 2x, es preferible a volver a pagar 1,25x cada cinco minutos siempre que la sesión continúe dentro de esa hora. Con pausas de veinte minutos entre usuarios, ningún TTL disponible aguanta, y la caché solo ayuda dentro de ráfagas de turnos.
3. El prefijo cambió sin que te dieras cuenta
OpenRouter calcula su clave de conversación predeterminada haciendo hash del primer mensaje de sistema y del primer mensaje que no sea de sistema. Todo lo que altere el inicio del prompt invalida la caché a partir de ahí. Los culpables recurrentes son contexto RAG inyectado antes del system prompt, timestamps o IDs de petición dentro del primer mensaje, definiciones de herramientas reescritas en cada llamada y aplicaciones de chat frontend que insertan mensajes a mitad del historial.
"La tasa de fallos de caché aumentará si algo al principio del prompt cambia constantemente." — u/Exact_Law_6489
A veces el cambio viene de herramientas que ni siquiera escribiste tú. «Descubrí que Claude Code me estaba causando problemas de aciertos de caché; creo que se debe a cómo inyectan las herramientas», comenta u/askchris. Gemini añade dos trampas propias: OpenRouter utiliza solo el último breakpoint cache_control que envíes, y trata la instrucción de sistema como contenido cacheado inmutable. El material dinámico debe ir en un mensaje de usuario posterior, no después del system prompt. En todos los casos, la disciplina es la misma: primero system prompt estático, esquemas de herramientas y documentos de referencia; al final, las variaciones de cada petición.
4. La petición llegó a un proveedor frío
OpenRouter enruta entre más de 70 proveedores (según su propio tutorial), y la caché de un prompt es local al endpoint que la escribió. El sticky routing devuelve los seguimientos al proveedor caliente, pero solo cuando las lecturas de caché de ese proveedor son más baratas que su entrada normal. Además, un provider.order manual anula por completo esa persistencia. Un error del proveedor también libera el pin.
Los datos de la comunidad sobre este fallo son contundentes:
- @bruceforai midió el mismo nombre de modelo en distintos proveedores y encontró tasas de acierto desde el 95,3% hasta el 0%, con precios de caché de algunos terceros 10 veces superiores a la tarifa oficial.
- @Bryan_1269 obtuvo una tasa de acierto muy baja con GLM 5.2 a través de OpenRouter y más del 85% con el mismo prompt directamente mediante Fireworks.
- @miolini, sobre el routing en OpenRouter: "la tasa de acierto de caché es realmente mala, inferior al 1%."
La postura oficial de OpenRouter es que el pin sí se mantiene: «cuando un modelo o proveedor te cachea, quedas fijado a él hasta que la caché expire» (@OpenRouter). Es coherente con la documentación y apunta a que la variabilidad entre proveedores, no el pinning, es lo que hay que gestionar.
Dónde colocar cache_control y qué puede eliminarlo
Los modelos de Anthropic en OpenRouter cachean en dos modalidades: un objeto cache_control único en el nivel superior, que avanza automáticamente a medida que crece la conversación —la recomendación de OpenRouter para chats de varios turnos—, y breakpoints explícitos en bloques de contenido individuales, hasta cuatro, para material fijo voluminoso como esquemas de herramientas, documentos RAG, volcados CSV o fichas de personaje. La forma de nivel superior funciona en Anthropic nativo, Vertex, Azure y Bedrock, donde OpenRouter la traduce a un breakpoint final porque la API de Bedrock no acepta ese campo en el nivel superior. Para configurar un TTL explícito debes usar Chat Completions o la API Anthropic Messages, no Responses.
{
  "role": "system",
  "content": [
    {
      "type": "text",
      "text": "<20k tokens de esquemas de herramientas y documentos de referencia>",
      "cache_control": { "type": "ephemeral", "ttl": "1h" }
    }
  ]
}
OpenAI funciona de otra manera: el caching es automático desde 1.024 tokens, y los marcadores explícitos prompt_cache_breakpoint solo existen en GPT-5.6 y posteriores. Se definen en un bloque input_text o text, con un TTL mínimo de 30 minutos cuando solicitas uno.
OpenRouter traduce entre dialectos, según sus notas de proveedores: un marcador cache_control de Anthropic se convierte en un breakpoint de OpenAI; un breakpoint de OpenAI se convierte en un marcador Anthropic predeterminado de 5 minutos; y los valores TTL nunca se transfieren. Qwen necesita marcadores cache_control explícitos, cachea durante 5 minutos y solo los admite en modelos concretos —qwen3-max, qwen-plus, qwen3-coder-plus y otros; los snapshots como qwen3.5-plus-02-15 quedan excluidos—.
Hay un modo de fallo más discreto: algunos clientes y gateways entre tu aplicación y OpenRouter eliminan campos no estándar antes de reenviarlos:
"que el prompt caching de anthropic caiga a cero detrás de gateways suele ser un bug de marshalling. ... los marcadores cache_control se eliminan silenciosamente antes de reenviarse a openrouter. no puedes abstraer proveedores descartando sus extensiones de esquema." — @SiddharthInk_
Comprueba que el marcador llegue: inspecciona los metadatos de la petición en bruto en el detalle de generación de Activity, o envía una petición de prueba con curl sin ningún intermediario que pueda interferir. Una herramienta que aplana los mensajes en un único bloque destruye los breakpoints aunque los hayas colocado correctamente. El repositorio de ejemplos de OpenRouter incluye muestras ejecutables para TypeScript, Vercel AI SDK y Effect que conservan los marcadores intactos.
Fija el proveedor con session_id y provider order
Una identidad de sesión estable es la palanca de routing más potente: session_id fija las peticiones posteriores al proveedor que atendió la primera petición correcta, incluso antes de observar un acierto de caché. Sin ella, la persistencia solo empieza tras el primer acierto detectado, y la identidad predeterminada —un hash del primer mensaje de sistema más el primer mensaje que no es de sistema— cambia silenciosamente con cualquier mutación del prefijo (fallo 3), según la documentación de routing de OpenRouter.
{
  "model": "anthropic/claude-sonnet-4.6",
  "session_id": "user-8801-thread-3",
  "messages": [ ... ]
}
Conviene conocer algunos detalles: session_id va en el cuerpo de la petición o en la cabecera x-session-id. Si estableces ambos, gana el cuerpo; el límite es de 256 caracteres. Si no hay ninguno, OpenRouter recurre a la clave de estilo OpenAI prompt_cache_key.
Dos advertencias de la documentación: los errores del proveedor liberan el pin, y las líneas de Batch API se ejecutan a la vez y sin orden, por lo que una escritura de caché de una línea no es visible para la siguiente. Comparte un prefijo "ttl": "1h" entre lotes o caliéntalo primero con una petición síncrona. (La guía de Auto Router explica la reutilización de mejor esfuerzo del modelo resuelto por Auto Router.)
Si el pinning por sí solo no basta, limita directamente el conjunto de proveedores:
"La solución que he encontrado es configurar una lista preferida de proveedores que se usen por orden de preferencia." — u/nabil9506
Una lista provider.order de dos o tres proveedores con lecturas de caché baratas cambia amplitud de failover por localidad de caché, un intercambio razonable para cargas de trabajo de agentes. u/welcome_to_milliways califica la carga de configuración manual como «un defecto bastante fundamental de OR»; sea justo o no, ese es el contrato actual.
Cuándo no compensa cachear a través de un router
El prompt caching mediante OpenRouter deja de compensar en tres situaciones reconocibles: prompts que nunca alcanzan el mínimo de tokens del modelo, sesiones con pausas superiores a todos los TTL disponibles y peticiones puntuales cuyo recargo de escritura nunca se amortiza con una lectura rebajada. Hay una cuarta: herramientas que no puedes modificar y que eliminan cache_control antes de que llegue al router. @grapeot resume bien lo que está en juego: cuando el caching falla en la capa de gateway, la diferencia de coste es de un orden de magnitud, muy por encima de la propia comisión de routing.
Para cargas de trabajo donde la caché es crítica y ninguna de las correcciones anteriores aplica, un único upstream fijo supera a un router: comportamiento de caché determinista y ningún pinning que administrar. Un endpoint directo de Claude API con el caching propio de Anthropic es la vía de escape más directa cuando la deriva de proveedores no tiene solución.
Zero Data Retention a nivel de cuenta desactiva por completo el response caching. Para el prompt caching bajo ZDR, la referencia que conviene revisar es el análisis de OpenRouter sobre si el caching implícito cuenta como retención de datos.
El orden de corrección
Depurar siguiendo el orden de medición recupera la mayor parte del ahorro con el menor cambio posible: primero verifica y luego baja por la pila, desde el prompt hasta el routing y el TTL:
| # | Acción | Qué resuelve |
|---|---|---|
| 1 | Consulta cached_tokens y cache_discount en varias peticiones reales | Problema de tasa de acierto frente a problema de expectativas de precio |
| 2 | Compara el tamaño del prompt con el mínimo de tokens del modelo | Descarta que nunca pueda cachearse antes de nada |
| 3 | Congela el prefijo: system prompt, esquemas y documentos estáticos primero; timestamps y RAG al final | Elimina la clase de invalidaciones silenciosas |
| 4 | Envía session_id en cada petición de una conversación | Pinning al proveedor desde el primer turno, no tras el primer acierto |
| 5 | Configura provider.order con dos o tres proveedores de lectura de caché barata | Elimina la deriva entre proveedores |
| 6 | Añade "ttl": "1h" (Anthropic) o cambia a un proveedor de escritura gratuita para sesiones largas | Gestiona la expiración entre turnos |
Los pasos 1–3 eliminan las clases de fallos que puedes controlar en el código; los pasos 4–6 explican la distancia entre los informes de menos del 1% y el titular del 82,8%. Para ampliar: la guía de precios de OpenRouter, sobre cómo se reflejan los tokens cacheados en tu factura; la guía de Auto Router, sobre el comportamiento de fijación de modelos; y la guía del dashboard de Activity, para monitorizar las tasas de acierto con el tiempo.