 AIREITER
Elegir manualmente un modelo para cada petición puede convertirse en un cuello de botella, sobre todo cuando una aplicación mezcla código, soporte, búsquedas y tareas de análisis. Auto Router de OpenRouter (openrouter/auto) intenta resolverlo: clasifica cada prompt en alrededor de 30 tipos de tarea y deriva la petición según el destino del gasto semanal de más de 55T tokens en la plataforma, no a partir de una clasificación estática. Desde el 10 de agosto de 2026, OpenRouter sustituyó el enrutamiento basado en NotDiamond por un sistema alimentado por una señal comunitaria móvil de 7 días. Promete menor coste en el nivel predeterminado y calidad de frontera en el nivel máximo. No cobra un recargo por petición, pero el modelo elegido determina la factura: sin configurar límites, incluso un prompt sencillo puede acabar en un modelo caro.
Qué hace el nuevo OpenRouter Auto Router
Auto Router funciona como un metaenrutador. Envíes la petición a openrouter/auto como nombre de modelo, y el servicio la redirige a un modelo subyacente concreto. Pagas la tarifa habitual de ese modelo, sin una comisión adicional por el enrutamiento. La respuesta incluye el campo model, que permite comprobar qué modelo se seleccionó en cada petición.
La actualización de agosto de 2026 reemplazó el motor de enrutamiento anterior, que antes utilizaba NotDiamond, por lo que OpenRouter denomina la «sabiduría del mercado». En lugar de depender de un modelo de clasificación fijo para decidir cuál es el mejor modelo, el router analiza datos anonimizados de gasto de los 7 días previos. Si miles de desarrolladores trasladaron su carga de trabajo de programación de un modelo a otro la semana anterior, el router sigue ese cambio en cuestión de días.
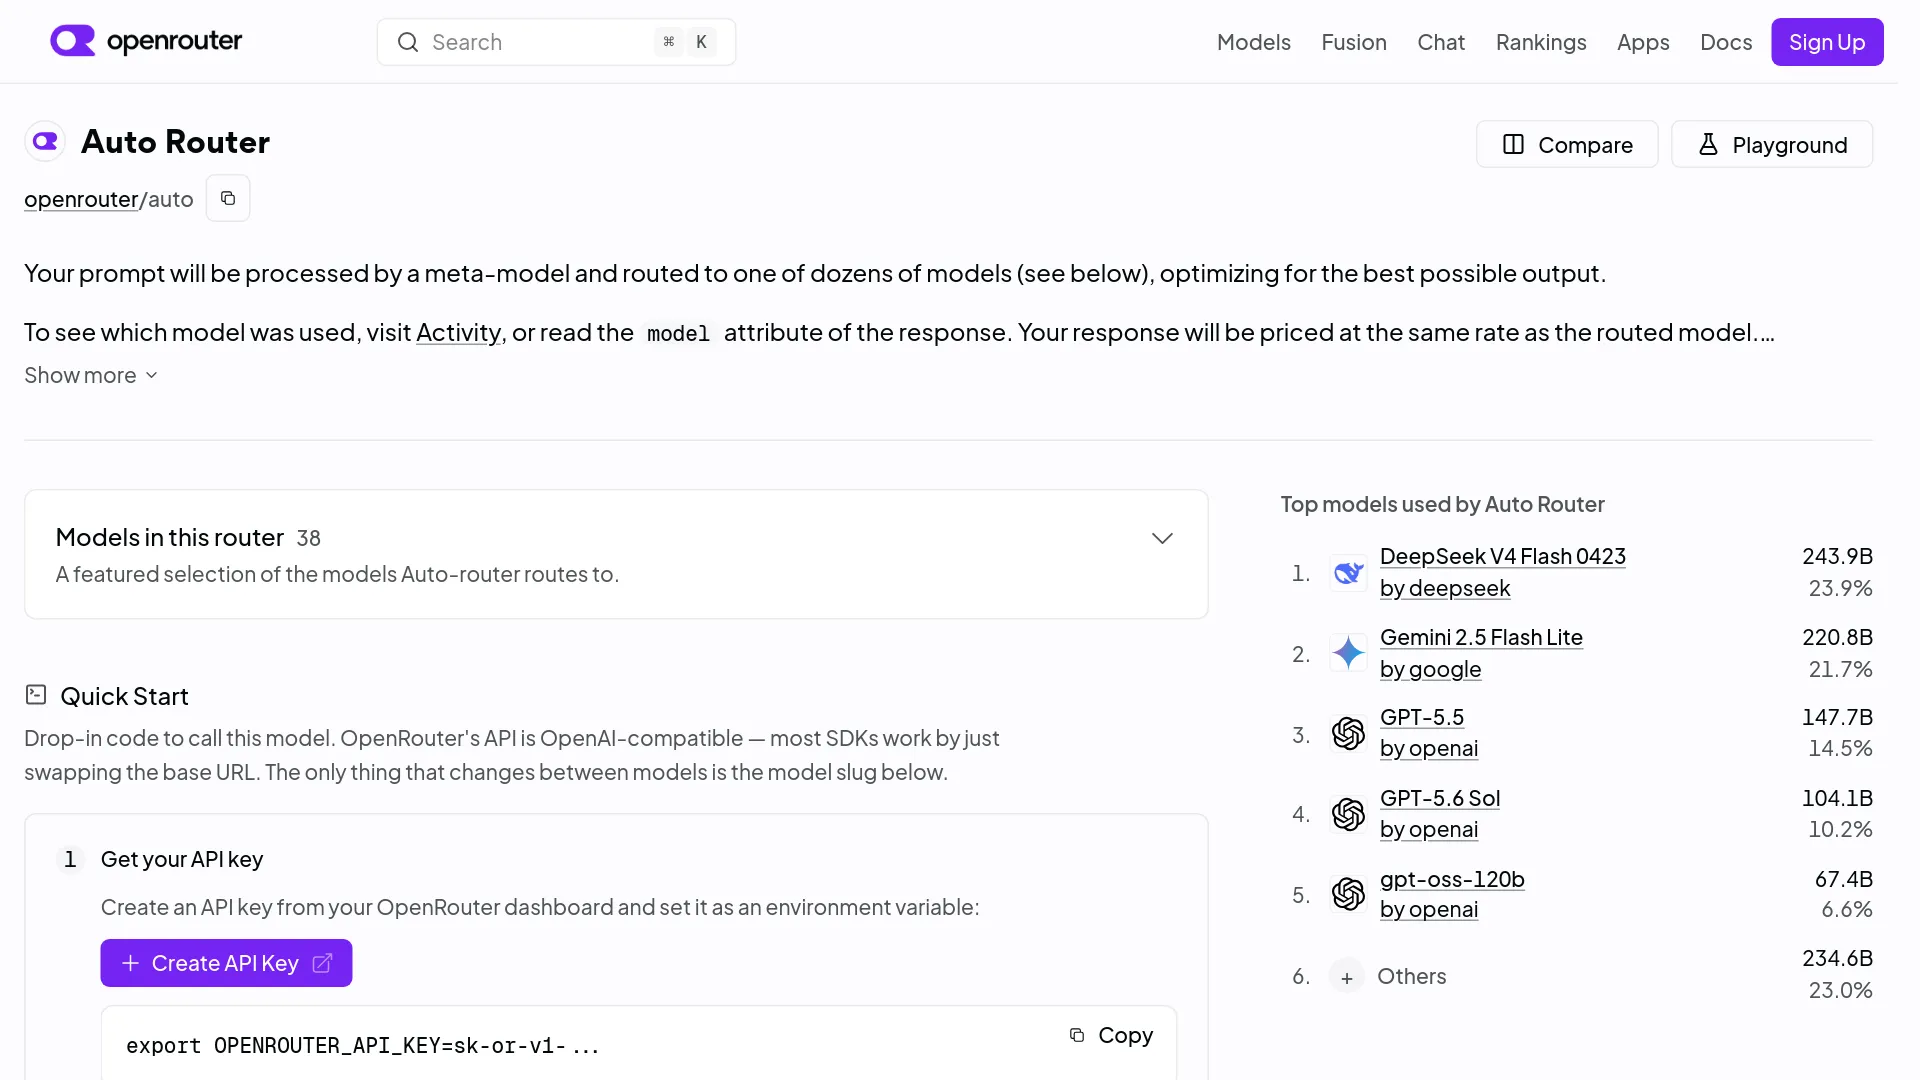
El router clasifica los prompts en tiempo real, sin necesidad de retenerlos, en aproximadamente 30 categorías. Entre ellas están la generación de código, depuración, planificación de agentes de varios pasos, preguntas y respuestas de conocimiento, matemáticas, atención al cliente e informes de investigación. Si no hay datos disponibles para clasificar o clasificar los candidatos, recurre a un conjunto de modelos predeterminado, de modo que un fallo de enrutamiento no haga fallar la petición.
Hay dos slugs disponibles:
| Slug | Uso | ID del plugin |
|---|---|---|
openrouter/auto | Router estable, disponible de forma general | auto-router |
openrouter/auto-beta | Canal de acceso anticipado para cambios en el enrutamiento | auto-beta-router |
El nuevo router estuvo un par de semanas en auto-beta antes de pasar al slug estable el 10 de agosto de 2026. Si envías la configuración con un ID de plugin equivocado, se ignora sin aviso; es un error de configuración habitual.
Cómo elige modelos: 30 tipos de tarea y 5 niveles de coste
La selección del router se basa en dos elementos: la clasificación de la tarea y el nivel de coste. Primero identifica el tipo de tarea a partir del prompt. Después, dentro de esa categoría, ordena los modelos candidatos según su cuota de uso comunitario durante los 7 días anteriores, aplicando además las restricciones de tu cuenta: modelos permitidos, guardrails, ajustes de privacidad y políticas ZDR.
Los niveles de coste determinan hasta qué tramo de precio está dispuesto a llegar el router. Hay cinco bandas, de menor precio a mayor capacidad: low, medium, high, xhigh y max. El valor predeterminado es low. Un nivel es una banda, no un límite máximo: se excluyen tanto los modelos más baratos como los más caros que queden fuera de ella.
La matriz de enrutamiento que OpenRouter publicó el 10 de agosto de 2026 cubre los cerca de 30 tipos de tarea. Estos 15 ejemplos representativos muestran cómo la tarea y el nivel de coste determinan el modelo seleccionado:
| Tipo de tarea | Low | Medium | High | Xhigh | Max |
|---|---|---|---|---|---|
| Generación de código | glm-5.2 | claude-4.6-sonnet | kimi-k3 | claude-opus-5 | claude-5-fable |
| Depuración | deepseek-v4-pro | glm-5.2 | gemini-3.6-flash | claude-4.8-opus | claude-opus-5 |
| Revisión de código | glm-5.2 | claude-sonnet-5 | kimi-k3 | gpt-5.6-sol | claude-opus-5 |
| SQL y bases de datos | deepseek-v4-flash | glm-5.2 | claude-sonnet-5 | kimi-k3 | claude-opus-5 |
| Frontend e interfaz | glm-5.2 | claude-sonnet-5 | gpt-5.6-sol | kimi-k3 | claude-5-fable |
| DevOps y configuración | deepseek-v4-flash | glm-5.2 | gpt-5.6-sol | kimi-k3 | claude-opus-5 |
| Planificación de varios pasos | deepseek-v4-pro | glm-5.2 | claude-4.8-opus | kimi-k3 | claude-5-fable |
| Búsqueda web | deepseek-v4-flash | glm-5.2 | gpt-5.6-sol | kimi-k3 | claude-4.6-opus |
| Matemáticas | deepseek-v4-pro | glm-5.2 | gemini-3.1-pro | kimi-k3 | claude-4.6-opus |
| Redacción de contenido | glm-5.2 | gemini-3.6-flash | claude-4.8-opus | claude-4.6-opus | gpt-5.6-sol |
| Informes de investigación | deepseek-v4-pro | glm-5.2 | claude-sonnet-5 | gpt-5.6-sol | claude-opus-5 |
| Preguntas, respuestas y conocimiento | glm-5.2 | gemini-3.6-flash | claude-sonnet-5 | kimi-k3 | gpt-5.6-sol |
| Traducción | deepseek-v4-flash | gemini-3-flash | gemini-3.5-flash | claude-sonnet-5 | gpt-5.6-sol |
| Clasificación | gemini-3-flash | gemini-3.5-flash | gemini-3.6-flash | gemini-3.1-pro | gpt-5.6-sol |
| Atención al cliente | gemini-3-flash | gpt-4.1 | gemini-3.6-flash | claude-4.6-sonnet | claude-opus-5 |
El nivel low prioriza modelos económicos como GLM-5.2 y DeepSeek V4 Flash para tareas de programación, además de variantes de Gemini Flash para clasificación y soporte. En max, el router dirige las peticiones a Claude Opus 5, Claude 5 Fable o GPT-5.6 Sol según la tarea.
cost_tier frente al parámetro obsoleto cost_quality_tradeoff
El antiguo parámetro numérico cost_quality_tradeoff, de 0 a 10, donde 0 priorizaba calidad y 10 coste, con 7 como valor predeterminado, está obsoleto pero sigue siendo válido. El nuevo parámetro cost_tier usa bandas con nombre. Si envías ambos, cost_quality_tradeoff tiene prioridad. Es una decisión de compatibilidad hacia atrás que puede provocar un enrutamiento inesperado al migrar código antiguo. Elimina el parámetro anterior al adoptar cost_tier.
Configuración mediante una petición de API:
{
  "model": "openrouter/auto",
  "messages": [{ "role": "user", "content": "Debug this Python function" }],
  "plugins": [{
    "id": "auto-router",
    "cost_tier": "max",
    "allowed_models": ["anthropic/*", "openai/*"]
  }]
}
allowed_models admite patrones comodín como anthropic/* para limitar la selección a un proveedor. La lista excluded_models se aplica después de allowed_models y permite restringir aún más el conjunto. Si no queda ningún modelo tras filtrar, la API devuelve un 404.
Benchmarks: el nuevo Auto Router frente al anterior
OpenRouter comparó el router nuevo y el antiguo en cinco benchmarks diversos, tanto con la configuración predeterminada como con el nivel máximo. El router anterior usaba por defecto cost_quality_tradeoff=7; el nuevo parte de cost_tier=low.
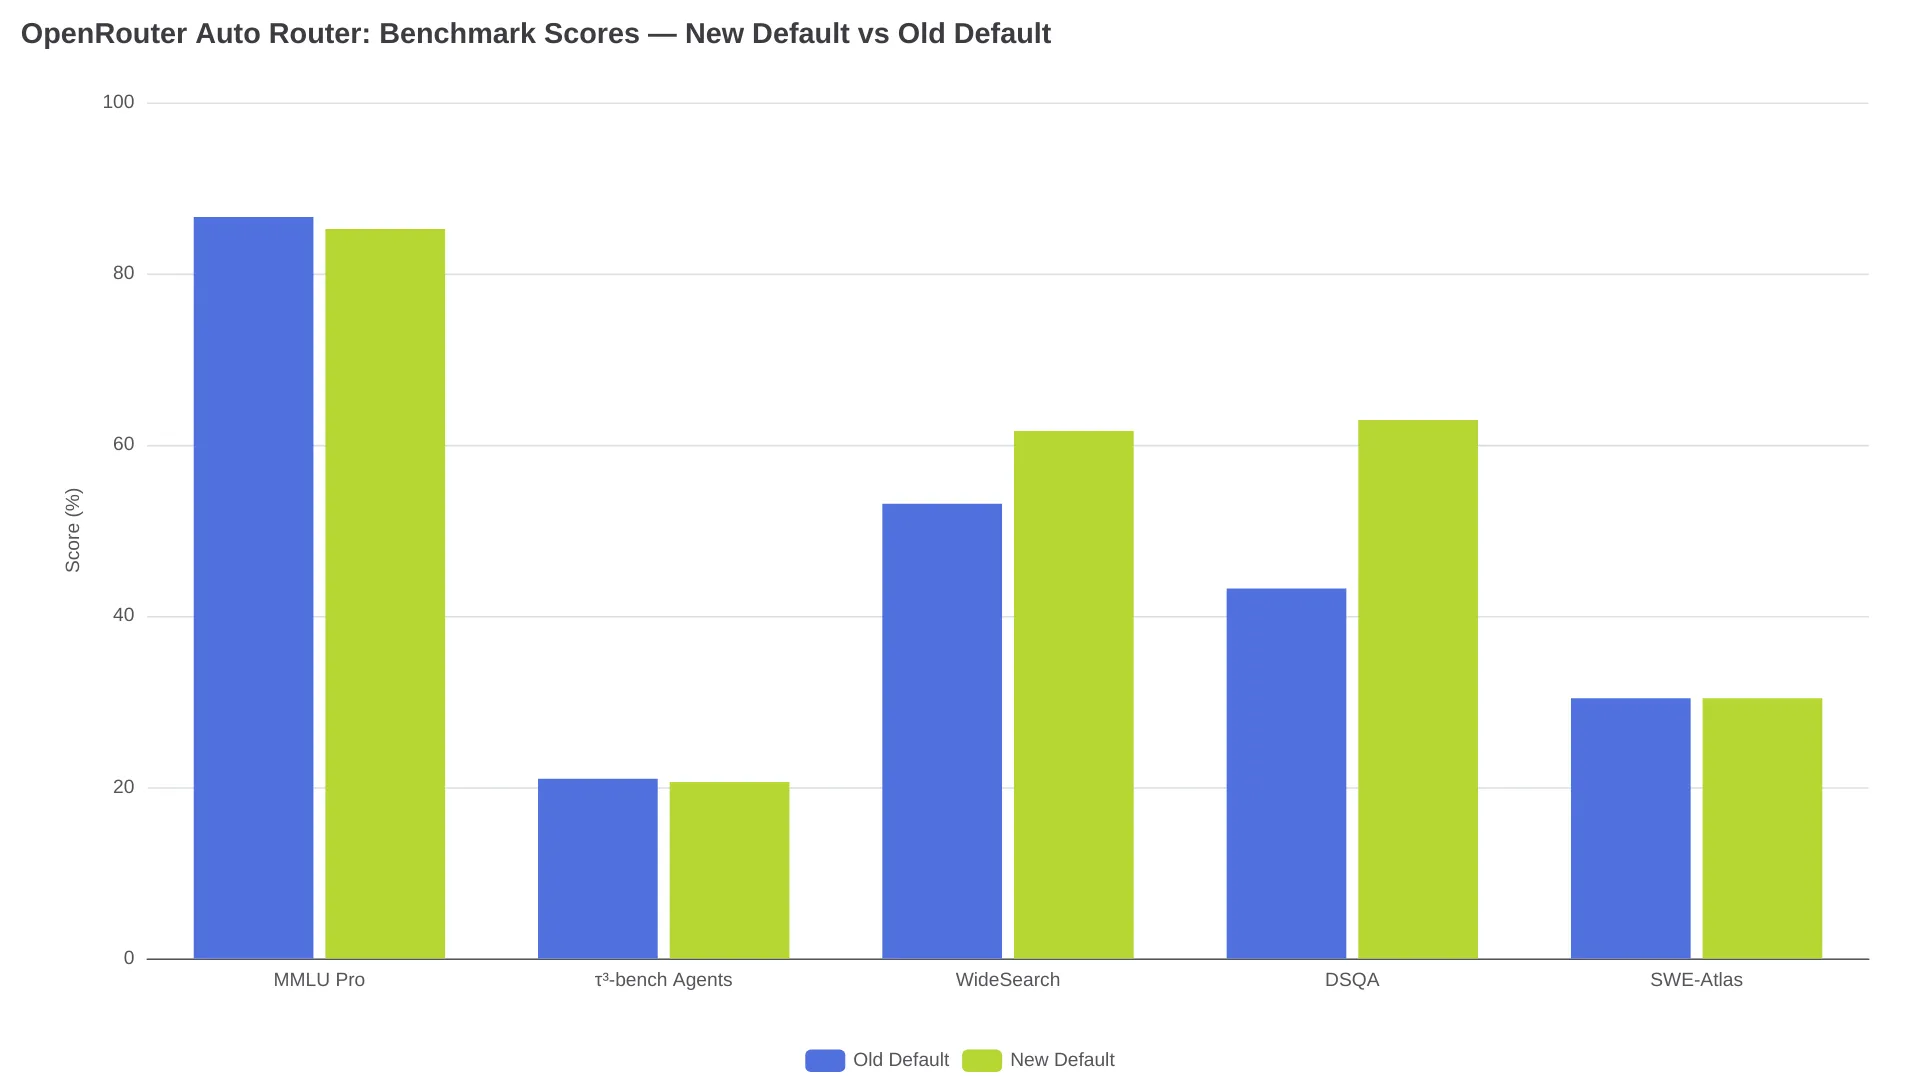
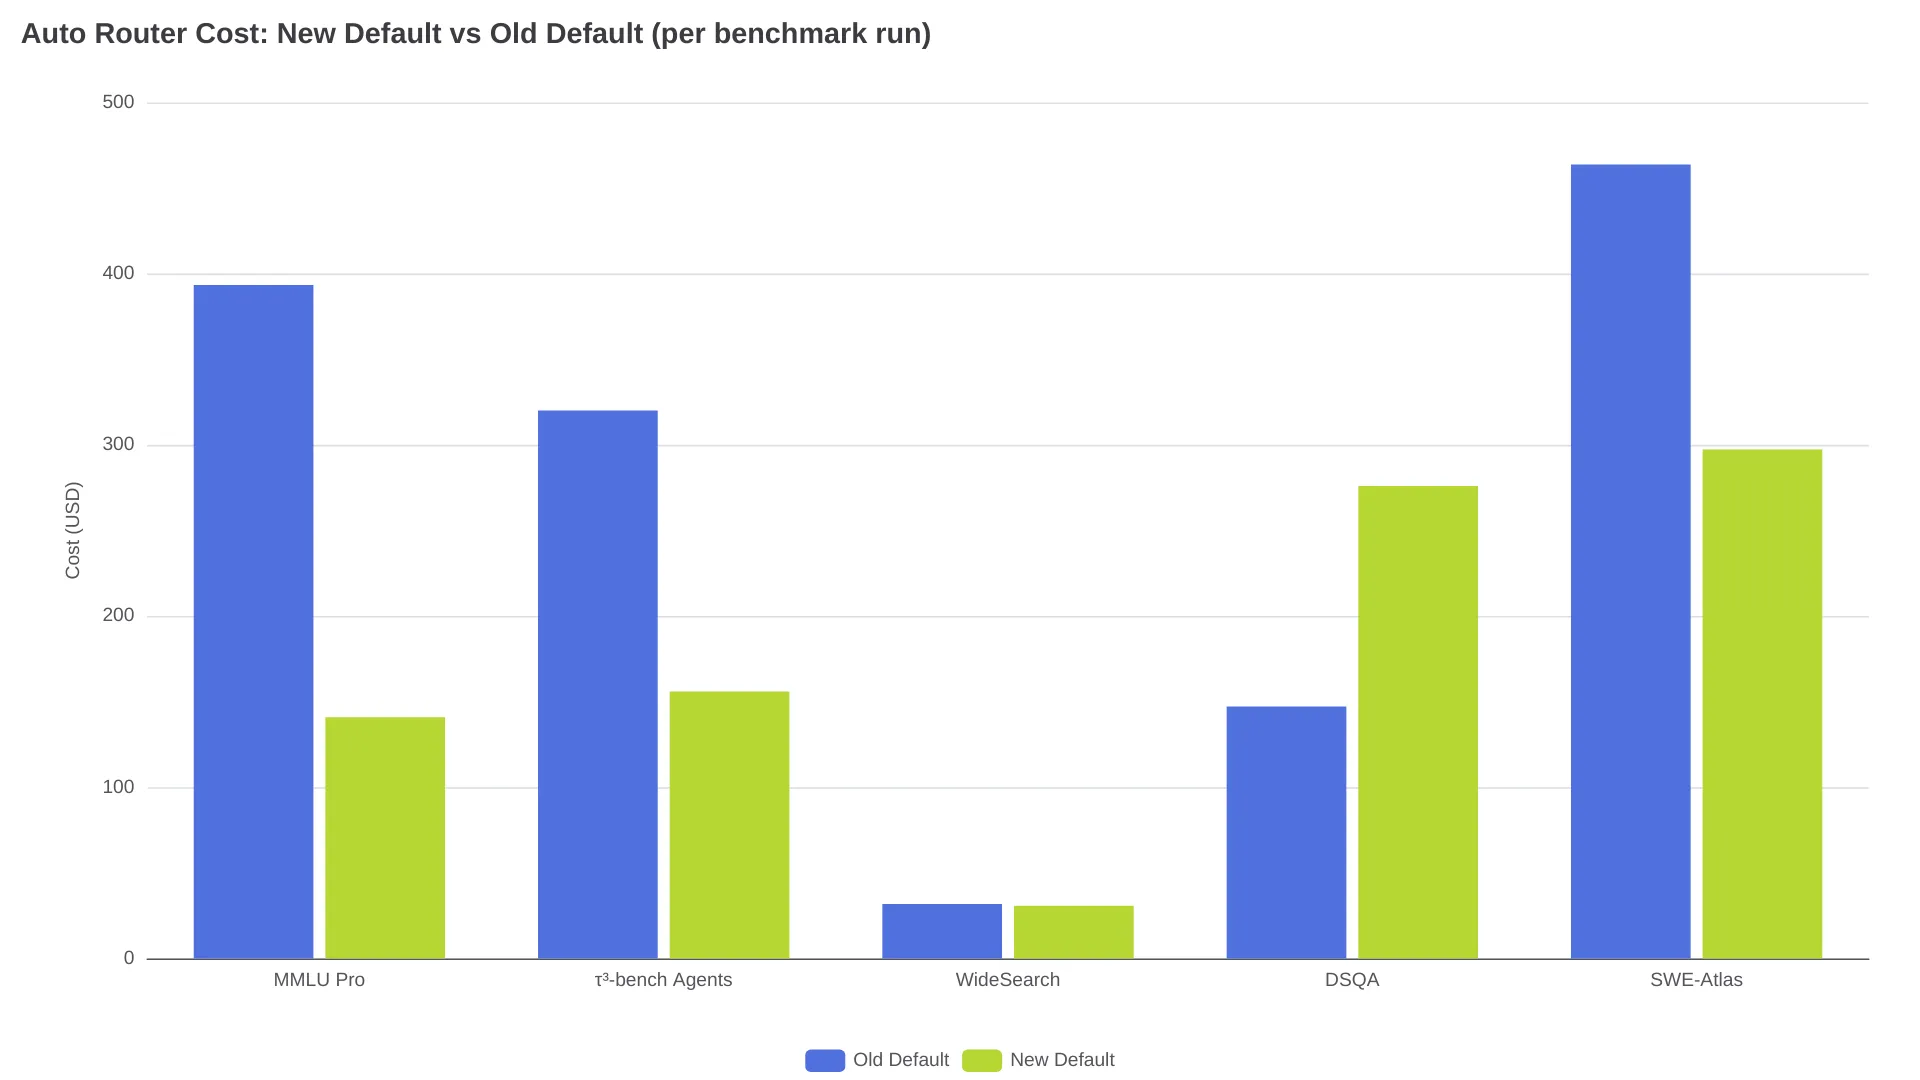
En el nivel predeterminado, el nuevo router iguala o supera al anterior en 3 de 5 benchmarks. Las mejoras más claras aparecen en DSQA, de investigación, con +45.6%, y WideSearch, de búsqueda, con +16.0%; cae ligeramente en MMLU Pro (-1.6%) y tau-bench Banking (-1.9%), y empata en SWE-Atlas QnA. Los costes del nivel predeterminado bajan en MMLU Pro (-64.2%), tau-bench (-51.3%) y SWE-Atlas (-35.9%), pero son un 87.6% más altos en DSQA ($276 frente a $147.11). En el nivel máximo, el nuevo router gana los 5 benchmarks: tau-bench Banking pasa de 7.2% a 31.6% (+338.9%), y SWE-Atlas QnA de 2.4% a 60.7% (+2429.2%). A cambio, los costes en max son mayores en 4 de 5 benchmarks, con SWE-Atlas en $1,325 frente a $205. Son resultados puntuales; OpenRouter advierte de que el comportamiento del router cambia conforme evolucionan las preferencias de la comunidad.
Cómo evitar costes inesperados con Auto Router
La principal inquietud en torno a Auto Router son los cargos imprevistos. Un usuario de r/openrouter lo resumía así:
«Puede que siga usando Opus.» - u/xtekno-id, alertando de una selección sin control de modelos caros en un contexto de equipo de ingeniería.
Estas cinco medidas ayudan a mantener los costes bajo control:
1. El sufijo :free no significa lo que parece. openrouter/auto:free no limita Auto Router a modelos gratuitos: todavía puede dirigir solicitudes a modelos de pago. Si necesitas enrutamiento sin coste, utiliza openrouter/free, que restringe el conjunto únicamente a endpoints del nivel gratuito. Así lo confirma el centro de ayuda de OpenRouter.
2. Combina cost_tier con allowed_models. Establecer únicamente cost_tier=low no impide que el router elija un modelo caro para tu volumen de uso. Añade allowed_models para limitarlo a familias concretas: ["deepseek/*", "google/*"] te mantiene en un rango económico para la mayoría de los tipos de tarea.
3. Usa provider.max_price como límite estricto. Este parámetro filtra los endpoints elegibles por precio y fija un tope de coste por token, independiente de la selección de nivel del router.
4. Ten en cuenta la comisión de plataforma del 5.5%. OpenRouter cobra una comisión del 5.5% al comprar créditos, con un mínimo de $0.80, no por token. Una recarga de $20 en créditos cuesta $21.10. La comisión se aplica uses o no Auto Router: es la vía de monetización de la plataforma, no un recargo de enrutamiento.
5. Vigila la persistencia de sesión y el coste de caché. Si el router cambia de modelo a mitad de una conversación, debe reconstruirse la caché de entrada, lo que añade coste de tokens. Para reducirlo, utiliza persistencia de sesión: identifica las conversaciones mediante un session_id explícito o una huella de los mensajes, vuelve a ordenar los candidatos en cada turno y prefiere el modelo anterior cuando sigue siendo uno de los mejores candidatos. Si la tarea cambia de forma relevante, el router cambiará de modelo y pagarás el coste de reconstruir la caché.
Cuándo usar Auto Router y cuándo fijar un modelo
Auto Router encaja en cargas de trabajo variables, con distintos tipos de tarea en diferentes momentos y donde elegir modelos a mano se vuelve un freno. La matriz de enrutamiento sirve como punto de partida para conocer qué modelos considera la comunidad adecuados para cada tipo de tarea.
| Escenario | Recomendación |
|---|---|
| Cargas variables y uso generalista | openrouter/auto con cost_tier=low |
| Producción a escala sensible al coste | Fijar modelos concretos o usar listas de fallback |
| Programación de varios turnos con contexto | openrouter/auto con session_id para mantener la persistencia |
| Necesitas calidad de frontera sin importar el coste | openrouter/auto con cost_tier=max |
| Requisito de coste cero | openrouter/free (no auto:free) |
| Quieres actualizaciones de enrutamiento antes de su lanzamiento estable | openrouter/auto-beta |
Para equipos de ingeniería, el punto medio práctico es una configuración restringida de Auto Router: cost_tier ajustado a tu banda de presupuesto, allowed_models limitado a proveedores aprobados y provider.max_price como tope estricto.
Preguntas frecuentes
¿OpenRouter Auto Router tiene un coste adicional?
No. No hay recargo por usar Auto Router. Pagas la tarifa estándar del modelo que seleccione. Los ingresos de OpenRouter proceden de la comisión del 5.5% al comprar créditos.
¿openrouter/auto:free es realmente gratis?
No. El sufijo :free no restringe el enrutamiento a modelos gratuitos. Utiliza openrouter/free, el router específico que solo usa modelos gratuitos.
¿Puedo limitar Auto Router a proveedores concretos?
Sí. Usa el parámetro allowed_models con patrones comodín como ["anthropic/*", "openai/*"] en el plugin auto-router.
¿Cómo veo qué modelo se ha seleccionado?
Consulta el campo model en la respuesta de la API. Contiene el identificador del modelo que procesó tu petición, no openrouter/auto.
¿Qué diferencia hay entre auto y auto-beta?
openrouter/auto es el router estable. openrouter/auto-beta recibe mejoras de enrutamiento antes de que lleguen a la versión estable.
¿Auto Router admite streaming y tool calling?
Sí. Está disponible el conjunto completo de capacidades del modelo seleccionado: streaming, tool calling y visión.