 AIREITER
El 17 de agosto de 2026, OpenRouter reveló que uno de sus propios modelos de preview estaba generando en silencio unos 6,2 mil dólares mensuales: aproximadamente 25 veces la tarifa media combinada de la organización. El 98 % del gasto procedía de una sola clave de API asociada a un pipeline por lotes. El panel de actividad, estrenado ese mismo día, nace precisamente para detectar errores de este tipo en minutos, no después de meses. La interfaz cumple bien con lo básico: gasto, tokens, tasa de aciertos de caché y desglose de cada solicitud, todo en un mismo sitio. La API de Analytics que hay debajo todavía está en beta y es bastante más áspera; sus puntos débiles quedan detallados a continuación.
La lección de los 6,2 mil dólares: qué detecta el panel de actividad de OpenRouter
El caso interno del anuncio de lanzamiento retrata exactamente el problema que estas herramientas quieren sacar a la luz. Un modelo de preview consumió 6.185 dólares por 250 millones de tokens en un mes —unos 24,7 dólares por millón de tokens, con una tasa de aciertos de caché del 7,6 %—. Al desglosar el gasto por clave de API, una sola, batch-pipeline, concentraba 6.067 dólares repartidos entre 127 millones de tokens y 37.000 solicitudes: cerca de 48 dólares por millón de tokens para un trabajo por lotes de gran volumen y baja complejidad. La solución fue cambiar el modelo en una sola línea de código (el desglose completo está en el recetario de control de costes).
Junto al panel llegaron varias piezas más: una vista Explorar para crear consultas personalizadas, una vista Tendencias para detectar cambios, Guardrails para eventos de inyección de prompts y datos sensibles, registros a nivel de solicitud, la API de Analytics en beta y una skill de openrouter-analytics en GitHub instalable para agentes de programación.
Qué pregunta responde cada pestaña de Activity
El panel de actividad de OpenRouter está organizado en torno a preguntas, no a menús. Tres pestañas concentran casi todo el trabajo de análisis de costes, y cada una sirve para algo distinto.
Overview: ¿cuánto hemos gastado?
Overview empieza con cinco métricas principales: gasto total, número de solicitudes, volumen de tokens, tasa de aciertos de caché y coste combinado por millón de tokens. Cada una incluye una minigráfica y una comparación con el periodo anterior. Debajo aparecen los usuarios y aplicaciones que más gastan, el gasto por modelo, el reparto entre créditos de OpenRouter y gasto BYOK estimado, además del recuento de tokens de prompt y de finalización. Es la pestaña que conviene dejar abierta cuando la pregunta es simplemente cuánto dinero se está yendo.
Trends: ¿qué ha cambiado desde el periodo anterior?
Trends ordena los cambios, no los tamaños absolutos, entre modelos, usuarios, claves de API y aplicaciones. Está pensada para descubrir un agente desbocado, un modelo que acaba de ganar popularidad o una herramienta interna que ha pasado de experimento a opción predeterminada. Overview te dice qué es caro; Trends, qué acaba de encarecerse.
Explore: ¿cómo quiero segmentar los datos?
Explore es el constructor de consultas. Permite trabajar con gasto, solicitudes, varias categorías de tokens, tasa de aciertos de caché, coste combinado por millón, gasto BYOK frente a créditos, y latencia y rendimiento P50/P90/P99.
Se pueden agrupar los datos por un máximo de dos dimensiones, escogidas entre modelo, proveedor, clave de API, aplicación, usuario, espacio de trabajo, país, región, longitud de contexto, sesión, generación, identificadores personalizados y clasificadores. Las agrupaciones temporales van de minutos a meses, los gráficos pueden ser de barras, líneas o puntos, y cualquier gráfico se puede guardar para uso privado o para toda la organización. Hay dos límites importantes: una tercera dimensión se rechaza directamente y el contenido de prompts y respuestas en los registros solo aparece si el registro privado de entradas y salidas estaba activado antes de ejecutar la solicitud.
Exportar a CSV o PDF sin tocar la API
Para contabilidad y hojas de cálculo no hace falta usar la API. La página Activity exporta las mismas cifras agregadas en informes resumidos o detallados, en dos formatos y sin escribir código. El proceso oficial de exportación consta de cinco pasos:
- Abre la página Activity.
- Elige un periodo y una agrupación (modelo, clave de API o creador).
- Abre el menú de opciones de la esquina superior derecha.
- Selecciona Export to….
- Escoge CSV o PDF.
La exportación predeterminada es un resumen que reúne gasto, tokens y solicitudes. Para obtener un informe detallado, abre primero una tarjeta de métricas concreta y después exporta: esa versión desglosa la métrica según la agrupación elegida. El periodo seleccionado fija automáticamente el intervalo secundario:
| Filtro temporal | Intervalo secundario |
|---|---|
| 1 Hour | por minuto |
| 1 Day | por hora |
| 1 Month | por día |
| 1 Year | por mes |
La letra pequeña de la documentación incluye dos detalles. El gasto BYOK de estos informes es una estimación basada en las tarifas de mercado de los proveedores y puede no coincidir con la factura externa real, ya que no contempla descuentos específicos de cada proveedor. Los tokens de razonamiento se cobran dentro de los tokens de finalización, pero se muestran por separado: así puedes ver cuánto de la factura corresponde al proceso de «pensamiento» sin contabilizarlo dos veces.
Tu primera consulta a la API de Analytics en cinco minutos
La API de Analytics expone los mismos datos que calcula Explore mediante dos endpoints. Como está explícitamente en beta, el proceso debería empezar por descubrir el esquema disponible, no por lanzar consultas a ciegas.
La barrera de la clave de gestión
Los endpoints de Analytics requieren una clave de gestión; una clave normal de inferencia devuelve HTTP 403. También funciona al revés, según el recetario de control de costes: las claves de gestión no pueden realizar solicitudes a modelos. Eso limita el alcance del problema si una se filtra, aunque sigue dejando expuesto el desglose completo del gasto de la organización. El consejo del recetario es directo: trata esta clave como cualquier otra credencial.
Primero meta; después, la consulta
GET /api/v1/analytics/meta devuelve las métricas, dimensiones, operadores de filtro y granularidades compatibles en ese momento. Conviene consultarlo antes de cada ejecución automatizada, porque el soporte puede cambiar durante la beta. El endpoint para las consultas es POST /api/v1/analytics/query. Este es el ejemplo documentado con cURL:
curl -X POST https://openrouter.ai/api/v1/analytics/query \
  -H "Authorization: Bearer <management-key>" \
  -H "Content-Type: application/json" \
  -d '{
    "metrics": ["request_count"],
    "dimensions": ["model"],
    "granularity": "day",
    "limit": 100,
    "time_range": {
      "start": "2026-08-01T00:00:00Z",
      "end": "2026-08-08T00:00:00Z"
    }
  }'
Las respuestas colocan las filas dentro de data.data e incluyen un bloque metadata con query_time_ms, row_count y truncated. El recetario muestra consultas de ejemplo que tardan 17 ms para una sola fila, así que son llamadas baratas. Además, describe el flujo como de solo lectura y gratuito más allá de los costes de uso habituales. Los errores documentados son 400 (consulta incorrecta), 401 (sin autenticación), 403 (tipo de clave equivocado), 408 y 500.
Cuatro consultas para encontrar gasto excesivo
El recetario oficial incluye cinco recetas. Reordenadas como una secuencia de investigación, forman un método repetible para localizar costes innecesarios.
1. ¿Qué modelo se está llevando la mayor parte del presupuesto? La primera consulta del recetario solicita total_usage, request_count, tokens_total y cache_hit_rate, agrupados por model y ordenados por gasto:
{
  "metrics": ["total_usage", "request_count", "tokens_total", "cache_hit_rate"],
  "dimensions": ["model"],
  "order_by": { "metric": "total_usage", "direction": "desc" },
  "limit": 10,
  "time_range": { "start": "2026-07-01T00:00:00Z", "end": "2026-08-01T00:00:00Z" }
}
La cifra derivada clave es el coste efectivo por millón de tokens: total_usage / tokens_total × 1e6. Compárala con tu tarifa combinada —la misma fórmula sin dimensiones— y aplica la regla práctica del recetario: un modelo cuyo precio sea varias veces superior a la tarifa combinada es la señal más clara para empezar a investigar. Así fue como apareció la anomalía del modelo de preview, con un coste 25 veces mayor.
2. ¿Qué clave de API está provocando el problema? Añade un filtro para el slug exacto del modelo y agrupa por api_key_id. Los resultados convierten los nombres en etiquetas legibles, que es como batch-pipeline apareció concentrando 6.067 de los 6.185 dólares del problema. Agrupa por api_key_id en lugar de filtrar por los nombres resueltos de las claves y utiliza el user_email devuelto para contrastar el gasto con tus registros internos.
3. ¿En qué se ha gastado realmente el dinero? Desglosa el gasto diario en sus componentes:
| Métrica | Significado |
|---|---|
usage_upstream | coste bruto de inferencia |
usage_cache | ahorro por caché (o coste de escritura en caché) |
usage_data | descuentos, normalmente negativos |
usage_web | recargo por búsquedas web |
usage_file | recargo por procesamiento de archivos |
Una proporción de prompts frente a finalizaciones cercana a 20:1 apunta a un contexto sobredimensionado. Si la proporción de tokens de razonamiento es alta, quizá estés pagando por una capacidad de «pensamiento» que no necesitas. El mejor candidato para optimizar la caché es el tráfico con muchos tokens de prompt y una tasa de aciertos baja; si la tasa ya es alta, conviene revisar la combinación de modelos. Que predomine el prompt es lo habitual, no una anomalía: un análisis de los datos públicos de OpenRouter sobre programación midió que el 93,4 % de esos tokens eran de entrada.
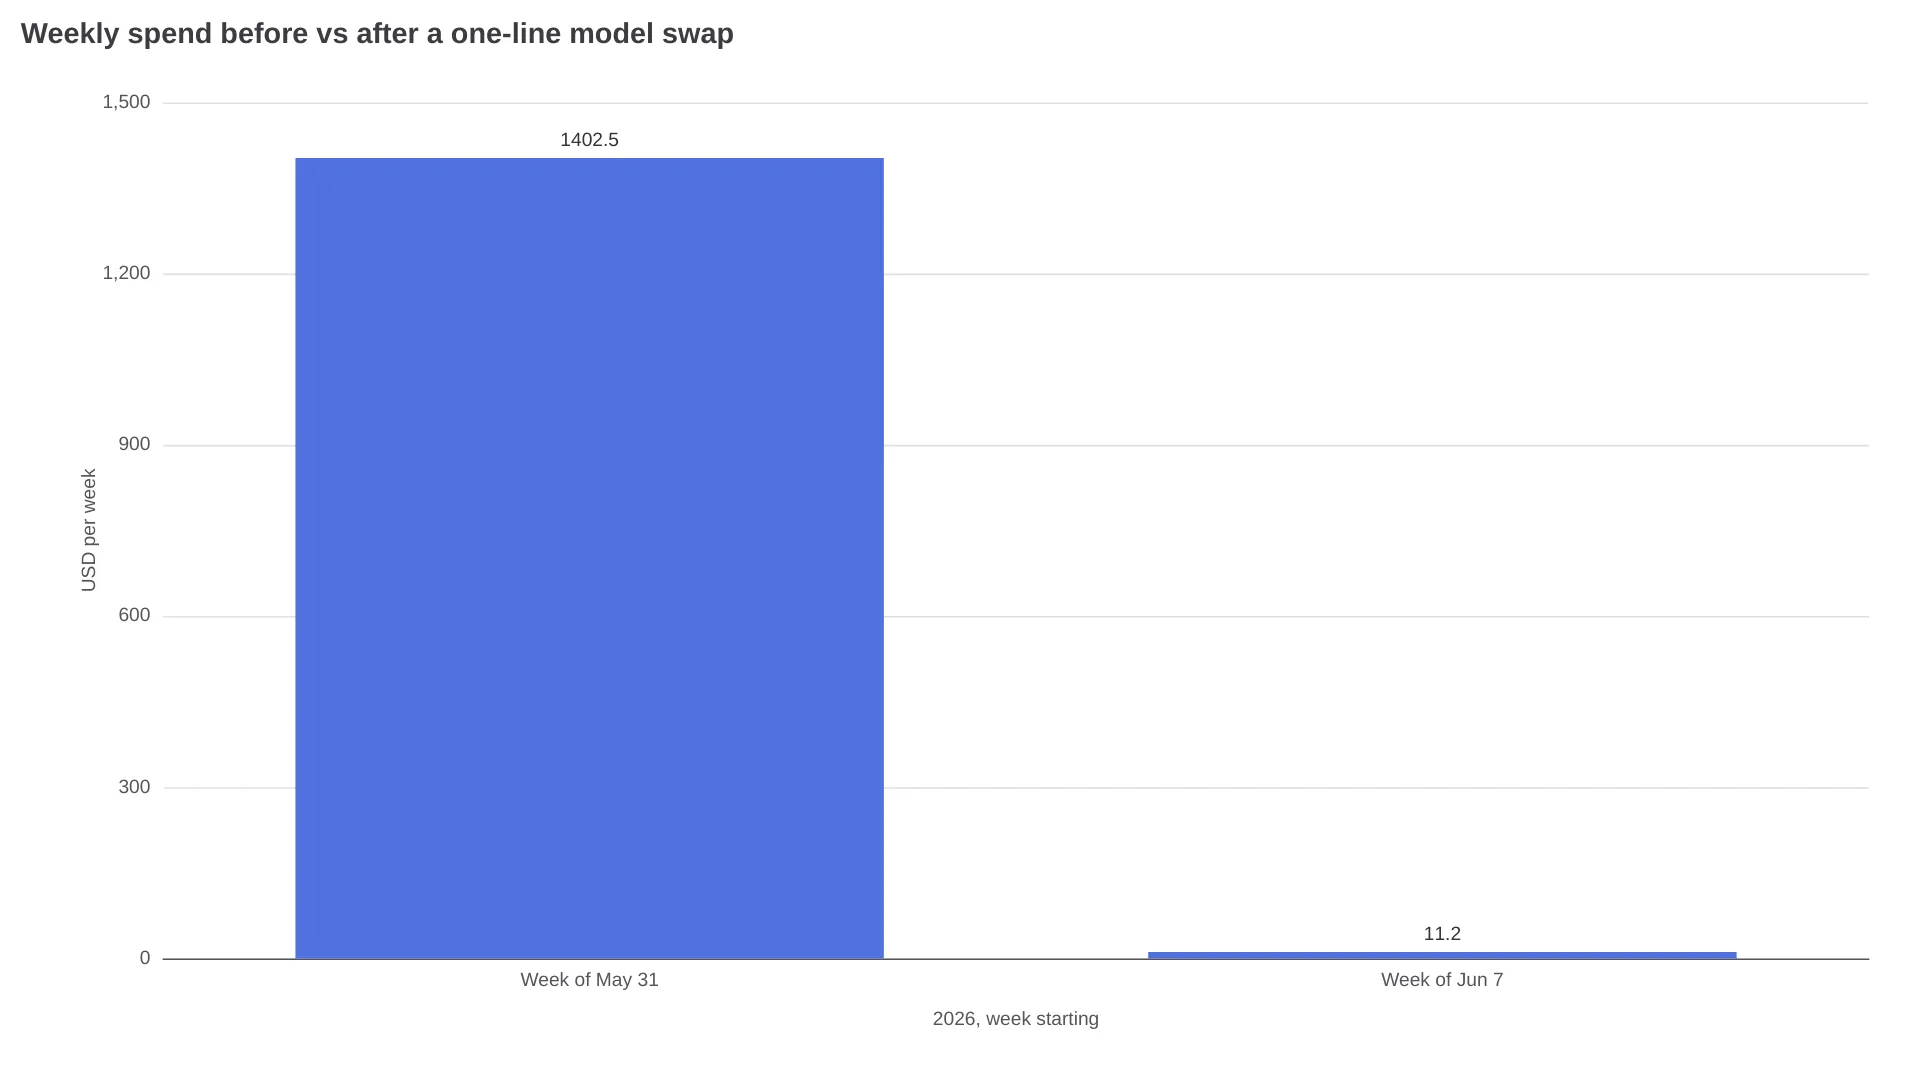
4. ¿La corrección ha funcionado de verdad? Repite la consulta 1 como una serie temporal semanal agrupada por api_key_id. En el ejemplo oficial, la clave batch-pipeline pasó de 1.402,50 dólares en la semana del 31 de mayo a 11,20 dólares en la semana del 7 de junio. Cuando un cambio de modelo funciona, el gráfico cae en picado; no baja poco a poco.
Si después de la consulta 1 la siguiente medida es cambiar a un modelo más barato, la capa de enrutamiento de OpenRouter es donde se toma esa decisión. En nuestra guía del auto router de OpenRouter explicamos las diferencias entre el enrutamiento automático y el fijado manualmente.
Seis bordes de la beta que la referencia no deja claros
La API funciona como está documentada cuando la consulta es correcta. Los problemas siguientes también aparecen en la documentación, pero desperdigados entre notas y pies de página del recetario.
- Tres dimensiones devuelven 400. El límite es dos;
model × key × dayexige varias consultas o una granularidad temporal. group_limitpuede truncar silenciosamente los bloques temporales. Si lo dejas sin definir, OpenRouter calcula automáticamente un valor seguro; si lo fijas demasiado bajo, desaparecerán semanas de las series temporales. Sin dimensiones, se ignora por completo.- Las métricas de recuento a veces llegan como cadenas. La referencia muestra números, pero la API puede devolver cadenas, así que tu código debe aceptar ambos tipos.
- Los nombres de las columnas temporales son ambiguos. El mismo bloque puede aparecer como
date__dayocreated_at__day, según la forma de la consulta. - Los componentes de coste que no se usan devuelven
null, no cero. Cualquier script de agregación debe comprobar los valores nulos. metadata.truncated: truesignifica que los totales son parciales. Aumentalimit(por defecto, 1.000) o acota el periodo y vuelve a ejecutar la consulta.
¿Panel, API o pipeline propio?
Las herramientas nativas cubren las preguntas relacionadas con una cuenta. Montar una solución propia solo empieza a compensar cuando necesitas ir más allá:
| Necesitas… | Usa |
|---|---|
| Gasto, tokens y tasa de caché de un vistazo | Activity Overview |
| Qué ha cambiado y qué se está disparando | Trends |
| Segmentaciones puntuales y compartir resultados | Explore + exportación CSV/PDF |
| Informes programados, alertas y paneles internos | Analytics API |
| Agregación entre varios proveedores, presupuestos por usuario y detección personalizada de anomalías | Un pipeline propio basado en registros de uso y webhooks |
El camino de construirlo por tu cuenta ya está bastante recorrido. Un usuario de r/FinOps lo resumía así:
«Me hice mi propio rastreador de costes de IA en Obsidian porque el precio de un modelo pasó de céntimos a 3 € de la noche a la mañana».
Ese hilo y la conversación de r/openrouter titulada «Long context pricing should be more transparent» apuntan a la misma causa: las estimaciones locales se desvían de los importes facturados por culpa del enrutamiento, la caché, los tokens de razonamiento y los precios de los contextos largos. El uso registrado en el panel Activity es la cifra de referencia; si montas tu propio sistema, contrástalo con esos datos en lugar de fiarte de tu tabla de precios.
Hay un truco sencillo para atribuir el gasto, compartido por un desarrollador con seis meses en la plataforma: añade cabeceras X-Title a las solicitudes para que cada aplicación o experimento aparezca con su propio nombre en Activity. Y si tu gasto ya está repartido entre varios proveedores en lugar de concentrarse en un único router, una configuración con API unificada —AIReiter, entre ellas— resuelve el problema de agregación antes de que empiece.
Preguntas frecuentes
¿Necesito una clave de gestión para usar el panel de actividad?
No. El panel funciona desde la interfaz web con el inicio de sesión habitual de la cuenta. La clave de gestión solo es necesaria para los endpoints de la API de Analytics (/api/v1/analytics/meta y /api/v1/analytics/query).
¿Es gratuita la API de Analytics de OpenRouter?
El recetario describe el flujo de Analytics como de solo lectura y gratuito: consultas tus propios registros de uso y no pagas por cada llamada. Eso sí, sigues pagando la inferencia que reflejan esos registros.
¿Hasta cuándo conserva OpenRouter los datos de actividad?
El antiguo /api/v1/activity cubre los 30 días UTC completos anteriores. La documentación de la nueva API de Analytics no indica un límite de retención —sus ejemplos abarcan un mes—, así que considera no verificado cualquier historial de largo plazo y exporta CSV para conservar los datos que necesites.
¿Por qué no veo los prompts y las respuestas en los registros de Activity?
El detalle de prompts y finalizaciones solo existe para las solicitudes en las que el registro privado de entradas y salidas estaba activado en el momento de ejecutarlas. El anuncio lo deja claro: sin esa opción, el contenido histórico de los prompts no está disponible. Los totales se registran; el contenido es opcional.
El coste que conviene tener en cuenta
Todo lo anterior se puede usar hoy, y la consulta 1 por sí sola ya justifica dedicarle cinco minutos a la configuración. El riesgo pendiente es la deriva: estamos ante una beta explícita, cuyas métricas y dimensiones compatibles pueden cambiar. La propia OpenRouter recomienda volver a leer /meta antes de dar por válido un esquema en automatizaciones. Protege tus tareas programadas con una comprobación de meta en lugar de fijar nombres de campos a mano y la visibilidad del panel seguirá siendo útil mientras la API madura.
También te puede interesar: guía del auto router de OpenRouter · mejores modelos gratuitos de OpenRouter para programación · guía de precios de OpenRouter