Gehostete Benchmarks versprechen 280 Token pro Sekunde. Auf frühen Laptop-Setups erreicht das Modell je nach Hardware und Runtime jedoch alles zwischen 8 und 220 Token/s. Inkling 2 Mini ist eine überzeugende Option für Offline-Coding-Agenten: ein Open-Weights-Modell mit 26,4B Parametern, das rund 20 GB belegt. Vor dem Download sollte man aber seine Schwächen bei Chat, Faktentreue und APIs kennen.
Für wen sich Inkling 2 Mini lohnt – und wer besser weitersucht
Inkling 2 Mini beherrscht einen Anwendungsfall ziemlich gut, tut sich mit mehreren anderen aber schwer. Deshalb entscheidet der Workflow letztlich mehr als die Benchmark-Tabelle. Offline-Coding mit Tools und Suche ist sein Revier; chatlastige oder rein API-basierte Nutzung eher nicht.
| Dein Workflow | Fazit zu Mini |
|---|---|
| Offline-Coding-Agent auf einem Mac mit mindestens 32 GB oder einem DGX Spark | Passt gut: Hier liegen die besten gemeldeten Werte |
| Privates Arbeiten mit langem Kontext (nominal bis zu 1M Tokens) | Testen lohnt sich: In der Praxis zunächst mit 32K Kontext starten |
| Mehrere Chat-Runden oder strikte Befolgung von Anweisungen | Besser auslassen: Qwen3.8-27B misst sich hier besser |
| Heute schon eine gehostete API nutzen | Besser auslassen: Noch kein Serverless-Eintrag, nur Preise für Sampling und Fine-Tuning |
Der Rest dieses Tests liefert die Zahlen hinter dieser Einteilung: Was das Looping verändert, welche Benchmarks einer genaueren Prüfung standhalten, wie schnell das Modell lokal tatsächlich läuft und was der Preis wert ist.
Was Inkling 2 Mini ist – und wie das Looping funktioniert
Thinking Machines Lab hat Inkling 2 Mini am 20. November 2026 als Open Weights unter der Apache-2.0-Lizenz veröffentlicht. Die Gewichte liegen auf Hugging Face unter thinkingmachines/Inkling-2-Mini. Das Modell verarbeitet Text und Bilder, erzeugt Text und gibt eine maximale Kontextlänge von 1 Million Tokens an.
| Spezifikation | Inkling 2 Mini |
|---|---|
| Veröffentlichung | 20. November 2026, Thinking Machines Lab |
| Lizenz | Apache 2.0 |
| Parameter | 26,4B gesamt / 3,4B aktiv pro Token / 5,4B effektiv mit Loops |
| Layer | 24 gespeichert; die mittleren 12 laufen pro Token 3-mal (6 + 3x12 + 6 = 48 Anwendungen) |
| MoE-Routing | 8 von 128 Experten pro Token und Layer |
| Präzision | NVFP4 für 20 Layer, MXFP8 für die letzten 4; Checkpoint mit rund 20 GB (19,5 GB + 0,64 GB Predictor) |
| Kontext / Modalitäten | Bis zu 1M Tokens; Text und Bild als Eingabe, Text als Ausgabe |
| Lokale Ziele | Mac mit mindestens 32 GB Arbeitsspeicher über Ollama oder laut Model Card ein NVIDIA DGX Spark |
Die Angabe 3,4B beschreibt die gespeicherten aktiven Parameter. Werden die drei Loop-Durchläufe mitgerechnet, kommt die effektive Rechenlast auf rund 5,4B. Wiederverwendete Gewichte halten die Dateigröße klein, erhöhen aber den Rechenaufwand pro Token, wie der technische Überblick von Hugging Face erläutert.
Looping bringt zusätzliche Berechnung, aber kein zusätzlich gespeichertes Wissen. In der Ankündigung ordnet das Labor Mini bei der Faktentreue hinter größeren Inkling-Modellen ein, weil Wissen vor allem mit der Gesamtzahl der Parameter wächst. Genau deshalb sind Suche und Tools für dieses Modell so wichtig.
Welche Benchmarks belastbar sind – und welche man relativieren sollte
Alle folgenden Werte stammen aus den hauseigenen Testumgebungen des Labors und sind in der Model Card auf Hugging Face dokumentiert: Mini überzeugt bei toolgestütztem Coding und Suche, liegt beim Reasoning, bei visuellen Aufgaben und bei der Disziplin im Chat dagegen gleichauf oder zurück.
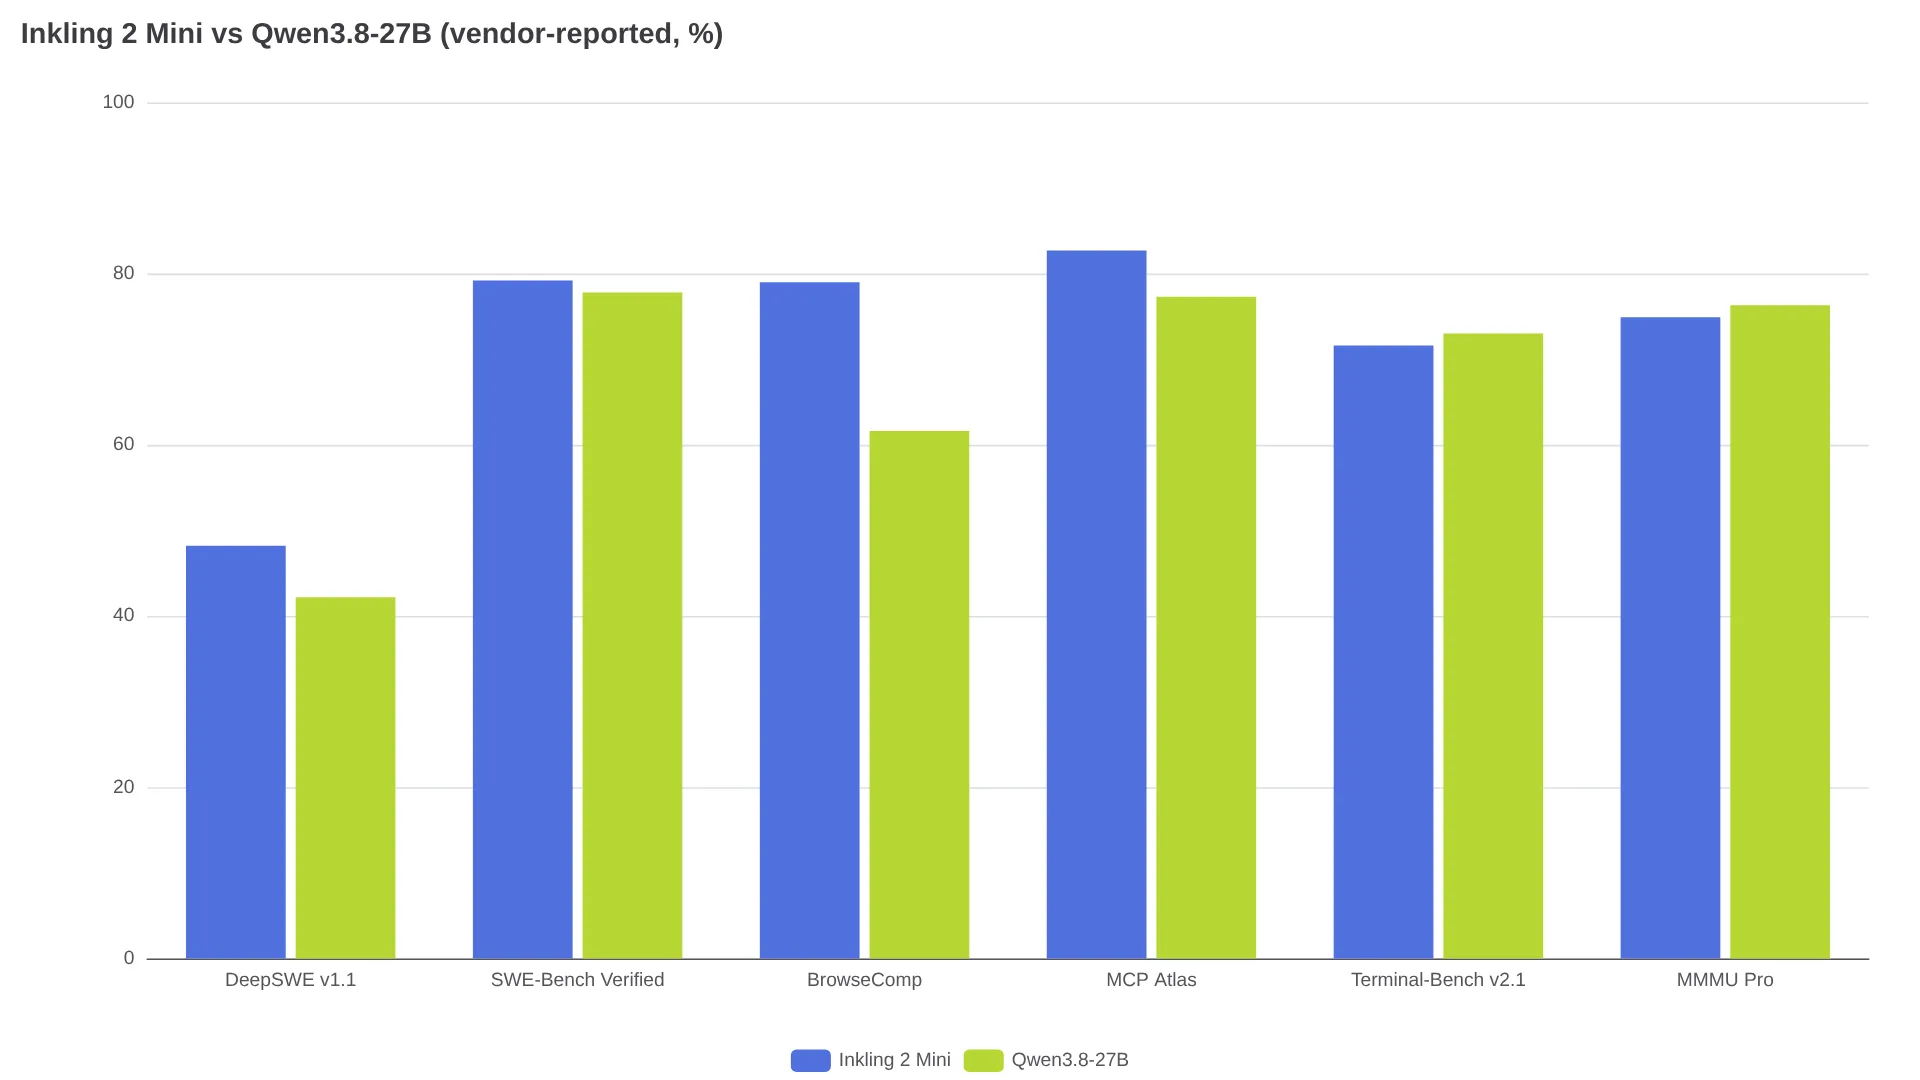
Mini führt bei DeepSWE v1.1 mit 48,2 % gegenüber 42,2 % für Qwen3.8-27B, bei SWE-Bench Verified mit 79,2 % gegenüber 77,8 %, bei BrowseComp mit 79,0 % gegenüber 61,6 % und bei MCP Atlas mit 82,7 % gegenüber 77,3 %. Artificial Analysis bewertet beide Modelle in seinem Intelligence Index mit 20,1. Mini erledigt die Index-Aufgabe allerdings in 9,0 Minuten, Qwen benötigt 38,2 Minuten. Der ARC Prize meldet bei der höchsten Reasoning-Einstellung 84,5 % für ARC-AGI-1 und 49,3 % für ARC-AGI-2.
Auf der anderen Seite fällt Mini laut derselben Model Card zurück: HLE-Diamond 15,2 % gegenüber 15,3 %, MMMU Pro 74,9 % gegenüber 76,3 % und Terminal-Bench v2.1 71,6 % gegenüber 73,0 %. Bei der Faktentreue ist der Abstand größer: AA-Omniscience kommt bei der Vermeidung von Halluzinationen auf 63,4 %, Qwen auf 71,4 %. Auch bei ComplexConstraints (33,4 %) und MultiChallenge (50,0 %) liegt Mini hinter Qwen.
Lokal gibt es nicht die eine Geschwindigkeit
Die offizielle Ollama-Auflistung und die Model Card nennen einen Mac mit 32 GB oder einen DGX Spark als Zielsystem. Da die Unterstützung für Loop-Modelle noch jung ist, schwankt die tatsächliche Geschwindigkeit jedoch stark. Der gehostete Durchsatz von 280 Token/s bei Artificial Analysis sagt wenig über die Leistung eines Laptops aus.
| Setup | Gemeldete Geschwindigkeit | Quelle |
|---|---|---|
| Gehosteter Test (Artificial Analysis) | 280 Token/s | Messung eines Drittanbieters |
| RTX 4090, gepatchtes vLLM + FP8/NVFP4 + Drafter | ~190-220 Token/s | Reddit-Nutzer, nur nach dem Patch (117 als Ausgangswert) |
| M5 Max MacBook Pro | ~125 Token/s | @alexocheema |
| M1 Max MacBook Pro mit 64 GB, 4-Bit-Quantisierung | ~20 Token/s | Hacker-News-Nutzer gregsadetsky, über den Starttest von eesel |
| Frühe llama.cpp-Builds, verschiedene Hardware | ~5-10 Token/s | Thread auf r/LocalLLM |
„Ich habe es nicht einmal auf 5 T/s gebracht.“ – u/KURD_1_STAN, Vergleichsthread auf r/LocalLLM
Ein großer Teil der Streuung geht auf Runtime und Quantisierung zurück: Aktuelle Builds kommen mit den Loop-Layern besser zurecht als die Versionen vom ersten Tag. Außerdem verändert die Wahl der Quantisierung den Speicherbedarf. Die empfohlene 4-Bit-Variante belegt laut Unsloths Anleitung bei Crewmark rund 17,6 GB plus einen 639 MB großen Vision Projector – und lange Kontexte erhöhen zusätzlich den Druck auf den KV-Cache.
In einem Test zum Abgleich von Zahlungen erreichte Qwen bei gleicher Latenz 98,2 % Genauigkeit und keine falschen Treffer. Mini kam auf 96,9 % und fünf falsche Treffer:
„Inkling 2 Mini gegen Qwen3.8-27B mit unserem echten Workflow zum Abgleich von Zahlungen getestet ... Qwen: 98,2 % Genauigkeit, 0 falsche Treffer ... Inkling: 96,9 %, 5 falsche Treffer ... Für diese Aufgabe bleibt Qwen im Einsatz.“ – @exebat3 (Beitrag)
Die praktische Konsequenz: zunächst mit 32K Kontext starten, ihn bei Speicherdruck reduzieren und vor einer Qualitätsbewertung prüfen, ob die verwendete Runtime Loop-Layer unterstützt.
Der Preis – ohne Checkout-Button
Die auf der Modelseite von Artificial Analysis genannten Tinker-Preise liegen bei 0,15 $ pro einer Million Eingabetokens, 0,015 $ für gecachte Tokens und 0,50 $ für Ausgabetokens. Fine-Tuning kostet 0,75 $ (64K) beziehungsweise 1,50 $ (256K). Auf den gemessenen Tokenverbrauch angewendet ergibt das 0,59 $ pro Index-Aufgabe gegenüber 3,53 $ für Qwen3.8-27B.
Die 0,59 $ sind eine Schätzung und kein aktuell buchbarer Hosting-Preis. Zum Testzeitpunkt war Mini bei keinem Serverless-Inference-Anbieter gelistet. Das dokumentiert der Test von eesel anhand von Tinker und OpenRouter. Außerdem erzeugte Mini beim Index-Lauf 161M Ausgabetokens gegenüber einem Median von 85,7M. Ein Teil des Preisvorteils pro Token geht dadurch beim höheren Redebedarf wieder verloren. Wer das Modell selbst betreiben will, sollte Hardware, Strom und Einrichtung mit einer gehosteten Qwen- oder Frontier-API vergleichen.
Zwei Einstellungen entscheiden über Erfolg oder Frust
Der Reasoning-Aufwand reicht von none (0,0) über minimal (0,1), low (0,2), medium (0,7) und high (0,9, Standard) bis xhigh/max (0,99). Die niedrigste Stufe deaktiviert Reasoning laut Model Card nicht vollständig.
Weniger kann mehr sein: In der Terminal-Bench-Diskussion auf r/LocalLLM erzielte ein Nutzer in einem Ausschnitt mit 13 Aufgaben bei niedriger Einstellung 10 von 13 Punkten, während die mittlere Einstellung wiederholt in Time-outs lief. Ein anderer Tester auf Hacker News, den eesel in seinem Test zitiert, verbrauchte ohne Tools 19.200 Thinking-Tokens, ohne fertig zu werden. Mit aktivierter Suche kam zwar eine Lösung, sie verwendete aber den falschen Hook-Namen.
Begrenze die Zahl der Ausgabetokens und Agentenrunden, führe Dateisystemzugriffe in einer Sandbox aus und verlange vor dem produktiven Einsatz eine menschliche Prüfung. Die Model Card warnt vor destruktiven Aktionen ohne Bestätigung und festhängenden Reasoning-Schleifen, insbesondere beim Debuggen von Code.
Diesen Kompromiss solltest du vor dem Download akzeptieren
Mini gewinnt zusätzliche Rechenleistung, ohne dass der Checkpoint größer wird, indem es seine mittleren Layer wiederverwendet. Das Labor stellt außerdem einen Checkpoint mit variabler Loop-Anzahl bereit, um dieses Verhalten zu untersuchen (technischer Überblick). Die dokumentierten Schwächen sind konkret: Schleifen beim Debugging, ein von einem Nutzer gemeldeter Wechsel ins Japanische mitten in einer Antwort und Tool-Aufrufe, die klare Grenzen brauchen. Für Offline-Coding mit Sicherheitsvorkehrungen ist der Download sinnvoll. Wer sorgfältige Chats oder eine API mit einem Klick braucht, wartet besser noch.
FAQ
Läuft Inkling 2 Mini auf einem Laptop?
Ja, mit dem passenden Build: auf einem Apple-Silicon-Mac mit mindestens 32 GB über Ollama oder eine aktuelle Version von llama.cpp, idealerweise in 4-Bit (~17,6 GB plus Projector). Auf einem älteren M1 Max sind etwa 20 Token/s zu erwarten, auf M5-Hardware mehr als 100 Token/s. Nicht gepatchte Runtimes können dagegen auf einstellige Werte abrutschen (siehe Tabelle oben).
Ist Inkling 2 Mini besser als Qwen3.8-27B?
Für Coding-Agenten ja, für Chat nein. Die Grafik oben zeigt den Unterschied: Mini liegt bei DeepSWE, SWE-Bench Verified, BrowseComp und MCP Atlas vorn. Qwen führt bei Terminal-Bench v2.1, MMMU Pro, Faktentreue und restriktiven Anweisungen. Alle Werte stammen aus Anbieterangaben in der Model Card.
Warum nennen Quellen sowohl 3,4B als auch 5,4B aktive Parameter?
3,4B sind die gespeicherten aktiven Parameter. Die 5,4B berücksichtigen zusätzlich drei Loop-Durchläufe mit jeweils etwa 1,0B. Für den Rechenaufwand ist 5,4B die passende Zahl, für den Speicherbedarf 3,4B.
Kann ich Inkling 2 Mini heute über eine gehostete API ansprechen?
Nein. Zum Testzeitpunkt gab es keinen First-Party-Serverless-Endpunkt. Tinker nennt Preise für Sampling und Fine-Tuning, führt aber laut Prüfung von eesel keinen Serverless-Eintrag für Mini. Du kannst die Hugging-Face-Gewichte lokal ausführen oder auf weitere Hosting-Angebote warten.
Wie verhindere ich Reasoning-Schleifen?
Starte mit der niedrigen Einstellung (0,2), begrenze Ausgabetokens und Agentenrunden und führe Tools in einer Sandbox aus – entsprechend den Empfehlungen der Model Card.
Weiterführend: Test und API-Preise von Inkling 2 Small für den 594B großen Geschwister-zu-Mini; Bestes LLM für Coding-Agenten 2026, um Mini unter den Agenten-Optionen einzuordnen; llama.cpp-v1.0-Anleitung für die Runtime, auf die Mini lokal angewiesen ist.