Neon auf high bietet hier das beste Preis-Leistungs-Verhältnis für Agents mit langem Kontext, wenn möglichst wenige falsche Antworten entscheidend sind. Astra und Sol bleiben pro Aufgabe günstiger. Diese Einschätzung zum Start basiert auf offiziellen Spezifikationen, Ranglisten und unabhängigen Tests. Eigene Läufe mit Neon habe ich nicht durchgeführt.
Neon ist der schnellere Carbon für Agents – mit einem klaren Kompromiss
Gemini 4 Neon ist am 18. November 2026 als gemini-4-neon gestartet. Laut Google und 9to5Google liegt das Modell innerhalb der Gemini-4-Familie zwischen Hydrogen und Carbon. Google verspricht gegenüber Carbon kürzere End-to-End-Laufzeiten bei niedrigeren Kosten pro Aufgabe. DeepMind-Mitarbeiter beschreiben Neon ebenfalls als günstiger und schneller als Carbon (@_mohansolo). Im Artificial Analysis Index erreicht es auf xhigh Platz 3 mit 61 Punkten, in der Agent Arena Platz 2 mit 1336 Punkten aus mehr als 4.200 Sessions. Vergleichbare Arena-Werte für Opus 5.5 und Fable 5.2 wurden in den geprüften Startunterlagen nicht veröffentlicht. Der folgende Vergleich stützt sich daher auf Index-Ränge und Tests mit identischen Aufgaben.
Preis, Kontextfenster und verfügbare Plattformen
Neon kostet 3 US-Dollar pro 1 Million Input-Tokens, 15 US-Dollar pro 1 Million Output-Tokens und 0,15 US-Dollar für gecachte Eingaben, so Google. Das Kontextfenster umfasst 1.048.576 Tokens, die maximale Länge einer einzelnen Antwort liegt bei 65.536 Tokens. Für das Denken stehen low, medium, high (Standard) und xhigh zur Verfügung. Höhere Stufen können mehr Reasoning-Tokens verbrauchen und damit die Rechnung erhöhen. Dass high der Standard ist, dokumentieren die Übersicht von DataCamp und die API-Hinweise von SpringPrompt.
Neon ist ausschließlich kostenpflichtig und bietet keinen Gratis-Tarif, wie eesel in seinem API-Check festhält. Laut Google und 9to5Google ist das Modell in der kostenpflichtigen API von AI Studio, in Gemini for Business, Antigravity (Pro/Ultra), der Gemini-App (Pro/Ultra, ersetzt Argon) und Android Studio verfügbar. Auch Cursor bietet Neon an: Bei standardmäßigem Aufwand erreicht es 63,7 % im CursorBench gegenüber 57,3 % bei Hydrogen, laut Cursor.
| Modell | Input / Output pro 1 Mio. | Standard-Denkstufe |
|---|---|---|
| Gemini 4 Neon | 3 / 15 US-Dollar, gecacht 0,15 US-Dollar | high |
| Gemini 4 Hydrogen | 1,50 / 7,50 US-Dollar | high |
| Gemini 4 Carbon | 2 / 10 US-Dollar bis 30. November, danach 4 / 20 US-Dollar | medium |
| Claude Opus 5.5 | 4 / 20 US-Dollar, getestete Maximalstufe | maximal getestet |
| GPT-6.2 Sol | 2 / 10 US-Dollar, getestete Maximalstufe | maximal getestet |
Die Preise der Konkurrenz und die Angaben zu den jeweils besten Einstellungen stammen aus der Vergleichstabelle von eesel. Ab dem 1. Dezember ist Neon pro Token 25 % günstiger als Carbon. Details finden sich in der Übersicht zu den Neon-Preisen.
Wer die Denkstufe exakt festlegen möchte, sollte die API verwenden; für verwaltete Kontingente eignen sich die App oder Antigravity. Berichte zur Kontingentauslastung sind lediglich anekdotische Planungswerte: ungefähr 1–3 % des Pro-Kontingents pro Chat gegenüber etwa 5 % für einen zehnminütigen Lauf mit drei Subagents, basierend auf Nutzerberichten.
Benchmarks: Opus 5.5, Fable 5.2 und Sol im Vergleich
Die Werte stammen aus Herstellerangaben von Google und wurden bei eesel sowie DataCamp zusammengetragen.
| Test | Neon | Konkurrenz | Einordnung |
|---|---|---|---|
| Vals Index | 70,9 %, Platz 2 | Fable etwa 71,3 % | Nahe an der Spitze |
| AutomationBench | 56,3 %, Platz 1 | Opus 42,5 %, Sol 41,3 % | Führung bei Agents |
| GraphWalks 256K–1M | 95,2 % | Opus 66,8 %, Sol 80,1 % | Führung bei langem Kontext; die längste Datei sollte zuerst erneut getestet werden, da einige Argon-Nutzer von zu starker Zusammenfassung berichten (Thread) |
| Terminal-Bench 4.1 | 65,2 % | Opus 65,8 % | Fast Gleichstand, Opus +0,6 |
| FrontierCode 2.0 | 46,2 % | Opus 47,3 % | Opus +1,1 |
| CursorBench 4.1 | 63,7–65,4 % | Opus 58,1 % | Neon liegt bei Standardaufwand vorn |
Bei den Kosten pro Aufgabe dreht sich das Bild gegenüber dem reinen Tokenpreis, wie Artificial Analysis über eesel zeigt:
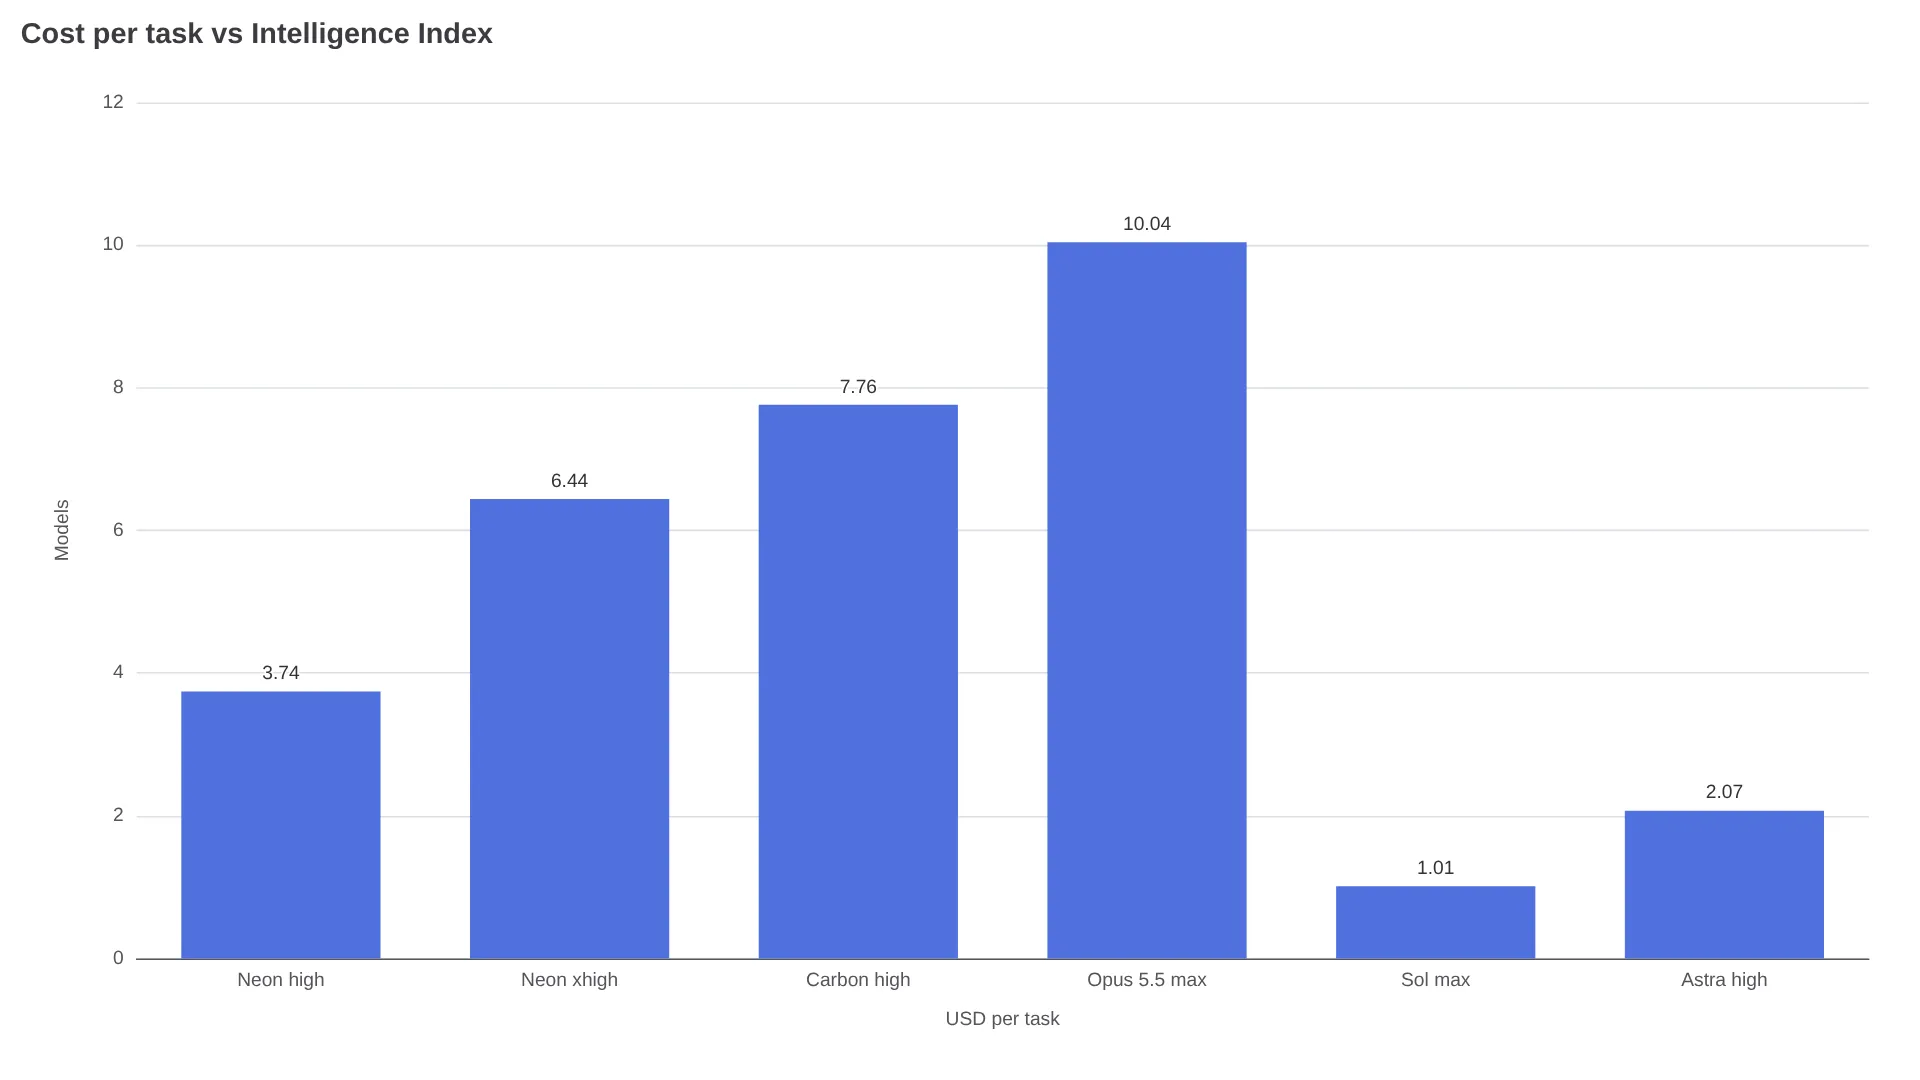
Neon high erreicht 59,6 Punkte für 3,74 US-Dollar in 14,8 Minuten; Carbon high kommt auf 60,0 Punkte für 7,76 US-Dollar in 37,2 Minuten; Opus max erreicht 59,1 Punkte für 10,04 US-Dollar; Astra high schafft 60,1 Punkte für 2,07 US-Dollar; Sol max erreicht 57,3 Punkte für 1,01 US-Dollar. Mit xhigh kommt Neon auf 61,4 Punkte für 6,44 US-Dollar in 21,5 Minuten. In der Regel reicht high – außer die zusätzlichen 1,8 Punkte sind 2,70 US-Dollar und 6,7 Minuten wert.
Neon gegen Fable 5.2: Vorläufig spricht vieles für getrennte Rollen
Im Provider-Harness-SWE-sweep mit Antigravity-Harness erreicht Neon 39,0 % gegenüber 10,1 % bei Opus und 8,3 % bei Sol. Im gemeinsamen mini-SWE-Harness sind es 12,8 % für Neon, 11,6 % für Sol und 3,6 % für Opus, laut DataCamp. Ein großer Teil des auffälligen Abstands hängt damit am Harness und nicht ausschließlich am Modell.
„Ich nutze Fable 5.2 als Orchestrator und für die Entwicklung und Neon als Coding-Agents. Das ist der beste Stack, den ich je betrieben habe.“ — u/1969Stingray (Thread)
Anekdotisch setzen Nutzer Fable bevorzugt für die Orchestrierung und Neon für die Implementierung ein. Für das eigene Repository sollte man diese Kombination zunächst selbst prüfen. Bei AA-Omniscience gibt Neon in 14 % der Fälle eine falsche Antwort, statt abzulehnen; bei Opus sind es 50 %, bei Sol 55 % und bei Astra und Fable 58 %. Gleichzeitig liegt die Abdeckung bei Neon bei 59–60 % korrekten Antworten, gegenüber 66 % bei Astra und 77 % bei Fable, laut eesel.
Praxistests: Schach, Produktlisten und 105 echte Bugs
| Test | Ergebnis | Einschränkung |
|---|---|---|
Schachseite, 3 Läufe medium (DataCamp) | Neon 3/3 für 0,83–1,06 US-Dollar; Carbon 1/3, zwei Läufe erreichten das 65K-Limit; 16 Partien, kein einziger illegaler Zug | Nur eine Aufgabe; Carbon würde mit Hintergrundmodus wahrscheinlich fertig |
| CatalogBench, Fakten (SpringPrompt) | 78,6 % mit x3 publikationsfertig, Platz 1 von 35; liest Spezifikationen von Verpackungen ab | Verkauf 32,1 %, Präsentationen Platz 24, Umfragen Platz 22 bei begrenztem Budget |
| 105 neu eingepflanzte Bugs (@PawelHuryn) | Neon xhigh 63 gegenüber Astra 62,7, Fable 58 und Carbon 57,3 | Ein einzelner Tester |
SpringPrompt nutzte OpenRouter mit medium, während die Google API standardmäßig high verwendet. Die Ausführlichkeit fällt deshalb unterschiedlich aus. Einzelne Berichte über Datenlecks in AI Studio gibt es ebenfalls (Thread). Für Chats veranschlagt eesel bei Neon xhigh 56,5 Sekunden bis zum ersten Token. Für interaktive Antworten sind daher medium oder Hydrogen die bessere Wahl.
Die passende Wahl für jede Aufgabe
| Einsatzgebiet | Empfehlung | Warum |
|---|---|---|
| Anspruchsvolle Agents, lange Dokumente, Refactorings | Neon high | 59,6 Punkte für 3,74 US-Dollar, Platz 2 in der Agent Arena, 3/3 beim Schach |
| Projekte mit dem längsten Planungshorizont | Carbon, gemäß Googles Positionierung der Modellfamilie | Google reserviert Carbon für die schwierigsten Projekte; ein Test mit identischer Aufgabe liegt hier nicht vor |
| Orchestrierung und Coding | Fable als Lead + Neon als Coder | Der oben genannte anekdotische Hybrid-Ansatz; vorher selbst validieren |
| Niedrigste Kosten pro Aufgabe | Sol max für 1,01 US-Dollar; Astra high für 2,07 US-Dollar erzielt höhere Werte | Beide hatten bei AA-Omniscience höhere Raten falscher Antworten |
| Interaktiver Chat | Hydrogen oder Neon medium | Die Latenz bis zum ersten Token ist bei xhigh für Chats zu hoch |
| Regulierte Nutzung | Auf weitere Dokumente warten | Der vollständige Sicherheitsbericht stand am 19. November noch aus; Freigabe nur anhand der benötigten Dokumentation |
In einem Nachmittag selbst testen
Verwende denselben Prompt, dieselben Dateien und dasselbe Denkbudget mit Neon high, deinem aktuellen Standardmodell und einer günstigen Alternative. Halte Erfolgsquote, Kosten, Dauer und falsche Antworten fest. Dieser direkte Vergleich ist für deine Aufgaben meist aussagekräftiger als jede Rangliste. Die Rechnung für Opus findet sich im Test zu Opus 5.5, die für Fable im Test zu Fable 5.2.