Wer nach Token abrechnet, muss bei Gemini 4 Neon vor allem auf den Kalender schauen: Noch für 11 Tage ist Carbon günstiger, ab dem 1. Dezember liegt Neon 25 % darunter. Google hat Gemini 4 Neon am 18. November 2026 gestartet – für $3 je 1 Mio. Input-Token und $15 je 1 Mio. Output-Token, mit einem Kontextfenster von 1 Mio. Token und ohne kostenlosen Tarif.
Der 30. November entscheidet über den besseren Preis
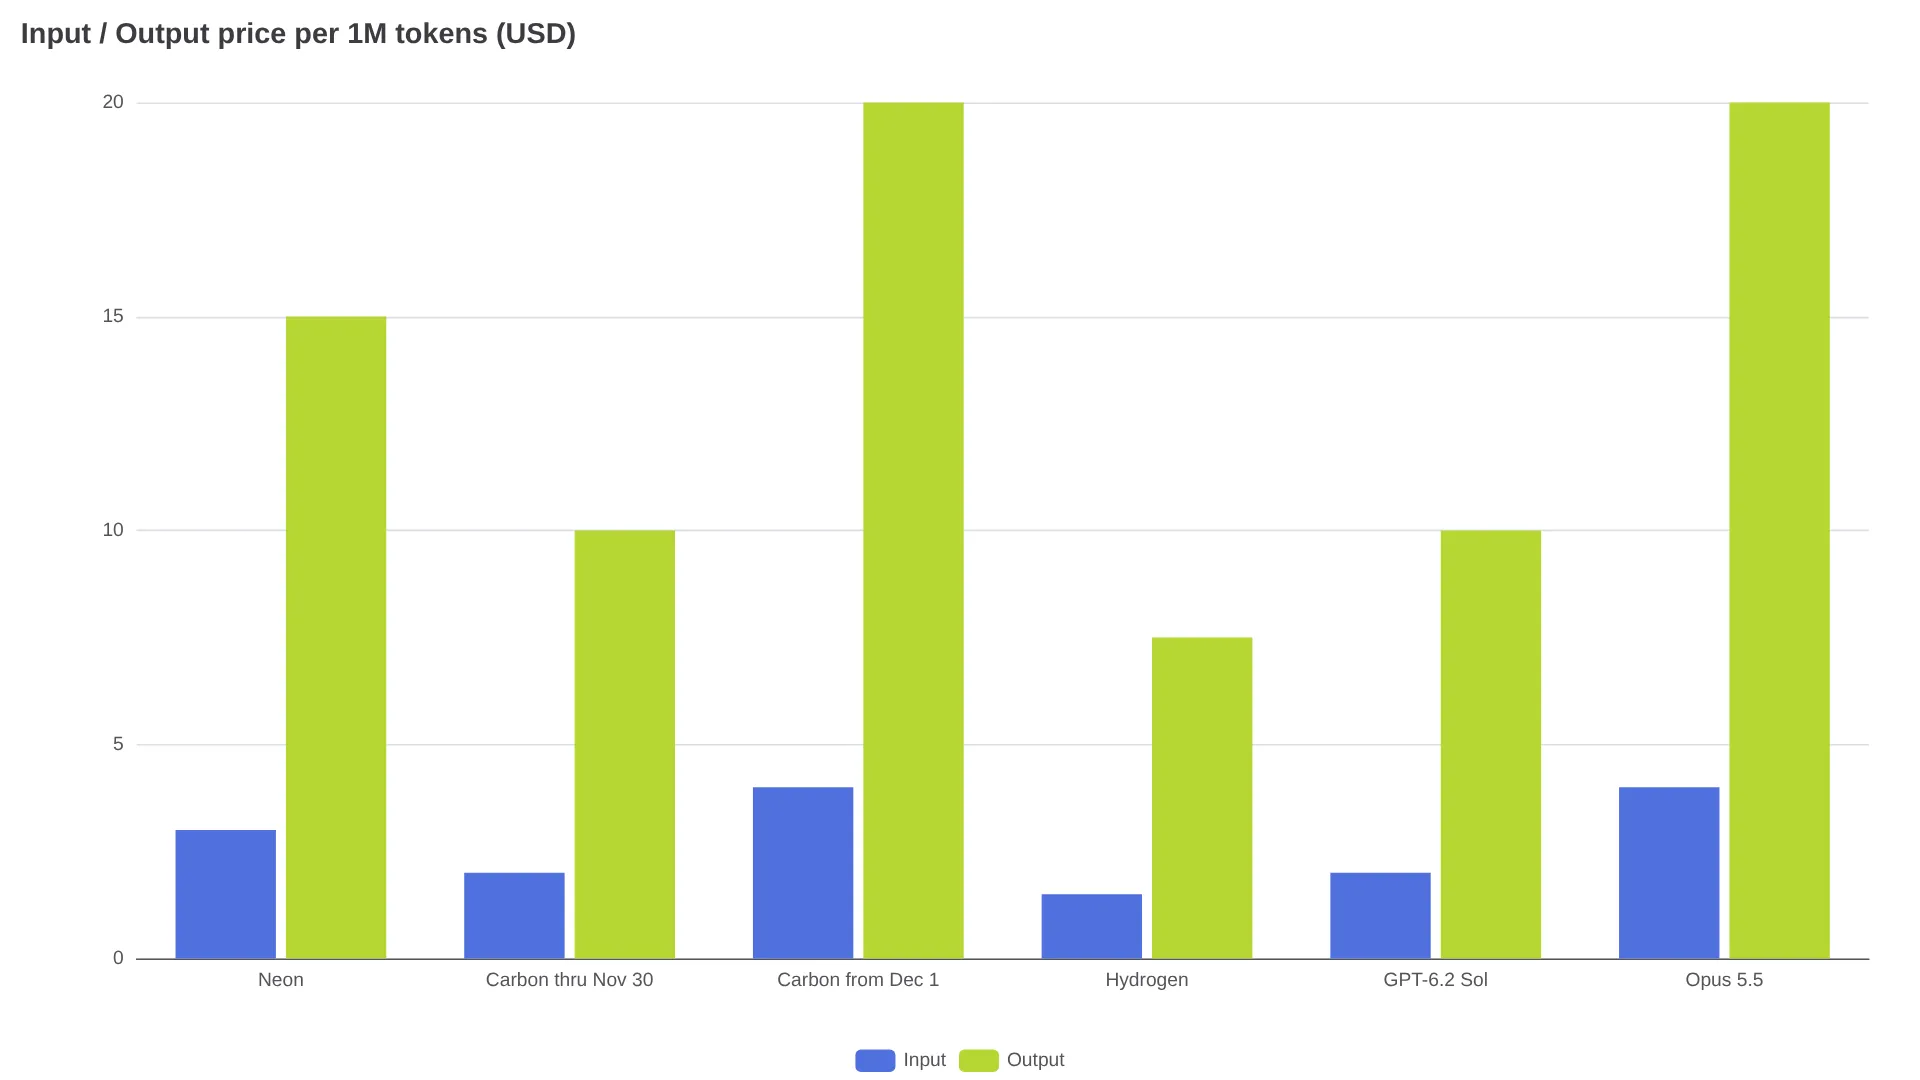
Die Preise der Gemini 4 Neon API lassen sich nur im Kontext des Stichtags bewerten. Bis zum 30. November 2026 kostet Gemini 4 Carbon zum Einführungspreis $2 Input / $10 Output je 1 Mio. Token. Ab dem 1. Dezember steigen Carbon und Argon auf $4 / $20. Damit ist Neon mit $3 / $15 pro Token exakt 25 % günstiger (Preisvergleich). Bis einschließlich 30. November kostet Neon zu den Aktionspreisen dagegen 50 % mehr als Carbon.
Google argumentiert mit den Kosten pro Aufgabe und nennt bei hohem Thinking-Level 32 % geringere Aufgabenkosten als bei Carbon sowie bei xhigh mindestens 36 % Ersparnis gegenüber nicht genannten Wettbewerbern (Launch-Analyse). Für die Budgetplanung zählen jedoch die veröffentlichten Tokenpreise von $3/$15; die Kosten pro Aufgabe stammen von Google und haben keine benannte Vergleichsbasis.
Die Rolle von Neon im Gemini-4-Portfolio
Gemini 4 Neon positioniert sich in der Mitte: mehr Reasoning-Tiefe als Hydrogen, bei schnellerer Ausführung nahe an der Qualität von Carbon, so die Modellpositionierung von OpenRouter. Carbon war der Standard für Frontier-Coding, Argon das Flaggschiff für Reasoning bei Mathematik und Naturwissenschaften, während Hydrogen als Hochvolumen-Modell $1.50 / $7.50 kostet (Preisindex). Neon bietet vier Reasoning-Stufen – low, medium, high und xhigh –, wobei high voreingestellt ist (Provider-Spezifikationen).
Zum Start war Neon laut Googles Ankündigung und der Launch-Aufschlüsselung hier verfügbar:
| Plattform | Zugang zu Neon |
|---|---|
| Gemini API | Zahlende Entwickler, Modell-ID gemini-4-neon (Katalogeintrag) |
| AI Studio / Gemini-App / Antigravity | Bezahlter Tarif sowie Google AI Pro und Ultra |
Beim Neon-Label in Antigravity ist Vorsicht angebracht. Nutzer berichten im Antigravity-Thread, dass der Orchestrator-Eintrag in manchen Sitzungen offenbar weiterhin auf einen Carbon-System-Prompt auflöst; eine Antwort fasst es so zusammen: „its just the orchestrator. not neon“ (Thread). Solange Google keine Zuordnung per Build-ID veröffentlicht, sollte die Abrechnung auf der API-Modell-ID basieren, nicht auf dem UI-Label.
Was man für $3/$15 tatsächlich bekommt
Die Standardpreise betragen $3.00 für Input, $15.00 für Output und $0.15 für gecachten Input je 1 Mio. Token (offizielle Ankündigung) – einheitlich über den gesamten Kontext von 1.048.576 Token hinweg (Preisprüfung). Drittanbieter-Indizes führen Batch mit $1.50 / $7.50, Flex mit $1.50 / $7.50 und Priority mit $5.40 / $27.00 auf (Spezifikationen und Provider-Tabelle). Google hatte Neon Batch/Flex/Priority zum Launch jedoch nicht auf seiner allgemeinen Preisseite veröffentlicht. Bis diese Seite aktualisiert wird, sollte Neon als Standard-only gelten (Launch-Analyse).
Wiederverwendbare Formel: Kosten = frischer Input / 1 Mio. × $3 + gecachter Input / 1 Mio. × $0.15 + Output einschließlich Thinking / 1 Mio. × $15.
Drei Abrechnungsregeln verändern den Listenpreis erheblich (Launch-Analyse und Preisreferenz):
- Thinking-Token werden als Output abgerechnet. Der Output-Preis von $15 dominiert jede Rechnung.
- Das Caching erfolgt ausschließlich implizit: mindestens 4.096 Token Prompt, 95 % Rabatt auf berechtigten gecachten Input. Es gibt keinen expliziten
cachedContents-Cache und keine Cache-Schreibgebühr. - Synchroner Output ist auf 65.536 Token begrenzt (Spezifikationen). Für längere Ausgaben ist Background Execution nötig.
Kurze Prompts unter 4.096 Token profitieren überhaupt nicht vom Cache (Preisreferenz). Ein Support-Bot mit 1.200 Input-Token kann den $0.15-Tarif also nicht nutzen.
Zwei modellierte Workloads im Kostencheck
Die folgenden Rechnungen basieren auf festen Tokenmengen; Retries und variable Reasoning-Längen sind nicht enthalten. Entscheidend ist der Output-Anteil. Alle Zeilen verwenden dieselben Cache-Verhältnisse und die jeweiligen Listenpreise aus der Launch-Preistabelle.
Codingsitzung: 50 Aufrufe, jeweils 80.000 Input-Token, davon 90 % aus dem Cache, sowie 2.500 Output-Token einschließlich Thinking pro Aufruf. Insgesamt: 400.000 frische Input-Token, 3,6 Mio. gecachte Token, 125.000 Output-Token.
| Modell | Kosten pro Sitzung |
|---|---|
| Gemini 4 Neon $3/$15 | $3.62 ($1.20 frisch + $0.54 gecacht + $1.88 Output = $3.615) |
| Carbon bis 30. Nov. $2/$10 | $2.41 |
| Carbon ab 1. Dez. $4/$20 | $4.82 |
| Hydrogen $1.50/$7.50 | $1.81 |
| GPT-6.2 Sol $2/$10 | $2.41 |
Support im großen Maßstab: 10.000 Gespräche pro Tag über 30 Tage, jeweils 6.000 Input-Token mit 75 % Cache-Anteil und 500 Output-Token. Insgesamt: 450 Mio. frische Token, 1,35 Mrd. gecachte Token, 150 Mio. Output-Token.
| Modell | Monatliche Kosten |
|---|---|
| Gemini 4 Neon $3/$15 | $3,802.50 (davon $2,250 für Output) |
| Carbon bis 30. Nov. $2/$10 | $2,535.00 |
| Carbon ab 1. Dez. $4/$20 | $5,070.00 |
| Hydrogen $1.50/$7.50 | $1,901.25 |
| GPT-6.2 Sol $2/$10 | $2,535.00 |
Neon kostet pro Token doppelt so viel wie Hydrogen und 50 % mehr als Sol zu $2/$10. Damit Neon beim Preis pro Aufgabe gewinnt, muss es Aufgaben mit weniger Token oder weniger Retries abschließen. Die angeführten Benchmark-Werte (Intelligence Index 61, Rang 3; Coding Agent Index, Rang 1) stammen vom Anbieter und belegen keine niedrigeren Kosten in realen Workloads (Benchmark-Überblick).
Tokenpreise und Quoten sind zwei verschiedene Dinge
Prozentanzeigen in der App lassen sich nicht in API-Dollar umrechnen. Ein Pro-Nutzer berichtet bei Neon-Sitzungen mit langem Kontext von 1–2 % Verbrauch pro Nachricht:
Ich habe auch bestehende Gespräche mit langem Kontext auf Neon umgestellt und sehe 1–2 % Nutzung pro Nachricht. Das sieht so aus, als könnte es im Pro-Tarif tatsächlich nutzbar sein! — u/biblecrumble (Thread)
Die App-Quote hängt von Fünf-Stunden-Fenstern, Thinking-Level und Tool-Aufrufen ab. Bei der API werden alle verarbeiteten Token einschließlich Thinking gezählt, dazu kommt Search Grounding separat je Anfrage (Launch-Analyse). API-Workloads sollten anhand der obigen Tabellen in Dollar budgetiert werden; den Spielraum im Abo ermittelt man mit eigenen Läufen auf high und xhigh.
Umstellung in einer Zeile – dann diese drei Punkte prüfen
Aufrufer von Carbon, Argon oder Hydrogen migrieren, indem sie die Modell-ID auf gemini-4-neon ändern (Launch-Analyse). Drei Stolperfallen können Aufrufe dennoch scheitern lassen (Launch-Analyse):
thinking_levelexplizit setzen. Neon verwendet standardmäßig high.cached_content-Felder entfernen. Explizites Caching wird nicht unterstützt.temperature,top_pundtop_kentfernen. Werte außerhalb des gültigen Bereichs liefern HTTP 400, andere Werte werden ignoriert.
Für lange Ausgaben sollte außerdem max_output_tokens in Richtung 65.536 erhöht oder Background Execution eingesetzt werden.
Jetzt wechseln oder Carbon noch ausreizen?
| Situation | Empfehlung |
|---|---|
| Release vor dem 30. November, maximales Reasoning erforderlich | Bei Carbon $2/$10 bleiben, Neon parallel testen |
| Produktiv-Agenten im Dezember, langer Kontext | Neon $3/$15 ist der Kandidat zum Listenpreis – vor dem Wechsel Aufgabenerfolg und Retries prüfen |
| Einfacher Chat mit hohem Volumen | Bei Hydrogen $1.50/$7.50 bleiben, die einzige kostenlose Option in diesem Vergleich (Preisindex) |
| Günstigster Frontier-Listenpreis heute | GPT-6.2 Sol für $2/$10, sofern der Stack OpenAI zulässt |
| Nachweis für Batch erforderlich | Abwarten – Neon Batch ist nicht veröffentlicht |
FAQ
Wie viel kostet die Gemini 4 Neon API?
Laut Google $3 für Input, $15 für Output und $0.15 für gecachten Input je 1 Mio. Token.
Wie groß sind Kontext- und Output-Limit?
1.048.576 Input-Token; 65.536 synchrone Output-Token.
Gibt es einen kostenlosen Tarif?
Nein. Neon ist nur kostenpflichtig; Hydrogen behält einen Free Tier.
Sind Batch, Flex oder Priority verfügbar?
Google hatte sie zum Launch nicht veröffentlicht. Drittanbieter nennen $1.50/$7.50 für Batch/Flex und $5.40/$27 für Priority – vor der Budgetplanung bestätigen.
Wie funktioniert das Caching?
Ausschließlich implizit, mit mindestens 4.096 Token und 95 % Rabatt auf berechtigten gecachten Input.
Wie lautet die Modell-ID?
gemini-4-neon.
Neon, Hydrogen oder Carbon: Welches Modell ist das richtige?
Hydrogen für günstiges Volumen; Carbon bis 30. November für die günstigsten Frontier-Token; Neon ab 1. Dezember für fortgeschrittenes Reasoning, 25 % unter Carbons Preis von $4/$20.
Was kostet eine Anfrage mit 2.000 Input- und 500 Output-Token?
$0.0135 zum Listenpreis, vor Caching. Thinking wird als Output abgerechnet.