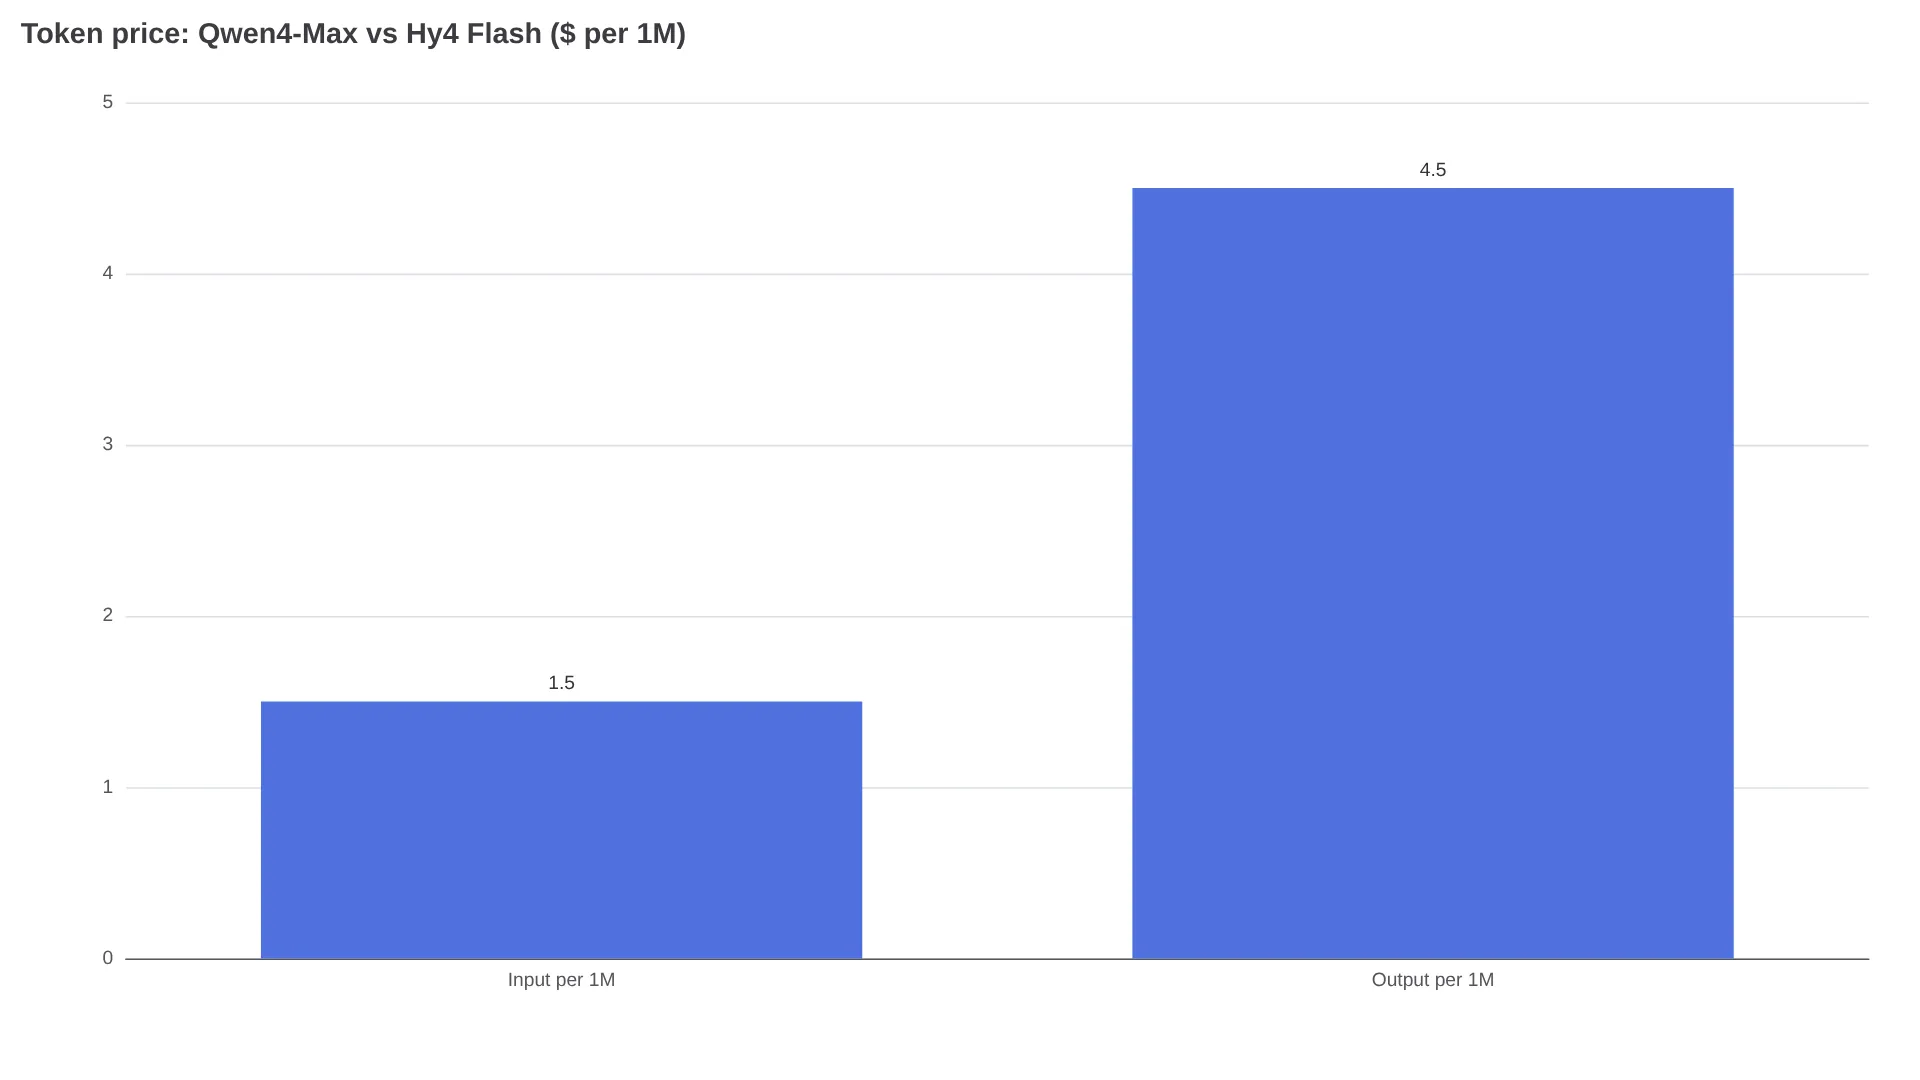
Bei anspruchsvollen Coding- und Workflow-Aufgaben liegt Qwen4-Max in den genannten Benchmarks vor Hy4 Flash. Dafür kostet jeder einzelne Versuch mit Hy4 Flash deutlich weniger. QwenCloud berechnet für Qwen4-Max $1.50/$4.50 pro Million Tokens, Tencent für Hy4 Flash $0.070/$0.281 – rund 21x mehr für Input und 16x mehr für Output. Für die tatsächliche Agentenrechnung zählen jedoch Reasoning-Tokens, Wiederholungen und Cache-Nutzung stärker als der Listenpreis. Dieser Preisvergleich der Qwen4 Max API stellt den 1M-Kontext, die Backbones mit 2.4T beziehungsweise 224B Parametern sowie die Kosten-pro-Task-Angaben der Anbieter gegenüber und leitet daraus passende Einsatzbereiche ab.
Listenpreise im direkten Vergleich
| Position | Qwen4-Max (Singapur / International) | Hy4 Flash (TokenHub International) |
|---|---|---|
| Input pro 1M | $1.50 | $0.070 |
| Output pro 1M (inkl. Reasoning) | $4.50 | $0.281 |
| Gecachter Input-Read pro 1M | $0.075 | $0.003 |
| Explizite Cache-Erstellung pro 1M | $1.875 (5-min) / $3.00 (1-hr) | Nicht separat ausgewiesen |
| Gemischt: 0.5M Input + 0.5M Output | $3.00 | ~$0.176 |
| Modell-ID | qwen4-max über QwenCloud | Hy4 Flash über Tencent |
Greifbar wird der Unterschied bei einer agentischen Coding-Session mit 60,000 Input- und 4,000 Output-Tokens. Qwen4-Max kostet $0.09 für den Input plus $0.018 für den Output, also etwa $0.108 pro Versuch. Bei Hy4 Flash sind es $0.0042 plus $0.0011, rund $0.0053 pro Versuch – vor Wiederholungen etwa 20x günstiger. Ist der Input vollständig gecacht, kosten dieselben 60k Input-Tokens bei Qwen4-Max $0.0045 und bei Hy4 Flash $0.00018, jeweils vor dem Output. QwenCloud rechnet Reasoning als Output ab; bei Hy4 Flash kostet Output $0.281 pro Million, daher senken kürzere Ausgaben die Tokenrechnung direkt.
Was die Modellarchitektur für die Kosten bedeutet
Qwen4-Max ist ein MoE-Modell mit 2.4T Parametern und 71B aktiven Parametern pro Token (Offloop, DataCamp). Hy4 Flash setzt auf ein LatentMoE-Modell mit 224B Parametern, 12B aktiven Parametern, 4-Bit-Inferenz und einer angegebenen Geschwindigkeit von 150+ Tokens pro Sekunde (Tencent). Für die Rechnung ist vor allem das gemessene Output-Volumen relevant: Der getestete Footprint von Qwen4-Max erreichte 127M Output-Tokens gegenüber einem Peer-Median von 78.6M (DataCamp), während Hy4 Flash die durchschnittliche Output-Länge nach dem Post-Training um 50% reduzierte (Tencent).
Welcher Tarif tatsächlich gilt
QwenCloud Singapur verlangt $1.50 für Input, $4.50 für Output und $0.075 für gecachte Reads. Das Maximum beträgt 991,808 Input-Tokens ohne Thinking und 983,616 mit Thinking, 131,072 Output-Tokens bei deaktiviertem Thinking sowie 262,144 kombiniert (QwenCloud). Andere Deployments in Virginia, Frankfurt, Tokio und Hongkong nennen $1.413 / $4.24 / $0.071 (regionale Tabelle über Offloop).
Für neue Pay-as-you-go-Konten in Singapur wird ein kostenloses Kontingent von 1 Million Tokens beworben; Bedingungen gelten dabei (über Xenospectrum). Die Token-Plan-Route qwen4-max-preview wird am November 25, 2026 eingestellt und deckte Produktions-Backends nie ab (Migrationshinweise).
Für Hy4 Flash nennt Tencent $0.070 / $0.281 / $0.003, während das vollständige Flaggschiff Hy4 bei $0.834 / $2.501 / $0.042 liegt (Tencent). Bis Nov 30, 2026 kostete TokenHub die Hälfte (~$0.035 effektiver Input) (Tencent). Die Verfügbarkeit lässt sich bei OpenRouter prüfen. Details bietet Hy4 Flash pricing.
Drei Faktoren hinter der tatsächlichen Rechnung
Erstens: Reasoning teilt sich das Output-Budget und wird als Output abgerechnet. Qwen4-Max nutzt standardmäßig high mit einem Thinking-Budget von 131,072 Tokens; xhigh und low sind die Alternativen. Beim SVG-Test von Simon Willison über OpenRouter, zusammengefasst bei Offloop, verbrauchte derselbe Prompt mit high 6,362 Tokens, mit xhigh dagegen 26,295 – also 4.1x so viele abrechenbare Tokens. Wer im Thinking-Modus max_completion_tokens auf 10,000 setzt, begrenzt Reasoning und Antwort zusammen auf 10,000.
Zweitens verstärken sich Ausführlichkeit und Retries gegenseitig. Von Alibaba zusammengestellte Zahlen über Offloop veranschlagen für Qwen4-Max etwa 105,000 Output-Tokens pro Benchmark-Aufgabe, gegenüber 171,000 bei Qwen3.8-Max. Das entspricht zwar einer Reduktion um 39%, liegt aber weiter deutlich über dem Peer-Median. Ein Reddit-Benchmark in einer Sandbox mit 56 Aufgaben, jeweils zwei Versuchen und insgesamt 112 Versuchen (Thread) zählte bei Qwen4-Max Preview 64 erfolgreiche Versuche und bei DeepSeek V4.1 Flash 61. Zugleich gab es 16 statt 4 Timeouts sowie ungefähr 13 statt 7 Minuten pro Aufgabe. Jeder wiederholte Timeout erzeugt eine weitere abrechenbare Anfrage.
"the 16 timeouts for qwen are doing a lot of the work in that 64 vs 61." — u/the_crooked_badger, r/DeepSeek thread
Drittens lohnt sich Cache-Reuse besonders bei Agenten mit langem Kontext. Der gecachte Read von Qwen4-Max kostet mit $0.075 95% weniger als regulärer Input; ein Kommentator im r/Qwen_AI-Thread berichtete von 112M gecachten gegenüber 14M ungecachten Input-Tokens. Mit $0.003 ist der Cache-Read von Hy4 Flash nochmals 25x günstiger. Das hilft jedoch weniger, wenn zusätzliche Reasoning-Schleifen den Großteil der Rechnung ausmachen. Wie @MarcosRGjr formulierte: "Ignore the per-token price. Agents get billed per task" (Post).
Was Anbieter pro Aufgabe versprechen – und was externe Daten zeigen
Anbieterangaben stehen hier externen Näherungswerten gegenüber, nicht einem verifizierten direkten Vergleich.
| Angabe | Wert | Grundlage |
|---|---|---|
| Alibaba Work360, Qwen4-Max vs. Qwen3.8-Max (anbieterintern, über DataCamp) | $1.67 vs $4.43 pro versuchter Aufgabe | Suite mit 721 Feldern, ~35% weniger Tokens bei high |
| Alibaba-Chart inklusive AA-Zeilen, Qwen4-Max vs. Qwen3.8-Max (vom Anbieter zusammengestellt, über Offloop) | $3.27 vs $10.02 pro Benchmark-Aufgabe | xhigh, 105K vs 171K Output-Tokens |
| Tencent WorkIndex, Hy4 Flash vs. vollständiges Hy4 (anbieterintern, über Tencent und Aufschlüsselung) | ¥0.2 vs ¥5.7 pro Aufgabe | Office-Suite mit 8 Sets |
| Tencent-Blindtest, Hy4 Flash vs. Claude Haiku 5.5 (vom Anbieter durchgeführt, über Tencent) | ¥0.26, 2.79/4 vs ¥4.73, 2.81/4 | 85 Nutzer, 259 Aufgaben, 6.7 vs 6.8 min |
Work360 bewertet Qwen4-Max mit 52.69 gegenüber 47.74 für Qwen3.8-Max. Der Intelligence Index steigt von 34 auf 43, bleibt jedoch hinter Kimi K3.1 Pro mit 46 und Opus 5.5 mit 59 zurück (Offloop, LLM Leaderboard).
Externe Ergebnisse, die in Anbietercharts wiedergegeben werden, setzen den Behauptungen Grenzen. Vals-nahe Tests, dokumentiert im LLM-Leaderboard-Guide, maßen für Qwen4-Max 63.20% bei $9.33 pro Test; GPT-6.1 Sol kam auf 63.94% bei $3.61. In Terminal-Bench 4.0 erreicht Qwen4-Max laut Tencents Chart 48.5%, Hy4 Flash 19.2% und vollständiges Hy4 44.4%. ProgramBench weist 31.5 gegenüber 16.0 aus (Offloop). Bei AutomationBench-AA stehen 72.5% für Qwen4-Max (DataCamp) 52.2 für die Automation-Leistung von Hy4 Flash gegenüber (Tokenstrom).
Die erwarteten Kosten pro Erfolg ergeben sich aus den Kosten pro Versuch geteilt durch die Erfolgswahrscheinlichkeit. Nur als Illustration: $0.108 / 0.485 ≈ $0.22 für Qwen4-Max gegenüber $0.0053 / 0.192 ≈ $0.028 für Hy4 Flash – ein Unterschied um etwa den Faktor 8. Benchmark-Raten sind keine Retry-Raten aus der Produktion. Bei diesen Token-Volumina müsste Qwen4-Max ungefähr eine 20x höhere Erfolgswahrscheinlichkeit bieten oder entsprechend bei Tools, Latenz und Reparaturen einsparen, um allein in Dollar zu gewinnen.
Nach Workload routen – dann mit 30 Aufgaben prüfen
| Agentenprofil | Empfohlener Standard | Begründung |
|---|---|---|
| Anspruchsvolles Coding und Terminal-Arbeit mit langem Horizont | Qwen4-Max mit high | Die höhere Erfolgsrate (48.5 vs 19.2, 31.5 vs 16.0) kann den Aufpreis rechtfertigen, wenn Fehler oder Reparaturen teuer sind |
| Office-Schleifen mit hohem Volumen: Präsentationen, Dokumente, Tabellenreparatur, Computer-Use | Hy4 Flash | ¥0.2 vs ¥5.7 im WorkIndex, nahezu gleichauf mit Claude Haiku 5.5 (2.79 vs 2.81) bei ~einem Achtzehntel der Kosten |
| Gecachte Pipelines und Batch-Extraktion | Hy4 Flash als Standard; Qwen4-Max, wenn Replays Qualitätsersparnisse belegen | $0.003 mit $0.075 für Cache-Reads vergleichen, zuzüglich Reparaturkosten für die eigenen Dokumente |
Vor einer Festlegung sollten 30 eigene Aufgaben auf beiden Modellen erneut ausgeführt werden. Erfassen Sie Reasoning- plus Output-Tokens pro Erfolg, Tool-Aufrufe, Timeouts, Korrekturen und die Medianzeit – neben den Dollarbeträgen.
FAQ
Was kostet die Qwen4 Max API pro Million Tokens?
QwenCloud Singapur nennt $1.50 für Input und $4.50 für Output sowie $0.075 für gecachte Reads. Andere Regionen listen $1.413 / $4.24 / $0.071. Hy4 Flash kostet laut Liste $0.070 für Input, $0.281 für Output und $0.003 für gecachte Tokens.
Werden Reasoning- oder Thinking-Tokens als Output abgerechnet?
Qwen4-Max berechnet Thinking mit $4.50 innerhalb eines gemeinsamen Budgets von 262,144 Tokens. Bei Hy4 Flash kostet Output $0.281, daher reduzieren kürzere Ausgaben die Zahl abrechenbarer Tokens.
Wie groß ist das nutzbare Kontextfenster statt der beworbenen 1M?
QwenCloud dokumentiert 991,808 Input-Tokens ohne Thinking und 983,616 mit Thinking, 131,072 Output-Tokens bei deaktiviertem Thinking sowie 262,144 kombiniert. Tencent nennt für Hy4 Flash 1M Kontext. Eine Sicherheitsreserve ist sinnvoll.
Ist Qwen4-Max oder Hy4 Flash pro erledigter Agentenaufgabe günstiger?
Pro Versuch ist Hy4 Flash ungefähr 20x günstiger. Tencent gibt für Hy4 Flash ein Zwanzigstel der Kosten des vollständigen Hy4 pro Aufgabe und bei Spitzenpreisen ein Achtel von DeepSeek-V4.1-Flash-1017 an (Tencent). In der obigen Beispielrechnung bleibt es pro erwartetem Erfolg ungefähr 8x günstiger. Qwen4-Max kann sich jedoch lohnen, wenn weniger Fehlschläge und Reparaturen den höheren Tokenpreis überwiegen.