Die Qwen4-Max-API ist jetzt regulär per Pay-as-you-go nutzbar und nicht mehr auf eine Token-Plan-Vorschau beschränkt. Der Preis liegt bei $1.50 für Eingaben und $4.50 für Ausgaben je 1M Tokens, das Kontextfenster umfasst 1M Tokens. Wer jetzt integriert, sollte auf qwen4-max setzen: qwen4-max-preview wird am 25. November 2026 abgeschaltet.
Qwen4-Max API im Überblick: seit dem 16. November 2026 verfügbar
Alibaba hat Qwen4-Max am 16. November 2026 auf Alibaba Cloud Model Studio allgemein freigegeben. Das Modell ist dort als qwen4-max verfügbar; vorausgegangen war eine Vorschau, die ab dem 11. November ausschließlich im Token Plan lief. @Alibaba_Qwen kündigte die neue MoE-Architektur mit nativer Bildverarbeitung und einem Kontextfenster von 1M Tokens an. Die API ist auf QwenCloud bereits aktiv. Für internationale Zugriffe verweisen die QwenCloud-Dokumente auf Model Studio – verwendet wird der für die jeweilige Region passende Model-Studio-Endpunkt (QwenCloud-Dokumentation).
| Punkt | Qwen4-Max (qwen4-max) |
|---|---|
| Status | Seit dem 16. November 2026 allgemein verfügbar; die Vorschau qwen4-max-preview läuft vom 11. bis 25. November 2026 und wird danach eingestellt |
| Eingabe / Ausgabe | $1.50 / $4.50 je 1M Tokens (Singapur, international) |
| Cache-Lesen | $0.075 je 1M Tokens |
| Weitere Regionen | $1.413 / $4.24 je 1M Tokens in den USA (Virginia), Frankfurt, Tokio und Hongkong |
| Kontext | 1M Tokens; maximale Eingabe laut Angabe 991K Tokens |
| Maximale Ausgabe | 131,072 Tokens ohne Thinking; 262,144 Tokens für Thinking plus Antwort |
| Eingabeformate | Text, Bilder, Video |
| API-Stil | OpenAI- und Anthropic-kompatibel; Tool Calling, strukturiertes JSON, Websuche, Caching, Batch und Fine-Tuning |
| Regionen | Singapur, USA (Virginia), Frankfurt, Tokio, Hongkong und Peking; Batch-Jobs nur in Peking |
| Testzugang | Neue Konten in Singapur erhalten 1M kostenlose Tokens für 90 Tage |
Die genannten Preise und Limits stammen aus der Dokumentation von Alibaba Cloud Model Studio, Stand 16. November 2026 (Preise und QwenCloud-Dokumentation). Ein Beispiel: 100K Eingabe- plus 10K Ausgabetokens kosten in Singapur ungefähr $0.15 + $0.045 = $0.195.
Was sich gegenüber Qwen3.8-Max tatsächlich geändert hat
Nach Angaben von Qwen, die sich auf Zahlen von Artificial Analysis beziehen, erreicht Qwen4-Max im Intelligence Index 43 Punkte. Damit liegt es 9 Punkte über Qwen3.8-Max (xhigh) und 3 Punkte unter Kimi K3.1 Pro. Die durchschnittlichen Kosten pro Aufgabe betragen $3.27 – ungefähr ein Drittel der Kosten von Qwen3.8-Max. Gleichzeitig fallen 39% weniger Ausgabetokens an.
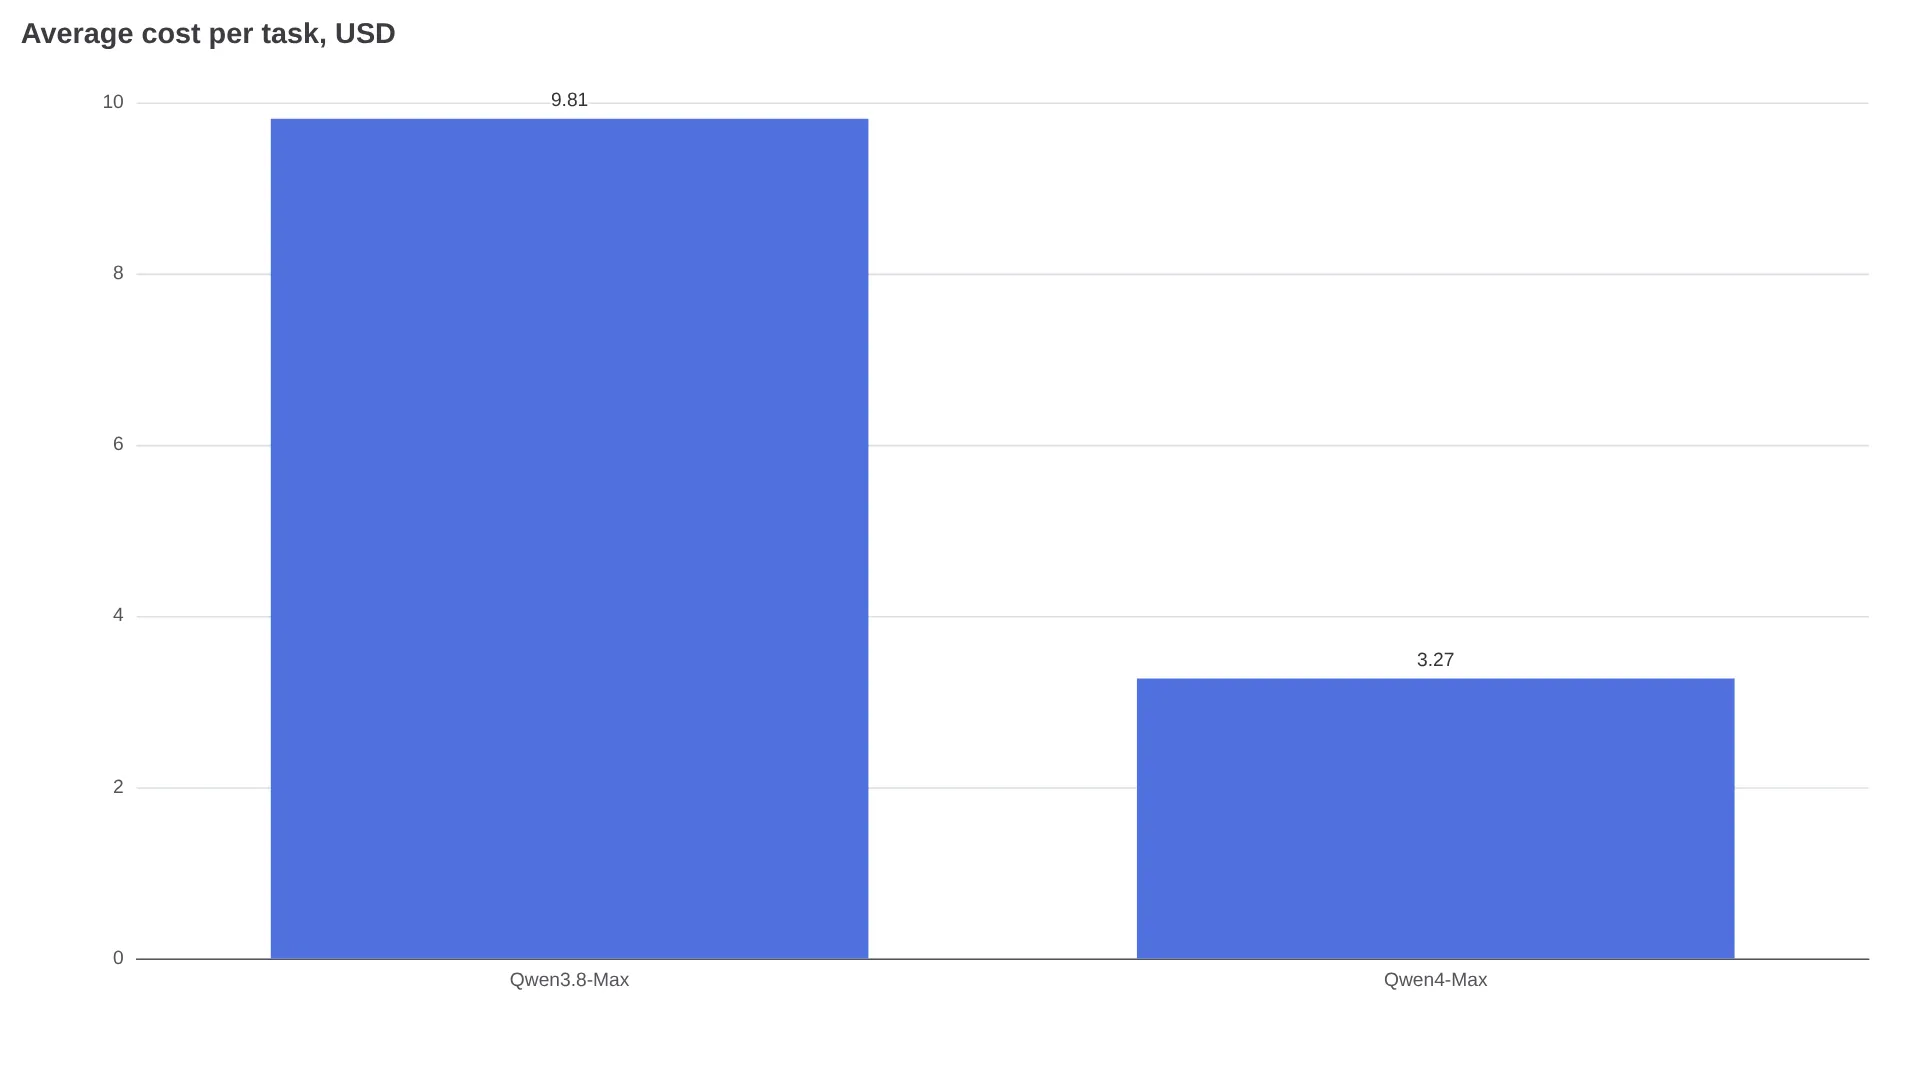
Die Einsparungen kommen aus zwei Richtungen: dem Tokenpreis aus der Tabelle oben und dem geringeren Tokenverbrauch pro Aufgabe, der in Qwens interner Auswertung bis zu etwa 50% niedriger lag. Besonders stark macht sich das bei einem 1M-Token-Durchlauf mit wiederverwendetem Cache bemerkbar, denn implizite Cache-Lesezugriffe kosten $0.075 je 1M Tokens und sind laut Angabe 70% günstiger als beim Cache von Qwen3.8-Max.
Technisch basiert Qwen4-Max auf einem nativen Vision-MoE-Backbone mit insgesamt 2.4T Parametern, davon 71B aktiv, sowie einem 328B-N-gram-Embedding. Während Qwens Blog die Werte von Artificial Analysis nennt, weisen AI First Look und AICoder darauf hin, dass vollständige Benchmarktabellen und öffentliche Einträge in der AA-Rangliste am 16. November noch nicht verfügbar waren.
Weiterführend zum Vorgänger: Qwen3.8-Max API-Preise und Qwen3.8-Max vs. Kimi K3.
Technische Limits, die direkt auf die Rechnung schlagen
Drei Begrenzungen sind wichtiger als die große 1M-Angabe.
Kontextfenster und tatsächlich nutzbare Eingabe. Das Fenster umfasst 1M Tokens, QwenCloud nennt als maximale Eingabe jedoch 991K Tokens. Für die Praxis sollte man einen Sicherheitspuffer einplanen und bei retrieval-lastigen Anwendungen testen, wie zuverlässig Informationen aus der Mitte des Kontexts wiedergefunden werden.
Ausgabe und Thinking teilen sich das Budget. Ohne Thinking liegt die maximale Ausgabe bei 131,072 Tokens. Ist Thinking aktiviert, teilen sich Denkprozess und Antwort ein Budget von 262,144 Tokens. Aufwendiges Reasoning lässt dadurch weniger Platz für die eigentliche Antwort. In der Vorschau waren es laut XenoSpectrums Übersicht zu den Vorschau-Limits noch 393,216 Tokens für Thinking und Antwort zusammen. Vorschauwerte sollten daher nicht fest in Produktionscode übernommen werden.
Die Thinking-Standards wurden geändert. Thinking ist standardmäßig aktiviert. Das GA-Modell verwendet standardmäßig high; zusätzlich stehen low und xhigh zur Verfügung. In der Vorschau war laut der Spezifikationstabelle von AI First Look xhigh voreingestellt. Wenn die Latenz zu hoch ausfällt, ist low bei reasoning_effort der erste sinnvolle Test.
Bei multimodalen Eingaben werden Text, Bilder und Video unterstützt. Für Video galten in der Vorschau laut XenoSpectrums Übersicht zu den Vorschau-Limits Obergrenzen von 2 Stunden, 2 GB und 64 Videos pro Anfrage. Das sind Einreichungsgrenzen, keine Garantie für zuverlässiges Verständnis. Wie gut lange Videos verarbeitet werden, sollte man mit eigenen Dateien prüfen.
Für eine bessere Kostenkontrolle helfen strukturiertes JSON, um ausufernde Antworten zu begrenzen, sowie die Wiederverwendung langer Kontexte über Cache-Lesezugriffe ($0.075 je 1M Tokens in Singapur). In den Launch-Notizen von AICoder wird außerdem eine explizite Cache-Erstellung für fünf Minuten mit $1.875 je 1M Tokens genannt, sofern diese Funktion unterstützt wird.
Qwen4-Max mit dem OpenAI-SDK ansprechen
Model Studio unterstützt laut der Modelldokumentation von Alibaba Cloud die Formate OpenAI Chat Completions, Responses und Anthropic Messages API. Für Pay-as-you-go-Backends wird qwen4-max verwendet; qwen4-max-preview ist auf den Token Plan beschränkt.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("QWEN_API_KEY"),
    # Singapore/international endpoint:
    base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1",
    # China/Beijing endpoint: https://dashscope.aliyuncs.com/compatible-mode/v1
)

resp = client.chat.completions.create(
    model="qwen4-max",
    messages=[
        {"role": "user", "content": "Summarize this release in 3 bullets."}
    ],
    extra_body={"reasoning_effort": "high"},
)
print(resp.choices[0].message.content)
API-Schlüssel und Endpunkt müssen zur selben Model-Studio-Region gehören. Für strukturierte Antworten kann response_format={"type": "json_object"} oder – sofern unterstützt – ein JSON-Schema angefordert werden. Große strukturierte Ausgaben sollten anschließend validiert werden.
Pay-as-you-go, Token Plan oder Chat-App: Welcher Weg passt?
| Weg | Geeignet für | Wichtige Einschränkung |
|---|---|---|
Model Studio Pay-as-you-go (qwen4-max) | Apps, Backends und Batch-Verarbeitung | Abrechnung nach Tokens; Region, Endpunkt und API-Schlüssel prüfen |
Token Plan (qwen4-max-preview) | Interaktives Programmieren in Claude Code, Cline, Cursor und OpenCode | Nur interaktive Nutzung; keine Produktionsautomatisierung, Batch-Skripte oder Einbettung in Backends; nur Region Singapur; endet am 25. November 2026 um 24:00 UTC+8 |
| Qwen Chat, QwenWork, QwenStudio und Qoder | Prompts ausprobieren, Dokumente bearbeiten und agentische IDEs testen, ohne API-Schlüssel einzubinden | Verfügbarkeit und Credit-Tarife werden in der App angezeigt; kein API-Vertrag |
Der Token Plan ist ein monatliches Credit-Kontingent für interaktive Entwicklung. Die Übersicht von Apidog zum Token Plan nennt einzelne Stufen: von Lite für $3 Eventpreis / $8 Listenpreis mit 20,000 Credits bis Pro für $43 Eventpreis / $51 Listenpreis mit 200,000 Credits. Die Schlüssel beginnen mit sb-sp-. Das Teilen von Schlüsseln, Hintergrundjobs oder die Einbettung des Schlüssels in ein ausgeliefertes Backend verstößt gegen die Nutzungsbedingungen. Für erste Prompt-Tests nennen Apidog und XenoSpectrum Qwen Chat, QwenWork, QwenStudio und Qoder als mögliche Wege. Die Verfügbarkeit wird in der App angezeigt und kann je nach Konto variieren.
Vor dem 25. November 2026 migrieren:
- Die Modellzeichenfolge von
qwen4-max-previewaufqwen4-maxändern. - Von Token-Plan-Endpunkt und -Schlüssel auf einen Pay-as-you-go-Schlüssel von Model Studio samt regionalem Endpunkt wechseln.
- Die Thinking-Standards erneut testen (
xhighzuhigh). - Die Ausgabebudgets neu messen (393K gemeinsames Vorschau-Limit gegenüber 131K/262K bei der GA-Version).
Erste Erfahrungen: schnelle Greenfield-Projekte, durchwachsene Agenten
Kleine, von AI First Look gesammelte Tests berichten von funktionierenden Builds aus einem einzigen Prompt. In einem Beispiel wurden 20 von 20 versteckten Tests in etwa 2.5 Minuten bestanden, verglichen mit 17 Minuten bei Qwen3.8-Max. Dieselbe Zusammenfassung nennt allerdings auch einen Spieletest, in dem Qwen4-Max zwar schneller fertig war, insgesamt aber nur auf Platz zwei landete.
Beim Versuch, Code zu generieren, bekomme ich ständig diese Fehler.
— @bijanbowen, Beitrag (erster Eindruck eines echten Nutzers, 16. November 2026; Screenshot mit wiederholten Fehlern bei der Codegenerierung)
Eine frühe Zusammenfassung chinesischsprachiger Tests (@weconomypistis) bezeichnete den Preis und die Kosten pro Aufgabe als größten Vorteil. Bei Terminal- und Agentenaufgaben lag Qwen4-Max demnach jedoch einen Schritt hinter Kimi, mit langsameren Antworten.
FAQ
Ist Qwen4-Max ein Open-Weight-Modell?
Nein. Qwen4-Max wird ausschließlich gehostet; bis zum 16. November wurden keine Gewichte angekündigt, wie der Tracker von AI First Look festhält. Qwen zufolge sollen kleinere Qwen4-Modelle später mit offenen Gewichten erscheinen, wie aus der Ankündigung von Qwen4-Max hervorgeht. Ein Termin, konkrete Größen oder eine Lizenz wurden bislang nicht genannt.