 AIREITER
Auf dem Papier kosten beide Decision-Endpunkte $0.10 pro 1 Mio. Eingabe-Token. In der Praxis kann dasselbe wiederverwendete Richtliniendokument bei der einen API $520 und bei der anderen nur $70 kosten. Die OpenAI Decisions API ist auf Agentenprotokolle mit wiederholtem Kontext zugeschnitten, während die Gemini Decisions API ihre Stärken bei Audio, Video und Checklisten mit bis zu 1.000 Regeln ausspielt.
Gleicher Preisaufkleber, andere Rechnung
Die OpenAI Decisions API und die Gemini Decisions API berechnen jeweils $0.10 pro 1 Mio. nicht gecachter Eingabe-Token. Für Ausgabe-Token fallen bei beiden keine Kosten an. Die OpenAI Decisions API ist seit dem 22. Oktober 2026 mit dem Modell gpt-6-luna allgemein verfügbar. Die Gemini Decisions API startete am 11. November 2026 in v1beta mit dem Modell gemini-decision-1. Welche API günstiger ist, hängt daher von der Wiederholung und dem Format der Eingaben ab – nicht vom Logo.
| Kriterium | OpenAI Decisions API | Gemini Decisions API |
|---|---|---|
| Modell | gpt-6-luna | gemini-decision-1 |
| Status | GA seit 22. Okt. 2026 (OpenAI-Dokumentation) | Preview v1beta seit 11. Nov. 2026 (Google-Ankündigung) |
| Fragen pro Anfrage | 1–400 (OpenAI-Dokumentation) | 1–1.000 (Google-Ankündigung) |
| Kontextfenster | Long-Context-Multiplikator 2x oberhalb von 272K Token | 262.144 Token |
| Eingaben | Text, Bilder, input_json, Konversationen und Tool-Aufrufe | Text, Bilder, Audio, Video, PDF |
| Ausgabegebühr | $0 | $0 |
| Gecachte Eingaben | $0.01 pro 1 Mio. Token, Präfix ≥1.024 Token | Nicht unterstützt |
| Kostenloses Kontingent | Kein separates kostenloses Kontingent angegeben | Ja, in AI Studio: 200 RPM / 50K TPM / 10K RPD |
| Veröffentlichte Latenz | Etwa 10x schneller als die Responses API | 50–100 ms Modellberechnung, 150–250 ms Ende-zu-Ende bis 16K Token |
| Enterprise | ZDR, HIPAA, regionale Verarbeitung in USA/EU (+10%) | Cloud-Support in Kürze |
So sieht eine Anfrage tatsächlich aus
Bei OpenAI läuft die Anfrage über POST /v1/decisions und ein geordnetes Array von Fragen, die jeweils einen optionalen name tragen können. Gemini verwendet dagegen client.decisions.create() mit einer Map, deren Schlüssel vom Entwickler festgelegte IDs sind. Beide APIs kennen drei Fragetypen – die Bezeichnungen und Grenzen unterscheiden sich jedoch.
OpenAI bietet predicate (Wahrscheinlichkeit von 0 bis 1), choice (ungeordnete Kategorien) und score (2–10 geordnete Stufen mit wahrscheinlichkeitsgewichteten Mittelwert), wie der OpenAI-Leitfaden beschreibt. Bei Gemini heißen die Typen noul (Ja/Nein, Wahrscheinlichkeit von 0.01 bis 0.99), choice (2–255 Optionen) und score (2–255 Stufen, empfohlen werden 2–10), laut Google-Ankündigung. Die Fragen innerhalb einer Anfrage sind bei beiden APIs unabhängig voneinander. Verkettete Logik muss der Anwendungscode oder ein zweiter API-Aufruf übernehmen.
Drei Stolperfallen beim Portieren
Gemini sortiert die Schlüssel von choice vor der Bewertung alphabetisch. Eine Sammeloption namens none_of_the_above kann deshalb vor shipping landen (dokumentiertes Verhalten). OpenAI übernimmt den Fragnamen in das Antwort-Array, Gemini liefert dagegen eine Map mit der jeweiligen Frage-ID als Schlüssel. noul von Gemini gibt niemals einen Wert über 0.99 zurück – ein Schwellwert von >0.99 kann also nie ausgelöst werden.
Auch bei Ablehnungen verhalten sich die APIs unterschiedlich. OpenAI kann für eine einzelne Frage ein refusal zurückgeben und die übrigen Fragen trotzdem beantworten, wie der OpenAI-Leitfaden erklärt. Gemini weist bei Sicherheits- oder Inhalten-Triggern dagegen die komplette Anfrage mit HTTP 400 zurück, etwa mit den Codes safety und prohibited_content.
„Eine merkwürdige Sache ist, dass Decisions und die normale Textgenerierung offenbar getrennte Caching- und Inferenzpfade verwenden.“ — u/Balance- auf r/OpenAI
Wenn du beide Endpunkte unterstützen musst, solltest du eine schlanke Adapter-Schicht einplanen. Vereinheitliche die Frage-IDs, benenne Gemini-Schlüssel so um, dass alphabetische Gleichstände keine Überraschungen verursachen, und begrenze Gemini-Schwellwerte auf ≤0.99.
Welche Eingaben die APIs akzeptieren – und was du selbst bauen musst
Die Gemini Decisions API verarbeitet Text, Bilder, Audio, Video und PDFs nativ in einer gemeinsamen Eingabe. Die OpenAI Decisions API unterstützt Text, Bilder, input_json, Konversationsverläufe, Funktionsaufrufe und Tool-Ausgaben, aber keine Dateien oder Audiodaten. Genau diese Lücke entscheidet darüber, ob Vorverarbeitung entfällt oder zusätzlich gebaut werden muss.
Eine Gesprächsaufzeichnung zusammen mit Kontometadaten kann direkt an Gemini gehen – ohne vorherige Transkription. Gleiches gilt für ein gescanntes Schadens-PDF samt Fotos. Ein Agentenprotokoll mit Tool-Aufrufen passt dagegen nativ zu OpenAI, inklusive passender call_id. Für Gemini muss dasselbe Protokoll zunächst in Text überführt werden. OpenAI akzeptiert außerdem Bilder innerhalb von instructions, etwa für den Abgleich von Kandidat und Referenz.
Auch bei der Abrechnung von Bild-Token gibt es Unterschiede. In einem unabhängigen Praxistest (System Design Academy) zählte ein 224×224 Pixel großes Eierfoto bei OpenAI mit drei Fragen als 523 Eingabe-Token. Bei Gemini waren es geschätzte 390 Token im Modus Low (257 Bild-Token), 663 im Modus Medium und 1.223 im Modus High – entsprechend $0.039, $0.066 und $0.122 pro 1.000 Fotos.
Die Latenzangaben stammen von den Anbietern selbst. Google nennt 150–250 ms Ende-zu-Ende und eine nahezu konstante Skalierung von 1 bis 100 Fragen bis 16K Token. OpenAI spricht von einer etwa 10-fach höheren Geschwindigkeit gegenüber der Responses API, nennt aber keinen absoluten Wert. Berichte aus der Praxis fallen gemischt aus:
„Geschwindigkeit und Kosten. Die Ausgaben kommen fast sofort und kosten nur Bruchteile.“ — u/zyeus-guy auf r/OpenAI
Gemini Decision 1 im kostenlosen Kontingent getestet: 30/30 beim Routing mit einem Median von etwa 0,24 s und deterministischen Wiederholungen. Wenn „other“ fehlte, wählte das Modell allerdings selbstbewusst die falsche Kategorie. — Praxistest auf r/GeminiAI
Behandle die Anbieterwerte als Zielmarke für eigene Tests, nicht als Produktions-SLA.
Was 1 Mio. Anfragen tatsächlich kosten
Gemeinsame Eingaben werden bei beiden APIs pro Anfrage nur einmal abgerechnet. Zusätzliche Fragen schlagen lediglich mit ihren Instruktions-Token zu Buche. Der große Unterschied entsteht bei wiederholten Eingaben über mehrere Anfragen hinweg: OpenAI cached sie, Gemini berechnet sie jedes Mal vollständig.
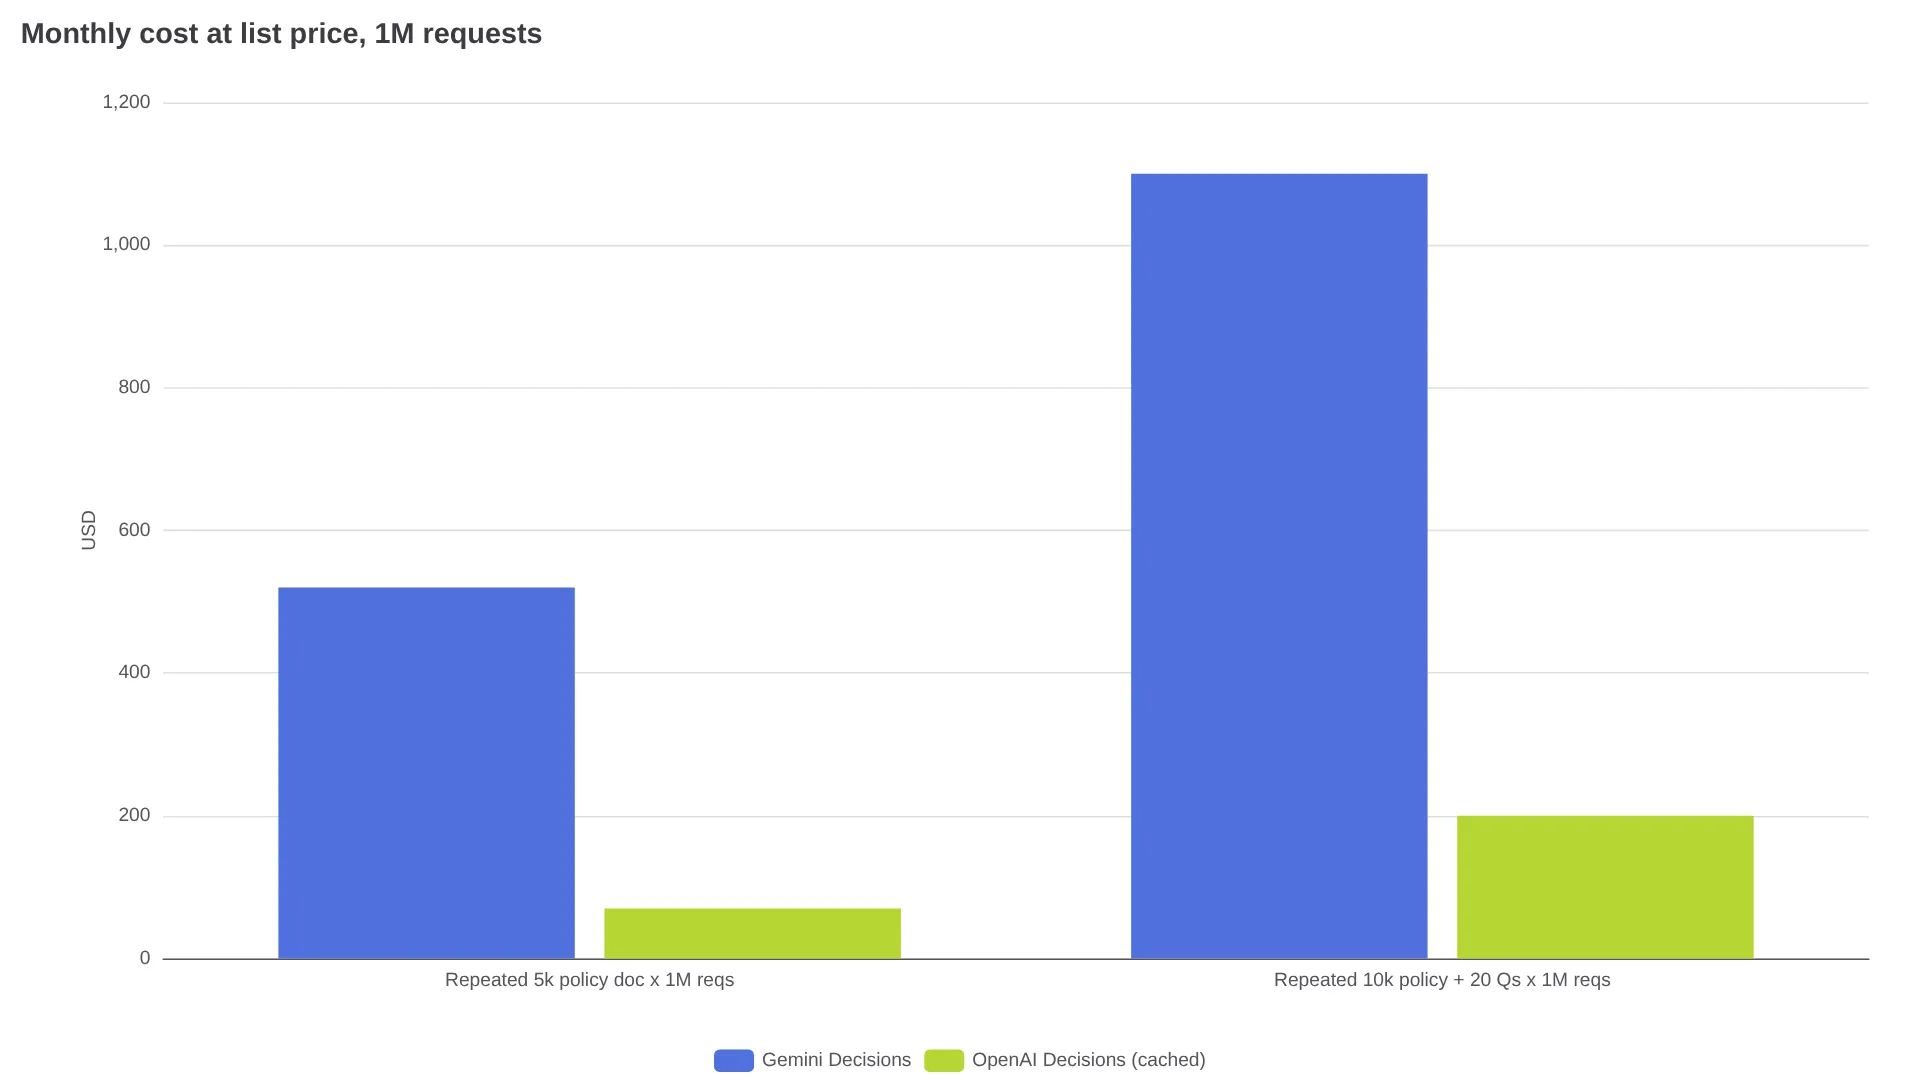
Die folgende Beispielrechnung zu Listenpreisen orientiert sich am von Apidog und BaristaLabs veröffentlichten Muster und nimmt bei OpenAI Cache-Treffer vor den Gebühren für das Schreiben in den Cache an:
- 1 Mio. Tickets mit derselben Richtlinie aus 5.000 Token plus 200 neuen Token: Gemini etwa $520, OpenAI mit Cache etwa $70.
- 1 Mio. Anfragen mit derselben Richtlinie aus 10.000 Token plus 20 Fragen mit jeweils etwa 50 Token: Gemini etwa $1,100, OpenAI mit Cache etwa $200 zuzüglich Schreibvorgänge.
Bei frischen, einzigartigen Eingaben verschwindet der Vorteil: Eine 400-Token-Nachricht ohne wiederverwendbares Präfix kostet bei beiden zum Satz von $0.10 pro 1 Mio. Token gleich viel. Wichtiger als die Modellwahl ist die Bündelung: Eine Anfrage mit 20 Prüfungen auf einem Datensatz aus 4.000 Token kostet etwa $0.50 pro 1.000 Datensätze, während 20 einzelne Anfragen etwa $8.10 kosten.
Lange Konversationen, bei denen in jeder Runde erneut gelesen wird, sprechen für Caching. Ein modellierter Router mit 30 Runden und 124.680 gelesenen Token kostet bei Gemini Decision 1 ohne Caching etwa $12.47 pro 1.000 Chats, bei einem Chat-Modell mit Cache dagegen etwa $6.31.
Wie verlässlich ist die ausgegebene Zahl?
In Googles Tabelle, zusammengefasst von AIToolsReview, liegt Decision 1 in jedem gemeinsamen Test vor Luna: Die Top-1-ECE beträgt 0.0250 gegenüber 0.0721 bei Luna und 0.0494 bei Jev 1.14. Im öffentlichen JevBench-Split erreicht Decision 1 92.2 %, Luna 90.9 % und Jev 1.14 90.0 %. Die Gesamtkosten der Testsuite lagen bei $0.88 für Decision 1, $0.68 für Jev und $0.93 für Luna.
Eine im selben Review zitierte unabhängige Auswertung von Artificial Analysis gibt Decision 1 einen Decision Index von 66 – gleichauf mit Jev 1.14 und auf Platz 9 von 18. Damit liegt das Modell etwa 7 Punkte hinter Drex Max v1.1. Bei When2Call kommt Decision 1 auf 75.2 %, Jev auf 80.8 % und Drex Max auf 94.6 %. Die Kosten liegen dort bei $345 pro 1 Mio. Aufgaben und 211 ms für Decision 1 gegenüber $156 und 92 ms für Jev.
Für Automatisierung über Schwellwerte ist die Kalibrierung wichtiger als die Schlagzeilen-Genauigkeit. Eine Konfidenz von 0.90 sollte in der späteren Einsatzverteilung ungefähr 9 von 10 Fällen richtig liegen. Bestimme Schwellwerte anhand von 200–500 gelabelten Fällen und miss die Genauigkeit nach Konfidenzintervallen.
„Konfidenz: Kalibrierte Wahrscheinlichkeiten im Jev-Stil liefert nicht jeder OpenAI-kompatible Endpunkt.“ — u/xapep auf r/LLMDevs
Zwei Fehlermuster tauchen immer wieder auf. Frühe Praxistests berichten bei OpenAI von einer Verzerrung zugunsten der ersten Auswahl (@NatashaTheRobot). Der oben genannte Gemini-Test zeigt außerdem, dass bei einer fehlenden Sammeloption die am wenigsten falsche Kategorie gewählt wird, statt sich zu enthalten. Abhilfe schaffen eine other-Option, ein separates predicate zur Prüfung des Gültigkeitsbereichs, kurze und klar unterscheidbare Beschreibungen sowie eine manuelle Prüfung unterhalb des Schwellwerts.
Produktions-Checkliste vor dem Start
OpenAI ist mit Caching, Nutzungsreporting über GET /v1/organization/usage/decisions, ZDR und HIPAA für berechtigte Kunden allgemein verfügbar. Regionale Verarbeitung in den USA und der EU gibt es mit einem Aufschlag von 10 %. Gemini befindet sich in v1beta; Cloud-Support soll folgen. Beide Anbieter nennen Framework-Integrationen wie OpenRouter, LangChain, Vercel und LiteLLM.
Die Caching-Regeln beeinflussen die Architektur. OpenAI verwendet ein Präfix gemeinsamer Eingaben ab 1.024 Token wieder; der Inhalt der Fragen zählt nicht zu diesem Mindestwert. Gemini bietet weder Context Caching noch Batch-, Flex- oder Priority-Tarife. Für Prototypen ist das kostenlose Kontingent von Gemini attraktiv. Inhalte aus dem kostenlosen Kontingent können jedoch zur Verbesserung von Google-Produkten verwendet werden. Echte Kundendaten gehören daher auf kostenpflichtige Schlüssel. Bevor du kritische Aktionen automatisierst, solltest du die Konfidenzverteilungen eine Woche lang protokollieren.
Die Wahl hängt vom Workload ab, nicht vom Logo
Ein Agenten-Loop mit Tool-Aufrufen und wiederholten Instruktionen spricht für die OpenAI Decisions API. Das gilt ebenso bei Anforderungen an ZDR, HIPAA oder eine Verarbeitung in der EU.
Eine Gesprächsaufzeichnung, ein Videoclip oder ein gescanntes PDF mit Hunderten von Prüfungen passt besser zur Gemini Decisions API. Native Audio-, Video- und PDF-Verarbeitung spart Transkription und OCR, während bis zu 1.000 Fragen pro Anfrage auch Regelwerke mit mehr als 400 Punkten abdeckt. Für das Budget gelten dabei die Grenzen: 100 MB inline pro Anfrage, 50 MB pro PDF und 15 MB pro externer URL.
Bei kurzen, einzigartigen Texten mit weniger als 400 Fragen herrscht beim Listenpreis Gleichstand. Prototypen lassen sich mit synthetischen Daten im kostenlosen Gemini-Kontingent umsetzen. Danach solltest du dieselben 200–500 gelabelten Fälle mit beiden APIs testen und Genauigkeit nach Konfidenzband, p50/p95-Latenz, Token pro Anfrage und monatlichen Kosten vergleichen.
| Workload | Empfehlung |
|---|---|
| Wiederverwendetes Richtliniendokument mit 5K–10K Token, hohe QPS | OpenAI Decisions API, Caching spart 80 %+ |
| Agenten-Routing mit Tool-Call-Verlauf, GPT-Live-Voice | OpenAI Decisions API |
| Entscheidungen aus Audio / Video / PDF, >400 Regeln | Gemini Decisions API |
| Kurzer einzigartiger Text, <400 Fragen | Gleichstand – vorhandenen Stack wählen |
| Kostenlose Prototypen | Gemini AI Studio, anschließend mit kostenpflichtigem Zugang neu bewerten |
Ist Gemini günstiger als OpenAI?
Beim Listenpreis herrscht mit $0.10 pro 1 Mio. Token und ohne Ausgabegebühr Gleichstand. OpenAI ist bei wiederholtem, gecachtem Kontext im Vorteil, Gemini beim kostenlosen Prototyping.
Kann OpenAI Audio, Video oder PDFs lesen?
Nein. OpenAI unterstützt nur Text, Bilder, JSON und Konversationen mit Tool-Aufrufen. Gemini verarbeitet Audio, Video und PDFs nativ.
Wie viele Fragen sind pro Anfrage möglich?
Gemini unterstützt 1–1.000 Fragen innerhalb von 262.144 Token, OpenAI 1–400.
Ist Gemini bereit für den Produktionseinsatz?
Gemini läuft in v1beta, der Cloud-Support steht noch aus. OpenAI ist allgemein verfügbar und bietet ZDR, HIPAA sowie regionale Verarbeitung.
Brauche ich Jev oder einen lokalen Klassifikator weiterhin?
Jev nennt $0.042 pro 1 Mio. Token und führt einige Tests zur Tool-Auswahl an. Wenn die Kosten pro Aufgabe entscheidend sind, solltest du Jev mitbenchmarken.
Wie sollte ich mit niedriger Konfidenz umgehen?
Leite Schwellwerte aus gelabelten Daten ab, führe Aktionen oberhalb des Schwellwerts automatisch aus, übergib den mittleren Bereich an ein größeres Modell und leite Fälle darunter zur manuellen Prüfung weiter – immer mit einer other-Option.
Weiterführende Artikel: