 AIREITER
Google hat die Gemini Decisions API am 11. November 2026 veröffentlicht. Gemini Decision 1 bewertet feste Entscheidungsoptionen in einem einzigen Durchlauf. Ob das günstiger ist als OpenAI, hängt vor allem an den Details zur Zwischenspeicherung und an deinem konkreten Workload.
Was ein Aufruf der Gemini Decisions API kostet
Die Gemini Decisions API kostet $0.10 pro 1 Million Eingabetoken; Ausgabetoken werden nicht berechnet. Der gemeinsame multimodale Input wird pro Anfrage nur einmal abgerechnet – unabhängig davon, wie viele Fragen ausgewertet werden. Jede zusätzliche Frage bringt lediglich ihre eigenen Anweisungs- und Kriterien-Token hinzu.
Google positioniert Gemini Decision 1 als über eine gemeinsame Benchmark-Suite hinweg fast fünfmal günstiger als Gemini 3.5 Flash-Lite mit der Interactions API. Es gibt keine Gebühren für Ausgabetoken, keine variablen Kosten für Thinking-Token und keine separaten Kosten für Audiotranskription oder OCR. Für Prototypen steht in Google AI Studio eine kostenlose API-Stufe bereit.
| Workload (500 insgesamt abgerechnete Eingabetoken / Anfrage) | Anfragen pro Monat | Eingabetoken | Kosten bei $0.10/1M |
|---|---|---|---|
| Routing von Support-Intentionen | 10.000 | 5M | $0.50 |
| Moderations-Gate | 100.000 | 50M | $5.00 |
| Tool-Auswahl für Agenten | 1.000.000 | 500M | $50.00 |
Die Formel lautet requests x average billed input tokens / 1,000,000 x $0.10. Weil die gemeinsamen Belege nur einmal abgerechnet werden, kannst du 50 unabhängige Prüfungen zu einem Ticket in eine einzige Anfrage packen; zusätzlich fallen dann nur die fragebezogenen Token an. Der Vorteil entsteht also durch das Bündeln – nicht durch einen Rabatt pro Frage.
Welche Entscheidungen Gemini Decision 1 trifft
Gemini Decision 1 (Model-ID gemini-decision-1) ist ein speziell entwickelter Klassifikator und Scorer, kein Chatmodell. Eine Anfrage kann einen gemeinsamen multimodalen Input mit bis zu 256K Token und bis zu 1.000 unabhängigen Fragen enthalten. Jede Antwort liefert Wahrscheinlichkeiten sowie einen Konfidenzwert zwischen 0 und 1.
Als Eingabe werden Text, Bilder, Audio, Video und PDFs in einem gemeinsamen Block unterstützt. Dabei kommt dasselbe Content-Block-Format wie bei der Interactions API zum Einsatz. Für Bilder und Videos lässt sich die Auflösung anpassen – wer Belege vor dem Upload auf eine kleinere Darstellung bringt, steuert damit direkt die Tokenkosten. Die drei Fragetypen lassen sich in einem Aufruf kombinieren:
| Typ | Aufbau | Ergebnis | Geeignet für |
|---|---|---|---|
noul (Ja/Nein) | Eine Bedingung mit optionalen Beschreibungen für wahr/falsch | Wahrscheinlichkeit, dass die Bedingung erfüllt ist | Richtlinienprüfungen, Erkennung verschütteter Flüssigkeiten, Relevanzfilter |
choice (Multiple Choice) | 2 bis 255 benannte Optionen mit Kriterien | Gewinner plus normalisierte Wahrscheinlichkeiten pro Kandidat | Modell-Routing, Queue-Routing, Auswahl der nächsten Aktion |
score (geordnete Rubrik) | Geordnete Stufen ab 0 | Kontinuierlicher gewichteter Score plus Wahrscheinlichkeiten pro Stufe | Schweregrad, Dringlichkeit, Lead-Qualität |
Google gibt eine mediane Model-Compute-Zeit von 50–100 ms und eine End-to-End-Latenz von 150–250 ms an. Gemessen wurde mit multimodalen Eingaben und Kontexten bis 16K Token; laut Google bleibt die Latenz zwischen 1 und 100 Fragen pro Anfrage nahezu konstant. In Benchmarks zu Agenten-Routing, Reasoning, Ranking und multimodalem Verständnis soll Gemini Decision 1 die Suite mit dem niedrigsten Kalibrierungsfehler anführen. Beide Angaben solltest du als Hersteller-Benchmarks betrachten, bis unabhängige Messungen vorliegen.
Gemini Decisions API im Vergleich zur OpenAI Decisions API
Der naheliegendste Vergleich ist OpenAIs Decisions API, die einige Wochen zuvor zum gleichen Listenpreis gestartet ist. Auch die Gemini Decisions API kostet $0.10 pro 1M Eingabetoken und berechnet typisierte Ausgaben nicht. Unterschiede gibt es bei Kapazität, unterstützten Modalitäten und Caching.
| Merkmal | Gemini Decisions API | OpenAI Decisions API |
|---|---|---|
| Modell | gemini-decision-1 | Klasse gpt-6-luna |
| Listenpreis | $0.10 / 1M Input, $0 Output | $0.10 / 1M Input, $0 Output |
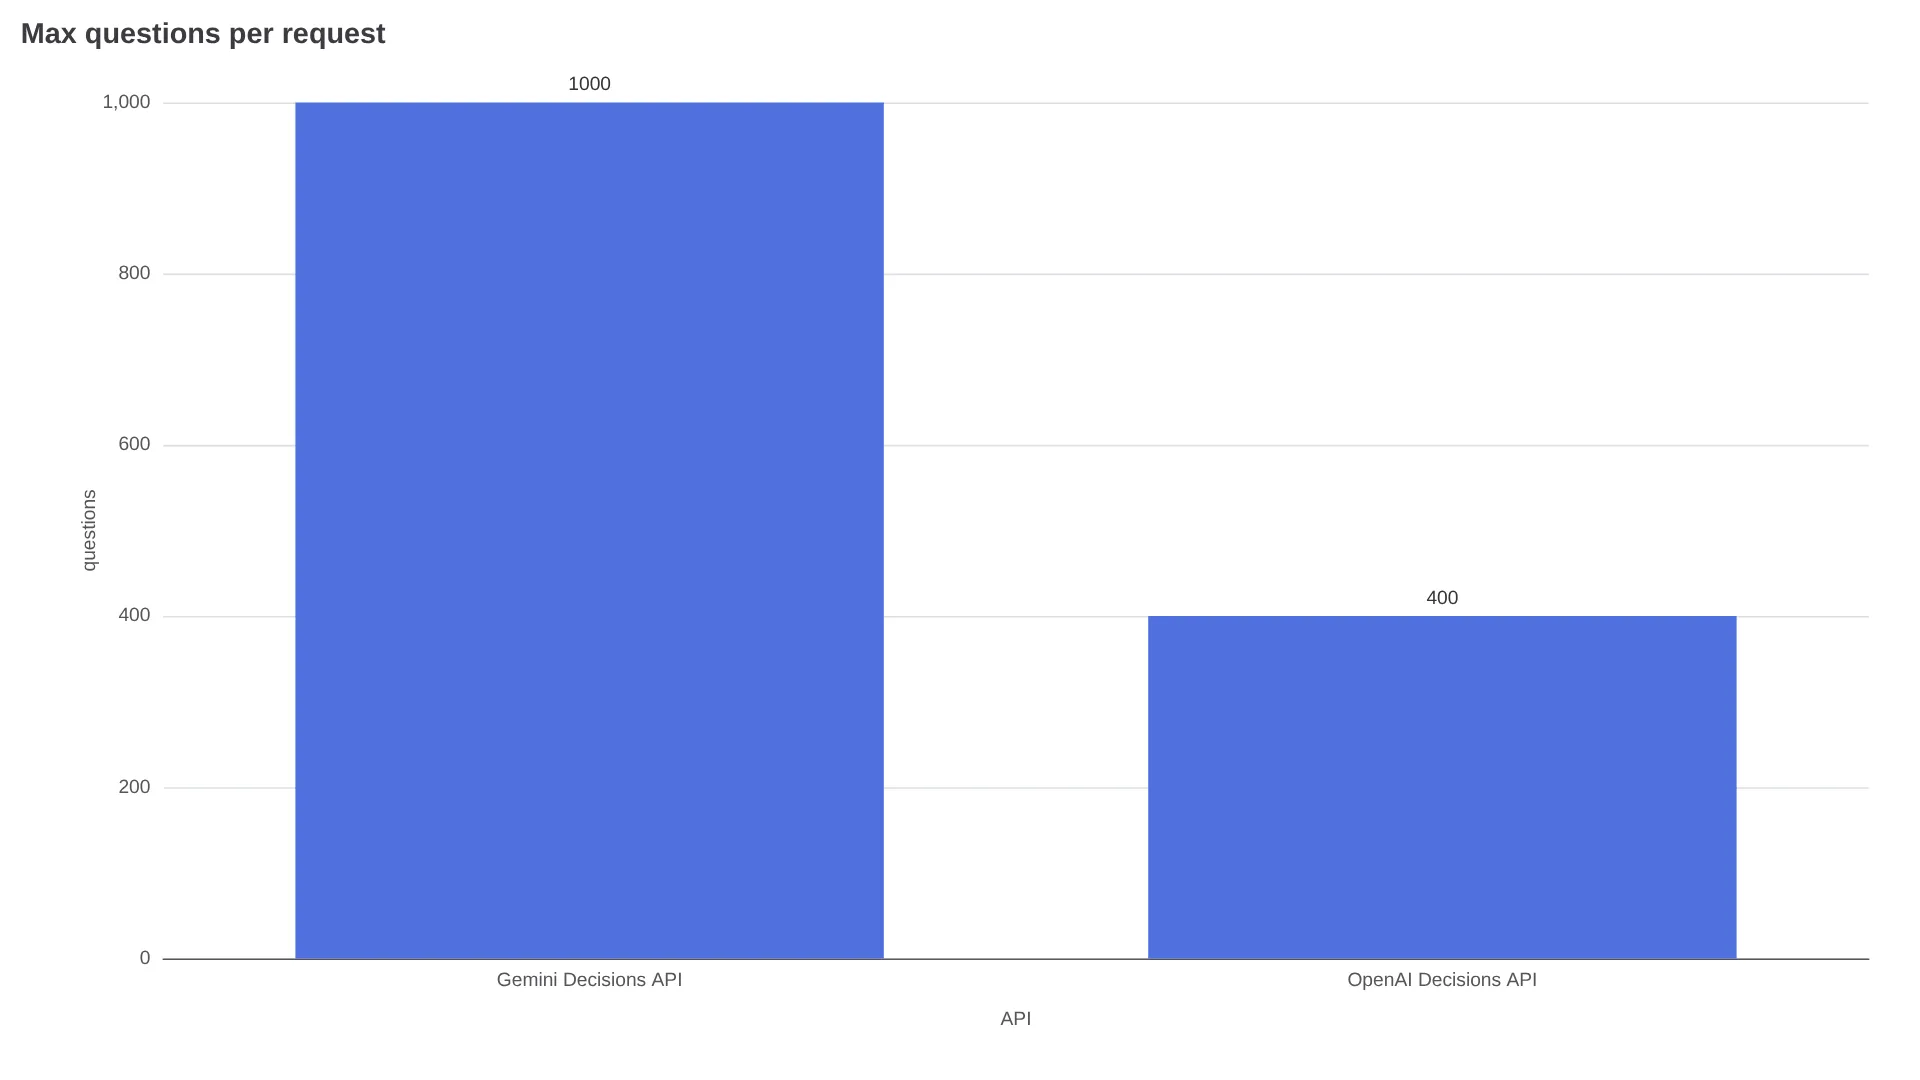
| Maximale Fragen pro Anfrage | 1.000 | 400 |
| Fragetypen | Ja/Nein, Auswahl (2–255), Rubrik-Score | Prädikat, Auswahl, Score (2–10 Stufen) |
| Eingabemodalitäten | Text, Bilder, Audio, Video, PDFs (256K Kontext) | Text, Bilder (URLs, Base64), natives JSON, Gesprächsverlauf, Tool-Ausgaben; kein Audio oder Dateien |
| Angabe zur Latenz | 150–250 ms End-to-End, 50–100 ms Model-Compute | Etwa zehnmal schneller als Responses (kein veröffentlichtes p50/p95) |
| Prompt-Caching | Im Launch-Post nicht angekündigt | Ja: mindestens 1.024 Token Präfix, $0.01/1M für gelesene Cache-Inhalte |
| Kostenlose Stufe | Ja, kostenlose Stufe in AI Studio | Keine eigene kostenlose Stufe dokumentiert |
| Nutzungsberichte | Standardnutzung der Gemini API | GET /v1/organization/usage/decisions mit Admin-Key |
Die Angaben zur Gemini-Spalte stammen aus dem Google-Launch-Post; die OpenAI-Spalte aus AIReiters Preisleitfaden zur OpenAI Decisions API, der offizielle OpenAI-Dokumentation zitiert.
Aus der Tabelle ergeben sich drei praktische Konsequenzen.
- Nutze die Gemini Decisions API, wenn deine Belege multimodal sind. Eine Gesprächsaufzeichnung zusammen mit Kontometadaten oder ein gescanntes Schadensformular mit Fotos lässt sich in einem Durchlauf verarbeiten. Beim OpenAI-Endpunkt wäre dafür in der Regel eine getrennte Vorverarbeitung nötig.
- Sie eignet sich für breite Parallelprüfungen. Mit 1.000 unabhängigen Fragen pro Anfrage statt 400 kannst du bei einem Ticket Rückerstattungsintention, Abteilungsrouting, Dringlichkeit und Dutzende Richtlinien-Prädikate ohne zweiten Roundtrip prüfen.
- OpenAI hat bei langen gemeinsamen Richtlinientexten weiterhin einen Vorteil. Gecachte Präfixe senken die Kosten auf $0.01/1M. Das ist relevant, wenn jede Anfrage ein Richtliniendokument mit 5.000 Token erneut sendet und die Fragen kurz sind.
Wo die Gemini Decisions API in der Produktion sinnvoll ist
Google setzt den Endpunkt laut Launch-Ankündigung in Notebook für Routing, in Stitch für Wireframes, in CC für Emoji-Auswahl und in Search für MCP-Sicherheit ein. Das gemeinsame Muster: ein Belegblock, viele klar begrenzte Optionen und Code, der anhand der zurückgegebenen Konfidenz weiterleitet. Genau an dieser Stelle ist allerdings Vorsicht angebracht:
„Der niedrige Preis ist nicht der entscheidende Punkt, sondern der kleinere Ausgaberaum. Konfidenz ist nicht gleich Genauigkeit. Kalibriere deshalb mit echten Geschäftsdaten und lege Schwellenwerte für die Enthaltung fest, bevor du live gehst.“ — @david1989_zhu (aus dem Chinesischen übersetzt)
Stelle aus dem echten Workload einen gelabelten Datensatz zusammen, einschließlich mehrdeutiger Fälle. Werte über verschiedene Schwellenwerte hinweg falsch-positive und falsch-negative Raten aus und gib Ergebnissen mit niedriger Konfidenz einen expliziten Weg zur Enthaltung und menschlichen Prüfung. Aufgaben außerhalb des vorgesehenen Vertrags – etwa offene Extraktion, generierte Erklärungen oder Tool-Aufrufe mit benötigten Argumenten – gehören weiterhin in die Interactions API, die Responses API oder in Function Calling.
Gemini Decision 1 aufrufen
Der Endpunkt ist über die Gemini API in Google AI Studio verfügbar. Das Modell gemini-decision-1 wird in den google-genai-SDKs über client.decisions.create angesprochen. Python-, JavaScript- und REST-Anleitungen findest du in der Dokumentation zur Decisions API. Das offizielle Beispiel mit einem Pausenraum prüft in einer einzigen Anfrage ein Foto plus Textnotiz gegen alle drei Fragetypen:
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    input=[
        {"type": "image", "uri": "https://storage.googleapis.com/generativeai-downloads/images/spill.jpg", "mime_type": "image/jpeg"},
        {"type": "text", "text": "Breakroom counter check before the 9 AM client meeting."},
    ],
    questions={
        "has_spill": {"type": "noul", "instructions": "Is there an uncleaned liquid spill on the counter?"},
        "next_action": {"type": "choice", "instructions": "Which cleanup action fits the scene?",
            "criteria": {"wipe_with_cloth": "Small counter spill with cloth nearby.",
                         "dispatch_janitorial": "Large floor hazard, broken glass, or active leak.",
                         "ready_for_meeting": "Counter is clean and ready."}},
        "severity": {"type": "score", "instructions": "Rate the severity of the counter mess.",
            "criteria": ["Clean and ready.", "Minor localized spill.", "Major spill or safety hazard."]},
    },
)
print(result)
Google nennt Integrationen mit OpenRouter, LangChain, Vercel, LiteLLM, Pydantic AI, Pipecat, LiveKit und OpenCode; Google-Cloud-Unterstützung soll bald folgen. Wer bereits den OpenAI-Endpunkt nutzt, kann pragmatisch vorgehen: Zuerst multimodale Gates und Workloads mit vielen parallelen Prüfungen migrieren, lange Richtlinien-Workloads mit geltenden Caching-Rabatten zunächst dort belassen und die Schwellenwerte anschließend komplett neu kalibrieren. Konfidenzskalen sind zwischen den Anbietern nicht direkt übertragbar.
| Dein Workload | Das solltest du verwenden |
|---|---|
| Klassifizieren, routen oder mit festen Optionen bewerten | Gemini Decisions API |
| Die Belege enthalten Audio, Video oder PDFs | Gemini Decisions API |
| Mehr als 400 unabhängige Prüfungen pro Element | Gemini Decisions API |
| Lange gemeinsame Richtlinie wird bei jedem Aufruf erneut gesendet | Zuerst gecachte Reads bei OpenAI testen |
| Erklärung, Extraktion oder Tool-Argumente erforderlich | Interactions / Responses / Function Calling |
| Zerstörerische oder Compliance-relevante Aktion | Decisions nur als Gate plus menschliche Prüfung |
Gibt es eine kostenlose Stufe für die Gemini Decisions API?
Ja, Google AI Studio bietet für Prototypen eine kostenlose Stufe.
Unterstützt die Gemini Decisions API Prompt-Caching?
Im Launch-Post wird zum 12. November 2026 keine Caching-Option genannt.
Wie viele Fragen passen in eine Anfrage an die Gemini Decisions API?
Bis zu 1.000 unabhängige Fragen zu einem gemeinsamen Input mit bis zu 256K Token.
Welche Latenz sollte ich für Produktionscode einplanen?
Plane zunächst 250 ms End-to-End ein, bis du dein eigenes regionales p95 gemessen hast.
Benötige ich die Interactions API weiterhin?
Ja – zum Erzeugen von Text, Extrahieren beliebiger Felder, Erklären von Entscheidungen oder Erstellen von Tool-Argumenten.