 AIREITER
Eine Routing-Entscheidung mit 500 Tokens kostet zum Standardtarif $0.00005. Damit ist die OpenAI Decisions API günstig genug für Prüfungen in großem Maßstab – aber nicht automatisch zuverlässig genug für folgenschwere Aktionen. Die ausgegebenen Wahrscheinlichkeiten müssen zunächst mit eigenen gelabelten Daten kalibriert werden.
Abgerechnet werden Token, nicht einzelne Aufrufe
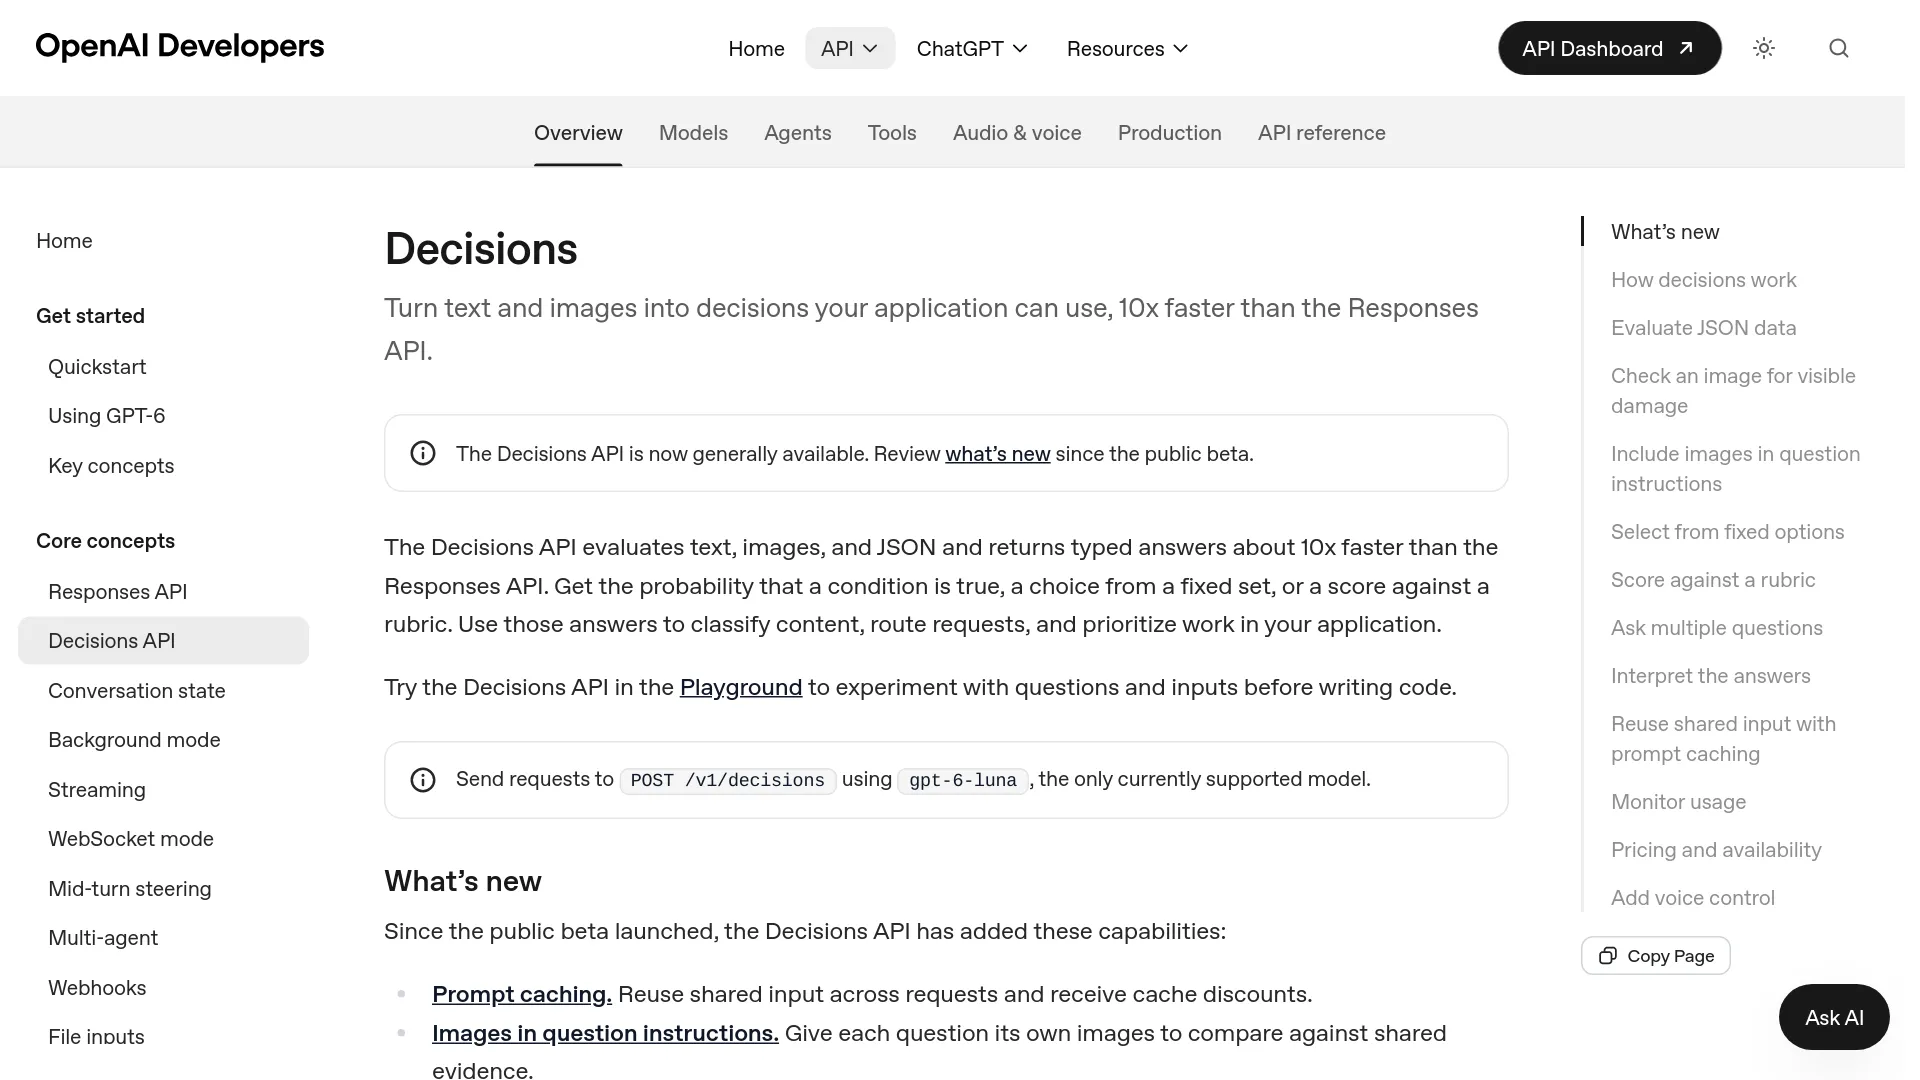
Die OpenAI Decisions API kostet $0.10 pro 1 Million nicht gecachter Input-Tokens; Output-Tokens sind kostenlos. OpenAI bezeichnet den Endpunkt inzwischen als allgemein verfügbar. Er läuft ausschließlich mit gpt-6-luna und ist unter POST /v1/decisions in der aktuellen Decisions-Dokumentation verfügbar.
In der veröffentlichten Preisliste gibt es keine zusätzliche Gebühr pro Anfrage. Die grundlegende Rechnung lautet:
monatliche Kosten = Anfragen × durchschnittlich abgerechnete Input-Tokens ÷ 1,000,000 × $0.10
Was 10.000, 100.000 und 1 Million Anfragen kosten
Bei durchschnittlich 500 Input-Tokens pro Anfrage ergibt sich folgendes Bild:
| Anfragen pro Monat | Input-Tokens | Standardkosten für Input | Kosten pro Anfrage |
|---|---|---|---|
| 10,000 | 5 Millionen | $0.50 | $0.00005 |
| 100,000 | 50 Millionen | $5.00 | $0.00005 |
| 1,000,000 | 500 Millionen | $50.00 | $0.00005 |
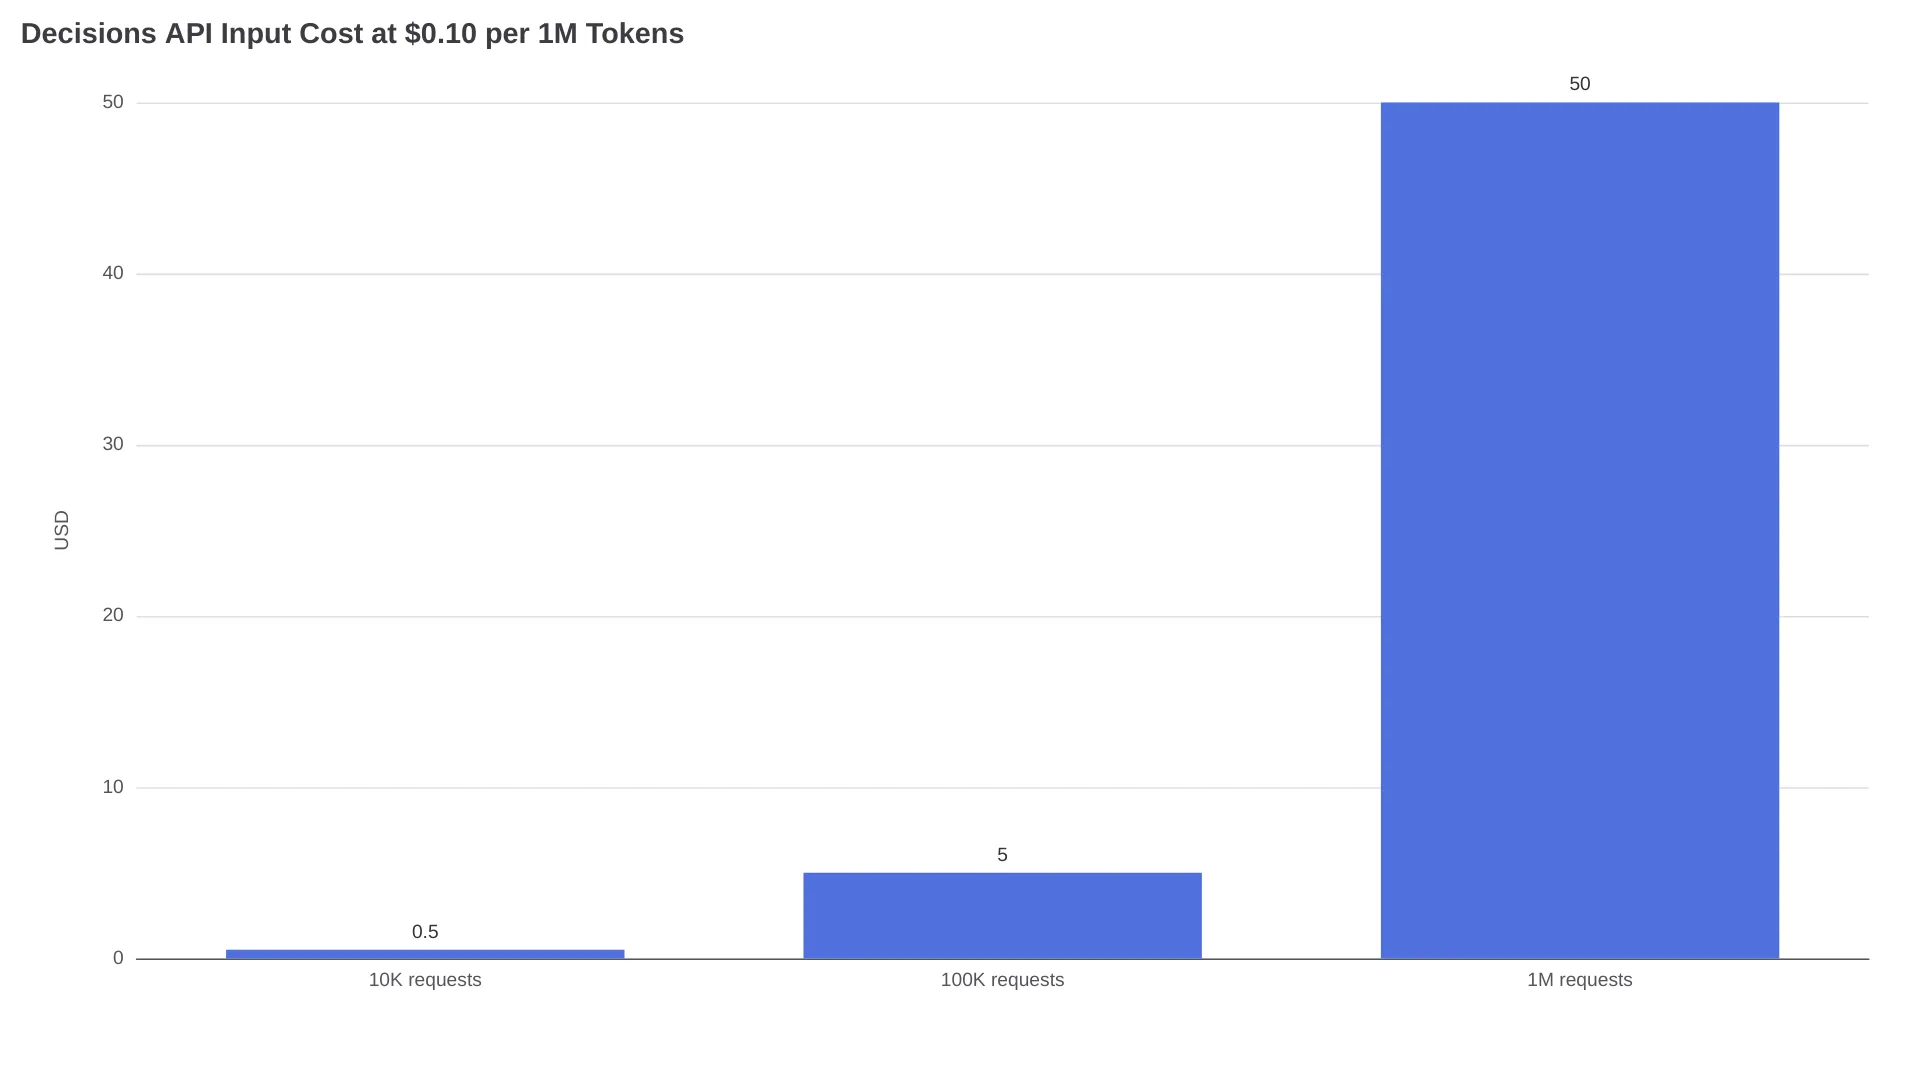
Die Ausgaben für Predicate, Choice und Score verursachen keine zusätzlichen Output-Kosten. Ein entsprechendes Responses-JSON wird erzeugt und zum Output-Tarif des Modells abgerechnet; die OpenAI-Preistabelle weist für den Standard-Output von gpt-6-luna $0.50 pro 1 Million Tokens aus.
Cache-Lesevorgänge, Schreibvorgänge, Regionen und lange Kontexte
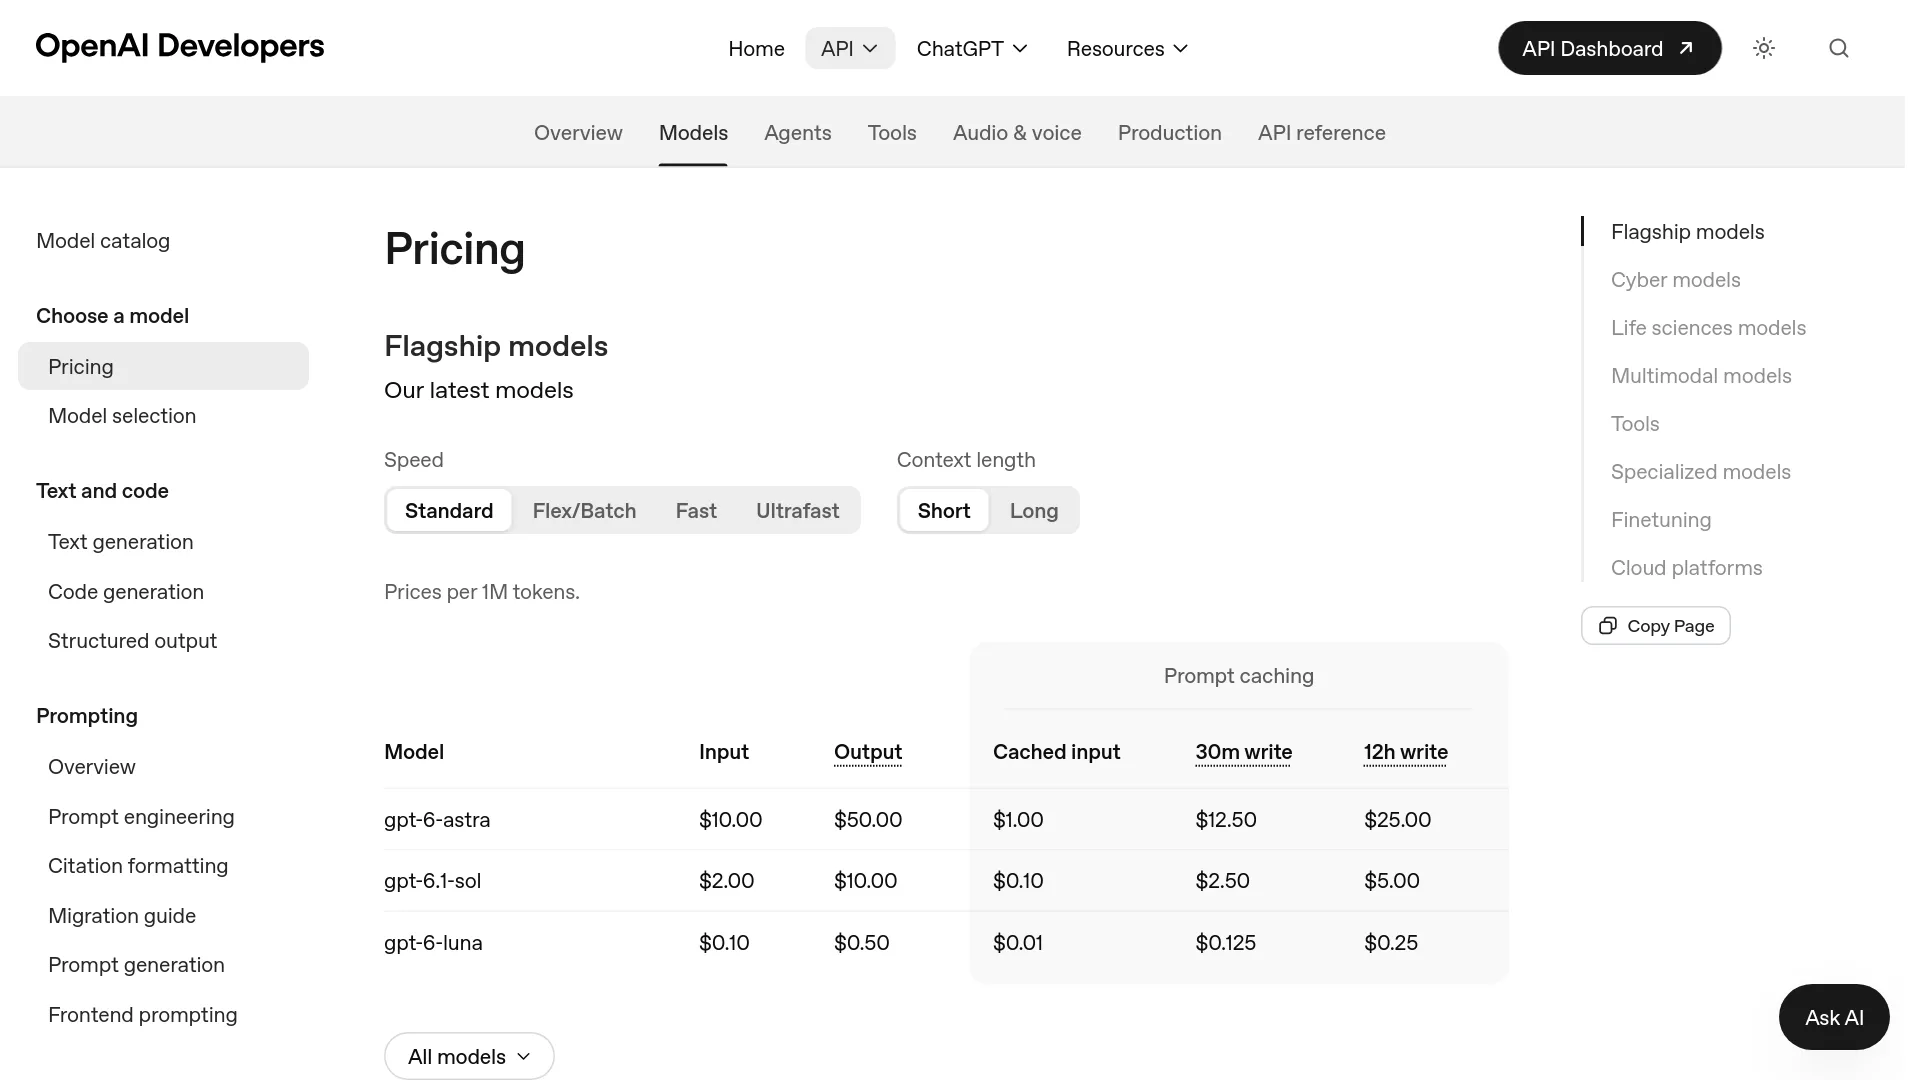
Der Schlagzeilenpreis von $0.10 ist nicht der einzige mögliche Input-Tarif. Laut aktueller Dokumentation werden Prompt-Cache-Lesevorgänge vergünstigt abgerechnet, während Cache-Schreibvorgänge den regulären gpt-6-luna-Tarifen für Cache-Write folgen. Die Preisliste nennt für gecachten Luna-Input im Standardtarif $0.01 pro 1 Million Tokens, für einen 30-Minuten-Cache-Write $0.125 und für einen 12-Stunden-Write $0.25 pro 1 Million Tokens.
Caching greift erst, wenn das wiederverwendbare gemeinsame Input-Präfix mindestens 1,024 Tokens umfasst. Die Fragen zählen nicht zu diesem Minimum; bildbezogene Inhalte einzelner Fragen liegen außerhalb des wiederverwendbaren Präfixes. Cache-Lese- und Schreibvorgänge sind laut Abschnitt zum Prompt-Caching bereits in usage.input_tokens enthalten. Wer sie erneut addiert, zählt den Verbrauch doppelt.
Regionale Endpunkte oder Endpunkte mit Datenresidenz können bei berechtigten neueren Modellen einen Aufschlag von 10% verursachen. Im offiziellen Abschnitt zu Preisen und Verfügbarkeit weist OpenAI außerdem auf mögliche Multiplikatoren für lange Kontexte hin. Wer einen Compliance-Workload plant, sollte vorab die aktuelle Preisliste prüfen – beide Faktoren können die einfache Rechnung mit $0.10 verändern.
Der Endpunkt ist bewusst eng gefasst
Die Decisions API verwandelt Informationen in eines von drei typisierten Ergebnissen. Sie ist ein Klassifizierungs- und Bewertungswerkzeug, kein günstiger Ersatz für einen allgemein einsetzbaren Response-Endpunkt.
| Art der Frage | Rückgabe | Geeignet für | Ungeeignet für |
|---|---|---|---|
predicate | Wahrscheinlichkeit von 0 bis 1 | Betrugsprüfung, Erkennung sichtbarer Schäden, Relevanzfilter | Eine schriftliche Begründung der Entscheidung |
choice | Eine vorgegebene Option, Wahrscheinlichkeiten der Optionen, Konfidenz | Weiterleitung an eine Warteschlange, Dokumentkategorie, nächste Aktion | Eine unbekannte oder dynamisch erzeugte Kategorie |
score | Gewichteter Score, Wahrscheinlichkeiten der Stufen, Konfidenz | Schweregrad, Dringlichkeit, Lead-Qualität | Das Extrahieren von Namen, Daten oder beliebigen Feldern |
Ein Score unterstützt 2 bis 10 geordnete Stufen. Eine Anfrage kann 1 bis 400 Fragen enthalten. In einer Anfrage sollten aber nur unabhängige Fragen gebündelt werden. Hängt Frage zwei von der Antwort auf Frage eins ab, empfiehlt OpenAI eine zweite Anfrage nach Erhalt der ersten Antwort.
Mehrere unabhängige Fragen können dieselben Informationen wiederverwenden. So lässt sich etwa ein Support-Ticket gleichzeitig auf Rückerstattungsabsicht prüfen, an eine Abteilung weiterleiten und nach Dringlichkeit bewerten, ohne das Ticket dreimal zu übertragen. Laut Nutzungsdokumentation zählt num_model_requests die Anfrage – nicht deren Fragen.
Was sich seit der öffentlichen Beta geändert hat
Die aktuelle Liste unter What's new ersetzt mehrere Einschränkungen aus der Startphase:
- Das Fragenlimit stieg von 200 auf 400.
- Prompt-Caching ist für gemeinsame Inputs verfügbar.
- Inputs können natives JSON, Konversationsverläufe, Function-Call-Datensätze und passende Tool-Ausgaben enthalten.
- Bilder können über öffentliche HTTP/HTTPS-URLs oder als eingebettetes Base64 übertragen werden;
file_id, Audio, Dateien und Item-Referenzen werden weiterhin nicht unterstützt. - Das Organisations-Reporting ist unter
GET /v1/organization/usage/decisionsverfügbar. Dafür ist ein Admin-Key mitapi.usage.readerforderlich; die Ergebnisse lassen sich nach Projekt, API-Key oder Modell gruppieren.
Decisions oder Responses? Der Output-Vertrag entscheidet
Die Decisions API ist die richtige Wahl, wenn der Anwendungscode das erlaubte Antwortformat bereits kennt. Die Responses API passt besser, wenn das Modell Informationen zusammenführen und formulieren muss. Soll das Modell ein Tool auswählen und seine Argumente erzeugen, ist Function Calling die passende Option.
| Anforderung | Beste Standardwahl | Grund |
|---|---|---|
| Ja/Nein-Prüfung mit Wahrscheinlichkeit | Decisions | Natives Predicate-Ergebnis; keine Kosten für generierten Output |
| Eine bekannte Route auswählen | Decisions | Liefert die Wahrscheinlichkeit jeder Option plus Konfidenz |
| Nach einer geordneten Bewertungsmatrix einstufen | Decisions | Nativer gewichteter Score und Verteilung über die Stufen |
| Beliebige JSON-Felder zurückgeben | Responses mit Structured Outputs | Decisions bietet kein eigenes JSON-Ausgabeschema |
| Begründen, warum ein Element abgelehnt wurde | Responses | Decisions erzeugt keine Erklärungen in Textform |
| Ein Tool auswählen und Argumente erzeugen | Function Calling | Decisions wählt eine Antwort, erzeugt aber keine Tool-Argumente |
Bei 100.000 Aufrufen mit jeweils 400 Input-Tokens kosten die Decisions-Inputs $4. Gibt ein gleichwertiger Responses-Aufruf jeweils 30 Output-Tokens aus, ergeben sich nach den veröffentlichten Luna-Tarifen $4 für den Input plus $1.50 für den Output – also $5.50, bevor Reasoning-Tokens hinzukommen. Entscheidend bleibt, ob die Anwendung generierte Felder oder Erklärungen benötigt.
Beide Endpunkte bieten inzwischen vergünstigte Cache-Lesevorgänge. Maßgeblich sind die Cache-Hit-Tokens aus dem Usage-Objekt der Antwort, nicht eine Schätzung anhand der Prompt-Länge.
Günstige Fehler bleiben teuer
Eine niedrige Token-Rechnung ändert nichts an den Folgen einer fälschlich genehmigten Anfrage, einer falschen Moderationsmaßnahme oder einer fehlerhaften Zahlungsweiterleitung. OpenAIs Dokumentation zur Interpretation der Antworten empfiehlt, Schwellenwerte anhand gelabelter Beispiele festzulegen und die unterschiedlichen Kosten von False Positives und False Negatives zu gewichten.
Auch in Entwicklerdiskussionen taucht dieses Problem auf. In einem produktionsnahen Reddit-Thread zu Decision APIs schrieb u/Ctbhatia:
„a gate that says skip beats one that guesses wrong.“ Quelle: u/Ctbhatia auf r/LLMDevs
Konfidenz und Wahrscheinlichkeiten der API sind Signale, keine veröffentlichte Garantie für eine kalibrierte Ausgabe. Eine Konfidenz von 0.90 sollte nicht automatisch als 90-prozentige Trefferquote verstanden werden, bevor dieser Zusammenhang nicht mit repräsentativen Daten gemessen wurde.
OpenAI gibt im offiziellen Leitfaden an, dass Decisions etwa 10-mal schneller als Responses ist. Konkrete Angaben zu p50, p95, Region, Payload-Größe oder Vergleichskonfiguration veröffentlicht das Unternehmen jedoch nicht. Wer ein Latenzbudget festlegt, sollte deshalb in der vorgesehenen Bereitstellungsregion benchmarken.
Produktionsregel: kalibrieren, Ausnahmen zulassen, dann automatisieren
- Erstelle einen gelabelten Datensatz aus dem echten Workload – einschließlich unklarer Fälle und besonders teurer Fehlentscheidungen.
- Führe dieselben Fragen über diesen Datensatz aus und erfasse bei verschiedenen Schwellenwerten die Raten für False Positives und False Negatives.
- Baue im Anwendungscode einen expliziten Ausweichpfad ein. Antworten mit niedriger Konfidenz oder widersprüchliche Ergebnisse sollten zur manuellen Prüfung gehen, statt eine Route zu erzwingen.
- Überwache Token-Verbrauch und Anfragezahlen mit
GET /v1/organization/usage/decisionsund prüfe nach dem Start stichprobenartig automatisierte Ergebnisse.
Entscheidungstabelle für den produktiven Einsatz
Die OpenAI Decisions API ist die naheliegende Standardwahl für kurze, häufige und klar begrenzte Bewertungen innerhalb eines bestehenden OpenAI-Stacks. Der Preis allein ist jedoch kein Grund für eine Migration.
| Workload | Empfehlung | Wichtigste Voraussetzung |
|---|---|---|
| Weiterleitung von Support-Anfragen oder Leads | Decisions verwenden | Kategorien sind fest definiert und gelabelte Beispiele liegen vor |
| Prüfung von Bildschäden | Decisions testen | Bildgenauigkeit benchmarken; gehostete URLs werden inzwischen unterstützt |
| Lange Richtlinie plus kurzer Einzelfall | Beide Endpunkte testen | Tatsächliche Cache-Hit-Tokens und Latenz prüfen |
| Compliance- oder destruktive Aktion | Decisions nur als Gate einsetzen | Ausweichpfad, Prüfung und asymmetrische Schwellenwerte vorsehen |
| Extraktion plus Erklärung | Responses verwenden | Ein umfassenderer Aufruf kann eine zweite Generierungsanfrage überflüssig machen |
| Tool-Auswahl mit Argumenten | Function Calling verwenden | Der Output-Vertrag entspricht direkt der auszuführenden Aktion |
| Workload in der EU oder in einem regulierten Umfeld | Decisions in Betracht ziehen | Berechtigung, Datenresidenz und regionalen Aufschlag bestätigen |
FAQ zu den Preisen der OpenAI Decisions API
Wird die Decisions API pro Anfrage oder nach Tokens abgerechnet?
Die Abrechnung erfolgt nach Input-Tokens, nicht nach der Zahl der Anfragen. Nicht gecachter Input kostet im Standardtarif derzeit $0.10 pro 1 Million Tokens; Caching sowie regionale oder auf lange Kontexte bezogene Aufschläge können den Preis verändern.
Sind Output-Tokens der Decisions API kostenlos?
Ja. Laut dem offiziellen Decisions-Leitfaden werden Output-Tokens nicht berechnet.
Gibt es ein kostenloses Kontingent?
Die aktuelle Decisions-Dokumentation von OpenAI nennt kein eigenes kostenloses Kontingent. Kontoguthaben oder vertragliche Vereinbarungen können dennoch beeinflussen, welchen Betrag eine Organisation tatsächlich zahlt.
Funktioniert Prompt-Caching mit der Decisions API?
Ja. Gemeinsame Input-Präfixe mit mindestens 1,024 Tokens können dafür infrage kommen. OpenAI setzt standardmäßig einen impliziten Breakpoint am Ende des gemeinsamen Inputs. Fragen und bildbezogene Inhalte einzelner Fragen gehören nicht zu diesem wiederverwendbaren Präfix.
Ist Decisions günstiger als die Responses API?
Bei kurzen, klar begrenzten Klassifizierungen ohne generierten Text meistens ja. Der Vorteil schrumpft, wenn Responses nur sehr wenig Output erzeugt, oder verschwindet, wenn der Workflow für Extraktion oder Erklärung einen zweiten Aufruf benötigt.
Wie viele Fragen passen in eine Anfrage?
Das aktuelle Limit liegt bei 1 bis 400 Fragen. Unabhängige Fragen können denselben Input nutzen; voneinander abhängige Fragen erfordern separate Anfragen.
Werden Bilder unterstützt und berechnet?
Ja. Decisions akzeptiert gehostete Bild-URLs über HTTP/HTTPS sowie eingebettete Base64-Bilder. Bild-Input fließt in den abgerechneten Input-Verbrauch ein. Bildreferenzen über file_id werden nicht unterstützt.
Kostet regionale Verarbeitung mehr?
Das ist möglich. Die Preisseite von OpenAI sieht für berechtigte regionale Endpunkte und Endpunkte mit Datenresidenz bei neueren Modellen einen Aufschlag von 10% vor. Vor dem Einsatz sollte der aktuelle Tarif für die Zielregion geprüft werden.