 AIREITER
Mit 2 US-Dollar pro Million Input-Tokens und 6 US-Dollar pro Million Output-Tokens ist Qwen3.8-Max jetzt allgemein verfügbar. Beim Output liegt das Modell damit mindestens um den Faktor vier unter Claude Opus 4.8, Claude Fable 5 und GPT-5.6 Sol. Der Haken steckt in der Voreinstellung: reasoning_effort steht ab Werk auf xhigh. Der angezeigte Tokenpreis und die tatsächliche Rechnung gehen deshalb schon ab der ersten Anfrage auseinander.
Die Tokenpreise von Qwen3.8-Max im Überblick
Qwen3.8-Max löst Qwen3.7-Max als Alibabas Flaggschiff ab. Das Mixture-of-Experts-Modell hat 2,4 Billionen Parameter, von denen laut Qwen-Ankündigung 95 Milliarden pro Token aktiv sind. Die folgenden Preise stammen von Alibabas Modellseite, die selbst mit „Updated: Aug 2, 2026“ datiert ist:
| Posten | Preis pro 1 Mio. Tokens |
|---|---|
| Input | 2,00 US-Dollar |
| Output | 6,00 US-Dollar |
| Input (impliziter Cache) | 0,25 US-Dollar |
| Expliziten Cache erstellen | 2,50 US-Dollar |
| Expliziten Cache lesen | 0,17 US-Dollar |
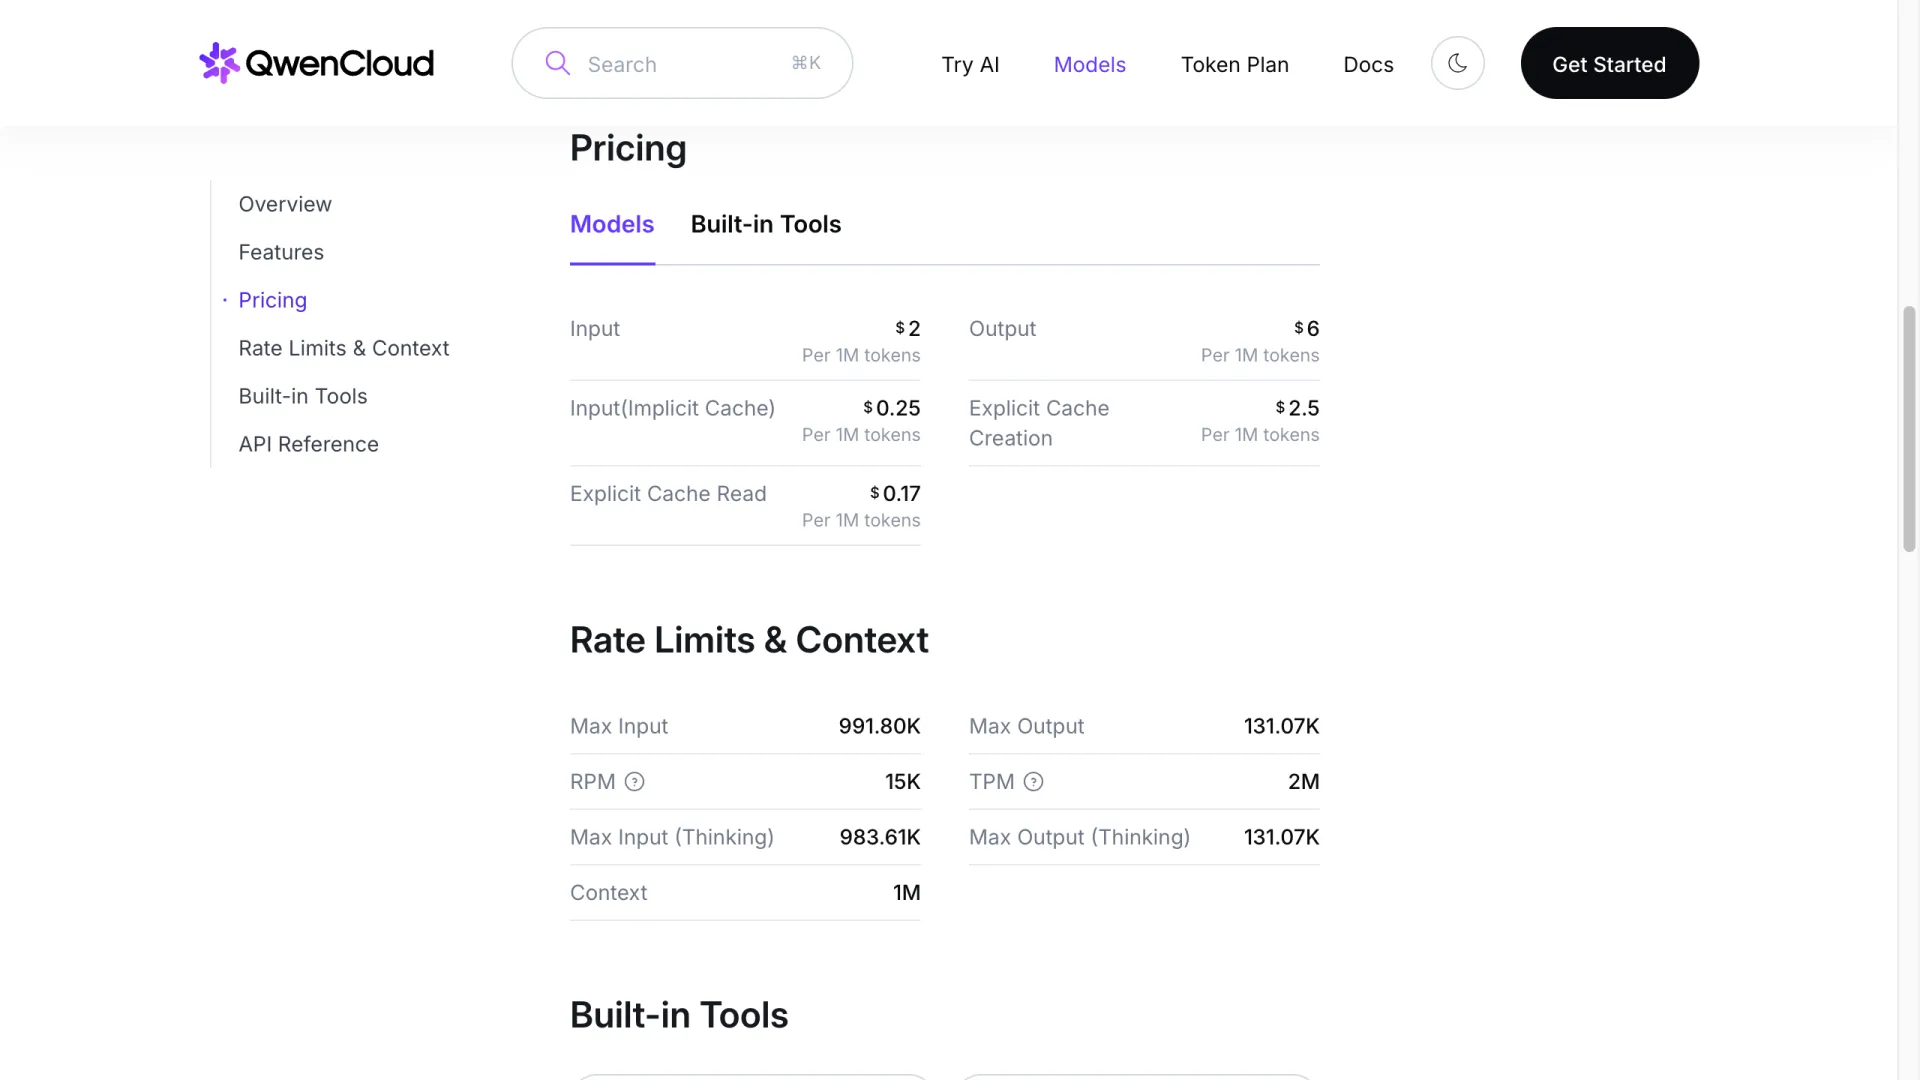
Der implizite Cache funktioniert ohne zusätzlichen Code. Wiederkehrende Präfixe werden automatisch mit 0,25 US-Dollar abgerechnet – einem Achtel des regulären Input-Preises. Beim expliziten Caching muss man sich bewusst dafür entscheiden: 2,50 US-Dollar fürs Schreiben und 0,17 US-Dollar pro Lesezugriff schlagen ungekürzten Input ab dem zweiten Lesen. Gegenüber dem impliziten Tarif lohnt es sich jedoch erst ungefähr ab dem dreißigsten Abruf desselben Präfixes. Für die meisten Anwendungen ist es daher sinnvoll, explizites Caching gar nicht erst anzufassen.
Eine Einschränkung bleibt: Die API ist offen, die Gewichte sind es nicht. Laut Alibabas Launch-Post sollen die Qwen3.8-Max-Gewichte nächste Woche auf Hugging Face und ModelScope erscheinen. Das ist nach Wochen eines undatierten „coming soon“ erstmals eine konkrete Kalenderzusage. Stand 3. August zeigt die Seitenleiste der Modellseite weiterhin Open Source: No.
Warum 6 US-Dollar für Output nicht die ganze Rechnung sind
In der Launch-Dokumentation beschreibt Alibaba drei Stufen für reasoning_effort; standardmäßig ist xhigh aktiv, die tiefste der drei. Darunter liegen medium („balances accuracy and speed“) und low („optimized for speed and cost“). Zusätzlich ist preserve_thinking in allen Szenarien standardmäßig eingeschaltet. Thinking-Tokens werden als Output-Tokens abgerechnet. Beide Defaults schieben Kosten also zum 6-US-Dollar-Tarif, bevor der erste Prompt überhaupt formuliert ist.
Die zwei wichtigsten Stellschrauben für die effektiven Kosten sind damit ab Werk ungünstig gesetzt – und beide lassen sich über einen Request-Parameter ändern. Mit medium oder low zahlt man die 6 US-Dollar pro Million nicht pauschal für tiefes Nachdenken, das eine Aufgabe womöglich nicht braucht, sondern gezielt dort, wo es sich lohnt.
Ein früher Tester fasste seinen Eindruck im Titel eines r/LocalLLaMA-Threads unverblümt zusammen:
Qwen 3.8 max first impressions - model is moderate and it is awful on thinking
Das ist kein Benchmark-Ergebnis. Es ist aber ein guter Grund, die einzelnen Effort-Stufen zunächst mit dem eigenen Workload zu testen, statt den Standard blind zu übernehmen.
Kein Aufpreis für langen Kontext – und wann das zählt
Auf der Modellseite von Qwen3.8-Max gibt es genau einen Input- und einen Output-Preis, aber keine kontextabhängigen Tarifstufen. Gemini 3.1 Pro und GPT-5.6 Sol wechseln beide oberhalb einer Kontextgrenze in eine teurere Preiszone:
| Modell | Input (kurzer Kontext) | Output (kurzer Kontext) | Input (langer Kontext) | Output (langer Kontext) |
|---|---|---|---|---|
| Qwen3.8-Max | 2,00 US-Dollar | 6,00 US-Dollar | 2,00 US-Dollar (bis 1M) | 6,00 US-Dollar (bis 1M) |
| Gemini 3.1 Pro | 2,00 US-Dollar (≤200K) | 12,00 US-Dollar | 4,00 US-Dollar (>200K) | 18,00 US-Dollar |
| GPT-5.6 Sol | 5,00 US-Dollar | 30,00 US-Dollar | 10,00 US-Dollar | 45,00 US-Dollar |
Bis 200K Tokens kostet der Input bei Gemini 3.1 Pro exakt so viel wie bei Qwen3.8-Max, danach verdoppelt sich der Preis. Bei GPT-5.6 Sol steigt der Input im Langkontext-Tarif auf das Doppelte, der Output um weitere 50 Prozent – zusätzlich zu einer ohnehin bereits umstrukturierten Preisliste.
Mit wachsendem Kontext wird der Abstand also größer, statt konstant zu bleiben. Ein Prompt mit 400K Tokens kostet als Input bei Qwen3.8-Max 0,80 US-Dollar, bei Gemini 3.1 Pro 1,60 US-Dollar und bei GPT-5.6 Sol 4,00 US-Dollar. Das summiert sich bei Dokumenten-Pipelines, langen Agent-Sessions und Durchläufen über ganze Repositories. Bei kurzen Chat-Turns fällt es dagegen kaum ins Gewicht.
Preisvergleich mit Alibabas Benchmark-Konkurrenz
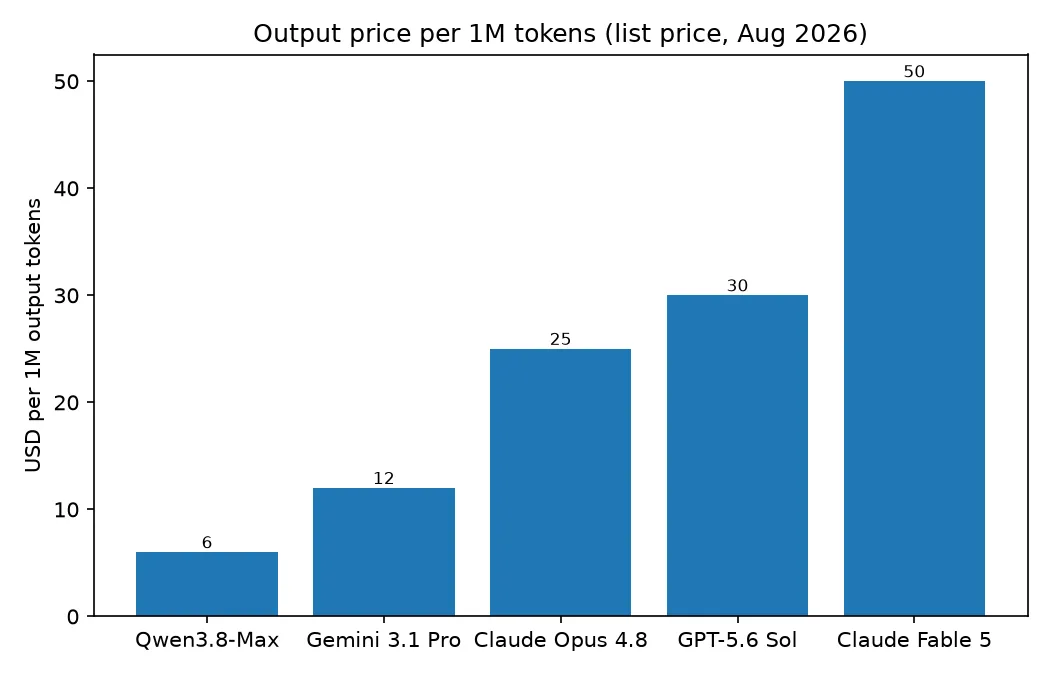
6 US-Dollar für Output liegen bei weniger als einem Viertel von Claude Opus 4.8 mit 25 US-Dollar und bei einem Fünftel von GPT-5.6 Sol mit 30 US-Dollar. Claude Fable 5 liegt mit 50 US-Dollar beim mehr als Achtfachen. Ob dieser Preisabstand den Wechsel rechtfertigt, hängt von der Leistungsfähigkeit ab. Alibaba argumentiert dafür mit einer Benchmark-Tabelle mit 28 Zeilen:
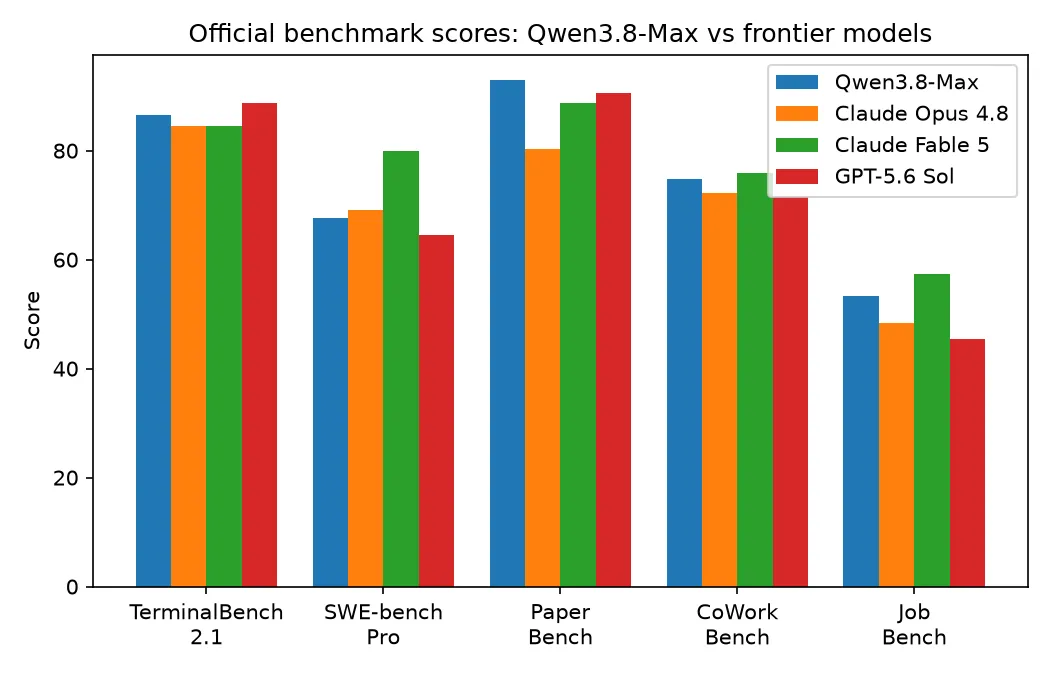
Qwen3.8-Max führt bei PaperBench mit 93,0 gegenüber 90,5 für GPT-5.6 Sol und 88,8 für Fable 5. Bei JobBench erreicht es 53,4 gegenüber 48,4 für Opus 4.8 und liegt beim Terminal Bench 2.1 mit 86,6 knapp vor beiden Claude-Modellen. Deutlich verliert es bei SWE-bench Pro: Fable 5 liegt mit 80,0 mehr als zwölf Punkte vor den 67,7 von Qwen3.8-Max. Sämtliche Werte stammen aus Hersteller-Benchmarks und wurden auf derselben Herstellerseite veröffentlicht.
Damit teilt sich die Entscheidung recht klar auf. Bei outputlastiger Agentenarbeit – langen Tool-Calling-Schleifen, Dokumenterstellung und der Art von Forschungsreproduktion, die PaperBench misst – verändert ein Output-Rabatt um den Faktor 4 bis 8 die Wirtschaftlichkeit des gesamten Betriebs. Bei Softwareentwicklung auf Repository-Ebene, wie sie SWE-bench Pro abbildet, erkauft man sich den günstigeren Preis mit einem realen Fähigkeitsverlust. Hier können die Tarife von Fable 5 weiterhin sinnvoll sein.
Der Vergleich mit dem eigenen Workload lässt sich günstig aufsetzen: Der Launch-Post von Alibaba dokumentiert OpenAI-kompatible Chat-Completions- und Responses-Aufrufe sowie eine Anthropic-kompatible Schnittstelle. Das sind dieselben zwei Request-Formate, die auch Claude Opus 4.8 und GPT-5.6 Sol akzeptieren.
Das sollten Sie jetzt im Code ändern
Die Modell-ID lautet qwen3.8-max. Am 3. August ist sie der einzige 3.8-Eintrag in Alibabas Modellkatalog; die Preview-ID qwen3.8-max-preview ist verschwunden. Wer über einen Relay-Anbieter geht, sollte daher prüfen, ob ein eventueller Preview-Rabatt nach der allgemeinen Verfügbarkeit noch gilt.
Beide Schnittstellen sind über drei regionale Base-URLs verfügbar: Peking, Singapur und US Virginia. Diese Limits dürften zuerst relevant werden:
| Limit | Wert |
|---|---|
| Kontextfenster | 1M |
| Maximaler Input | 991,80K |
| Maximaler Input (Thinking) | 983,61K |
| Maximaler Output | 131,07K |
| Anfragen pro Minute | 15K |
| Tokens pro Minute | 2M |
Zwischen den beiden Input-Grenzen liegen rund 8K Tokens: Aktiviertes Thinking kostet also nicht nur Output-Tokens, sondern auch Input-Spielraum. Sollten die Gewichte nächste Woche tatsächlich erscheinen, sind die 95 Milliarden aktiven Parameter der Ausgangspunkt für jeden Self-Hosting-Vergleich mit den 2/6 US-Dollar der API.
FAQ
Ist die Qwen API kostenlos?
Nein. Qwen3.8-Max wird tokenbasiert abgerechnet: 2 US-Dollar pro Million Input-Tokens und 6 US-Dollar pro Million Output-Tokens. Das auf Alibabas API-Plattform angebotene Token-Plan-Abonnement ist ein separates, kreditbasiertes Produkt und nicht mit der nutzungsbasierten API-Abrechnung gleichzusetzen.
Was kostet Qwen Max?
In der aktuellen Generation kostet es 2 US-Dollar pro Million Input-Tokens und 6 US-Dollar pro Million Output-Tokens; implizites Präfix-Caching kostet 0,25 US-Dollar. Ältere qwen-max-Einträge in der Alibaba-Cloud-Dokumentation beziehen sich auf frühere Generationen und haben andere Tarife.
Berechnet Qwen3.8-Max für das Kontextfenster von 1M einen Aufpreis?
Nein. Input und Output kosten bei 5K Tokens genauso viel wie bei 900K. Genau das unterscheidet die Preisstruktur am deutlichsten von GPT-5.6 Sol und Gemini 3.1 Pro.
Ist Qwen3.8-Max günstiger als Qwen3.7-Max?
Das lässt sich anhand der offiziellen Seiten nicht beantworten. Auf der Modellseite von Qwen3.7-Max werden die Tokenpreise hinter einem 50%-Rabatt-Hinweis als -- dargestellt, statt konkrete Tarife anzuzeigen. Eine veröffentlichte Vergleichszahl gibt es daher nicht.
Weiterführende Artikel
- Preise für Claude Fable 5: der 10/50-US-Dollar-Tarif im Vergleich
- Claude-Fable-5-Tokenkosten senken: dieselben Hebel bei Effort und Caching, aber bei einem anderen Anbieter