 AIREITER
Zwei chinesische MoE-Flaggschiffe, ein Kontextfenster von einer Million Token und gerade einmal drei Wochen zwischen ihren Releases – bei den Kosten könnten sie jedoch kaum weiter auseinanderliegen. Kimi K3 ist die stärkere Wahl fürs Coding, berechnet aber $15 pro Million Output-Token. Das ist das 2,5-Fache der $6 von Qwen 3.8 Max. Qwen ist damit die günstigere und frischere Option (GA seit dem 3. August 2026) und liegt bei Diagrammen sowie Computer Use vorn. Der Haken: Beide Modelle arbeiten ab Werk mit maximalem Reasoning-Aufwand. Kimi K3s höherer Output-Preis schlägt daher bei jeder Anfrage durch, während offene Gewichte für Qwen erst etwa am 11. August erwartet werden.
Gleiche Klasse, unterschiedliche Prioritäten
Qwen 3.8 Max und Kimi K3 sind beide Mixture-of-Experts-Modelle mit mehreren Billionen Parametern, nativer Bildverarbeitung und Kontextfenstern von einer Million Token. Sie erschienen Mitte 2026 im Abstand von nur drei Wochen. Auf dem Datenblatt liegen sie damit fast gleichauf – entsprechend wenig hilfreich ist ein bloßes Benchmark-Pingpong. Entscheidend ist vielmehr, ob ein Qualitätsvorsprung beim Coding die höheren Output-Kosten rechtfertigt und ob offene Gewichte oder starke multimodale Fähigkeiten sofort benötigt werden.
| Spezifikation | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| Parameter gesamt | 2.4T | 2.8T |
| Aktiv pro Token | ~95B | 104B |
| Architektur | MoE (~4% aktiv) | MoE (16 von 896 Experten) |
| Kontextfenster | ~1M (991K maximaler Input) | 1,048,576 |
| Vision | Ja (Text- + Bildeingabe) | Ja (nativ) |
| Standard-Reasoning | xhigh, Thinking aktiviert | maximaler Aufwand, Reasoning aktiviert |
| Offene Gewichte | Nein (erwartet etwa am 11. Aug.) | Ja (HF, 27. Jul., 1.56TB MXFP4) |
| API-Status | GA, 3. Aug. 2026 | GA |
Quellen: Direktvergleich von yottalabs, Alibaba QwenCloud via AIReiter und Moonshot platform.kimi.ai, geprüft am 6. August 2026.
Preise, Beispielrechnung und Zugang
Beide Anbieter rechnen tokenbasiert ab. Der große Preisunterschied steckt nicht dort, wo die Parameterzahlen ihn vermuten lassen würden, sondern im Output – also genau in dem Bereich, in dem Reasoning-Modelle den Großteil ihres Budgets verbrauchen. Kimi K3 verlangt $15 pro Million Output-Token, Qwen 3.8 Max $6. Da beide Modelle ihre Gedankengänge standardmäßig ausgeben, gilt dieser Tarif sowohl für die Reasoning-Traces als auch für die finale Antwort.
| Preis pro 1 Mio. Token | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| Input (Cache Miss) | $2.00 | $3.00 |
| Input (Cache Hit) | $0.25 | $0.30 |
| Output (inkl. Thinking) | $6.00 | $15.00 |
| Kontext | ~1M | 1,048,576 |
Quellen: Alibaba-QwenCloud-Modellseite (aktualisiert am 2. August 2026) und Moonshot platform.kimi.ai/docs/pricing/chat-k3, geprüft am 6. August 2026.
Für einen typischen Coding-Workload mit 20M Input-Token, einer Cache-Hit-Rate von 60 % und 5M Output-Token kostet Kimi K3 rund $103 ($27.60 Input plus $75 Output). Bei Qwen 3.8 Max sind es etwa $49 ($19 Input plus $30 Output). Der fast doppelt so hohe Gesamtpreis entsteht nahezu vollständig beim Output: Caching reduziert den Abstand beim Input, beim Output gibt es diesen Hebel nicht. Weil beide Modelle standardmäßig maximal intensiv reasonen, fällt dieser Kostenblock entsprechend groß aus.
Auch beim Zugang unterscheiden sich die Modelle. Qwen 3.8 Max erreichte am 3. August 2026 die allgemeine Verfügbarkeit über Alibabas API, seine Gewichte sind aber noch nicht öffentlich. Auf der Modellseite steht weiterhin Open Source: No; Gewichte für Hugging Face und ModelScope werden in der Woche des 11. August erwartet (Alibaba, über die Qwen-3.8-Max-Preisseite). Kimi K3 ist die offene Alternative: Moonshot veröffentlichte den 1.56-TB-MXFP4-Checkpoint am 27. Juli, zudem ist die API verfügbar.
Kimi K3 ist außerdem über den Kimi K3 API endpoint von AIReiter zu Moonshots offiziellem Tarif ohne Aufschlag erreichbar. Das ist praktisch, wenn K3 zusammen mit anderen Modellen über eine Rechnung getestet werden soll. Qwen 3.8 Max ist dort noch nicht integriert.
Kimi K3 vorne beim agentischen Coding
Bei mehrstufigen Coding-Aufgaben ist Kimi K3 die bessere Wahl: Agent-Loops, Refactorings über ganze Repositories und SWE-ähnliche Aufgaben, bei denen das Modell Tools aufrufen und nach Sackgassen wieder weiterarbeiten muss. In den öffentlichen agentischen Benchmarks liegt es durchgehend vor Qwen 3.8 Max. Am deutlichsten ist der Vorsprung bei Aufgaben, die echter Entwicklungsarbeit am nächsten kommen.
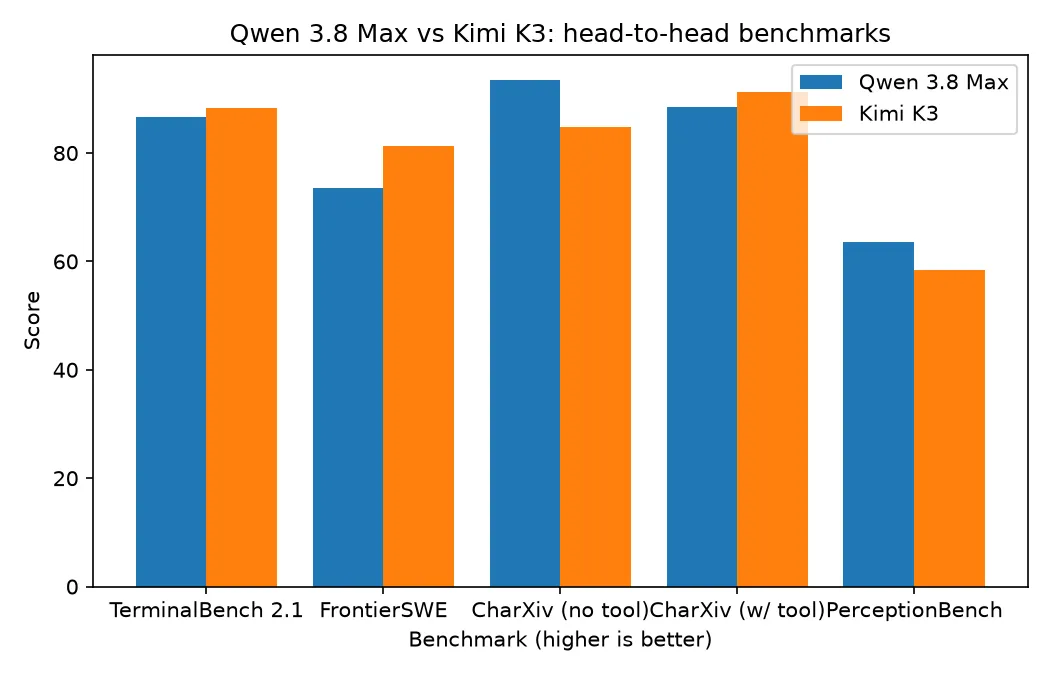
| Benchmark | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| FrontierSWE | 73.5 | 81.2 |
| TerminalBench 2.1 | 86.6 | 88.3 |
| CharXiv (mit Tool) | 88.4 | 91.3 |
Quelle: Direktvergleich von yottalabs, geprüft am 6. August 2026.
Auch das Community-Feedback passt zu den Zahlen – mit dem Kostenhinweis, der diesen Vergleich prägt:
"K3 is god tier. Qwen 3.8 is almost similar to it. However the subscription or API costs are not justified for either of the models as they are…" — r/Qwen_AI
"K3 mogs Qwen 3.8 on this exercise by far, Qwen was 3 times faster than Kimi to generate this landing page." — @filicroval on X
Kimi K3 erreicht zudem einen höheren Rohwert bei der Intelligenz: Im Artificial Analysis Intelligence Index liegt es bei 57. Schnell ist es allerdings nicht: etwa 39 Output-Token pro Sekunde und 3.1 Sekunden bis zum ersten Token (Artificial Analysis). Der Gegenwert für die höhere Latenz und den höheren Preis sind Qualität und offene Gewichte.
Qwen 3.8 Max punktet bei Multimodalität und Preis-Leistung
Qwen 3.8 Max empfiehlt sich, wenn Dokumente, Diagramme oder Screenshots ausgewertet werden sollen, ein Browser bedient wird oder die Output-Kosten wichtiger sind als die letzten Punkte in einem Coding-Benchmark. Bei Dokument- und Wahrnehmungs-Benchmarks schlägt es Kimi K3 und hält einen verifizierten State-of-the-Art-Wert in einem Computer-Use-Benchmark. Gleichzeitig kostet sein Output nur 40 % von Kimi K3s Tarif.
| Benchmark | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| CharXiv (ohne Tool) | 93.5 | 84.8 |
| PerceptionBench | 63.5 | 58.5 |
| OSWorld-Verified | 86.1% (SOTA) | kein öffentlicher Wert |
Quelle: Direktvergleich von yottalabs, geprüft am 6. August 2026.
Die Schwäche von Qwen 3.8 Max liegt genau dort, wo Kimi K3 besonders stark ist und mit geschlossenen Frontier-Modellen mithält. Auf SWE-bench Pro erzielt es 67.7 und liegt damit deutlich hinter Claude Fable 5 mit 80 (von Alibaba veröffentlichte Tabelle, vom Anbieter erstellt). Für die schwierigsten Software-Engineering-Evaluierungen ist es daher nicht die erste Wahl. Zum Zeitpunkt des Schreibens ist die API zudem erst drei Tage in der allgemeinen Verfügbarkeit – sie startete am 3. August 2026 – und die Gewichte bleiben geschlossen (Details oben). Wer heute selbst hosten muss, muss daher warten oder Kimi K3 wählen.
Die Wahl nach Einsatzgebiet
Entscheidend ist weniger, welches Modell pauschal besser ist, sondern wofür es eingesetzt wird. Die folgende Übersicht ordnet typische Workloads einer Empfehlung und dem jeweils belegten Grund zu.
| Bei diesem Workload … | Empfehlung | Warum |
|---|---|---|
| Agent-Loops, Repository-Refactorings, SWE-Aufgaben (Kosten sind nicht limitierend) | Kimi K3 | FrontierSWE 81.2 vs. 73.5, TerminalBench 88.3 vs. 86.6 |
| Dokument- und Diagrammauswertung, Browser oder Computer Use, kostenbewusst | Qwen 3.8 Max | CharXiv 93.5, OSWorld 86.1% SOTA, $6 vs. $15 Output |
| Self-Hosting heute | Kimi K3 | Gewichte seit 27. Jul. auf HF; Qwens kommen etwa am 11. Aug. |
FAQ
Ist Qwen 3.8 Max besser fürs Coding als Kimi K3?
Nein. Kimi K3 führt bei den relevanten Benchmarks für agentisches Coding – FrontierSWE 81.2 zu 73.5 und TerminalBench 2.1 88.3 zu 86.6. Für mehrstufige Engineering-Aufgaben ist Kimi K3 daher die stärkere Wahl.
Was ist günstiger: Qwen 3.8 Max oder Kimi K3?
Qwen 3.8 Max. Es verlangt $6 pro Million Output-Token gegenüber $15 bei Kimi K3 sowie $2 Input gegenüber $3. Die Cache-Hit-Preise sind ähnlich. Bei einem typischen Coding-Workload ergibt sich ungefähr ein Faktor von 2.
Welches Modell ist bei agentischem Coding mit maximalem Reasoning günstiger?
Weiterhin Qwen 3.8 Max: Beide Modelle rechnen Reasoning-Token bei maximalem Aufwand als Output ab. Kimi K3s Tarif von $15/M vergrößert den Abstand somit gerade bei dem Coding-Workload, in dem es qualitativ gewinnt.
Unterstützen beide Modelle ein Kontextfenster von einer Million Token?
Ja. Qwen 3.8 Max verarbeitet ungefähr 991K Input-Token, bei aktiviertem Thinking weniger. Kimi K3 akzeptiert 1,048,576 Token. Beide haben nominell ein Kontextfenster von einer Million Token.
Sind die Gewichte offen?
Die von Kimi K3 schon. Moonshot veröffentlichte den 1.56-TB-MXFP4-Checkpoint am 27. Juli 2026. Die Gewichte von Qwen 3.8 Max sind noch nicht offen: Alibaba führt sie als geschlossen, eine Veröffentlichung auf Hugging Face und ModelScope wird für die Woche des 11. August erwartet.
Weiterführende Artikel
- Kimi K3 model page: detaillierte Einordnung von Kimi K3 als Einzelmodell
- Qwen 3.8 Max API pricing: vollständige Preis- und Technikübersicht für Qwen 3.8 Max
- Qwen3.8-27B: das kleinere Open-Weight-Release von Qwen 3.8 für Self-Hosting
- Kimi K2.7 Code vs GLM 5.2: ein verwandter Vergleich aus derselben Gruppe von Coding-Modellen