 AIREITER
Ein Download mit 17GB bedeutet noch lange keinen angenehm nutzbaren lokalen Agenten. Qwen3.8-27B ist ein leistungsfähiges Open-Weight-Modell unter Apache-2.0-Lizenz. Mit dem standardmäßig aktivierten, besonders intensiven Reasoning kann aus einer kurzen Aufgabe jedoch eine lange Wartezeit werden – wenn Quantisierung, Kontextbudget und Serving-Stack nicht zur eigenen Hardware passen.
Lohnt sich Qwen3.8-27B auf dem eigenen Rechner?
Für Entwickler mit rund 24GB GPU- oder Unified Memory, hohen Ansprüchen an lokale Datenverarbeitung und einer gewissen Toleranz für langsamere Antworten als bei schnellen gehosteten APIs kann sich Qwen3.8-27B lokal lohnen. Seine Stärke liegt nicht in einem einzelnen Benchmark, sondern in der Kombination aus dichtem Apache-2.0-Modell, Bild- und Videoeingabe, nativem Kontextfenster von 262.144 Tokens und konfigurierbarem Reasoning bei noch gut handhabbarer Modellgröße. Laut offizieller Modellkarte von Qwen wurde das Modell am 14. August 2026 veröffentlicht.
Als pauschaler Ersatz für jede API taugt es aber nicht. Die offiziellen Ergebnisse stammen vom Anbieter selbst, aggressive Quantisierungen beeinflussen Qualität und Geschwindigkeit, und das standardmäßige xhigh-Reasoning ist für viele interaktive lokale Aufgaben ein schlechter Ausgangspunkt.
Erst den Speicher planen, dann Benchmarks vergleichen
Qwen3.8-27B ist ein dichtes Modell: Bei jedem generierten Token wird das gesamte Modell aktiviert. Deshalb sind Speicherbandbreite, KV-Cache, Quantisierung und das angeforderte Kontextfenster viel wichtiger, als die reine Größe der Gewichtsdatei vermuten lässt. Qwens Modellkarte nennt 262K nativen Kontext. In einer lokalen Sitzung lässt sich der Kontext jedoch deutlich kleiner konfigurieren, um Speicher und Geschwindigkeit sinnvoll zu nutzen. Die Serving-Beispiele von Qwen zeigen das Maximum von 262.144 Tokens – das ist eine technische Obergrenze, kein vernünftiger Standard für jeden Consumer-Rechner.
| Verfügbarer Speicher | Sinnvoller Einstieg | Realistische Erwartungen | Empfehlung |
|---|---|---|---|
| 12GB | Aggressive Quantisierung der Q3-Klasse plus CPU-/RAM-Offload | Kurzer Kontext und deutliche Latenznachteile | Besser ein kleineres Modell wählen, sofern lokales Experimentieren nicht das Ziel ist |
| 16GB | Aggressives Q3 oder sorgfältig gewähltes Q4-ähnliches Quant | Für kurze, überwachte Aufgaben nutzbar; Kontext und Tempo bleiben begrenzt | Vor einem Agenten-Workflow unbedingt testen |
| 24GB | Quantisierung der Q4-Klasse | Der praktische Einstieg für Coding, Tools und moderaten Kontext | Für die meisten lokalen Qwen3.8-27B-Nutzer die beste Wahl |
| 32GB+ | Höherwertige Quantisierung oder mehr Kontextreserve | Weniger Kompromisse bei KV-Cache und langen Sitzungen | Für dauerhafte Agentenarbeit diese Klasse bevorzugen |
Das sind Betriebsempfehlungen, keine Mindestvorgaben des Herstellers. Unabhängige Nutzer berichten, dass eine RTX 3060 mit 12GB einen lokalen Build ausführen und Tool Calling bewältigen kann. Andere warnen dagegen, dass ein dichter Agent bei dieser VRAM-Ausstattung schlecht arbeitet. Genau deshalb sollte man „lässt sich laden“ nicht mit „funktioniert gut“ verwechseln. Die Diskussion von echten Nutzern findet sich in r/LLM.
Eine 24GB-Karte ist die Untergrenze für einen komfortablen 4-Bit-Workflow, aber keine Garantie für entspanntes Arbeiten mit langem Kontext. Eine auf Deployments fokussierte Einschätzung veranschlagt für 4 Bit insgesamt 17–19GB Speicher, warnt aber zugleich davor, dass der KV-Cache in langen Agentensitzungen schnell anwächst. Die Analyse von Neoteric zum lokalen Deployment ist ein nützlicher Planungswert, jedoch keine offizielle Hardware-Spezifikation.
Warum Qwen3.8-27B mit den Standardwerten zäh wirken kann
Bei Qwen3.8-27B ist Thinking standardmäßig aktiv. Die offizielle Modellkarte führt für reasoning_effort unter anderem xhigh, medium und low auf; für Anfragen ohne Thinking gibt es enable_thinking=False. Außerdem ist preserve_thinking standardmäßig eingeschaltet. Im Abschnitt zu Best Practices weist Qwen darauf hin, dass ein niedrigerer Reasoning-Aufwand nicht immer die gesamte Bearbeitungszeit verkürzt. Für triviale Aufgaben bleibt eine hohe Einstellung dennoch ein kostspieliger Standard.
Wie groß der Unterschied ausfallen kann, zeigt ein lokaler Test von Simon Willison. Mit einem Q4_K_M-Build in LM Studio benötigte eine erste SVG-Aufgabe bei der Standardeinstellung laut seinem Bericht 22.276 Reasoning-Tokens und 21 Minuten. Mit deaktiviertem Reasoning kam ein anderes Ergebnis nach 137 Sekunden. Sein gemessenes Setup ist kein allgemeingültiger Benchmark, macht das Konfigurationsrisiko aber greifbar. Der vollständige Test mit Transkripten.
„Ich hatte erwartet, dass es ungefähr auf dem Niveau von 3.6 35b liegt, nur wegen der starken Quantisierung langsamer. Stattdessen hat es ihn überall klar übertroffen.“ u/AltruisticList6000, r/LocalLLaMA, über ein Q3-Experiment mit einer RTX 4060 Ti mit 16GB.
Das positive Ergebnis hebt den Zielkonflikt nicht auf. Ein anderer Nutzerbericht beschreibt begrenzten 32K-Kontext und eine Agentensitzung, die unzuverlässig wurde. Wieder andere empfehlen für lokale Programmierarbeit klare, atomare Anweisungen. Die Workflow-Diskussion gibt es hier.
Das steckt offiziell in Qwen3.8-27B
Qwen3.8-27B ist ein dichtes, natives Vision-Language-Modell und kein MoE-Modell. Die offizielle Modellkarte nennt Eingaben in Text, Bild und Video, 64 Layer, eine Hidden Dimension von 5.120, 262.144 native Kontext-Tokens sowie die Apache-2.0-Lizenz. Sie dokumentiert außerdem eine YaRN-basierte Erweiterung auf bis zu 1M Tokens – mit dem ausdrücklichen Hinweis, dass statisches YaRN die Leistung bei kurzen Texten verschlechtern kann. Die offiziellen Spezifikationen und Kontext-Hinweise sollten gegenüber Release-Zusammenfassungen von Drittanbietern Vorrang haben.
Das offizielle Repository nennt Transformers, vLLM, SGLang, TokenSpeed sowie quantisierte lokale Wege über llama.cpp, Ollama und LM Studio. Die Unterstützung des Runners ist wichtig, da das Modell ein hybrides Layout aus Gated DeltaNet und Gated Attention verwendet. Vor der Fehlersuche am Modell sollte der Runner aktualisiert werden. Das Quickstart-Repository von Qwen enthält Beispiele für OpenAI-kompatibles Serving.
Was die veröffentlichten Benchmarks aussagen – und was nicht
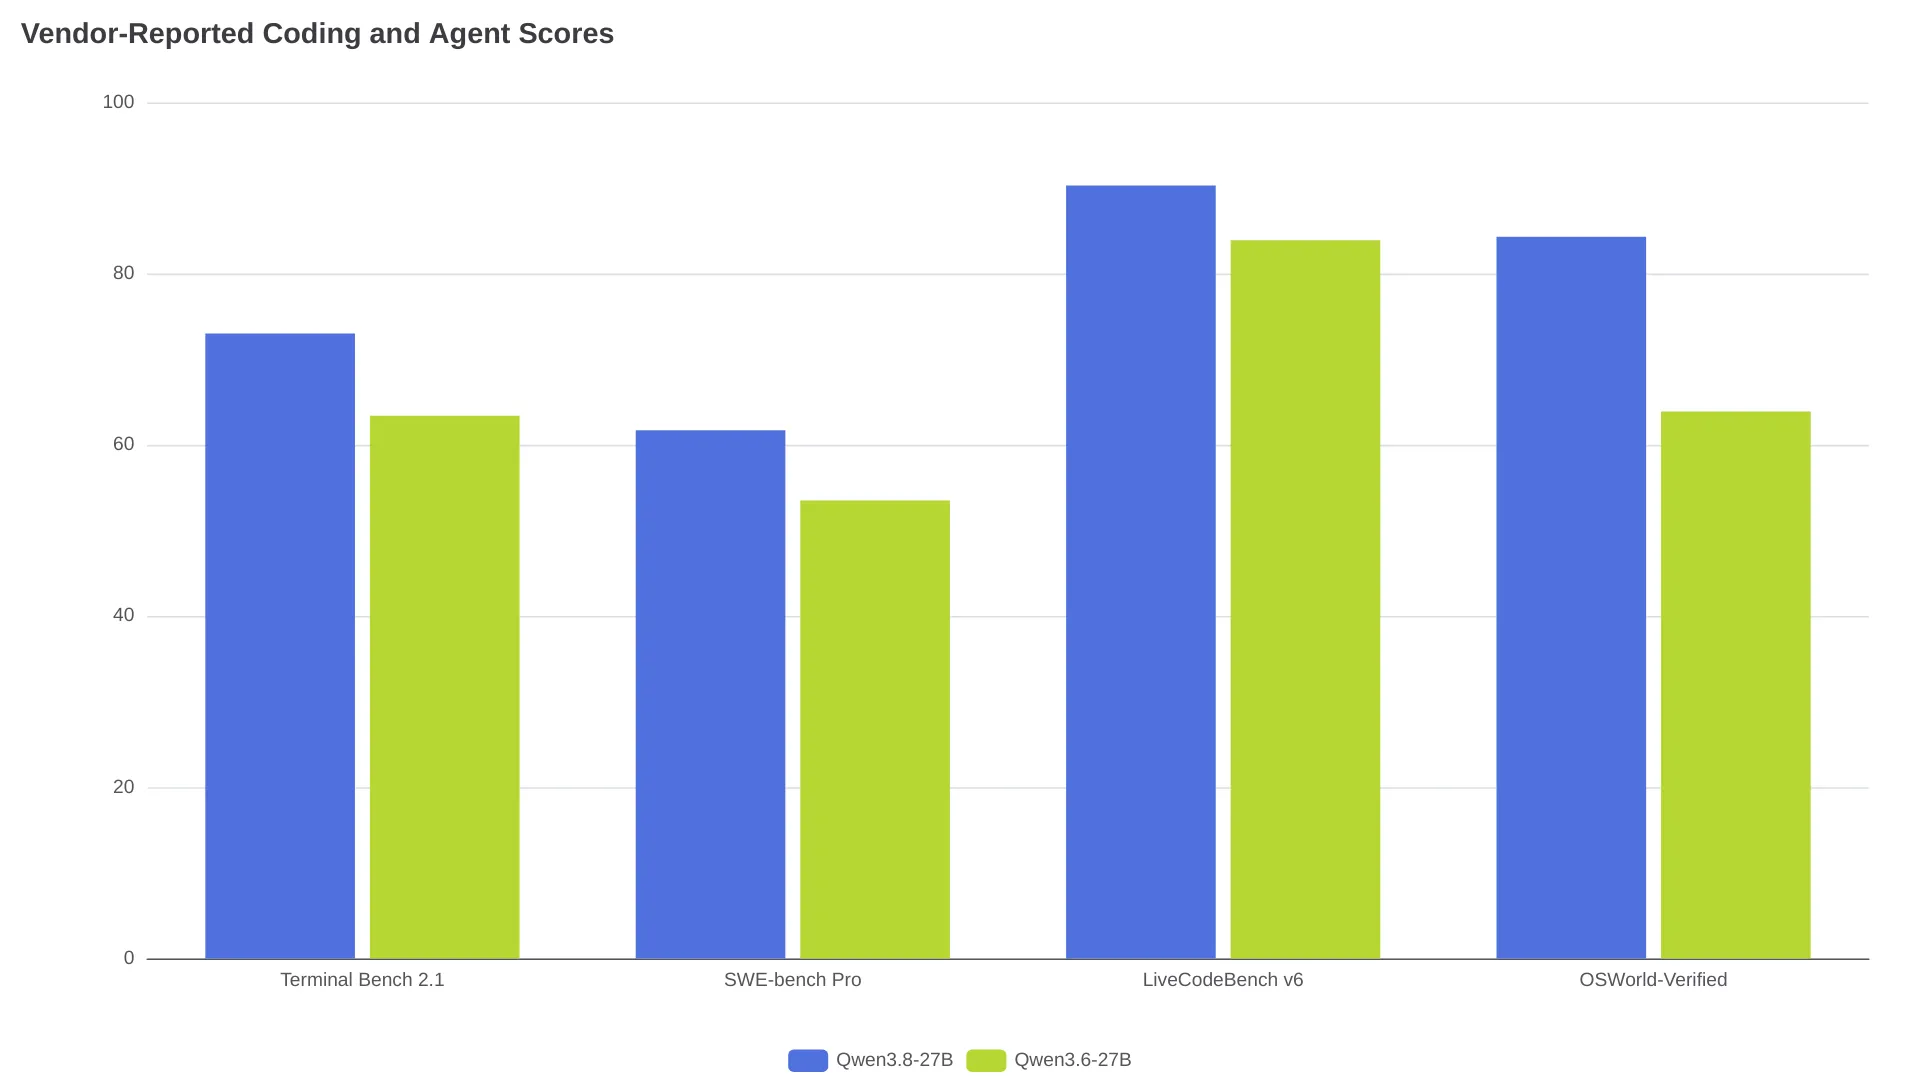
Qwen meldet deutliche Fortschritte gegenüber Qwen3.6-27B bei Coding- und Computer-Use-Evaluierungen. Die Grafik zeigt vier vom Anbieter gemeldete Werte aus der offiziellen Modellkarte, keine unabhängig reproduzierten Ergebnisse.
| Offizieller Benchmark | Qwen3.8-27B | Qwen3.6-27B | Einordnung |
|---|---|---|---|
| Terminal Bench 2.1 | 73.0 | 63.4 | Signal für agentisches Terminal-Coding |
| SWE-bench Pro | 61.7 | 53.5 | Signal für das Lösen von Repository-Issues |
| LiveCodeBench v6 | 90.3 | 83.9 | Signal aus einer Coding-Evaluierung |
| OSWorld-Verified | 84.3 | 63.9 | Signal für Computer Use |
Die Modellkarte veröffentlicht den vollständigen Vergleich samt Methodik. Für SWE-bench Pro und DeepSWE 1.1 verwendete Qwen nach eigenen Angaben ein Claude-Code-Harness mit temperature=1.0, top_p=0.95 und 256K Kontext; außerdem enthält sie interne Benchmarks wie QwenSWEBench. Vor dem Modellvergleich sollte man die Methodik prüfen. Die Werte stützen die Aussage „ein deutlicher offizieller Sprung gegenüber Qwen3.6-27B“, nicht aber „ein nachweislich universeller Ersatz für eine Frontier-API“.
So gelingt der lokale Einstieg
Beim ersten lokalen Deployment sollte vorhersehbares Verhalten wichtiger sein als maximales Reasoning. Verwenden Sie einen aktuellen Runner, starten Sie auf Hardware der 24GB-Klasse mit einem Quant der Q4-Klasse, setzen Sie bewusst ein moderates Kontextlimit und testen Sie kurze Agentenaufgaben, bevor lange autonome Schleifen laufen dürfen.
- Starten Sie einen OpenAI-kompatiblen Server mit einer unterstützten Engine wie vLLM oder SGLang. Qwen veröffentlicht Beispiele mit
Qwen/Qwen3.8-27B,--reasoning-parser qwen3und--tool-call-parser qwen3_coder. Die offiziellen Befehle stehen im Repository. - Für gewöhnliche Klassifizierung, Extraktion oder schnelle Code-Änderungen setzen Sie
enable_thinking=False. Für Anfragen ohne Thinking empfiehlt Qwentemperature=0.7,top_p=0.80undpresence_penalty=1.5. Siehe das offizielle API-Beispiel. - Bei Debugging mit hohem Reasoning-Bedarf zuerst
lowodermediumausprobieren, bevorxhighzum Einsatz kommt. Anschließend Gesamtzeit bis zum Ergebnis und Qualität der Tool Calls an einer echten Aufgabe vergleichen. - Gespeichertes Thinking deaktivieren, wenn die einzelnen Aufgaben unabhängig voneinander sind. Beibehalten sollte man es nur, wenn der mehrturnige Reasoning-Kontext den zusätzlichen Druck auf den KV-Cache rechtfertigt.
- Vor unbeaufsichtigter Nutzung Tool Calling, Einhaltung des Ausgabeschemas und einen Kontext-Rollover testen. Ein Modell, das in einem Prompt guten Code schreibt, kann in einer lang laufenden Agentenschleife trotzdem scheitern.
Wann Qwen3.8-27B lokal nicht die richtige Wahl ist
Qwen3.8-27B ist keine gute erste Wahl, wenn 12GB oder weniger eine harte Grenze sind, wenn Antwortlatenz wichtiger ist als lokale Kontrolle oder wenn ein Agent unbeaufsichtigt arbeiten und strikte Ausgabeformate einhalten muss. Das Modell kann in eingeschränkten Setups laufen. Das bedeutet aber nicht, dass es verlässlichen interaktiven Durchsatz oder genug Kontext für Repository-Arbeit liefert.
Unabhängige Tests sehen zudem eine Tendenz zu langen Ausgaben, hoher Tail-Latency und nicht immer perfekter Einhaltung strikter Anweisungen. Eine strukturierte Evaluation verzeichnete in 49 Tests 4 Timeouts und auf ihrer Workstation-Konfiguration eine P95-Antwortzeit von 143,32 Sekunden. Diese Werte sind keine übertragbaren Leistungsgarantien, aber eine nützliche Warnung davor, ein lokales 27B-Modell als Automatisierungskomponente ohne Prüfung einzuplanen. Der Testbericht von CrucibleMark dokumentiert Konfiguration und Einschränkungen.
FAQ zu Qwen3.8-27B
Ist Qwen3.8-27B offiziell veröffentlicht?
Ja. Das offizielle Repository von Qwen datiert die Veröffentlichung von Qwen3.8-27B auf Hugging Face Hub und ModelScope auf den 14. August 2026. Die Release-Zeitleiste von Qwen ist die Primärquelle.
Läuft Qwen3.8-27B auf einer GPU mit 16GB?
Ein stark quantisiertes Setup mit kurzem Kontext kann laufen, bleibt aber ein eingeschränktes Deployment. Nutzerberichte reichen von vielversprechenden Q3-Ergebnissen auf einer RTX 4060 Ti mit 16GB bis zu Warnungen vor erheblichen Kompromissen bei Geschwindigkeit und Qualität für dichte Agenten mit wenig VRAM. Diskussion auf LocalLLaMA.
Hat Qwen3.8-27B ein Kontextfenster von 1M Tokens?
Nativ stehen 262.144 Kontext-Tokens zur Verfügung. Die Modellkarte beschreibt 1M Kontext über YaRN-/RoPE-Skalierung und warnt, dass statisches YaRN die Leistung bei kurzen Texten verringern kann. Offizielle Kontext-Dokumentation.
Wie deaktiviere ich Thinking bei Qwen3.8-27B?
Setzen Sie in der API-Anfrage enable_thinking=False, wie in Qwens Modellkarte gezeigt. Für Aufgaben, die Reasoning erfordern, sollte man mit low oder medium beginnen, statt xhigh grundsätzlich vorauszusetzen. Offizielles Beispiel ohne Thinking.
Sollten Nutzer von Qwen3.6-27B upgraden?
Ein Upgrade lohnt sich, wenn die vorhandene Hardware bereits dieselbe Deployment-Klasse bewältigt und der Workflow von Verbesserungen bei Coding, Computer Use oder Multimodalität profitiert. Bei Qwen3.6-27B sollte man bleiben, wenn der aktuelle Stack stabil läuft und Runner, Quantisierung oder neues Reasoning-Verhalten noch nicht im tatsächlichen Workflow validiert wurden.
Entscheidend ist die unveränderliche Einschränkung
| Einschränkung | Bester nächster Schritt |
|---|---|
| Lokale Datenverarbeitung und 24GB verfügbar | Qwen3.8-27B mit Q4 betreiben, zunächst mit niedrigem oder deaktiviertem Thinking |
| Nur 12GB bis 16GB | Für überwachte kurze Aufgaben einen Q3-ähnlichen Build testen oder ein kleineres Modell wählen |
| Lange Agentensitzungen über Repositorys | 32GB+ Reserve einplanen und das KV-Cache-Verhalten vor der Einführung validieren |
| Schnelle interaktive Antworten | Eine gehostete API oder ein kleineres lokales Modell verwenden |
| Strikte unbeaufsichtigte Formatierung oder Veröffentlichung | Eine Validierungsschicht und menschliche Prüfung beibehalten; nicht allein auf Modelleinhaltung vertrauen |
Qwen3.8-27B verschiebt die Grenze dessen, was ein lokal einsetzbares 27B-Modell leisten kann. Die Systemarbeit entfällt dadurch nicht: Quantisierung zur Hardware passend wählen, Reasoning gezielt steuern und das Modell an einem repräsentativen Workflow bewerten – nicht anhand der Downloadgröße.