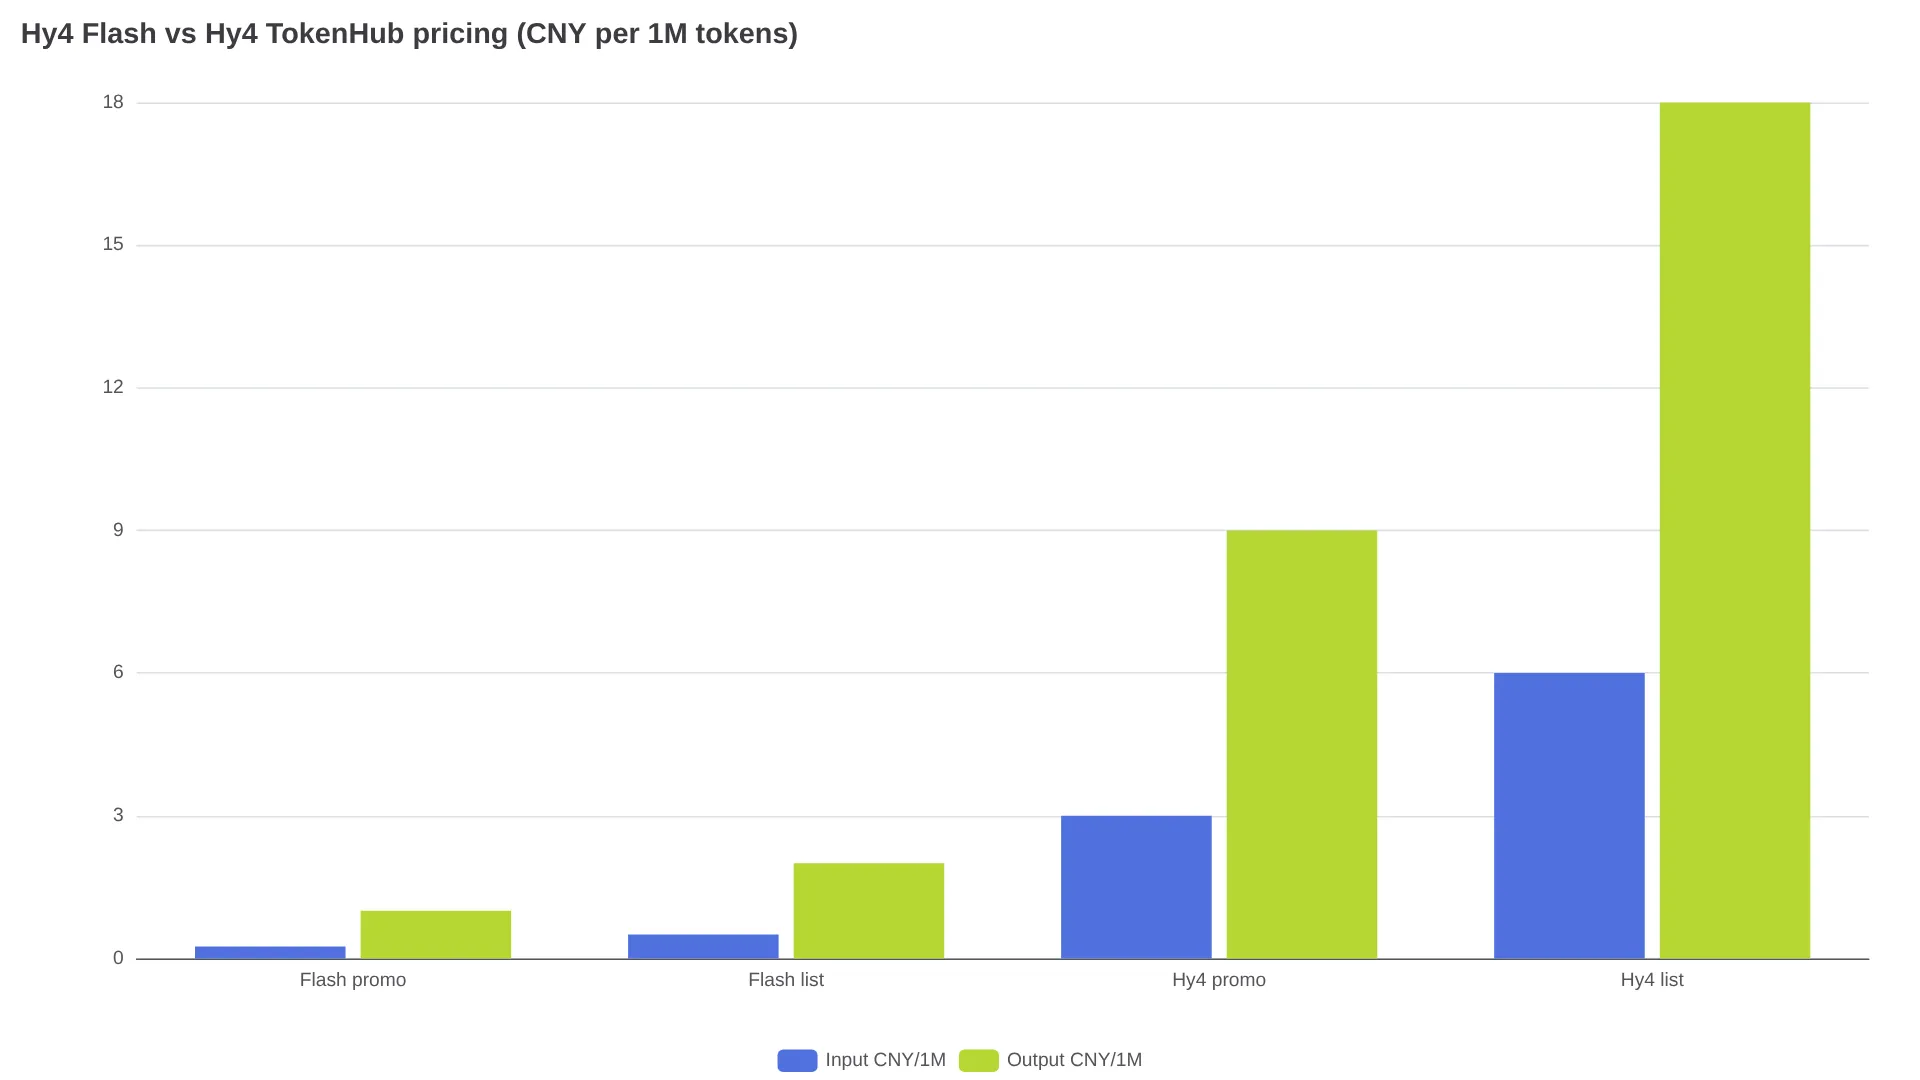
Tencent Hy4 Flash (224B Parameter insgesamt / 12B aktiv, 1M Kontext) ist seit dem 16. November 2026 verfügbar. Regulär kostet die Nutzung CNY 0,50 pro Million Input-Tokens und CNY 2,00 pro Million Output-Tokens (0,070 / 0,281 $). Zum Start gilt bei TokenHub noch ein Rabatt von 50 %: Bis zum 30. November um 12 Uhr Pekinger Zeit sinken die Preise auf CNY 0,25 / 1,00.
Flash ist kein einfach kleineres Hy4 für dieselben Aufgaben. Abgerechnet wird nach der von dir gesendeten Modell-ID: hy4-flash ist die günstige Variante, hy4 das Flaggschiff und hy4-preview der Checkpoint vom August.
Hy4 Flash ist da – das wurde am 16. November veröffentlicht
In der Hy4-Ankündigung vom 4. November fehlten noch Preise für Flash. Der Release-Post vom 16. November und der zeitgleiche Eintrag bei TokenHub haben diese Lücke geschlossen (ITHome, Sina Finance, LLMLearner-Spezifikationen).
- Tencent Cloud TokenHub, Modell-ID
hy4-flash– verfügbar. - WorkBuddy, Yuanbao und Tencent-Apps – WorkBuddy ist bis zum 30. November kostenlos.
- OpenRouter – geplant, aber noch nicht verfügbar. Stand 16. November ist dort nur
tencent/hy4gelistet. Bis OpenRouter Flash ergänzt, lässt sich der TokenHub-Endpunkt in Singapur verwenden.
Diese Specs erklären den Preisvorteil gegenüber Hy4
Hy4 Flash kommt auf 224B Parameter, darunter 64B Engram-Parameter; pro Token sind 12B aktiv. Zum Einsatz kommt eine Mixture-of-Experts-Architektur (LLMLearner, Sina). Das Kontextfenster umfasst 1M Tokens (1.048.576). Als Eingabe akzeptiert das Modell Text und Bilder, als Ausgabe erzeugt es Text.
Für die Rechnung entscheidend: Der KV-Cache ist sechsmal kleiner als bei Hy4 und 24-mal kleiner als bei Hy3. Dazu kommen Megakernel, 4-Bit-Quantisierung und dflash-Beschleunigung für die Dekodierung mit mehr als 150 Tokens/s. Bilder, Diagramme und visuelle Mathematik werden über denselben Endpunkt verarbeitet.
Gewichte angekündigt, aber noch nicht veröffentlicht: Anders als beim unter Apache 2.0 stehenden Hy4-preview gibt es für Flash mit Stand 16. November weder einen öffentlichen Checkpoint noch ein Veröffentlichungsdatum oder eine Lizenz.
Hy4-Flash-API-Preise kompakt in einer Tabelle
TokenHub führt separate Preislisten für das chinesische Festland (CNY) und den internationalen Markt (USD). Es handelt sich um regionale Preispläne, nicht um Umrechnungen. Die Flash-Aktion läuft bis zum 30. November um 12:00 Uhr Pekinger Zeit (LLMLearner); die Aktion für das Flaggschiff endet am 31. Dezember um 23:59 Uhr Pekinger Zeit (CostMyTokens-Verifizierung, ChinaModelAPI).
| Tarif | Input / 1M | Output / 1M | Cache-Read / 1M | Gültigkeit |
|---|---|---|---|---|
| Flash regulär (CNY) | ¥0.50 | ¥2.00 | ¥0.02 | Standard |
| Flash-Aktion (CNY) | ¥0.25 | ¥1.00 | ¥0.01 | bis 30. Nov., 12:00 Uhr Peking |
| Flash regulär (USD) | $0.070 | $0.281 | $0.003 | Standard |
| Hy4 regulär (CNY) | ¥6.00 | ¥18.00 | ¥0.30 | Standard |
| Hy4-Aktion (CNY) | ¥3.00 | ¥9.00 | ¥0.15 | bis 31. Dez., 23:59 Uhr Peking |
| Hy4 regulär (USD) | $0.834 | $2.501 | $0.042 | Standard |
| Hy4-Aktion (USD) | $0.417 | $1.2505 | $0.021 | bis 31. Dez. |
Rechenbeispiel mit dem Flash-Aktionspreis: 100K frische Input-Tokens + 500K gecachte Input-Tokens + 5K Output ergeben 0,1 × ¥0,25 + 0,5 × ¥0,01 + 0,005 × ¥1,00 = ¥0,035.
Der eigentliche Abstand zeigt sich bei den Kosten pro Aufgabe. Tencent spricht von ungefähr einem Zwanzigstel der Kosten von Hy4, einem Dreizehntel von Hy4 Preview und einem Achtel von DeepSeek-V4.1-Flash (max) (Sina). Eine Community-Berechnung im Launch-Thread, abgeleitet aus einem Blindtest von Tencent mit 85 internen Nutzern und 259 Aufgaben (LLMLearner), kommt auf ¥0,26 pro Aufgabe. Claude Haiku 5.5 (high) liegt demnach bei ¥4,73, DeepSeek-V4.1-Flash bei ¥1,20; die Zufriedenheit beträgt 2,79 gegenüber 2,81 (Aufschlüsselung von @alphaw0ng). Eine unabhängige Vergleichstabelle gibt es bislang nicht – die Werte sollten daher als Anbieter-Test mit Community-Berechnung eingeordnet werden.
Bei Agenten entscheidet der Cache über die Rechnung: Cache-Reads kosten nur 4–5 % eines frischen Inputs (¥0,02 gegenüber ¥0,50; $0,003 gegenüber $0,070).
„Ist das ein Spitzenmodell? Nein, überhaupt nicht. Aber genau das macht WorkBuddy zum Doubao für Arbeitsagenten. Mit nur 200B Parametern kann Tencent den Massenmarkt mit sehr günstigen Tokens versorgen, die für relativ einfache Aufgaben ausreichen.“ – @LeroyLi311063, Reaktion am Launch-Tag
Flash, Hy4 oder Hy4 Preview: Das passende Modell für jeden Workload
| Hy4 Flash | Hy4 (GA, 4. Nov.) | Hy4 Preview (28. Aug.) | |
|---|---|---|---|
| Parameter | 224B gesamt / 12B aktiv | nicht veröffentlicht (Preview-Referenz: 770B / 49B) | 770B / 49B |
| Kontext | 1M | 1M – maximal 960K Input, 64K Output (Einrichtungsanleitung) | 1M |
| Modalitäten | Text + Bild als Input, Text als Output | Text + Bild als Input, Text als Output, Computersteuerung | Text, früher Checkpoint |
| TokenHub-ID | hy4-flash | hy4 | hy4-preview |
| Listenpreis Input/Output | ¥0.5 / ¥2.0 | ¥6 / ¥18 ($0.834 / $2.501) | ¥6 / ¥18 |
| Am besten geeignet für | Suche, Dokumente, Präsentationen, einfaches Frontend, alltägliche Computeraufgaben | Software mit langen Aufgabenketten, komplexe Agenten, Finanzrecherche | Tests mit Open Weights (Apache 2.0) |
Der Vergleich mit dem Flaggschiff ist wichtig, weil Flash darunter angesiedelt ist. Im Benchmark-Anhang zu Tencent Hy4 liegt Hy4 bei Terminal-Bench 4.0 mit 44,4 hinter führenden proprietären Modellen (etwa 66 bei Opus-5.5-Modellen) und bei ProgramBench mit 30,0 hinter 56,5+. Für SWE-Bench-ähnliche Aufgaben oder Terminal-Agenten, die mehrere Stunden laufen, macht der Aktionspreis von ¥0,25 pro Input Flash nicht automatisch zum richtigen Modell. Die Preise des Flaggschiffs dokumentieren unser Guide zu den Hy4-Preview-API-Preisen und der Vergleich der günstigsten LLM-APIs.
hy4-flash in 10 Minuten aufrufen
TokenHub ist mit der OpenAI-API kompatibel und unterstützt /v1/chat/completions, /v1/responses sowie Anthropics /v1/messages (Endpunkt-Anleitung). Verwende einen TokenHub-Key, kein Yuanbao- oder WorkBuddy-Session-Token. Wähle Guangzhou mit https://tokenhub.tencentmaas.com/v1 oder Singapur mit https://tokenhub-intl.tencentmaas.com/v1. Aktiviere den Modelldienst in der Konsole – ein deaktivierter Dienst liefert laut derselben Anleitung den Fehler 402 – und sende anschließend hy4-flash.
curl https://tokenhub-intl.tencentmaas.com/v1/chat/completions \
  -H "Authorization: Bearer $TOKENHUB_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "hy4-flash",
    "messages": [{"role": "user", "content": "Summarize this 80-page PDF in 10 bullets"}]
}'from openai import OpenAI
client = OpenAI(api_key="YOUR_TOKENHUB_API_KEY",
base_url="https://tokenhub-intl.tencentmaas.com/v1")
resp = client.chat.completions.create(
model="hy4-flash",
messages=[{"role": "user", "content": "Hello"}],
)
print(resp.choices[0].message.content)Die maximale Flash-Ausgabelänge ist nicht veröffentlicht; für Hy4 sind 64K dokumentiert. Gehe daher nicht davon aus, dass Flash diesen Wert übernimmt. Prüfe vor der Planung von Ausgaben mit mehr als 100K Tokens die Modellseite in der Konsole.
Die Routing-Regel: Flash als Standard, Hy4 für die schwierigen 5 %
| Wenn dein Workload … | Verwende | Warum |
|---|---|---|
| Dokumente, Präsentationen, Tabellen, Meeting-Vorbereitung, Deep Search | hy4-flash | In Tencents Test nahezu Haiku-Niveau bei etwa ¥0,26 pro Aufgabe |
| Agenten mit hohem Volumen und stabilen langen Präfixen | hy4-flash | Das Cache-Verhältnis von 4–5 % summiert sich schnell |
| Einfaches Frontend, alltägliche Computeraufgaben | hy4-flash | Hier positioniert Tencent das Modell; mehr als 150 tps verbessern die Interaktion |
| Coding mit langen Aufgabenketten, Terminal-Agenten, Programmsynthese | hy4 | Flash ist ausdrücklich nicht für diesen Einsatz positioniert |
| Heute selbst hosten | hy4-preview-Gewichte | Nur für Preview gibt es herunterladbare Gewichte unter Apache 2.0 |