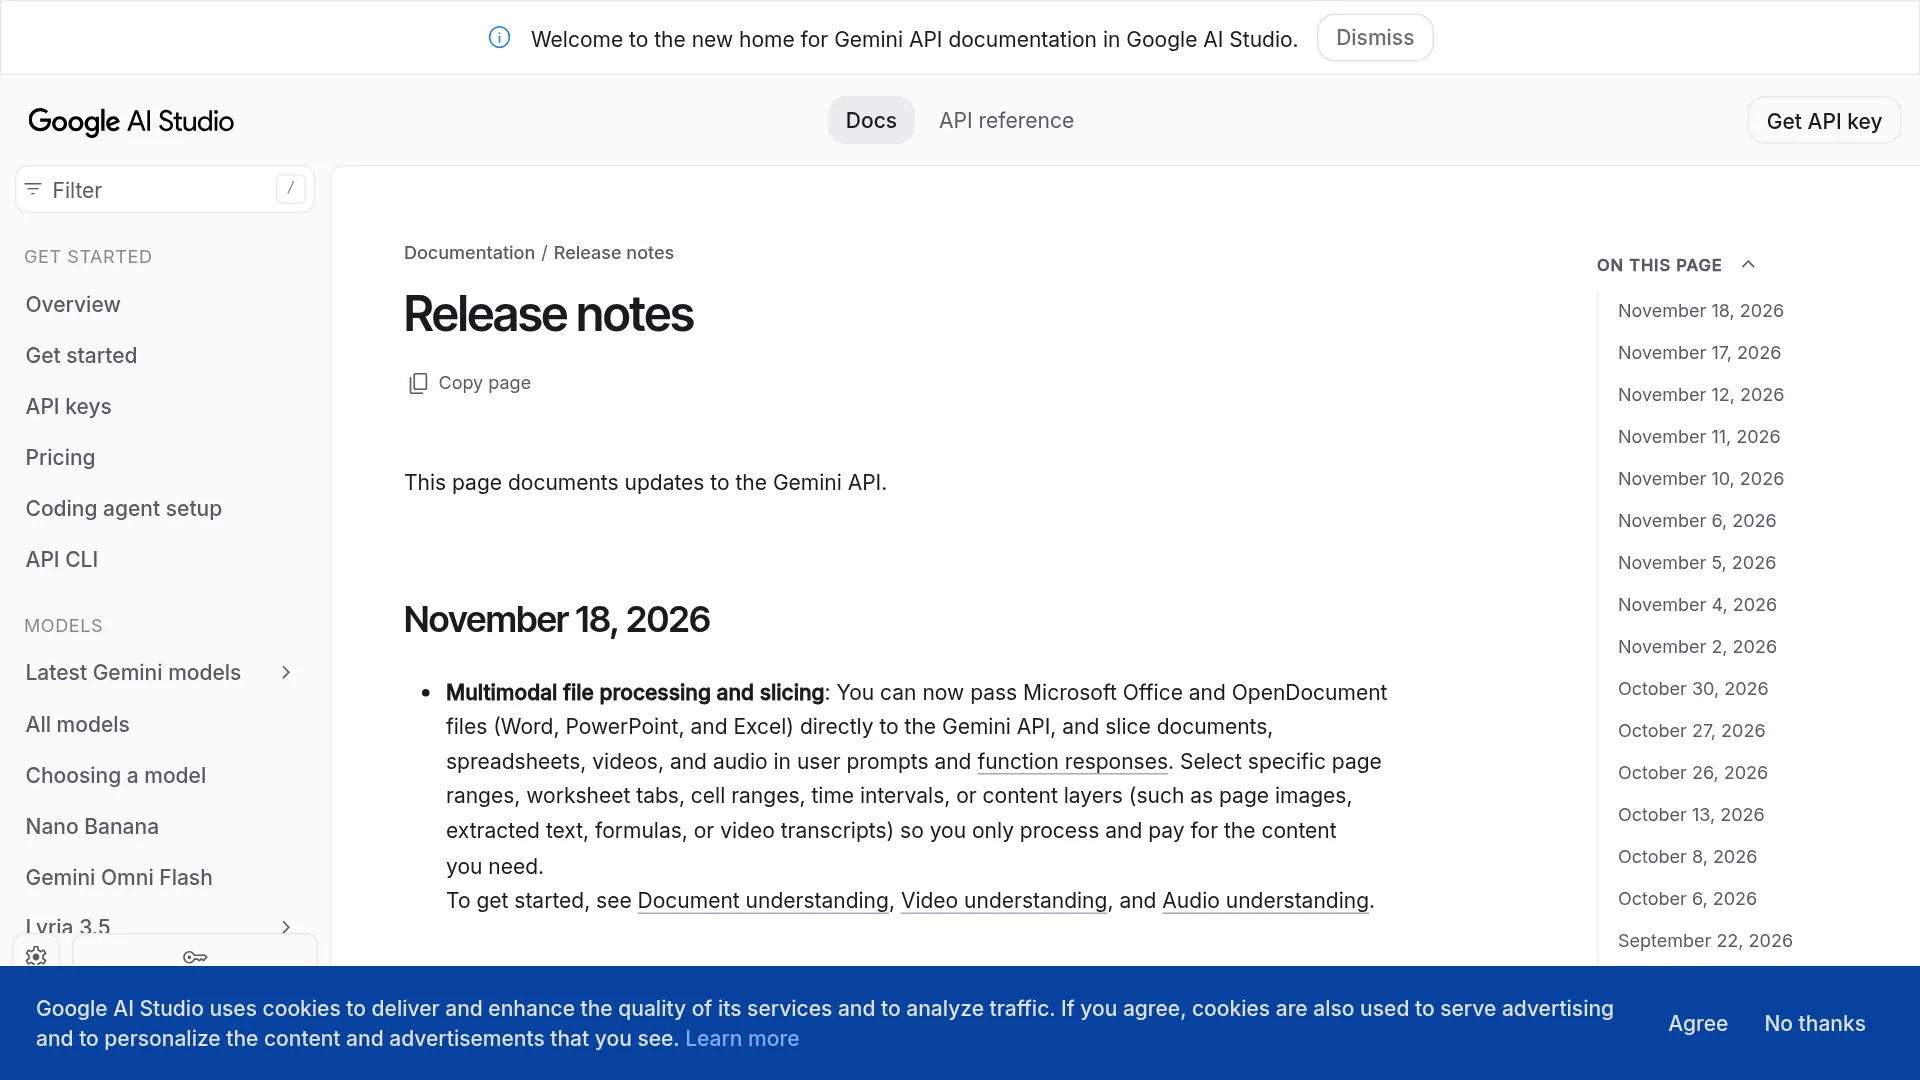
Wer Arbeitsmappen vor jedem Gemini-API-Aufruf noch in CSV umwandelt, kann diesen Umweg ab sofort streichen. Seit dem 18. November 2026 verarbeitet die Gemini API Word-, Excel- und PowerPoint-Dateien direkt. Google verspricht, dass sich damit nur der jeweils ausgewählte Ausschnitt „verarbeiten und bezahlen“ lässt (Google-AI-Studio-Changelog).
Der Spareffekt entsteht allerdings nur mit expliziten Selektoren. Ohne diese kann weiterhin die komplette Datei verarbeitet werden, wie Leser @zg0820 anmerkt.
Warum der bisherige Excel-Workflow an Grenzen stieß
Die ältere, dokumentierte Verarbeitung las aus einer XLSX-Datei lediglich das erste Tabellenblatt als CSV ein. Wer an andere Blätter herankommen wollte, musste Arbeitsblätter umsortieren oder die Arbeitsmappe aufteilen:
„In der Dokumentation steht weiterhin, dass nur das erste Tabellenblatt einer XLSX-Datei als CSV gelesen wird.“ — @aitrackerbot
Der Eintrag vom 18. November ersetzt diesen Workaround durch die direkte Verarbeitung von Office- und OpenDocument-Dateien. Zusätzlich lassen sich Inhalte sowohl in Prompts als auch in Function Responses gezielt eingrenzen (Analyse von DocsWatch).
Was sich mit dem Update vom 18. November konkret ändert
Auf die Erweiterung vom 5. November für PPT, ODP und ODS setzt der neue Eintrag zwei Funktionen obendrauf:
- Office- und OpenDocument-Dateien direkt verarbeiten. Word-, PowerPoint- und Excel-Dateien lassen sich ohne vorherige PDF- oder Textkonvertierung übergeben.
- Inhalte gezielt ausschneiden. Unterstützt werden Seitenbereiche, Tabellenblätter, A1-Zellbereiche, Zeitintervalle sowie Inhaltsebenen wie Seitenbilder, extrahierter Text, Formeln und Transkripte.
Das Zuschneiden funktioniert sowohl in Prompts als auch in FunctionResponse-Teilen. Ein Tool kann damit beispielsweise nur einen bestimmten Zellbereich statt der kompletten Arbeitsmappe zurückgeben (Zusammenfassung von AI Index).
Welche Dateien jetzt unterstützt werden – und auf welchen Modellen
Die am 18. November 2026 UTC aktualisierte Firebase-Seite zu den Eingabeanforderungen ordnet die Office-Unterstützung den Gemini-4.x-Modellen zu (Firebase-AI-Logic-Dokumentation):
| Familie | Endungen | MIME-Typ |
|---|---|---|
| Word | .doc, .docx, .dotx | application/msword, application/vnd.openxmlformats-officedocument.wordprocessingml.document, application/vnd.openxmlformats-officedocument.wordprocessingml.template |
| PowerPoint | .ppt, .pptx | application/vnd.ms-powerpoint, application/vnd.openxmlformats-officedocument.presentationml.presentation |
| Excel | .xls, .xlsx | application/vnd.ms-excel, application/vnd.openxmlformats-officedocument.spreadsheetml.sheet |
| OpenDocument | .odt, .odp, .ods | application/vnd.oasis.opendocument.text, application/vnd.oasis.opendocument.presentation, application/vnd.oasis.opendocument.spreadsheet |
| Grundformat | .pdf, .txt | application/pdf, text/plain |
Die offiziellen Limits bleiben unverändert – auch durch Slicing:
- 50 MB pro Datei, 1.000 Seiten pro Datei und 3.000 Dokumentdateien pro Anfrage.
- 20 MB Gesamtgröße für Inline-Daten im Base64-Format; größere Dateien benötigen Cloud-Storage-URLs.
Eine unbestätigte Information aus der Community sei separat erwähnt: Ein Leser des Changelogs berichtet von einer Office-spezifischen Grenze von etwa 2.000 Seiten oder Folien (@lawson_ste3476). Google hat diese Grenze nicht dokumentiert; darauf sollte man seine Architektur nicht auslegen.
Word und PowerPoint: Seitenbereiche mit wählbarer Inhaltsebene
DocumentMetadata wurde in öffentlichen Discovery-Dokumenten für v1beta/v1alpha gefunden, fehlt aber in der stabilen Version v1 (Schema-Bericht von ORIENS):
startPage: erste Seite, beginnend bei 1, inklusive.endPage: letzte Seite, beginnend bei 1, inklusive.contentLayers:PAGE_IMAGE(gerendertes Bild; laut Bericht der Standard, wenn Metadaten vorhanden, aber keine Ebenen angegeben sind) oderPAGE_TEXT(extrahierter Text).
PAGE_IMAGE ist die richtige Wahl für Layouts, Folien und gescannte Seiten. Für durchsuchbare Inhalte wie Verträge genügt PAGE_TEXT. Firebase beschreibt das zugrunde liegende Modell so: PDFs werden als Bilder behandelt, wobei eine Seite als ein Bild zählt. Bilder mit höchstens 384 Pixeln auf beiden Seiten werden mit 258 Tokens berechnet (Firebase-AI-Logic-Dokumentation).
Excel: Tabellenblätter, Zellbereiche und drei Inhaltsebenen
SpreadsheetMetadata wird laut Discovery-Schema an den Dateiteil aus inline_data oder file_data angehängt – entweder in einem Part oder einem FunctionResponsePart (Schema-Bericht von ORIENS):
sheetIndex: Reihenfolge des Tabellenblatts in der Arbeitsmappe, beginnend bei 1. Der Discovery-Text fürv1betanennt bei fehlender Angabe alle Tabellenblätter; die Texte der Python- und JavaScript-SDKs sprechen dagegen vom ersten Blatt. Daher sollte der Wert immer gesetzt werden.visibleCells: A1-Bereich wieA1:G35; ohne Angabe wird der belegte Bereich des ausgewählten Tabellenblatts verwendet.contentLayers:DATA(Werte, verbundene Zellen, Formatierung),FORMULAS(Ausdrücke samt berechneten Ergebnissen) undVISUAL(gerendertes Bild). Als Standard wird[DATA, FORMULAS]angegeben.
Für Prüfungen eignen sich DATA und FORMULAS. Bei Layoutfragen und verbundenen Zellen kommt VISUAL hinzu. Für eine einzelne Abfrage sollte der Bereich in visibleCells so eng wie möglich gefasst werden.
Nur den benötigten Ausschnitt senden: Python-REST-Beispiel
Die folgenden Feldnamen entsprechen der Discovery-Revision 20261116. Die Struktur ist Beta und fehlt in der stabilen Version v1. Vor dem produktiven Einsatz sollte sie daher mit dem installierten SDK abgeglichen werden.
import os
from google import genai
import requests

client = genai.Client()  # reads GEMINI_API_KEY
workbook = client.files.upload(
    file="q3_revenue.xlsx",
    config={"mime_type": "application/vnd.openxmlformats-officedocument.spreadsheetml.sheet"},
)

api_key = os.environ["GEMINI_API_KEY"]
url = f"https://generativelanguage.googleapis.com/v1beta/models/gemini-4-hydrogen:generateContent?key={api_key}"
payload = {
    "contents": [{
        "parts": [
            {
                "fileData": {
                    "fileUri": workbook.uri,
                    "mimeType": "application/vnd.openxmlformats-officedocument.spreadsheetml.sheet",
                },
                "spreadsheetMetadata": {
                    "sheetIndex": 2,
                    "visibleCells": "A1:G35",
                    "contentLayers": ["DATA", "FORMULAS"],
                },
            },
            {"text": "Summarize revenue variance in this range using computed values."},
        ]
    }]
}
r = requests.post(url, json=payload, timeout=120)
r.raise_for_status()
print(r.json()["candidates"][0]["content"]["parts"][0]["text"])
Für Word werden stattdessen "documentMetadata": {"startPage": 12, "endPage": 18, "contentLayers": ["PAGE_TEXT"]} und der MIME-Typ für .docx verwendet. PowerPoint nutzt dieselbe Struktur mit documentMetadata, den MIME-Typ für .pptx und Seitenzahlen für die Folien.
Die Kostenrechnung: Wann sich Slicing tatsächlich lohnt
Im Changelog und in den Firebase-Preishinweisen gibt es keine eigene Slicing-SKU. Die Ersparnis entspricht daher den vermiedenen Eingabe-Tokens zu den regulären Tarifen. Im Changelog wird gemini-4-hydrogen mit 1,50 $ pro 1 Million Eingabe-Tokens geführt.
Beispielrechnung für einen Bericht mit 200 Seiten, von denen nur die Seiten 12–18 relevant sind. Die angenommenen 800 Tokens pro Textseite sind dabei lediglich eine Beispielannahme und kein dokumentierter Tarif:
- Vorher: 200 Seiten als Bilder x mindestens 258 Tokens pro Seitenbild = 51.600 Eingabe-Tokens. Kosten: 51.600 / 1.000.000 x 1,50 $ = 0,0774 $.
- Nachher: 7 Seiten als extrahierter Text x angenommene 800 Tokens = 5.600 Eingabe-Tokens. Kosten: 5.600 / 1.000.000 x 1,50 $ = 0,0084 $.
- Ersparnis: bei dieser Anfrage rund 89 % der Eingabekosten, noch ohne Ausgabetokens. Für eine realistische Planung sollte die gemessene Seitendichte eingesetzt werden.
Die Größe der Ausschnitte sollte mit der eigenen Arbeitsmappe getestet werden: Viele winzige Aufrufe können in Summe teurer sein als ein sinnvoll gewählter Bereich (@zg0820).
Damit es zuverlässig funktioniert: Prüf- und Migrations-Checkliste
Ein erfolgreicher Upload beweist noch nicht, dass die Datei auch korrekt geparst wurde. Jede Pipeline sollte deshalb separat geprüft werden:
- Parsing nachweisen. Zeilenanzahl, Tabellenname oder Seitenzahl zurückgeben lassen und mit der Quelldatei vergleichen.
- Jeden Selektor setzen. Dazu gehören
sheetIndex,visibleCellsoder ein Seitenbereich sowiecontentLayers. - Inhaltsebene passend zur Frage wählen. Diagramme und Layouts benötigen
VISUALoderPAGE_IMAGE; Prüfungen brauchenDATAplusFORMULAS; für die Suche eignet sichPAGE_TEXT. - Verhalten bei ungültigen Bereichen in der Staging-Umgebung testen. Das Schema legt nicht fest, ob eine ungültige Seite oder ein falscher Bereich einen Fehler auslöst, begrenzt oder einfach keine Ergebnisse liefert.
- Upload-Grenzen einhalten. Eine 60-MB-Datei scheitert weiterhin am 50-MB-Limit. Für Inline-Daten über 20 MB sollten Cloud-Storage-URLs verwendet werden.
- In dieser Reihenfolge migrieren. Excel-Splitter auf
sheetIndexplusvisibleCellsumstellen; Report-Rasterizer auf Seitenbereiche mitPAGE_TEXTmigrieren undPAGE_IMAGEfür Layouts reservieren; ganzseitige Tool-Antworten durch geschnittene Function Responses ersetzen.
Offen bleibt laut den zitierten Quellen, wie ausgeblendete Zeilen, verbundene Zellen, Diagramme, eingebettete Bilder sowie passwortgeschützte, makrofähige oder beschädigte Dateien behandelt werden. Dazu machen weder die Ankündigung zum Slicing noch die oben verlinkte Firebase-Seite zu den Eingabeanforderungen Angaben. Diese Fälle sollten mit den eigenen Vorlagen getestet werden.
FAQ
Kann ich Inhalte auch innerhalb von Function Responses auswählen?
Ja. Tools können eine Datei-URI zusammen mit SpreadsheetMetadata oder DocumentMetadata zurückgeben. Das Modell erhält dann nur den relevanten Ausschnitt – passend für agentische Dokumenten-Workflows.
Welche API-Version unterstützt Slicing?
Die Funktion wurde in der Discovery-Revision 20261116 für v1beta und v1alpha beobachtet, nicht jedoch in der stabilen Version v1. Versionen sollten festgesetzt und mit dem Zielmodell getestet werden, bevor der Einsatz in Produktion beginnt.
Warum meldet Gemini, dass die hochgeladene Datei nicht sichtbar ist?
MIME-Typ, Dateigröße und explizite Selektoren anhand der Tabelle und der oben genannten Limits prüfen. Anschließend sollte das Modell Tabellenblattnamen oder Seitenzahlen wiederholen, damit sich das Parsing verifizieren lässt.
Weiterführend: Der Gemini-4-Carbon-vs.-Hydrogen-API-Guide hilft bei der Auswahl des Modells für eine Office-Pipeline.