Auf den ersten Blick ist die Sache klar: Astra verlangt $8 für Input und $40 für Output je Million Tokens, Sol $2 beziehungsweise $10. Damit kostet Astra nominell das Vierfache. In der Praxis zählt jedoch der Preis pro erledigter Aufgabe: Bei FrontierCode liegt Sol für Routine-Coding mit $1.29 statt $5.97 bei rund einem Fünftel der Kosten. Astra liegt dagegen in den anspruchsvollsten domänenspezifischen Tests etwa 4 bis 10 Punkte vorn — ein Vorteil, wenn ein sauberer Durchlauf mehrere Versuche ersetzt.
Preise, Limits und Verfügbarkeit von Astra und Sol
OpenAI positioniert Astra für die schwierigsten Projekte, Sol dagegen für den Alltag (Launch-Ankündigung). Wichtig ist die Trennung zwischen zwei Abrechnungen: Die Nutzung in ChatGPT- oder Codex-Plänen ist unabhängig vom API-Verbrauch. API-Aufrufe werden weder über das Plan-Kontingent bezahlt noch verringern sie dieses. Beide Modelle bieten ein Kontextfenster von 1,050,000 Tokens, maximal 922,000 Input-Tokens und 128,000 Output-Tokens pro Anfrage. Unterstützt werden Text und Bilder als Input sowie Text als Output. Die Modell-IDs für die Responses- und Chat-Completions-APIs lauten gpt-6.2-astra und gpt-6.2-sol.
Standardpreise der API pro Million Tokens:
| Modell | Input | Gecachter Input | Cache-Schreiben (30 Min.) | Output |
|---|---|---|---|---|
| GPT-6.2 Astra | $8.00 | $0.40 | $10.00 | $40.00 |
| GPT-6.2 Sol | $2.00 | $0.10 | $2.50 | $10.00 |
| GPT-6 Astra (Vorgänger) | $10.00 | $1.00 | $12.50 | $50.00 |
| GPT-6.1 Sol (Vorgänger) | $2.00 | $0.10 | $2.50 | $10.00 |
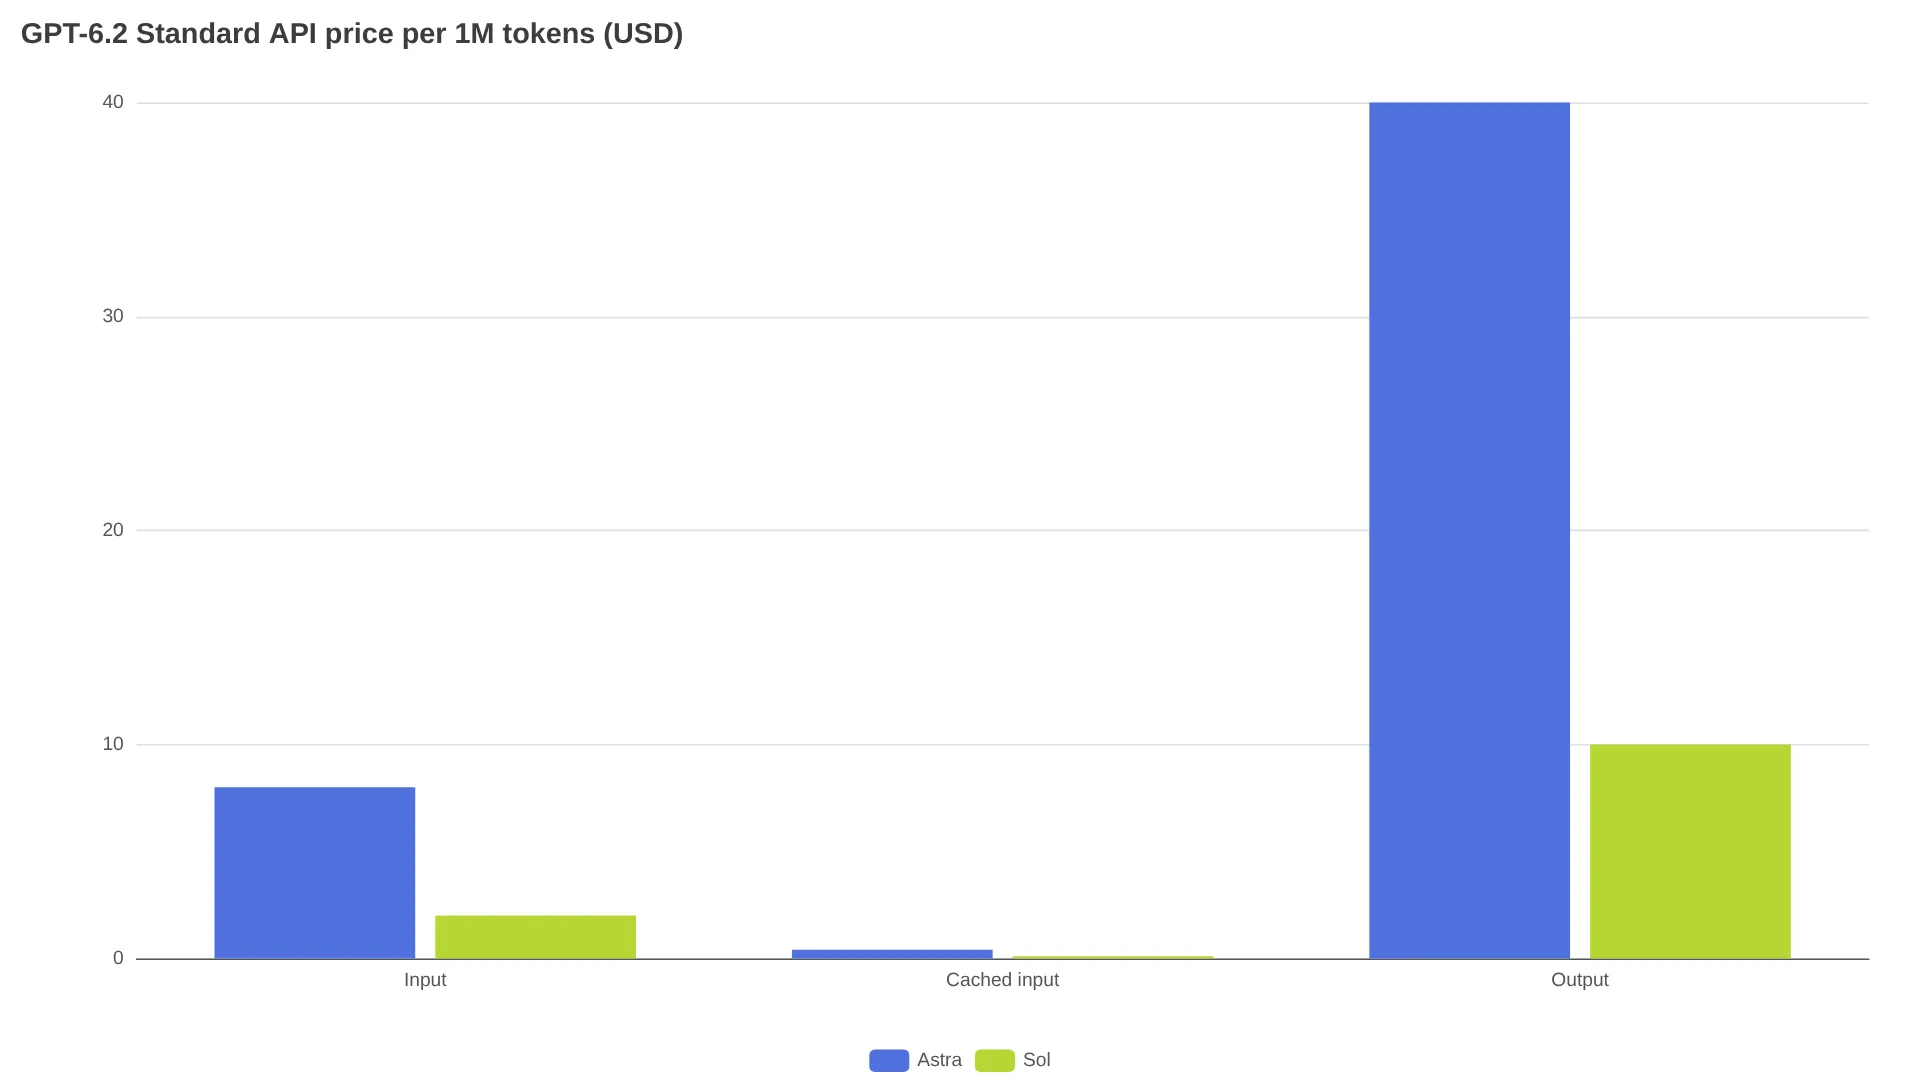
Gegenüber GPT-6 Astra ist Astra beim Input und Output 20% günstiger, beim gecachten Input sogar 60%. Sol behält die Preise von GPT-6.1 Sol bei. Seit dem Launch am 17. November 2026 sind beide Modelle allgemein über die API verfügbar. Batch kostet 50% weniger als Standard, Hintergrundfenster liegen 30–40% darunter (Aufschlüsselung der Tarifstufen bei GenAI Brief).
Drei Kostenfallen, die den Endpreis verändern
1. Das Befüllen des Caches kostet Geld. Gecachte Reads kosten 5% des regulären Input-Preises: $0.40 bei Astra und $0.10 bei Sol. Das Schreiben in den Cache kostet bei 30 Minuten TTL das 1.25-Fache des Input-Preises — $10.00 für Astra, $2.50 für Sol — und bei 12 Stunden Aufbewahrung das 2.5-Fache, laut Preistabelle von GenAI Brief. Beispiel: Nach einem Cache-Miss 108,000 History-Tokens neu zu schreiben, kostet vor dem Output 108,000 × $10/M = $1.08 bei Astra oder 108,000 × $2.50/M = $0.27 bei Sol.
2. Ab 272,000 Input-Tokens wird die gesamte Anfrage teurer. Oberhalb von 272K Input-Tokens verdoppelt sich der Input-Preis: bei Astra von $8 auf $16, bei Sol von $2 auf $4. Der Output verteuert sich um das 1.5-Fache, also bei Astra von $40 auf $60 und bei Sol von $10 auf $15. In einem Preisbeispiel von GenAI Brief reichten 20K zusätzliche History-Tokens, um einen Astra-Turn von $0.344 auf $0.624 zu verteuern: 81% mehr Kosten bei nur 7% mehr Input. History vor der 272K-Grenze zusammenfassen oder kürzen; verändert sich dadurch der gecachte Präfix, muss ein Cache-Miss einkalkuliert werden.
3. Geschwindigkeitstarife multiplizieren alle Preise. Fast kostet das Doppelte von Standard. Ultrafast kostet bis zum 28. Februar 2027 das Dreifache, ab dem 1. März 2027 das Sechsfache. Ultrafast ist nur mit US-Residency verfügbar; Standard, Fast und Batch unterstützen die USA und die EU. Das geht aus den Tarifregeln von GenAI Brief und der Dokumentation zu OpenAIs Processing-Tiers hervor. Beim 3x-Tarif kostet Astra-Output $120/M, beim 6x-Tarif $240/M.
Entscheidend sind Kosten pro Aufgabe, nicht pro Token
Bei gleicher Tokenmenge kostet Astra das Vierfache von Sol. Der höhere Preis rechnet sich nur, wenn Astra weniger Tokens benötigt, weniger Anläufe braucht oder teure manuelle Nacharbeit vermeidet. Die Break-even-Regel: Ein Astra-Versuch muss bei gleichem Token-Footprint mehr als vier Sol-Versuche ersetzen oder die gewichtete Tokenmenge um etwa 75% senken, damit Astra beim direkten API-Aufwand gewinnt.
Gemeldete Aufgabenkosten — Benchmarks, Effort-Einstellungen und Berechnungsmethoden unterscheiden sich. Deshalb sind die Werte als Tendenz zu verstehen und mit eigenen Replays zu überprüfen:
| Quelle / Workload | Astra | Sol | Einordnung |
|---|---|---|---|
| Artificial Analysis Intelligence Index, max. Effort | 62 bei $4.00/Aufgabe, 10.4 Min. (GPT-6 Astra: 57 bei $6.24) | 57 bei $1.01/Aufgabe, 7.9 Min. | Sol erreicht den GPT-6-Astra-Score von 57 zu ungefähr einem Sechstel der Aufgabenkosten von $6.24 |
| FrontierCode 2.0 über DataCamp, max. Effort | 44.2% bei $5.97/Aufgabe | 43.8% bei $1.29/Aufgabe | 0.4 Punkte Unterschied bei etwa dem 5-Fachen der Aufgabenkosten; für Coding überwindet Astra diese Hürde hier nicht |
| Harvey LAB-AA / SecureSWE / Terminal-Bench-Science über DataCamp | 15.0% / 65.7% / 77.1% | 11.1% / 55.6% / 68.0% | Hier ist der Abstand von Astra am größten; Astra für Recht, sicheren Code und Wissenschaft testen |
| BenchCAD 2.1 Core über DataCamp | 82.5% | 73.1% | Der CAD-Vorsprung von rund 9 Punkten spricht für einen Astra-Test bei CAD-Aufgaben |
| DataCamp-Nachbau einer Folie, Einzeltest | $0.22, 4,968 Output-Tokens | $0.07, Schriftgrößen exakt | Bei dieser Template-Aufgabe kein sichtbarer Qualitätsunterschied; Sol gewann bei den Kosten |
| Agents' Last Exam laut DataCamp-Zusammenfassung von OpenAI-Zahlen, Sol High vs. altes Astra Max | — | Sol High 72.0% bei $0.69/Aufgabe vs. GPT-6 Astra Max 73.1% bei $8.99 | Rund 1 Punkt weniger bei etwa 1/13 der Kosten in dieser Einstellung |
Ein Rechenbeispiel: Kostet ein Sol-Versuch $0.10 und gelingen 2 von 3 Versuchen, entstehen $0.15 pro akzeptiertem Ergebnis. Astra kann das bei $0.40 pro Versuch nicht allein über eine höhere Erfolgsquote schlagen. Astra gewinnt, wenn die Sol-Erfolgsquote stark einbricht — etwa bei 1 Erfolg in 5 Versuchen, also $0.50 pro akzeptiertem Ergebnis — während Astra direkt im ersten Versuch für $0.40 gelingt. OpenAI berichtet für Astra auf GDPval v2 von 22% weniger Output-Tokens; solche Herstellerangaben sollten als Richtungshinweis verstanden werden.
Für Routine-Coding und Agenten mit hohem Volumen ist Sol der Startpunkt. Astra lohnt sich zum Testen für Recht, CAD oder lange wissenschaftliche Läufe. Zu Astra sollte nur geroutet werden, wenn total spend / accepted tasks einschließlich Wiederholungen und Nacharbeit niedriger ausfällt.
Stabiler Präfix spart Cache-Kosten
Werden mitten in einer Unterhaltung Anweisungen, Tools, Schemas oder frühere Outputs verändert, kann das bei GPT-6.2 den Cache ungültig machen und erneutes Reasoning auslösen.
So bleibt das Präfix-Caching erhalten (Integrationshinweise von GenAI Brief, OpenAI-Modelldokumentation):
- Eine neue Developer-Message oder
configuration_updateanhängen, statt die ersten Nachrichten umzuschreiben. - Tools über
additional_toolsergänzen oder mittool_choice/allowed_toolssteuern, statt die Tool-Liste während eines Threads auszutauschen. - Alte Tool-Outputs kürzen und Bilder vor dem ersten Versand verkleinern.
- Vor der Verlagerung von Production-Traffic mit Prompt Cache Diagnostics und Responses-
input_transformations(prefix_mismatch) diagnostizieren.
Checkliste für die Migration zu Astra und Sol
Nach dem Migrationsleitfaden von EpiFive und den Integrationsregeln von GenAI Brief, abgeglichen mit OpenAIs Modellvergleich:
modelaufgpt-6.2-astraodergpt-6.2-soländern.- Mit
reasoning.effort: mediumin Responses beziehungsweisereasoning_effort: mediumin Chat Completions beginnen.nonewird abgelehnt; für Calls mit kurzer Latenzlowverwenden. temperature,top_psowielogprobs/top_logprobsaus den Requests entfernen. Tool Calling auf die Responses API umstellen.- Bei einer Migration von GPT-5.5 oder älter
prompt_cache_retentiondurchprompt_cache_options.ttl: "30m"ersetzen und die Kosten für Cache-Schreibvorgänge einplanen. - Bei Zero Data Retention wird
storealsfalsebehandelt — frühere Output-Items müssen in der richtigen Reihenfolge erneut gesendet werden, einschließlich verschlüsselter Reasoning-Items. - Je Modell 30 kurze Aufgaben wiederholen und Erfolgsquote, Wiederholungen, Output-Tokens sowie Kosten pro akzeptiertem Ergebnis messen. Zusätzlich eine lange Agenten-Session mit stabilem Präfix und eine mit einer Präfix-Änderung testen; dabei Cache-Hit-Rate und gesamte Aufgabenkosten erfassen.