Hunderte Tools für einen Agenten bereitzuhalten, muss nicht mehr bedeuten, ihre kompletten Parameter-Schemas bei jeder Anfrage mitzuschleppen. Tool Retrieval in der Gemini API hält zunächst nur Namen und Beschreibungen vor und lädt das vollständige Schema erst, wenn es für die Aufgabe gebraucht wird. Allerdings verursacht jede Suche einen zusätzlichen Modelldurchlauf. Wer praktisch in jedem Turn sucht, kann deshalb am Ende mehr statt weniger bezahlen.
Google hat die Funktion laut Ankündigung am 19. November 2026 als Preview exklusiv für die Interactions API veröffentlicht. Sie ergänzt das Tool tool_search und das Flag defer_loading: true. Bei aufgeschobenen Tools bleiben Name und Beschreibung sichtbar, das Parameter-JSON wird jedoch nicht in den Kontext aufgenommen. Eine separate Gebühr gibt es nicht; es gelten die üblichen Preise für Eingabe, gecachte Eingabe und Ausgabe.
Warum 200 Tools schon vor dem ersten Aufruf 164.000 Tokens kosten konnten
Entscheidend für die Prompt-Kosten ist nicht allein die Anzahl der Tools, sondern die Größe ihrer Schemas. Bei umfangreichen Katalogen können sie den gesamten Prompt dominieren.
Eine unabhängige technische Einordnung der Google-Dokumentation zeigt den Größenunterschied anhand eines Beispiels: Eine Bibliothek mit 200 Tools, von denen pro Anfrage nur wenige zum Einsatz kommen, landet bei rund 164.000 Input-Tokens ohne Aufschieben gegenüber etwa 23.650 mit Tool Retrieval. Das sind gerundete Illustrationswerte aus der Analyse, kein Benchmark. Der Kernpunkt: Für Schemas, die nie verwendet werden, fallen keine Kosten mehr an.
Hinzu kommt die Trefferqualität. Wenn Dutzende ähnliche Schemas gleichzeitig im Kontext stehen, hat das Modell mehr Möglichkeiten, das falsche auszuwählen. Google positioniert Tool Retrieval daher als Hilfe sowohl bei der Token-Last als auch bei der Tool-Auswahl. Eine Genauigkeitskennzahl wurde nicht veröffentlicht; diesen Teil sollten Sie daher mit Ihren eigenen Aufgaben prüfen.
So arbeitet Gemini Tool Retrieval mit tool_search und defer_loading
Die Einrichtung besteht aus zwei verkürzten Deklarationsfragmenten: einem tool_search-Eintrag {"type": "tool_search"} sowie "defer_loading": true an jedem aufgeschobenen Tool. Die vollständige Request-Struktur zeigt die Dokumentationsanalyse. Das Modell sieht weiterhin Name und Beschreibung jedes aufgeschobenen Tools. Laut dem Erklärstück zu defer_loading sieht das Modell bei gesetztem short_description diesen Wert; andernfalls den ersten Satz der vollständigen Beschreibung.
Im serverseitigen Ablauf passiert alles innerhalb einer Anfrage:
- Das Modell erzeugt einen
tool_search_call, etwa mit der Anfrage nachissue_refund. - Die API liefert ein
tool_search_resultmit dem vollständigen Schema zurück. - Das Modell erzeugt den eigentlichen
function_call(Googles Refund-Beispiel verwendetorder_id: "A-1042"undamount: 40mit dem Modellgemini-4-hydrogen). - Ihr Code führt den Aufruf aus und gibt ein
function_resultzurück.
Protokollieren Sie alles in interaction.steps. Wird das falsche Tool geladen, prüfen Sie im Trace zuerst, ob Namen oder Beschreibungen zu vage sind.
Server oder Client: eine Anfrage oder ein zusätzlicher Roundtrip
| Modus | Wer sucht? | Zu erstellender Index | Zusätzliche Roundtrips | Geeignet für |
|---|---|---|---|---|
| Serverseitig (Standard) | Gemini | Keiner — "There's no index to build or host." | Keine, dieselbe Anfrage | Große, überwiegend statische Bibliotheken; komplette MCP-Server |
Clientseitig ("execution": "client") | Ihre Anwendung | Ihre Registry oder Ihr Embedding-Index | Einer pro Suche | Benutzerbezogene Berechtigungen, private Registries, während der Unterhaltung hinzugefügte Tools |
Die serverseitige Suche benötigt keinen gehosteten Index und wird in derselben Antwort abgeschlossen. Wie die Dokumentationsanalyse beschreibt, verschiebt defer_loading: true an einem mcp_server-Tool alle Tools, die dieser Server bereitstellt.
Im Client-Modus verwenden Sie tool_search mit "execution": "client" — im Beispiel heißt es search_tools und erwartet den erforderlichen String query. Ihre Anwendung gibt die Treffer in einem function_result zurück und ruft anschließend client.interactions.create mit previous_interaction_id auf. Laut derselben Analyse ist pro Anfrage nur ein tool_search möglich; beide Modi lassen sich nicht mischen.
Setzen Sie auf den Client-Modus, wenn Berechtigungen pro Nutzer gelten oder Integrationen mitten in einer Unterhaltung auftauchen können. Eine serverseitige Suche über einen gemeinsamen Katalog filtert laut der zitierten Analyse nicht automatisch nach individuellen Nutzerrechten. Ebenfalls laut dieser Einordnung erlaubt nur der Client-Modus Tools, die mitten in der Unterhaltung hinzukommen, ohne alles vorab deklarieren zu müssen.
Die Kostenrechnung: 26 Tokens sofort, später ein weiterer voller Durchlauf
Für Tool Retrieval selbst berechnet Google laut Ankündigung nichts zusätzlich — "Tool Retrieval has no separate charge." Laut der Analyse zur Token-Ökonomie bleiben vier abgerechnete Kostenpunkte:
tool_searchfügt jeder Anfrage einen kleinen festen Block an Input-Tokens hinzu.- Die zitierte Analyse schätzt für jede aufgeschobene Zeile aus Name und Beschreibung rund 26 Tokens.
- Jede serverseitige Suche startet einen weiteren Modelldurchlauf über den aktuellen Kontext. Abgerechnet wird dies laut Analyse als
total_tool_use_tokens, ungefähr in Höhe des Prompt-Inputs abzüglich Cache-Treffern. - Jedes geladene Schema bleibt für den Rest der Unterhaltung als Input abrechenbar und kann nicht wieder entladen werden.
| Workload (illustrative Schätzwerte aus der zitierten Analyse) | Ohne Retrieval | Mit Retrieval | Fazit |
|---|---|---|---|
| 200 Tools, wenige pro Aufgabe genutzt | ~164.000 Tokens | ~23.650 Tokens | Spart |
| 10 Tools, 30k Kontext, Suche fast in jedem Turn | ~68.000 Tokens | ~92.830 Tokens | Teurer |
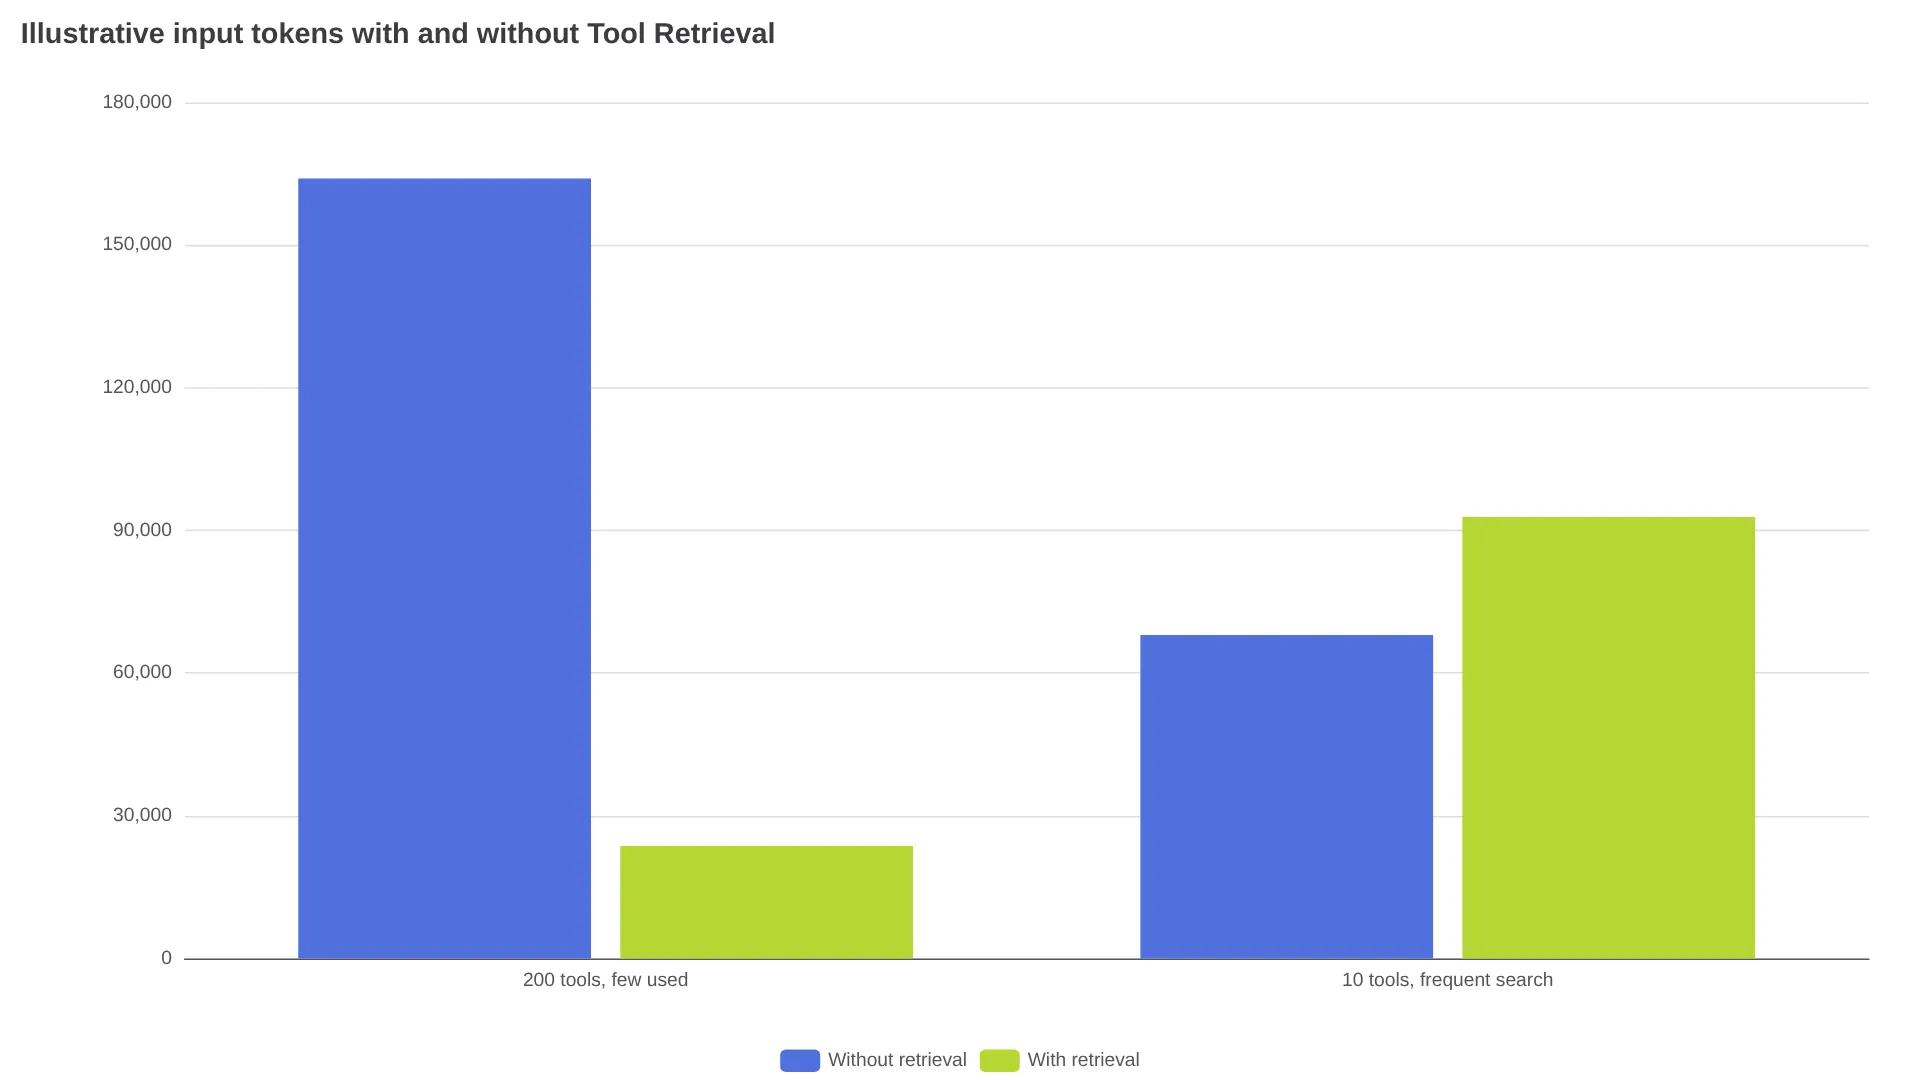
Googles Rat in derselben Ankündigung: "Measure it against your own traffic."
"Im serverseitigen Modus ... fügt jede serverseitige Suche einen weiteren Modelldurchlauf über den aktuellen Kontext hinzu ... Eine große Bibliothek, bei der pro Aufgabe nur wenige Tools genutzt werden, kann also profitieren. Eine kleine Bibliothek mit langer Unterhaltung und häufigen Suchen kann teurer werden." — @tekroch
Das Aufschieben kann den gecachten Präfix stabilisieren, einen Prompt aber auch unter die Mindestgröße für Caching drücken. Verfolgen Sie laut zitierter Analyse daher neben den Input-Tokens auch die Cache-Hit-Rate.
Wann sich Aufschieben lohnt — und wann Tools geladen bleiben sollten
Bei kleinen Bibliotheken sollten Sie zunächst statisches Laden benchmarken. Suchhäufigkeit und Schema-Größe sind wichtiger als jede pauschale Tool-Anzahl. Bei großen Katalogen mit 1–3 Tools pro Aufgabe lässt sich der Long Tail serverseitig aufschieben, während häufig genutzte Tools geladen bleiben sollten — also Tools, die in den meisten Anfragen vorkommen. Bei nutzerbezogenen oder während des Chats hinzukommenden Tools ist der Client-Modus passend; planen Sie einen Roundtrip pro Suche ein.
Die zitierten Implementierungshinweise nennen drei Fehlerquellen, die Sie absichern sollten:
- Schieben Sie kein Tool auf, das in Systemanweisungen oder der Ausgabe eines anderen Tools genannt wird. Das Modell könnte es ohne vorherige Suche aufrufen, sodass der nächste Turn fehlschlägt.
- Aufgeschobene Funktionen benötigen weiterhin vollständige
parametersim Request. Nur Name und Beschreibung können ein leeres, nicht aufrufbares Schema zurückgeben. - In zustandslosen Anwendungen müssen Sie
tool_search_call,tool_search_result, Signaturen und das vollständigetools-Array in jedem Turn unverändert erneut senden.
Die Qualität der Beschreibungen entscheidet über das Retrieval: Bevor das Modell ein Schema sieht, wählt es anhand von Namen und Beschreibungen. "Search customer invoices by date range" wird gefunden; "Invoice helper" kollidiert mit anderen Treffern. Aufschieben ist keine Sicherheitsgrenze — Namen und Beschreibungen aufgeschobener MCP-Tools bleiben als Prompt-Input sichtbar, und geladene Tools laufen mit den von Ihnen gewährten Berechtigungen, wie die Sicherheitsanalyse erläutert.
Was die Preview noch nicht bietet
Die Funktion ist nur als Preview verfügbar, ausschließlich in der Interactions API und auf der Oberfläche v1beta. Es gibt keine Unterstützung für generateContent; defer_loading auf einem nicht unterstützten Modell führt laut Dokumentationsanalyse zu HTTP 400.
Die Modellabdeckung ist derzeit enger, als die Überschrift vermuten lässt: Die Ankündigung nennt Gemini 3.6 und neuer, einschließlich aller Gemini-4-Modelle. Die zitierte Analyse berichtet jedoch, dass die aktuelle Live-Dokumentation gemini-4-hydrogen, gemini-4-argon, gemini-3.8-flash und gemini-3.6-flash aufführt. Prüfen Sie Ihr Modell in der Dokumentation, bevor Sie von Unterstützung verwandter Modelle ausgehen. Ein GA-Termin wurde nicht angekündigt. Anthropic veröffentlichte dieselbe defer_loading-Idee im November 2025 als Beta; Googles Unterschiede sind laut Launch-Bericht das serverseitige Aufschieben für MCP und der Client-Modus.
| Struktur Ihrer Bibliothek | Passender Modus | Erster Schritt |
|---|---|---|
| Klein, stabil | Statisches Laden | Schema-Tokens messen, bevor Sie Komplexität hinzufügen |
| 50–200 Tools, wenige pro Aufgabe genutzt | Serverseitiges Aufschieben | Long Tail aufschieben, häufig genutzte Tools geladen lassen |
| Nutzerbezogene oder während des Chats hinzukommende Tools | Clientseitiges Retrieval | Berechtigungsbewusste Suche entwickeln |
| Jedes Tool wird in jedem Turn genutzt | Statisches Laden | Der Such-Overhead übersteigt die Einsparung wahrscheinlich |
Starten Sie mit einem Abschnitt des Long Tails und vergleichen Sie dann bei identischen Aufgaben Input-Tokens, total_tool_use_tokens, Latenz und Aufgabenerfolg mit und ohne Aufschieben.
FAQ
Funktioniert Tool Retrieval mit generateContent?
Nein. Nur mit der Interactions API auf v1beta.
Welche Modelle werden unterstützt?
Angekündigt für Gemini 3.6 und neuer einschließlich Gemini 4; die zitierte Analyse berichtet, dass die Live-Dokumentation dies derzeit auf Modelle einschließlich gemini-4-hydrogen und gemini-3.6-flash eingrenzt. Prüfen Sie die Dokumentation für Ihr konkretes Modell.
Kann das meine Rechnung erhöhen?
Ja. Im zitierten illustrativen Workload mit 10 Tools steigt der Verbrauch von ~68.000 auf ~92.830 Tokens, wenn nahezu in jedem Turn gesucht wird.