Google legt am 19. November 2026 eine spielbare Welt hinter einen API-Key – allerdings kostet eine zweiminütige Demo rund $12, und nach einer Minute beginnt die Welt, sich selbst zu vergessen. Die Genie 4 API ist über die Gemini Interactions API und Google AI Studio verfügbar. Für kurze interaktive Prototypen ist sie einen Test wert, für persistente Spiele dagegen noch nicht.
Genie 4 API: Was am 19. November veröffentlicht wurde
Google hat den Entwicklerzugang am 19. November 2026 über die Interactions API der Gemini API (v1beta) und Google AI Studio freigeschaltet – einen Tag nachdem Project Genie für AI-Ultra-Abonnenten am 18. November verfügbar wurde. Die Modellkennung lautet laut den Genie-Dokumenten in AI Studio models/genie-4.
Für den Zugriff ist ein Gemini-API-Key eines kostenpflichtigen Tarifs erforderlich. Eine kostenlose Genie-4-Nutzung gibt es nicht. Außerdem führt Google die Oberfläche als v1beta – Anfrageformate und Kontingente können sich also weiterhin ändern.
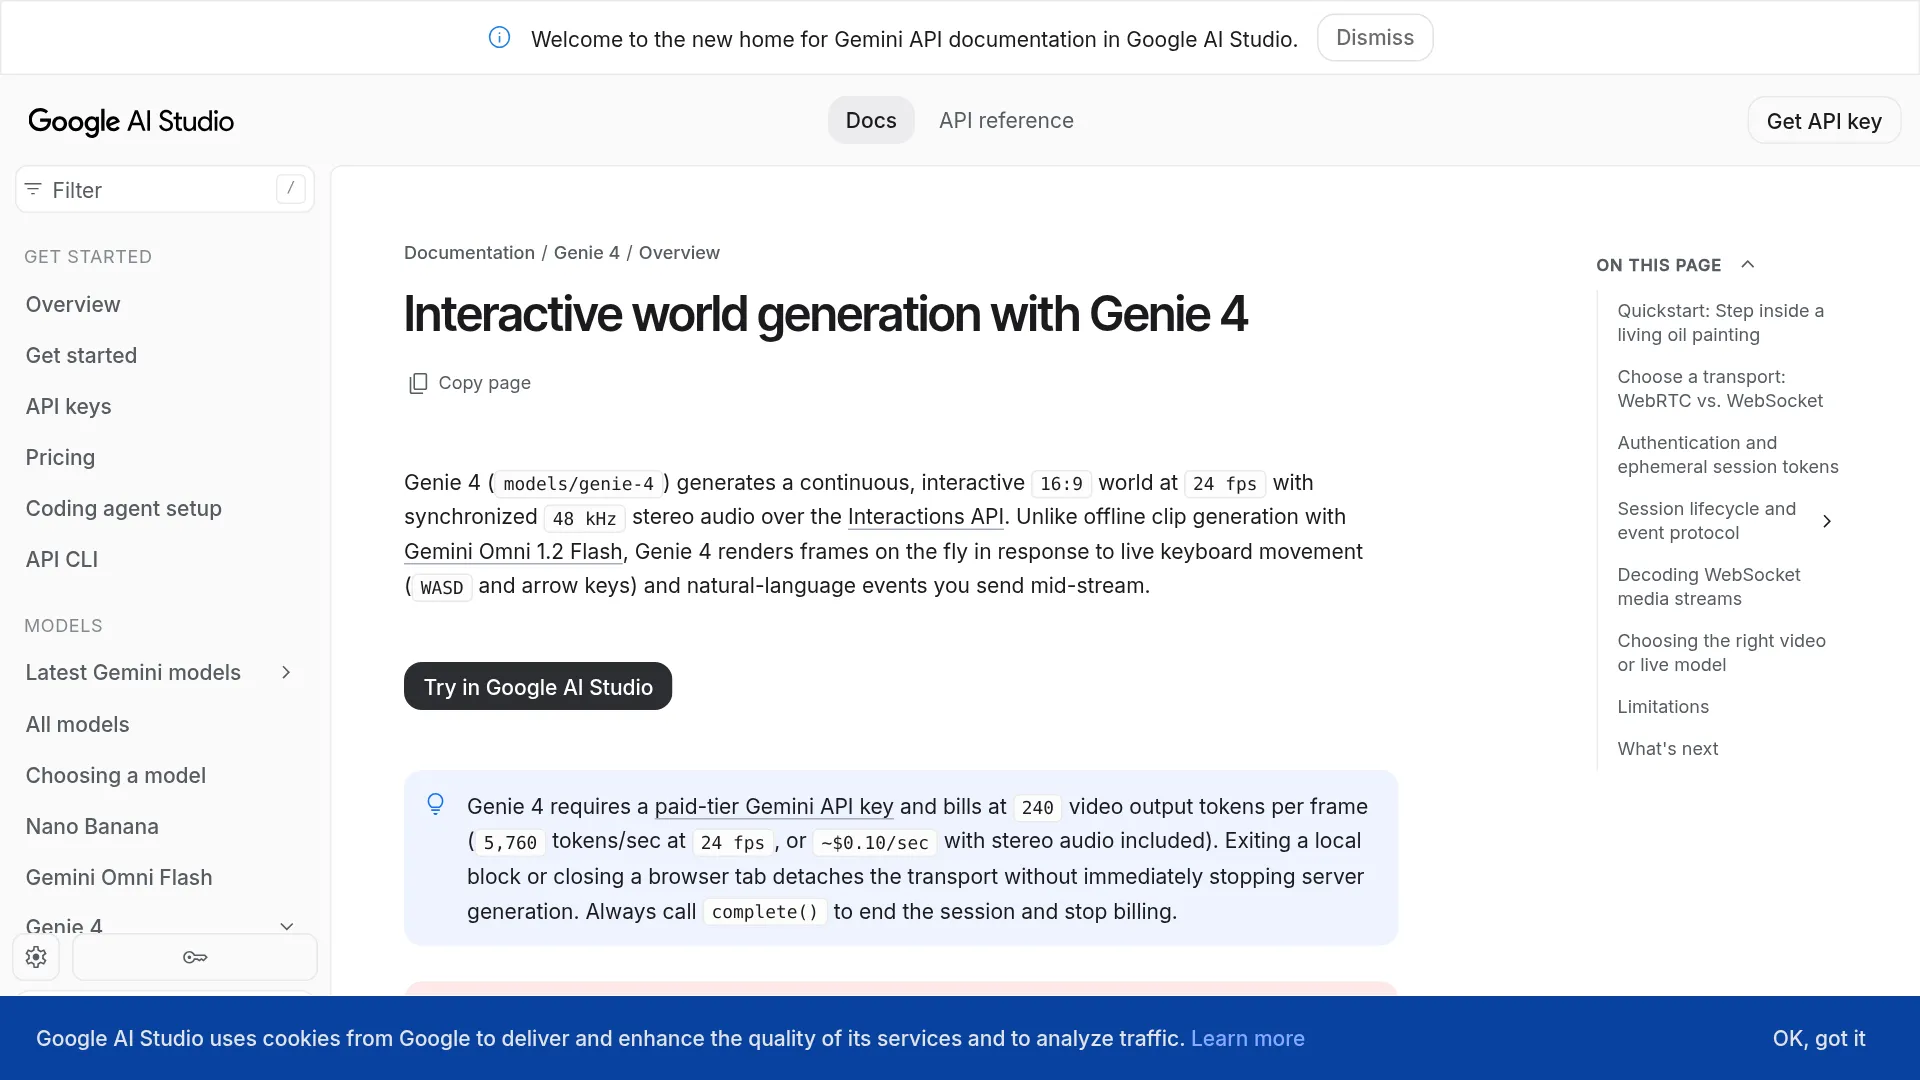
Genie 4 erzeugt laut der offiziellen Ankündigung eine kontinuierliche 16:9-Welt mit 1280x720 Pixeln und 24 fps sowie synchronisiertem 48-kHz-Stereoton inklusive Atmosphäre, Effekten und Dialogen der Figuren. Der Start erfolgt über einen Text-Prompt, ein 16:9-Referenzbild oder eine Kombination aus beidem. Gesteuert wird mit WASD oder den Pfeiltasten; zusätzliche Text-Prompts können während der Sitzung Wetter, Beleuchtung, Objekte oder Ereignisse verändern. Anders als bei der Offline-Videogenerierung rendert Genie 4 die Bilder als Reaktion auf Live-Eingaben.
Was eine Genie-4-Sitzung tatsächlich kostet
Abgerechnet wird Genie 4 zwar über Tokens, für die Praxis zählt aber vor allem die Laufzeit. Die Genie-Dokumentation in AI Studio nennt $1.50 pro einer Million Input-Tokens, $9.00 pro einer Million Text-Output-Tokens und $17.50 pro einer Million Video-Output-Tokens. Für Video fallen 240 Tokens pro Frame an. Als effektiven gebündelten Richtwert nennen die Dokumente etwa ~$0.10 pro Sekunde für den kombinierten Stream.
| Nutzung | Abrechnung |
|---|---|
| Input-Tokens | $1.50 / 1M Tokens |
| Text-Output-Tokens | $9.00 / 1M Tokens |
| Video-Output-Tokens | $17.50 / 1M Tokens |
| Video-Tokens bei 24 fps | 240 x 24 = 5,760 Tokens / Sekunde |
| Effektive Streaming-Kosten | ~$0.10 / Sekunde als gebündelte Schätzung laut Dokumentation |
Der größte Kostenblock ist das Video: 5,760 / 1,000,000 x $17.50 = $0.1008 pro Sekunde allein für Video-Tokens. Deshalb rundet die Dokumentation den kombinierten Video-und-Audio-Stream auf ~$0.10 pro Sekunde. Das entspricht etwa $6.05 pro Minute und etwa $12.10 für eine vollständige Sitzung mit 120 Sekunden – Prompt- und Dialog-Tokens noch nicht eingerechnet.
Für die Budgetplanung: Eine Demo auf einer Landingpage mit zehn 30-Sekunden-Besuchen verbraucht ~300 Sekunden, also rund $30 für die Welterzeugung. Eine Stunde kontinuierlicher Generierung kostet etwa $363. Zusätzlich zum Geld begrenzt das Kontingent die Nutzung: Laut AICoders Analyse zum Start erlaubt Tier 1 2 parallele Sitzungen und 50 Anfragen pro Tag, Tier 2 5 und 250, Tier 3 10 und 1,000. Vor Lasttests sollte der eigene Tarif in den Rate-Limit-Dokumenten geprüft werden, denn Beta-Kontingente können sich ändern.
Auch Smoke-Tests werden berechnet. Deshalb zuerst im Live-Playground von AI Studio testen und erst danach auf eine Integration mit API-Key umsteigen.
WebRTC oder WebSocket: Der Renderort entscheidet
| Eigenschaft | WebRTC | WebSocket |
|---|---|---|
| Geeignet für | Browser-Wiedergabe mit Tastatursteuerung | Serververarbeitung, Aufzeichnung, eigene Medien-Pipelines |
| SDK | @google/genai in Browser-JS/TS | google-genai asynchron in Python, @google/genai für Node |
| Medien | Native RTP-Videodaten plus Opus-Audio an <video> | JSON-step.delta mit Base64-JPEG plus 48-kHz-Int16-PCM |
| Verhalten bei der Latenz | Am niedrigsten; UDP plus Jitter-Buffering | Höher; TCP-Head-of-Line-Blocking bei Paketverlusten |
| Payload-Limit | 64-KB-SCTP-Limit; finale Größe des codierten Seeds prüfen | Größere JSON-Payloads möglich |
Die Gegenüberstellung folgt den Genie-Dokumenten in AI Studio: WebRTC ist die Standardwahl für eine reaktionsschnelle Browser-Wiedergabe, WebSocket eignet sich für Aufzeichnung und eigene Verarbeitungsketten.
Das sichere Integrationsmuster ist in beiden Fällen gleich, wie der Authentifizierungsabschnitt der Genie-Dokumentation erklärt. Der Server ruft interactions.create auf, erzeugt ein kurzlebiges Token für eine einzelne Sitzung und übergibt dem Browser nur die Interaction-ID und dieses Token. Ein langlebiger Key gehört niemals in den Client-Code. Standard-WebSockets im Browser können den Header x-goog-api-key nicht mitsenden. Browserverbindungen verwenden deshalb das Sitzungstoken auth_tokens/....
Der minimale Sitzungsablauf laut Dokumentation zum Sitzungszyklus:
- Server:
interactions.createmitmodels/genie-4. - Server: Ein Sitzungs-
auth_tokenerzeugen und ID plus Token an den Browser senden. - Client: Über WebRTC oder WebSocket mit
interactions.connectverbinden. - Client: Genau ein
world_setupmitworld_promptund optionalem 16:9-reference_imagesenden. - Client: Mit
user_action-Tastenereignissen undinput-Textereignissen steuern. - Client oder Server: Mit
complete()die Generierung und Abrechnung beenden.
Gedrückte Tasten bleiben aktiv, bis key_up gesendet wird. Die automatische Tastenwiederholung des Betriebssystems sollte der Client unterdrücken. Für eigene Aktionen auf E, Q oder der Leertaste gibt es im Beispiel der Dokumentation kein eingebautes Sprungverhalten – sie werden stattdessen als beschreibende Texteingaben übergeben.
Die Abrechnungsfalle ist wichtiger als die eigentliche Code-Struktur. Laut dem Abschnitt zum Sitzungszyklus beendet complete() die serverseitige Generierung und Abrechnung, während cancel() sofort abbricht. detach() schließt dagegen nur den lokalen Socket und sollte nicht als Methode zum Stoppen der Abrechnung betrachtet werden. Auch das Schließen eines Browser-Tabs trennt zwar den Transport, garantiert aber nicht das Ende der Generierung. Deshalb immer ausdrücklich complete() oder cancel() aufrufen.
Bei Seed-Bildern ist WebRTC besonders empfindlich. Die Dokumentation weist auf ein 64-KB-SCTP-Limit hin und empfiehlt, den finalen Base64-codierten Seed klein zu halten – nach der ~33-prozentigen Base64-Vergrößerung bleibt dafür grob die Hälfte des Budgets. Die codierte Payload-Größe sollte im Code geprüft werden, statt sich allein auf die Auflösung zu verlassen. Zu große Seeds gehören in eine WebSocket-Verbindung.
4 Limits, an denen deine Demo scheitern kann
Genie 4 hält laut dem Limitations-Abschnitt kein dauerhaftes 3D-Szenenmodell vor, sondern ein gleitendes zeitliches Fenster. Wer Nutzern mehr versprechen will, sollte diese vier Einschränkungen von Anfang an einplanen.
1. Harte Grenze bei 120 Sekunden. Jede Sitzung endet nach 120 Sekunden, wie die Limits-Dokumentation festhält. Eine Kette aus neuen Sitzungen kann das Nutzungserlebnis verlängern, erhält aber keinen exakten Szenenzustand, da Sitzungen nicht fortgesetzt werden. Der Aufbau der Welt dauert vor dem ersten Frame mehrere Sekunden; im Quickstart der Dokumentation sind es ~5–9 Sekunden.
2. Drift nach 60–90 Sekunden, Veränderungen beim Wegschauen. Laut den Dokumenten kann die visuelle Stabilität nach 60–90 Sekunden nachlassen. Wer 8+ Sekunden wegschaut oder sich um 360 Grad dreht, kann dadurch Landmarken, Türen oder Schalter verändern. Im Kanalbeispiel können sich Hintergrundgebäude neu anordnen, wenn man sich um 180 Grad dreht und zurückblickt. Schilder, Anzeigen, Uhren und exakte Anzahlen verformen sich zuerst. Die Dokumentation empfiehlt, kontinuierliche Veränderungen statt harter Kameraschnitte zu beschreiben und kurze Prompts über ~1.5 Sekunden zu wiederholen, mit einer Pause von ~2 Sekunden, weil die Weltplanung Texte an den Grenzen einzelner Schritte verarbeitet.
3. Latenz und Abhängigkeit von der Region. Genie 4 wird aus den USA, Westeuropa und Japan bedient. Die beste Reaktionsfähigkeit gibt es laut den Dokumenten bei einer Round-Trip-Zeit von unter ~150 ms in Nordamerika, West- und Mitteleuropa sowie Ostasien. Oberhalb dieser Schwelle fühlt sich die Steuerung träge an, und die Bildrate kann sinken. Backend-Relays sollten in der Nähe einer Serving-Region stehen; außerdem sollte die WebRTC-Latenz aus der Zielregion getestet werden. Die Tastaturreaktion wird bei niedriger Round-Trip-Zeit mit ~0.2–0.5 Sekunden angegeben, Texteingaben mit ~1–2 Sekunden.
4. Festes Format und blockierte Inhalte. Die Ausgabe ist auf 16:9, 720p und 24 fps festgelegt. Es gibt keinen Hochformatmodus, keine konfigurierbare Bildrate, keine Live-Mikrofon- oder Webcam-Eingabe, kein Function Calling, kein Search Grounding, keine strukturierten Ausgaben und keine Möglichkeit, Sitzungen fortzusetzen. Prompts oder Seeds mit identifizierbaren Personen, Persönlichkeiten des öffentlichen Lebens oder geschützten Markeninhalten können blockiert werden oder einen Stream beenden. Jede Ausgabe enthält ein nicht wahrnehmbares SynthID-Wasserzeichen.
„Sieht gut aus, kein Schrott, aber Googles kuratierte, spezifische Beispiele interessieren mich nicht … Ich will irgendeinen Typen namens Steve live auf YouTube damit sehen, der vielleicht Ideen aus seinem Chat aufgreift. Dann würde man sehen, wie gut das ohne handverlesene Beispiele funktioniert.“ — u/RobXSIQ, der statt kuratierter Demos ungeschnittene Live-Tests fordert
Diesen ungeschnittenen Härtetest sollte man vor dem Start selbst durchführen: Welt betreten, 10 Sekunden wegschauen, sich um 360 Grad drehen, drei widersprüchliche Texteingaben direkt hintereinander senden und beobachten, was sich verändert.
Lohnt sich Genie 4 schon diese Woche?
Genie 4 passt zu kurzen, steuerbaren und bewusst vergänglichen Welten. In den eigenen Vergleichsdokumenten grenzt Google das Modell von zwei Geschwistern ab: Gemini Omni 1.2 Flash für Offline-Clips und Gemini 3.8 Live für Sprachagenten.
| Aufgabe | Geeignetes Modell | Warum |
|---|---|---|
| Spielbarer Prototyp, räumlicher Rundgang, Browser-Spielerei, Agenten-Spielplatz | Genie 4 über die Interactions API | Live-Steuerung mit 24 fps plus nativer Audioausgabe; in diesem Vergleich die einzige Option mit WASD und Textänderungen während der Sitzung |
| Polierter 3–15-Sekunden-Clip, Bearbeitung/Verlängerung auf 30 Sekunden, 1080p-/4K-Upscaling | Gemini Omni 1.2 Flash über die Interactions API | Offline-Bearbeitung mit bis zu 6 Referenzbildern sowie höhere Ausgabeauflösung |
| Sprachagent mit Mikrofon/Kamera, Tools und Grounding | Gemini 3.8 Live über die Live API | Bidirektionales Audio-/Videoverständnis plus Tool Calling; Genie 4 bietet nichts davon |
Gute erste Einsatzfälle sind interaktive Moodboards, kurze Level-Design-Prototypen, Robotik- oder Agenten-Sandboxes, in denen eine sichere künstliche Welt besser ist als eine reale, sowie Event-Demos unter zwei Minuten. Schlecht geeignet ist Genie 4 für persistenten Multiplayer-Zustand, exakte Inventare oder Beschriftungen, lange Trainingsläufe, mobile Vollbildansichten im Hochformat und alles, was reproduzierbare Seeds benötigt.
Gibt es eine kostenlose Genie-4-API?
Nein. Für Genie 4 ist ein Gemini-API-Key eines kostenpflichtigen Tarifs nötig. Die Dokumentation beziffert die effektiven Kosten für eine gestreamte Welt mit Audio auf etwa $0.10 pro Sekunde.
Können Browser Genie 4 aufrufen, ohne den API-Key offenzulegen?
Ja, über kurzlebige Tokens. Der Server erstellt die Interaktion und erzeugt ein Token für eine einzelne Sitzung. Der Browser verbindet sich mit diesem Token – niemals mit dem langlebigen Key.
Kann eine Genie-4-Sitzung länger als 2 Minuten laufen?
Nein. Sitzungen sind auf 120 Sekunden begrenzt, die Stabilität lässt oft nach 60–90 Sekunden nach, und Sitzungen können nicht fortgesetzt werden. Für längere Abläufe lassen sich neue Sitzungen aneinanderreihen, allerdings wird der Szenenzustand nicht exakt übernommen.
Stoppt das Schließen des Tabs die Abrechnung von Genie 4?
Nicht zuverlässig. Laut den Dokumenten trennt das Schließen des Tabs den Transport, während die serverseitige Generierung weiterlaufen kann. Zum Beenden der Abrechnung immer complete() oder cancel() aufrufen.
Checkliste vor dem Start: Interaktionen serverseitig erstellen, Tokens pro Sitzung ausstellen, genau ein world_setup senden, die automatische Tastenwiederholung des Betriebssystems unterdrücken, mit ~$0.10/Sek. plus Dialog-Tokens kalkulieren, Relays nahe den Serving-Regionen in den USA, der EU oder Japan platzieren und jede Sitzung mit complete() beenden. Der entscheidende Kompromiss lautet: das Gefühl, „in den Prompt hineinzulaufen“, gegen ein kurzes Gedächtnis und sekundengenaue Abrechnung.