Wer bisher auf browser-use 0.x gesetzt hat, muss sich in Version 1.0 auf eine andere Architektur und neue Standardwerte einstellen. Aus 24 einzelnen Browser-Aktionen wird ein einziges persistentes Python-REPL – und Browser() startet jetzt standardmäßig einen Cloud-Browser. Dieser Leitfaden zeigt die Einrichtung mit 1.0.7, den ersten Lauf und die Migration von 0.x. Grundlage sind die Release Notes zu 1.0.7, die MIGRATING.md und der Engineering-Artikel vom 20. November.
In fünf Minuten mit 1.0 loslegen
Am besten pinnt ihr die Version direkt fest. Version 1.0.0 erschien am 10. November 2026, am 20. November war 1.0.7 der stabile Tag; parallel lag 1.0.8rc1 als Pre-Release vor (Releases). Das README weist ausdrücklich darauf hin, niemals >= zu verwenden, weil sich APIs zwischen Minor-Versionen ändern können.
uv add 'browser-use==1.0.7'
# or
pip install 'browser-use==1.0.7'
Die Anforderungen sind überschaubar: Python 3.11 oder neuer, aber jünger als 4.0 (README, PyPI). Sämtliche Abhängigkeiten sind mit == festgenagelt. Das verbessert die Reproduzierbarkeit, kann aber mit einer Anwendung kollidieren, die eine andere Version von pydantic, mcp oder google-genai benötigt.
Die Authentifizierung erledigt ihr einmalig. Erstellt einen Schlüssel unter cloud.browser-use.com und exportiert ihn anschließend oder nutzt den Login-Helfer:
export BROWSER_USE_API_KEY=bu_...
# or
browser-use login
Der Login legt die Zugangsdaten unter ~/.config/browser-harness/auth.json ab. CLI, MCP-Server und browser-harness greifen auf dieselben Credentials zu (MIGRATING.md). In Containern setzt ihr BROWSER_USE_AUTO_LOGIN=true. Auf SSH- oder Headless-Systemen gibt der Release Candidate 1.0.8 einen Link samt Bestätigungscode aus, den ihr auf einem anderen Gerät freigeben könnt (Hinweise zu 1.0.8rc1).
Der erste Lauf besteht aus drei Zeilen:
from browser_use import Agent

result = Agent(
    "Find the number of stars of the browser-use repo"
).run_sync()

print(result.final_result())
Standardmäßig ist das bereits ein kostenpflichtiger Lauf: Zum Einsatz kommen ein Browser Use Cloud Browser und das voreingestellte Gateway-Modell (README Path 1 / Path 3, MIGRATING.md defaults). Wer für diesen Test keinerlei Cloud-Kosten möchte, sollte gleich Browser('chromium') und ein eigenes llm angeben.
Was aus den 24 Aktionen geworden ist
Browser-use 0.x gab dem Modell ein Menü an die Hand: Für jeden Schritt wurde aus einem DOM-Dump genau eine Aktion ausgewählt. Version 1.0 schafft dieses Menü ab. Stattdessen steht dem Modell ein zentrales python-Tool zur Verfügung – ein persistentes REPL, in dem browser-harness-Helfer und rohes cdp() bereits importiert sind. Die Basis bildet Pydantic AI (Engineering-Artikel):
async def python(ctx: RunContext[Session], code: str) -> list[Any]:
    """Run Python in the persistent REPL
    (browser-harness helpers and raw cdp() pre-imported)."""
Durch den Umbau verschwanden 136.905 Zeilen, während in 554 Dateien 29.601 neue hinzukamen. Die Zahl der Python-Dateien sank von 178 auf 43 (Engineering-Artikel).
Wie flexibel das ist, zeigt die Wiederherstellung nach einer hängenden Seite: Der Agent rief Page.stopLoading auf, blockierte das festgefahrene Skript, lud die Seite neu, entdeckte den privaten JSONP-Endpunkt der Seite und holte anschließend 730 Datumswerte in Batches ab. Nur fehlgeschlagene Batches wurden wiederholt – am Ende kamen 4.720 Zeilen zurück, ohne dass es dafür ein spezielles Tool geben musste (Engineering-Artikel).
Die Leitlinie des Teams lautet: Einen Helfer gibt es nur dann, wenn das Modell ihn nach einmaligem Lesen nicht selbst umschreiben kann. CAPTCHA ist die Ausnahme. Reine Textanweisungen kamen in einem kleinen Staging-Test bei hCaptcha auf 0/3, während das dedizierte Tool solve_captcha 6/6 erreichte. Der Grund: Das Tool aktiviert einen Solver-Schalter, an den die Seite selbst nicht herankommt (Engineering-Artikel).
Bei Kosten und Geschwindigkeit lohnt sich ein Blick ins Kleingedruckte. Der Artikel vom 20. November berichtet bei denselben drei Modellen von 14–33 Punkten mehr und 2,7–5,2-fach niedrigeren Kosten mit 1.0 gegenüber 0.x. Grundlage war ein Lauf mit 200 Aufgaben vom 8. November, von denen 180 bewertet wurden. Gleichzeitig weist der Artikel ausdrücklich darauf hin, dass jedes Modell nur einmal getestet wurde und sich die Defaults geändert hatten. Den gesamten Effekt kann man daher nicht dem neuen Tool-Design zuschreiben (Engineering-Artikel).
Die saubereren Vergleiche fallen enger aus. Version 1.0.4 erreichte 76,1 Punkte gegenüber 76,0 bei 1.0.3, während die Modellkosten nach dem Entfernen redundanter Batch-Screenshots von 0,434 auf 0,208 Dollar pro Aufgabe sanken. Das Prompt-Caching blieb dabei erhalten (Hinweise zu 1.0.4). Im BU Bench v2 kam 1.0 im Modus ultrafast auf 62,5 Punkte, 0,070 Dollar und 650 Sekunden. Browser Use Pi erreichte 56,3 Punkte, kostete 0,082 Dollar und benötigte 743 Sekunden. Laut den Autoren verliert der Abstand an Aussagekraft, sobald Provider-Fehler herausgerechnet werden. Plant also mit niedrigeren Kosten und höherem Tempo – nicht automatisch mit intelligenteren Ergebnissen.
Defaults, die Rechnung und Browser unbemerkt verändern
Die folgende Tabelle basiert auf MIGRATING.md und den Release Notes zu 1.0.6. Sie bildet 1.0.7 ab und berücksichtigt den Wechsel des Standardmodells innerhalb der 1.0-Reihe, den ältere Anleitungen oft übersehen.
| Einstellung | 0.x | 1.0.7 |
|---|---|---|
llm=None | Modell erforderlich | bu-4.0 über das Browser-Use-Gateway |
bu-4.0-Preis | n/a | 1,80 $ / 1 Mio. Input, 9,00 $ / 1 Mio. Output |
bu-fast-Preis | n/a | 0,12 $ / 1 Mio. Input, 0,60 $ / 1 Mio. Output |
Browser() | Lokales Chromium | Browser Use Cloud Browser |
| Lokaler Browser | Standard | Browser('chromium') ausdrücklich angeben |
| API-Schlüssel | Einer pro Provider | Ein BROWSER_USE_API_KEY |
max_steps | 500 | 100 (ein Schritt für die Ausgabe reserviert) |
| Agent-Timeout | Nicht spezifiziert | 1.700 Sekunden, ohne Start und Herunterfahren |
| Judge | Optional | judge=True als Standard |
| Reasoning / Modus | n/a | reasoning='medium', mode='ultrafast' bei bu-fast / bu-ultrafast |
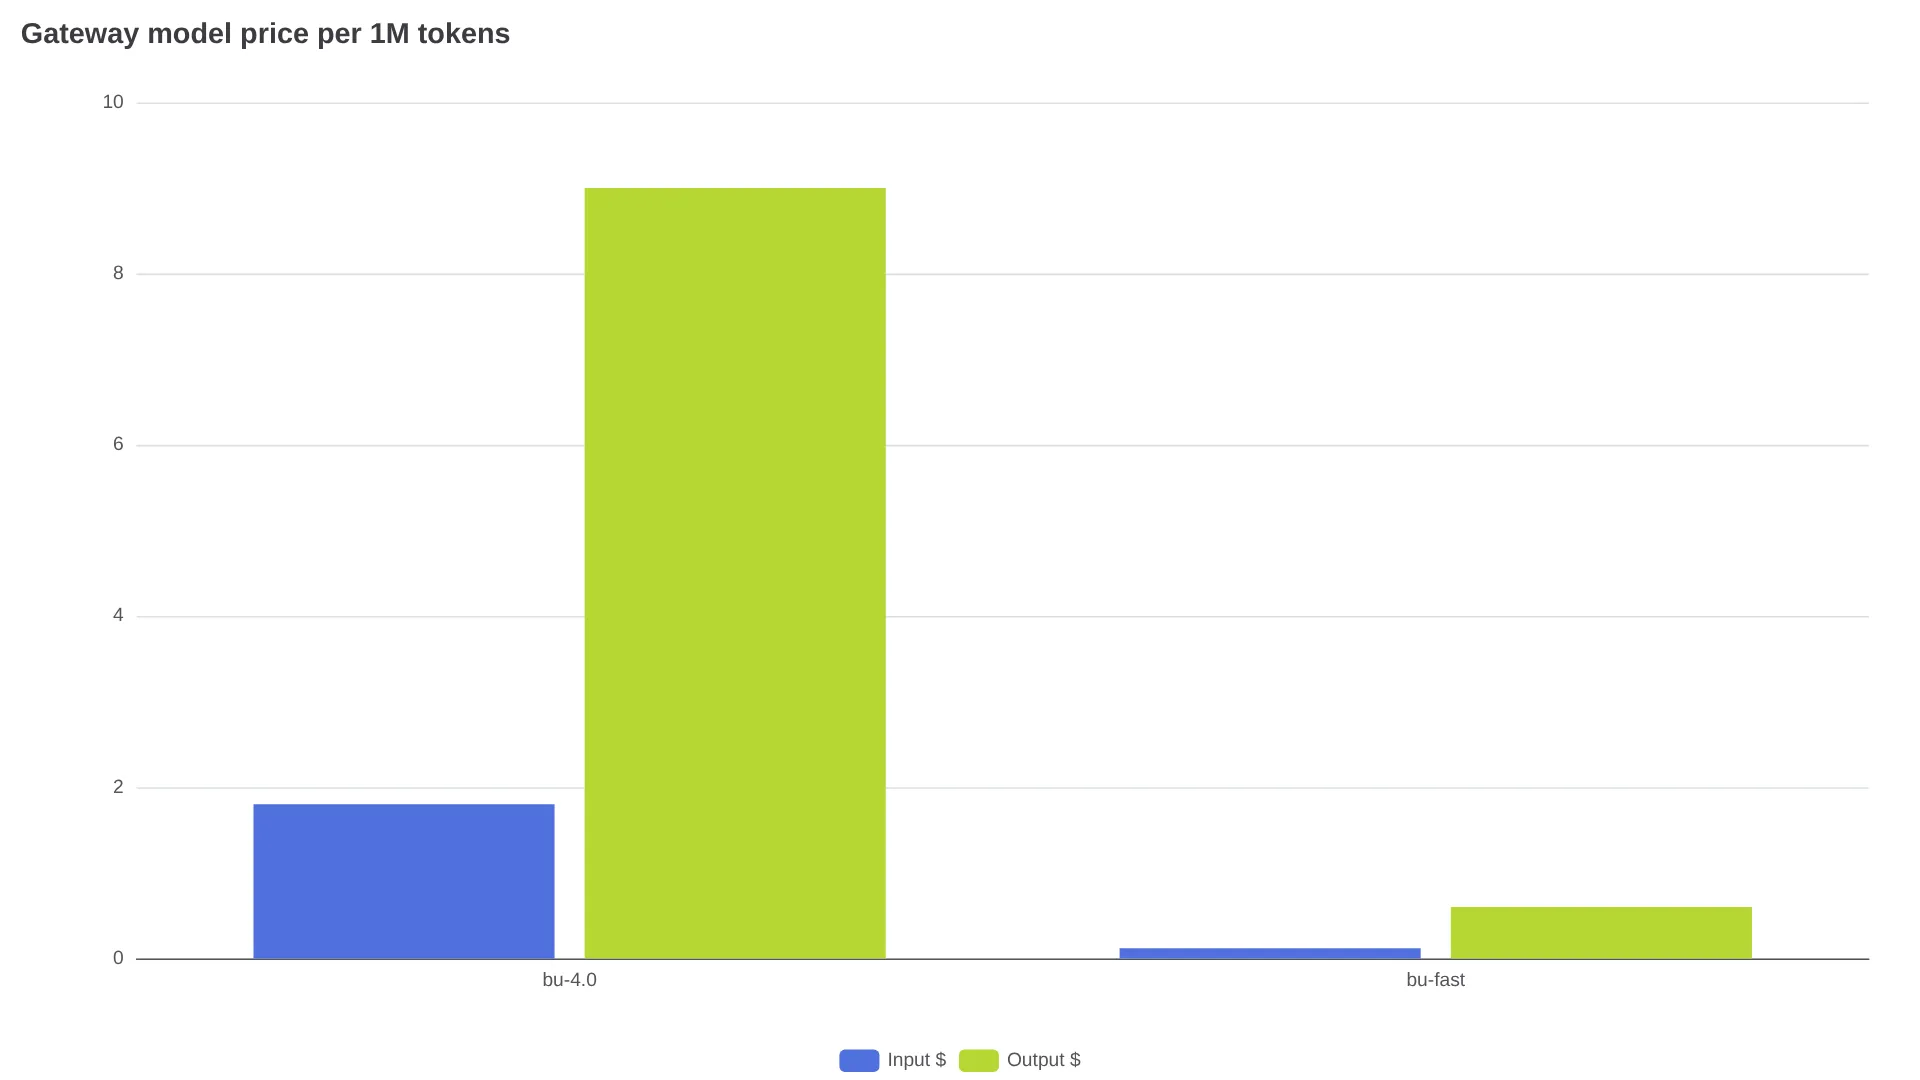
Drei Fallen sind besonders relevant. Erstens wechselte das Standardmodell innerhalb der 1.0-Reihe: Bis einschließlich 1.0.5 war bu-fast voreingestellt, mit 1.0.6 wurde bu-4.0 zum Standard – bei einem 15-fachen Tokenpreis. Das eigene Beispiel des Projekts kommt beim selben kurzen Test auf 0,022 Dollar mit bu-4.0 gegenüber 0,0014 Dollar mit bu-fast. Wer das alte Kostenprofil behalten möchte, muss llm='bu-fast' explizit setzen. Zweitens startet ein nacktes Browser() jetzt einen Cloud-Browser. Dafür fallen 0,06 Dollar pro Browser-Stunde sowie Modell- und Suchkosten an (README). Cloud-Browser erreichen weder localhost noch private IPs (MIGRATING.md). Drittens entspricht ein Schritt genau einer Modellanfrage und einer Python-Zelle. Das niedrigere Limit von 100 Schritten ist damit zugleich eine Ausgabenbremse. max_steps < 1 oder timeout <= 0 führt jetzt zu einem Fehler, bevor der Browser startet (MIGRATING.md).
Der Judge ist der zweite versteckte Kostenfaktor. Nach jedem Lauf mit mindestens einem Schritt stellt euer eigenes Modell eine zusätzliche Anfrage mit geringem Aufwand. Dabei können bis zu 120.000 Zeichen des Traces sowie bei aktivierter Vision die letzten vier unterschiedlichen Bilder einschließlich der letzten Seite unredigiert übertragen werden (MIGRATING.md). Das Ergebnis landet in result.judgement und enthält success, failure_reason, gotchas sowie Bot- und CAPTCHA-Flags. Die Kosten fließen in result.cost_usd ein. Abschalten lässt sich der Judge mit judge=False. Alternativ könnt ihr mit judge_context das erwartete Ergebnis vorgeben. Wenn Screenshots eure Umgebung nicht verlassen dürfen, setzt zusätzlich use_vision=False.
Wenn es lokal bleiben muss
Welcher Browser passt, hängt vom Netzwerk ab – nicht von Gewohnheit. Die folgende Modellkennung stammt als Beispiel aus dem Local-Browser-Snippet des README (README):
from browser_use import Agent, Browser, ChatOpenAI

agent = Agent(
    "Summarize the dashboard at http://localhost:3000",
    llm=ChatOpenAI("gpt-6-luna"),
    browser=Browser("chromium"),
)
print(agent.run_sync().final_result())
Browser('chromium') ist die richtige Wahl für localhost, private Netzwerke und eigene Viewports – oder überall dort, wo Cloud-Aufrufe für Gerätemetriken den tatsächlichen Viewport der Seite nicht verändern sollen. Mit Browser('chrome') steuert ihr ein bereits geöffnetes Chrome inklusive vorhandener Logins. Browser('chrome', profile='Work') startet eine temporäre Kopie mit den Logins, schreibt aber nichts über Sync zurück. Unter Windows muss das ursprüngliche Chrome vorher beendet werden, weil es die Cookies sperrt (MIGRATING.md). Cloud bleibt die bessere Wahl für verwaltete Tarnung, Proxies, CAPTCHA-Verarbeitung oder eine Einrichtung ohne lokale Komponenten (README). Rechnet Browser-Stunden aber getrennt von den Tokenkosten.
Eigene Modelle funktionieren weiterhin, allerdings kommt es auf den richtigen Pfad an (MIGRATING.md):
- Gateway-Aliase:
bu-4.0,bu-4.0-mini,bu-4.0-pro,bu-fast,bu-ultrafast,bu-smart - Provider:
ChatOpenAI,ChatAnthropic,ChatGoogleoder Pydantic-AI-Strings wiegroq:llama-3.3-70b-versatile - Azure über
llm='azure:<deployment>'mitAZURE_OPENAI_ENDPOINT,AZURE_OPENAI_API_KEYundOPENAI_API_VERSION
LangChain-Chatobjekte als Agent(llm=...) lösen jetzt einen TypeError aus. Ausgemusterte Gateway-Namen wie bu-2-0 werden abgelehnt, bevor ein Browser startet. Für jeden parallel laufenden Agenten ist ein eigener Browser() nötig. Teilen sich zwei Agenten einen Browser, folgt ein RuntimeError. Ein Browser mit keep_alive=True kann dagegen nacheinander wiederverwendet werden (MIGRATING.md).
Ohne Rätselraten migrieren: Fehlermeldungen als Wegweiser
Version 1.0 bricht absichtlich früh ab. Entfernte Imports führen zu einem ImportError, der den Ersatz nennt. Nicht unterstützte Argumente in Agent(...) erzeugen einen TypeError. Alles, was 1.0 nicht erfüllen kann, wird gemeldet, bevor ein Browser startet oder Kosten entstehen (MIGRATING.md). Eine kleinere Gruppe von Optionen – darunter use_vision=True, vision_detail_level, max_actions_per_step, flash_mode, max_failures und highlight_elements – wird zwar akzeptiert, aber ignoriert. Für jede davon erscheint einmalig eine Warnung. use_vision=False bleibt relevant, weil dadurch keine Screenshots an das Modell gesendet werden.
Nach dem Start verhält sich die Fehlerbehandlung anders: run() gibt normalerweise ein Fehlerergebnis zurück, statt eine Exception zu werfen. Der Status lautet dann status='error', Details stehen in result.error. Nur Abbrüche werden weiterhin durchgereicht. Die Prüfungen müssen deshalb angepasst werden:
# 0.x
history = await agent.run(max_steps=500)
ok = history.is_successful()

# 1.0
result = await agent.run(max_steps=100)
ok = result.is_done() and result.success is not False
is_done() bedeutet jetzt nur noch, dass der Lauf abgeschlossen ist. Ob er erfolgreich war, entscheidet das Modell über das Urteil aus finish(result, success). Liefert das Modell kein Urteil, gibt is_successful() nun None zurück. Die alten History-Helfer pro Schritt – darunter action_names(), model_actions(), extracted_content() und save_as_playwright_script() – sind verschwunden. Die vollständige Liste steht bei den entfernten History-APIs in MIGRATING.md. Stattdessen solltet ihr result.messages, result.status, result.partial, Dateien in agent.workspace und result.judgement auswerten.
Beginnt mit drei Änderungen: Verschiebt max_steps aus Agent(...) in agent.run(max_steps=...). Ersetzt entfernte Callbacks wie on_step_start, pause, stop, multi_act und save_history durch logging.getLogger('browser_use') auf INFO oder BROWSER_USE_LOGGING_LEVEL=warning. Und passt den Umgang mit Secrets an. Domain-bezogene Secrets werden nur noch auf passenden Seiten typisiert. Namen, die auf bu_2fa_code enden, gelten als TOTP-Seeds. Der alte Platzhalter <secret>name</secret> führt zu einem Fehler und muss durch type_secret('name') ersetzt werden. Werte erscheinen in Zellen und Ergebnissen als <secret:name>. Das ist allerdings nur Redaction und keine Sandbox, denn vom Modell geschriebener Python-Code kann die Werte weiterhin lesen (MIGRATING.md). Wer mehr Zeit braucht, kann mit pip install 'browser-use<1' auf 0.x bleiben und die Migration in einem Branch durchführen.
"browser use ist eher ein Python-Framework zum Bau eigener Browsing-Agenten" – u/Starks1293 auf r/ClaudeCode
Diese Einordnung passt zu den Beschreibungen in Reddit-Diskussionen: ein Framework zum Bau von Browsing-Agenten, häufig genannt für Seiten mit Bot-Schutz und für Code auf niedriger Ebene. Die Zuverlässigkeit hängt aber weiterhin vom Modell und der jeweiligen Website ab. Ein Bericht aus dem Produktionseinsatz schildert fünf Minuten und neun fehlgeschlagene Schritte bei einer einfachen Formulareingabe.
Vor dem Produktionseinsatz: Judge, Secrets und die Realität mit Fehlversuchen
Für anspruchsvollere Einsätze sind vor allem diese Punkte wichtig:
- Typisierte Ergebnisse über
output_model_schema, ausgelesen überresult.structured_output - Uploads in den Workspace und
workspace/downloadsmitresult.downloads - Domain-Kontrollen (
allowed_domains,prohibited_domains,block_ip_addresses), die ein ausgerichtetes Modell begrenzen, aber kein Netzwerk-Sandboxing bieten - Optional aktivierbare Suche mit
web_search=True, deren Kosten pro Suche inresult.cost_usdeinfließen - CLI/MCP über
browser-use --cli-mcp,browser-use skill installundbrowser-use --doctor
Behandelt 1.0 wie ein Framework in schneller Entwicklung: Fixiert exakte Versionen, ergänzt bei langen Aufgaben judge_context, sichert Teilergebnisse mit checkpoint('titles.json', titles, partial=True) und führt nicht vertrauenswürdige Aufgaben in Containern aus. Domain-Limits und Secret-Redaction sind keine Isolation (README).
Jetzt migrieren, pinnen oder bei 0.x bleiben?
| Situation | Empfehlung |
|---|---|
| Neues Agent-Projekt, Cloud ist in Ordnung | Mit ==1.0.7 starten, bu-4.0 als Standard belassen, Judge aktiviert lassen |
| Kostenkritische Batch-Jobs | llm='bu-fast' und judge=False setzen, vor der Skalierung messen |
| Localhost / Intranet / eigener Viewport | Browser('chromium') plus eigenes Modell verwenden, niemals den nackten Browser() |
| Bestehendes 0.x in Produktion | Im Hauptzweig browser-use<1 pinnen und die Migration in einem Branch anhand der frühen Fehlermeldungen durchführen |
| CAPTCHA-lastiger Ablauf | Das dedizierte Solver-Tool einplanen; reine Textanweisungen erreichten im Test des Teams nur 0/3 |
Ihr gewinnt einen Agenten, der ein festgefahrenes Skript blockieren oder eine private API aufrufen kann, für die ihr nie ein eigenes Tool geschrieben habt. Im Gegenzug entfallen die Leitplanken eines festen Aktionsmenüs. Passt dieser Tausch zu eurer Website, spricht nichts gegen die Migration. Für bestehende Produktionssysteme bleibt es jedoch die sicherere Option, mit browser-use<1 gepinnt zu bleiben, während ihr 1.0 evaluiert.
FAQ
Was ist neu in browser-use 1.0?
Ein persistentes Python-REPL mit browser-harness-Helfern und rohem CDP ersetzt das Aktionsmenü mit 24 Einträgen aus 0.x. Dadurch verschwinden rund 80 Prozent der Bibliothek; die Zahl der Python-Dateien sinkt von 178 auf 43. Als Defaults kommen Browser Use Cloud, ein Gateway-Modell und ein einzelner BROWSER_USE_API_KEY zum Einsatz.
Wird mein 0.x-Code kaputtgehen?
Die üblichen Einstiegspunkte (Agent, Browser, run(), final_result()) gibt es weiterhin. Entfernte Imports und Optionen führen aber vor der Abrechnung zu ImportError oder TypeError, max_steps ist in run() gewandert und Browser() bezeichnet jetzt einen Cloud-Browser. Wer bei 0.x bleiben möchte, pinnt browser-use<1; ansonsten sollte die Migration zunächst in einem Branch erfolgen.
Kann ich weiterhin mein eigenes Modell und einen lokalen Browser verwenden?
Ja. Übergebt Provider wie ChatOpenAI, ChatAnthropic oder ChatGoogle beziehungsweise einen Pydantic-AI-String. Für einen neuen lokalen Browser nutzt ihr Browser('chromium'), für das bereits geöffnete Chrome Browser('chrome'). Cloud-Browser erreichen localhost nicht.
Welche Python-Version benötigt browser-use 1.0?
Python 3.11 oder neuer, aber jünger als 4.0. Die exakten Dependency-Pins können mit anderen Paketen kollidieren. Deshalb sollte die Installation zunächst in einer frischen virtuellen Umgebung erfolgen.
Wie deaktiviere ich den Run-Judge?
Mit judge=False überspringt ihr die zusätzliche Anfrage zur Bewertung. Alternativ könnt ihr mit judge_context eure Akzeptanzkriterien übergeben und das Urteil dadurch nützlicher machen. Setzt use_vision=False, wenn Screenshots des Judges nicht übertragen werden dürfen.