 AIREITER
594 Milliarden Parameter, aber nur 17 Milliarden davon pro Token aktiv: Inkling 2 Small verspricht die Effizienz eines kleinen Modells bei deutlich größerem Gesamtumfang. Mit 0,30 US-Dollar pro 1 Mio. Input-Tokens ist die API günstig, doch aktuell gibt es das Modell ausschließlich über Tinker. Außerdem liegt DeepSeek-V4.1-Flash-1017 bei Coding-Benchmarks vorn. Der Einsatzbereich ist damit enger, als es der Launch-Beitrag vermuten lässt. Diese Einschätzung stützt sich auf den Launch-Bericht und die Tinker-Preise; unabhängige Tests zu Latenz und Ausgabequalität waren noch nicht möglich.
Das steckt hinter Inkling 2 Small
Inkling 2 Small ist das kleine Mixture-of-Experts-Modell der zweiten Generation von Thinking Machines Lab, vorgestellt am 5. November 2026. Es kombiniert 594B Parameter insgesamt mit 17B aktiven Parametern, verarbeitet Text und Bilder und lässt sich für lang laufende Agentenaufgaben mit variabler Reasoning-Intensität betreiben (Thinking Machines Lab).
| Spezifikation | Inkling 2 Small |
|---|---|
| Architektur | Mixture-of-Experts |
| Parameter gesamt / aktiv | 594B / 17B |
| Eingabemodalitäten | Text + Bild (kein Audio) |
| Reasoning-Steuerung | Variabler Aufwand (getestet bei 0.99 / xhigh) |
| Vision-Encoder | 292M Parameter, 20x20-Patches, 2x2-Pooling |
| Zahlenformat | NVFP4 auf NVIDIA GB300 NVL72 |
| Trainingskontext | 256K Tokens mit Kompaktierung (Benchmark-Trajektorien bis 1M) |
| Artificial Analysis Index | 31 (laut Ankündigung) |
Tinker bepreist es trotz des 594B großen Gesamtgewichts wie ein kleines Modell.
Aktuell nur über Tinker, Gewichte nächste Woche
Inkling 2 Small ist heute ausschließlich über die Tinker-Plattform von Thinking Machines Lab verfügbar: im Playground, für Fine-Tuning und Sampling. Herunterladbare Gewichte gibt es noch nicht. Vollständige Checkpoints unter Apache 2.0 sind für nächste Woche angekündigt, vorbehaltlich externer Sicherheitstests und Red-Teaming (Thinking Machines Lab).
In der Praxis heißt das:
- Die Launch-Ankündigung nennt ausschließlich Tinker als Zugang. Offizielle Releases auf Hugging Face oder im GGUF-Format sowie Angebote von Drittanbietern wurden dort nicht angekündigt.
- Frühe Checkpoints wurden unter dem Namen Fledge-Alpha über OpenCode öffentlich getestet (Thinking Machines Lab). Community-Spuren mit der Bezeichnung Fledge-Alpha beziehen sich daher auf diese Modellfamilie.
- Wer Self-Hosting plant, sollte abwarten: Die zitierten Launch-Materialien enthalten weder Angaben zu Durchsatz oder Time-to-First-Token noch offizielle VRAM-Empfehlungen oder Quantisierungsrezepte.
Tinker-Preise und der relevante Vergleich
Serverless-Inferenz für Inkling 2 Small kostet bei 256K Kontext 0,30 US-Dollar pro 1 Mio. Input-Tokens, 0,03 US-Dollar pro 1 Mio. gecachte Input-Tokens und 1,00 US-Dollar pro 1 Mio. Output-Tokens. Unter den drei gehosteten Modellen von Thinking Machines Lab sind das die niedrigsten Serverless-Preise für Output und gecachten Input (Thinking Machines Lab).
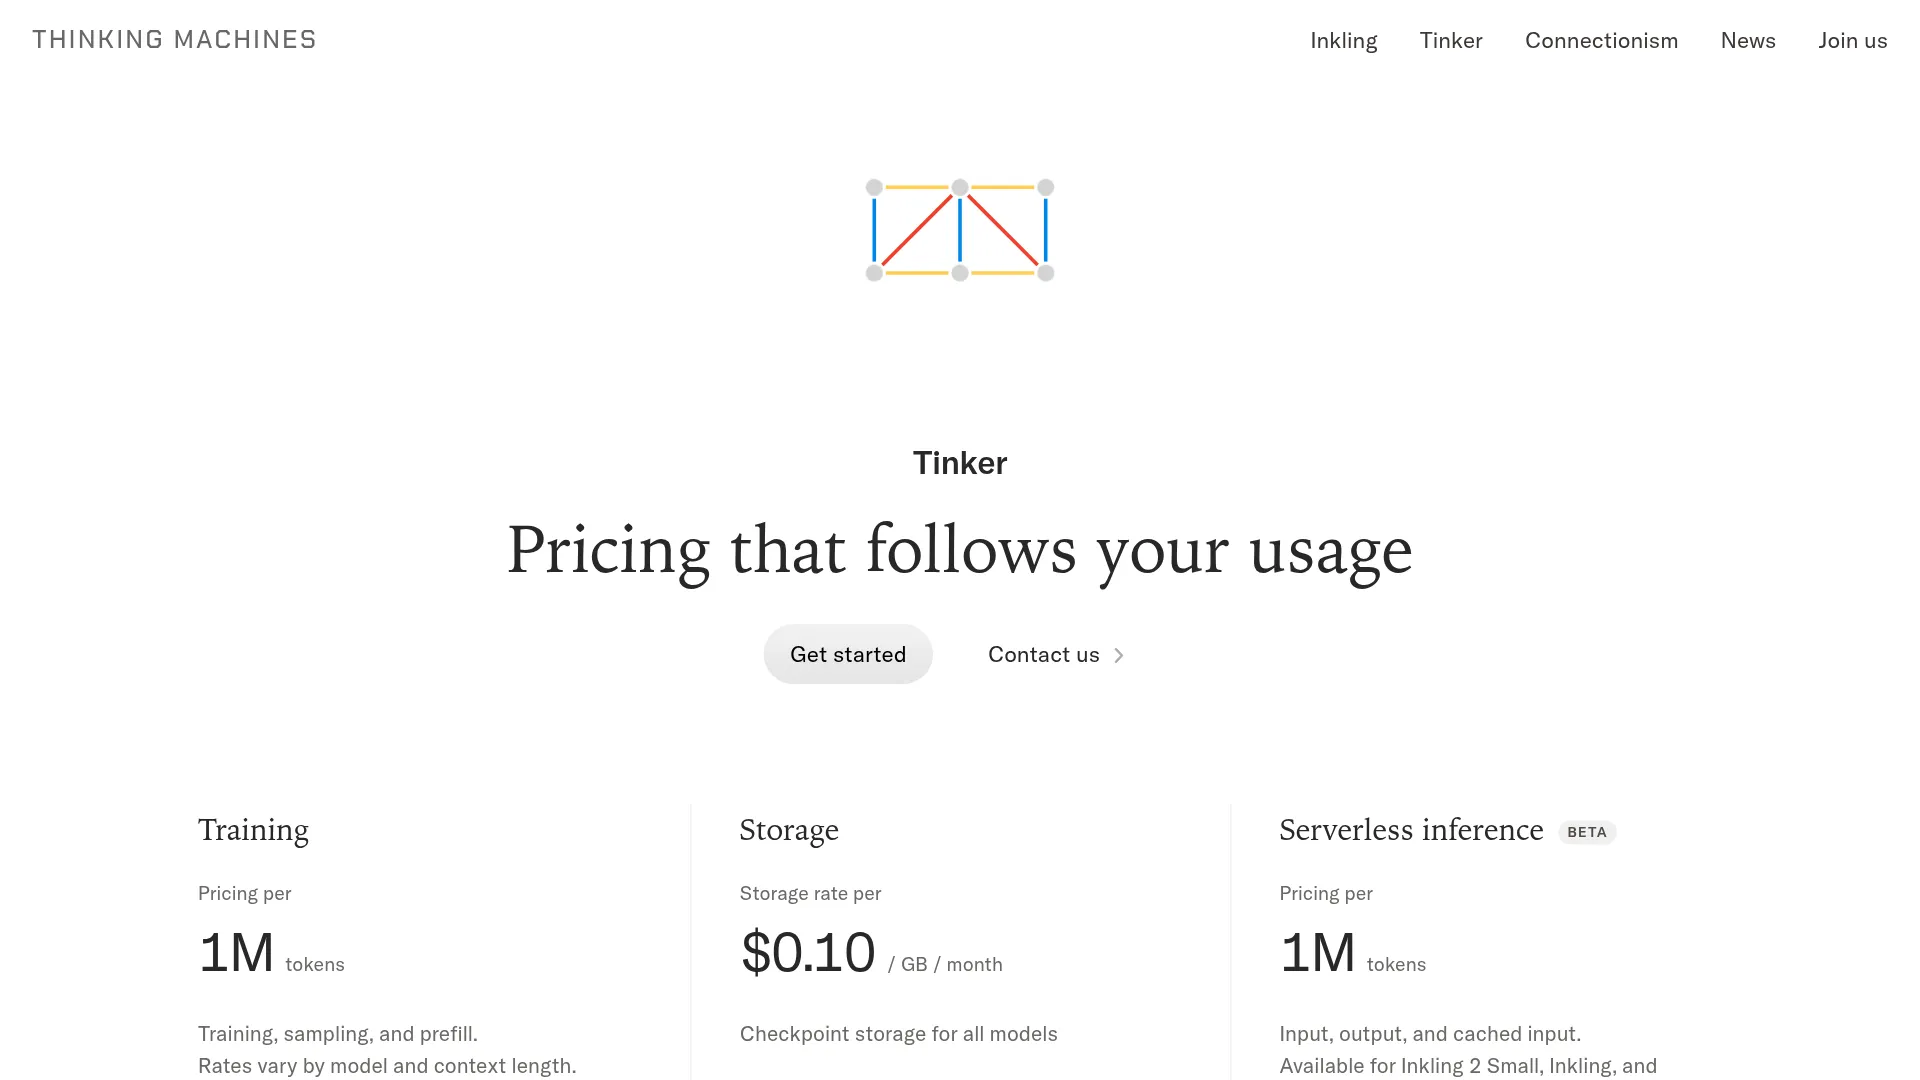
| Modell (Serverless, 256K) | Input / 1M | Gecacht / 1M | Output / 1M |
|---|---|---|---|
| Inkling 2 Small | $0.30 | $0.03 | $1.00 |
| Inkling-Small (Gen 1) | $0.30 | $0.06 | $1.20 |
| Inkling (Flaggschiff) | $1.00 | $0.17 | $4.05 |
Bei 80 % Cache-Treffern kosten 1 Mio. Input-Tokens rund 0,084 US-Dollar (200K x 0,30 US-Dollar plus 800K x 0,03 US-Dollar). Besonders profitieren lange Rollouts mit Kompaktierung: Der Anbieter nennt für dieses Trainingsregime 43K Rollout-Tokens im Median und 1,5M im p99-Wert (Thinking Machines Lab).
Benchmarks: vorne bei Enterprise, hinter DeepSeek Flash beim Coding
Die folgenden Werte stammen aus dem Bericht des Anbieters, der neben Erfolgen auch Rückstände offenlegt (Thinking Machines Lab).
| Benchmark | Inkling 2 Small | Bester Rivale in der Tabelle |
|---|---|---|
| FrontierCode v2.0 | 25.4% | 28.5% DeepSeek-V4.1-Flash-1017 |
| DeepSWE v1.1 | 72.1% | 77.0% DeepSeek-V4.1-Flash-1017 |
| SWEBench Pro v2 Hard | 86.3% | 88.2% Kimi K3 |
| Vibe Code Bench v1.1 | 81.6% | 87.7% DeepSeek-V4.1-Flash-1017 |
| HLE-Diamond | 28.7% | Führt die Gruppe an (Kimi K3 26.9%) |
| LongBench v2 | 70.6% | Führt die Gruppe an (Kimi K3 69.0%) |
| AA-Omniscience (Score / keine Halluzination) | 16.1 / 73.3% | Höchster Wert ohne Halluzinationen in der Gruppe |
| DesignArena Web snapshot | 1,340 (3.) | 1,366 Muse Wonder (Spitzenreiter) |
| JobBench / Vals Legal / Vals Finance | 70.5% / 73.9% / 61.5% | Führt die dargestellten Gruppen an |
| Terminal Bench Science | 5.7% | 12.9% DeepSeek-V4.1-Flash-1017 |
LongBench v2 mit 70,6 % stützt den Anspruch beim langen Kontext, während HLE-Diamond mit 28,7 % die Stärke bei anspruchsvollem Reasoning belegt. In den Enterprise-Wertungen führt das Modell laut Anbieter bei CoreCraft (71,8 %) und DAYJOB Finance (14,3 %) ebenfalls die dargestellten Gruppen an, ebenso wie bei JobBench und Vals. Es gibt aber Einschränkungen: Bei DiligenceBench liegen 58,1 % hinter den 59,0 % von Muse Spark Open. Kernel autoresearch erreicht 6,02x gegenüber 18,80x für Claude Opus 5.5. Das Labor räumt zudem ausführliche Antworten, uneinheitliche Struktur, nicht immer passende Tool-Auswahl und übervorsichtliche Ablehnungen ein (FORTRESS 20.4 gegenüber 3.2 für GLM-5.3).
Die Unterschiede zu Inkling-Small
Die Gesamtzahl der Parameter steigt von 276B auf 594B und die aktiven Parameter von 12B auf 17B. Das Halluzinationsverhalten verbessert sich, dafür entfällt Audio als Eingabe. Das neue Modell akzeptiert nur Text und Bilder, während die erste Generation auch 16-kHz-WAV verarbeiten konnte (Thinking Machines Lab).
Nach den Zahlen des Anbieters sieht die Faktentreue besser aus, auch wenn beide Generationen unterschiedliche Metriken ausweisen. Die erste Generation kam bei SimpleQA Verified auf rund 20,6 % und erzielte einen negativen Omniscience-Score (eesel AI). Inkling 2 Small führt seine Vergleichsgruppe mit 73,3 % ohne Halluzinationen an. Trotzdem warnt das Labor weiterhin vor Ausführlichkeit und übermäßigen Ablehnungen (Thinking Machines Lab).
Self-Hosting-Berichte zur ersten Generation liefern lediglich Kontext, keine Evidenz für v2:
"Ich habe es in Unsloth Studio bei Q4K_XL ausprobiert. In mehrsprachigen Gesprächen schlägt es sich sehr gut." — u/VotZeFuk im Release-Thread zu Inkling-Small der ersten Generation (Reddit)
Die Untergrenze von 89 GB bei 2 Bit für Gen 1 stammt aus Community-Builds von Unsloth (eesel AI). Bei insgesamt 594B Parametern bleiben die Anforderungen von v2 unbekannt, bis Gewichte und Rezepte veröffentlicht werden.
Sollte dein Agent Inkling 2 Small nutzen?
Entscheidend für das Routing ist die Form der Arbeitslast, nicht der aggregierte Benchmark-Rang.
| Deine Arbeitslast | Inkling 2 Small einsetzen? | Warum |
|---|---|---|
| Lang laufende Coding-Agenten mit visuellem Feedback | Über Tinker testen | Training mit Kompaktierung und visuelle Iterationsschleifen passen zu diesem Profil |
| Enterprise-Recherche, Finance- oder Legal-Entwürfe mit Retrieval | Zuerst testen | Führt in den Anbieter-Tabellen bei JobBench, Vals Legal/Finance und DAYJOB Finance; mit eigenen Dokumenten prüfen |
| Fine-Tuning für Aufgaben im Stil von Zusammenfassungen | Testen (nur Anbietertest) | Erreichte im 200-Schritte-Test des Anbieters die finale Qualität von Gen 1 nach 75 Schritten (Thinking Machines Lab) |
| Reines Coding im SWE-bench-Stil bei niedrigster Fehlerrate | Nein, DeepSeek-V4.1-Flash-1017 | 72.1% gegenüber 77.0% bei DeepSWE, 25.4% gegenüber 28.5% bei FrontierCode |
| Fakten-Q&A ohne Retrieval oder Guardrails | Nein, noch nicht | 16.1 bei Omniscience insgesamt liegt hinter dem besten Rivalen; RAG und Confidence-Routing beibehalten |
| Failover über mehrere Anbieter | Nein, abwarten | Nur Tinker als Anbieter, keine Routen über Drittanbieter angekündigt |
Die Alignment-Werte haben sich gegenüber den Vorgängern verbessert: internes Fehlverhalten liegt bei 14.9 statt 66.8 bis 75.2, wobei niedriger besser ist. Zu den 0.8 von GPT-6.1 Sol besteht aber weiterhin Abstand (Thinking Machines Lab).
FAQ zu Inkling 2 Small
Sind die Gewichte von Inkling 2 Small schon offen verfügbar?
Nein. Stand 5. November 2026 sind die Gewichte über Tinker geschlossen verfügbar; Apache-2.0-Gewichte sind nach bestandenen Sicherheitstests für nächste Woche angekündigt.
Worin unterscheidet es sich von Inkling-Small?
594B/17B statt 276B/12B, keine Audio-Eingabe, 73.3 % ohne Halluzinationen und 1,00 statt 1,20 US-Dollar Output pro 1 Mio. Tokens.
Was kostet die API pro 1 Mio. Tokens?
Bei Tinker Serverless und 256K Kontext: 0,30 US-Dollar für Input, 0,03 US-Dollar für gecachten Input und 1,00 US-Dollar für Output.
Kann ich es lokal ausführen?
Noch nicht: Es wurden keine Gewichte, Rezepte oder VRAM-Empfehlungen veröffentlicht.
Weiterführend: DeepSeek-V4.1-Flash-1017 Coding-Test und Kimi K3.1 Pro API-Preise.