 AIREITER
Auf dem Papier ist Moonshots Kimi K3.1 Pro ein starkes Modell für Coding und Agenten: 1 Mio. Token Kontext, $2 pro Million Input-Token und $10 pro Million Output-Token. Für die unten beschriebenen Workloads der Launch-Woche war die nutzungsbasierte API dabei deutlich günstiger als das $39-Abo.
Was Kimi K3.1 Pro eigentlich bietet
Kimi K3.1 Pro ist Moonshot AIs erstes Modell der K3.1-Reihe und erschien am 23. Oktober 2026 als nachtrainierter Nachfolger von Kimi K3. Moonshot positioniert das 3T-Model mit Mixture-of-Experts-Architektur für langlaufende Coding-Aufgaben, Tool-Workflows mit 3D und CAD, die Analyse von Finanzdokumenten sowie mehrstufige Agenten.
Das Kontextfenster umfasst 1.048.576 Token – gemeinsam für Eingabe, Reasoning-Token und Ausgabe. Es handelt sich also nicht um 1 Mio. Token Input plus weitere 1 Mio. Token Output. Über Moonshot-Produkte verarbeitet das Modell Text, Bilder und Videos; die API gibt Text, Code und Tool-Aufrufe zurück. Das sichtbare Ergebnis erzeugt dann externe Software wie Blender, Game Engines oder PDF-Tools. Reasoning ist stets aktiv. Für reasoning_effort stehen low, high und max bereit, standardmäßig ist max aktiv.
Moonshot hatte offene Gewichte bis zum 4. November angekündigt. Beim Check von TheQuery am 24. Oktober ließ sich jedoch weder ein herunterladbarer Checkpoint noch eine finale Lizenz bestätigen. Auch ArtificialWatch führte die Lizenz als unbekannt. Bis Checkpoint und Lizenz veröffentlicht sind, sollte man daher mit der gehosteten API planen.
Preise im Detail: Standard gegen Highspeed
In der Standardvariante kostet Kimi K3.1 Pro auf der Kimi API platform $2 pro Million nicht gecachter Input-Token und $10 pro Million Output-Token. Kimi K3.1 Pro Highspeed verdoppelt die nutzungsbasierten Preise auf $4 für Input und $20 für Output, behält aber den Preis von $0.20 für gelesene Cache-Inputs bei. Dieselbe Staffelung von $2/$10 und $4/$20 nennen auch ArtificialWatch und die Preistabelle von AI/ML API.
| Vorgang (pro 1 Mio. Token) | Kimi K3.1 Pro | Kimi K3.1 Pro Highspeed |
|---|---|---|
| Nicht gecachter Input | $2.00 | $4.00 |
| Output (einschließlich Reasoning) | $10.00 | $20.00 |
| Gelesener Cache-Input | $0.20 | $0.20 |
| Cache schreiben, 5 Minuten Laufzeit | $2.00 | $4.00 |
| Cache schreiben, 1 Stunde Laufzeit | $4.00 | $8.00 |
Drei Abrechnungsdetails sind wichtiger als der Listenpreis. Erstens gelten die Preise unabhängig von der Kontextlänge, und die Standardlaufzeit des Caches beträgt fünf Minuten. Wird ein Prompt-Präfix in diesem Zeitfenster wiederverwendet, sinkt der Preis von $2.00 auf $0.20. Zweitens werden Reasoning-Token zum Output-Preis abgerechnet. Bei langen Agent-Traces kann max deshalb den Großteil der Rechnung ausmachen. Drittens sind API-Kosten von Kimi-Mitgliedschaften und Kimi-Code-Abos getrennt. Der Check von TheQuery zum Batch-API-Leitfaden führte K3.1 Pro nicht auf – einen Batch-Rabatt sollte man also nicht voraussetzen.
Ein festes Token-Beispiel bleibt zu diesen Preisen günstig: 100.000 nicht gecachte Input-Token ($0.20) plus 10.000 Output-Token ($0.10) ergeben $0.30, bevor Cache-Schreibvorgänge, Tools, Wiederholungen und Steuern hinzukommen.
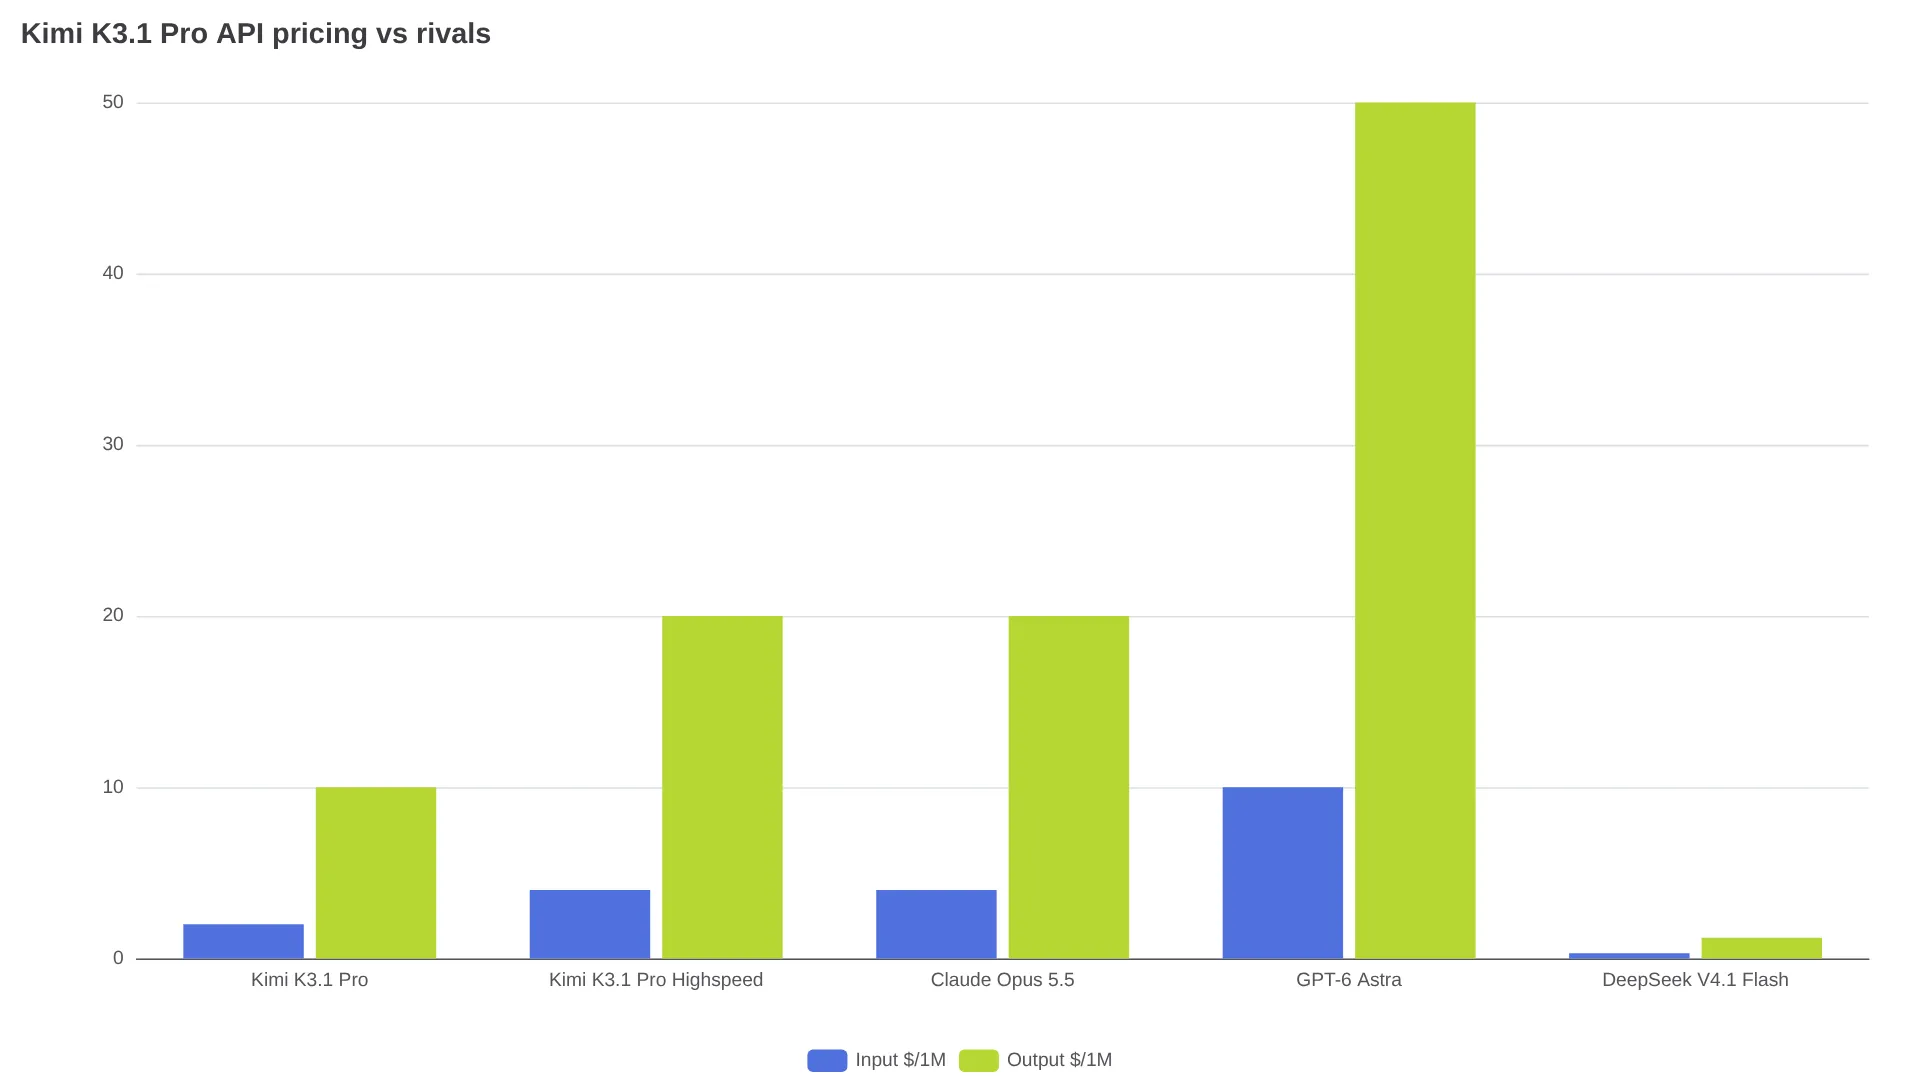
Verglichen mit der Konkurrenz ist K3.1 Pro in der Standardvariante 33% günstiger als Kimi K3 pricing ($3/$15), halb so teuer wie Claude Opus 5.5 ($4/$20) und kostet laut dem Vergleich von ArtificialWatch nur ein Fünftel von GPT-6 Astra ($10/$50). DeepSeek V4.1 Flash unterbietet laut der Preistabelle von AI/ML API mit $0.30/$1.20 alle aufgeführten Rivalen, liegt bei den Benchmarks im nächsten Abschnitt aber deutlich zurück. Highspeed kostet exakt so viel wie Opus 5.5. Es lohnt sich daher nur, wenn die behauptete Beschleunigung um das 2- bis 3-Fache eine latenzkritische Aufgabe genug verkürzt, um die doppelten Token-Kosten auszugleichen.
Warum das $39-Abo schnell an Grenzen stößt – die API aber nicht
Am Launch-Tag wirkte der API-Preis fair, das Abo dagegen nicht. Mehrere zahlende Nutzer berichteten, dass ihr 5-Stunden-Kontingent nach nur ein oder zwei Prompts aufgebraucht gewesen sei und ein einzelner Coding-Task Monatskontingente verschlungen habe.
"Kimi K3.1 Pro is the best open model in the world right now. No contest. But it's practically unusable on its own subscription. I was on the $39 plan. I built the ship test... it ate 11.6% of my monthly quota. That means I can build something like this about 8 times a month... Worst subscription out there... The bottleneck isn't quality. It's compute." — @Da7_Tech, vom Nutzer gemeldeter Quotenverbrauch
"absolutely disgusting and shameful usage limits on Kimi K3.1 Pro. My 5-hour limit was DONE after exactly 1 min into the prompt, and nothing was built!" — @MiaAI_lab, Abonnent des $39-Plans
Ein Nutzer berichtete, $400 für Abos bei vier Prompts ausgegeben zu haben, und schätzte die gleiche Arbeit per API auf $29. Ein anderer meldete, dass eine einzelne Animationsaufgabe den Großteil eines 5-Stunden-Kontingents verbraucht habe. Für Entwickler ist die Konsequenz klar: K3.1 Pro besser über eine nutzungsbasierte API bewerten – bei Moonshot, OpenRouter oder Vercel AI Gateway. Dort kosten 100k Input plus 10k Output vor Wiederholungen und Tools $0.30, statt dass dieselbe Reasoning-Leistung durch ein Abo-Kontingent wesentlich aggressiver begrenzt wird.
Benchmarks: aussagekräftig, aber mit Hersteller-Vorbehalt
Alle folgenden Spitzenwerte stammen von Moonshot, sofern nicht anders angegeben. Sie wurden mit maximalem Reasoning-Aufwand, Temperatur 1.0 und top-p 0.95 ermittelt. Kleine Unterschiede sollte man als setupabhängig behandeln: Die Vergleichswerte entstanden mit unterschiedlichen Harnesses – Kimi Code für Kimi, Claude Code für die anderen Modelle und Codex für GPT-6 Astra bei OfficeQA –, wie AI/ML API dokumentiert.
| Evaluation | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek V4.1 Flash 1017 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | 58.2% | 42.3% |
| SWE-Marathon v1.1 | 51.7% | 46.3% | 42.5% | 40.0% |
| Agents' Last Exam v1.1 | 43.2% | 42.6% | 32.8% | 37.7% |
| OfficeQA Pro v2 | 64.4% | 62.2% | 54.4% | 40.4% |
| BenchCAD mit Tools | 92.7% | 96.2% | 95.9% | 81.6% |
Kimi führt in drei von fünf Disziplinen und liegt bei Terminal-Bench lediglich 0.7 Punkte zurück. Wie TheQuery anmerkt, ist dieser Abstand kleiner als der von Anthropic für Opus ausgewiesene Standardfehler von 2.6 Punkten. Die 92.7% bei BenchCAD entsprechen der Voxel-Überlappung auf einem Open-Model-Subset mit 1.000 Fällen. Claudes Werte wurden zudem aus System Cards übernommen und nicht in einem einheitlichen Durchlauf neu gemessen, wie die Methodiknotizen von AI/ML API festhalten.
Bei der Faktentreue weist Moonshots interner Kimi Hallu Bench für K3.1 Pro auf dem Standard-Set 5.4% Fehler auf Claim-Ebene aus, gegenüber 4.2% für GPT-6 Astra. Im Hard-with-tools-Set sind es 8.3% gegenüber 5.5%, laut der Hallu-Tabelle von AI/ML API. Gegenüber K3 mit 23.4% im Hard-Set entspricht das einer relativen Senkung um 65%. Astra führt jedoch weiterhin in beiden Splits. Wo schon eine falsche Behauptung das Ergebnis unbrauchbar macht, bleibt Astra deshalb in der engeren Auswahl. Alle Werte stammen aus adversarialen Stresstests, nicht aus alltäglichen Fehlerwahrscheinlichkeiten.
Der zum Start verfügbare unabhängige Datenpunkt kommt von Artificial Analysis: K3.1 Pro erreichte 55 Punkte im Intelligence Index und Platz #4 insgesamt – hinter Claude Opus 5.5, Sonnet 5.5 und Muse Wonder Full. Das stützt die Einordnung als Modell nahe der Spitze zum halben Preis, ohne sich allein auf Herstellerläufe zu verlassen.
API-Aufruf ohne unnötige Mehrkosten
Kimi K3.1 Pro ist OpenAI-kompatibel. Für die Migration müssen daher nur Base-URL und Modell-ID geändert werden. Die offizielle Base-URL lautet https://api.moonshot.ai/v1, die Modell-IDs sind kimi-k3.1-pro und kimi-k3.1-pro-highspeed. Das bestätigen der Endpoint-Check von TheQuery und der Einrichtungsleitfaden von AI/ML API. Drittanbieter-Gateways verwenden qualifizierte IDs, etwa moonshot/kimi-k3.1-pro bei Requesty oder moonshotai/kimi-k3.1-pro bei Vercel.
Der Quickstart setzt Temperatur 1.0 und top-p 0.95 fest und empfiehlt laut den API-Hinweisen von TheQuery, beide Werte wegzulassen statt sie zu tunen. Die Kosten steuert man stattdessen mit reasoning_effort: Für Tests mit low beginnen, bei Fehlschlägen auf high erhöhen und max – den Standardwert – dem finalen Lauf vorbehalten. Ein Budget von 8.192 Token bei max_completion_tokens kann eine deutlich kürzere sichtbare Antwort liefern, weil verborgenes Reasoning aus demselben Budget zu $10 pro Million bezahlt wird.
Checkliste zur Kostenkontrolle laut dem Leitfaden von AI/ML API zu Tool-Nutzung und Token:
- Zwischen Tool-Schritten die vollständige Assistant-Nachricht erhalten, beim Streaming einschließlich
reasoning_content, und Tool-Ergebnisse vor dem nächsten Aufruf zurückgeben. - Prompt-Präfixe innerhalb des 5-Minuten-Cache-Fensters wiederverwenden, um wiederholten Input auf $0.20 pro Million zu senken.
- Kosten pro akzeptiertem Ergebnis messen, nicht pro Token.
- Ein pro Token günstigeres Modell ist nicht günstiger, wenn es zwei Wiederholungen braucht.
from openai import OpenAI
client = OpenAI(
    base_url="https://api.moonshot.ai/v1",
    api_key="YOUR_KIMI_KEY",
)
resp = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Refactor this module with tests"}],
    extra_body={"reasoning_effort": "low"},
    max_completion_tokens=8192,
)
print(resp.choices[0].message.content)
Eine Aufladung von $1 schaltet den Zugang frei, vorbehaltlich gestaffelter Rate Limits. Enterprise-Zugang ist standardmäßig deaktiviert und muss laut dem API-Verhaltenscheck von TheQuery zunächst durch einen Administrator freigegeben werden. Zum Datenschutz berichtet Oppers Prüfung der Moonshot-Route, dass Inhalte gespeichert und Kundendaten auf dieser Route standardmäßig fürs Training verwendet werden; eine Option für Zero Data Retention gibt es dort nicht. Vertrauliche oder regulierte Daten sollten ohne vertragliche Absicherung nicht über diese Route laufen.
Lohnt sich Kimi K3.1 Pro? Auf diesen Kompromiss kommt es an
| Wenn Sie brauchen | Wählen Sie | Warum |
|---|---|---|
| Günstigste Coding-Läufe auf Frontier-Niveau | Kimi K3.1 Pro API | Führt bei SWE-Marathon zum halben Opus-Preis, 1 Mio. Token gemeinsamer Kontext |
| Niedrigste Latenz | Kimi K3.1 Pro Highspeed | Behauptete Beschleunigung um das 2- bis 3-Fache, aber exakt doppelte Token-Kosten |
| Wenigste Faktenfehler | GPT-6 Astra | 4.2% gegenüber 5.4% im Standard-Hallu-Test, zum 5-fachen Preis |
| Günstigste Token, schwächere Scores | DeepSeek V4.1 Flash | $0.30/$1.20, aber auf vier der fünf aufgeführten Benchmarks Letzter |
| Self-Hosting | Abwarten | Gewichte bis 4. November versprochen, Lizenz unbekannt |
Falls Moonshot bis zum 4. November vollständige Gewichte unter einer freizügigen Lizenz veröffentlicht, könnte Self-Hosting die Rechnung zwischen Kontingent und API grundlegend verändern. Entwickler, die Long-Context-Modelle fürs Coding vergleichen, sollten sich vor einer Festlegung außerdem die best LLM for coding agents in 2026 ansehen.
Kimi K3.1 Pro API: FAQ
Wie viel kostet die Kimi K3.1 Pro API?
Kimi K3.1 Pro in der Standardvariante kostet $2 pro Million nicht gecachter Input-Token und $10 pro Million Output-Token. Gelesene Cache-Inputs kosten $0.20 pro Million. Highspeed verdoppelt die Preise für Input, Output und Cache-Schreibvorgänge, während das Lesen aus dem Cache weiterhin $0.20 kostet.
Was unterscheidet K3.1 Pro von Highspeed?
Highspeed bewirbt bei gleicher Intelligenz eine Serving-Geschwindigkeit um das 2- bis 3-Fache, verlangt dafür aber den doppelten Input-/Output-Preis ($4/$20 statt $2/$10). Die Live-Provider-Tabelle von Vercel weist für Highspeed geringere Latenz und höheren Durchsatz aus. Ein unabhängiger Vergleich der Aufgabenabschlusszeit für Moonshots Beschleunigungsversprechen fehlt jedoch.
Wie lauten die API-Modell-IDs?
Auf der offiziellen Kimi API werden kimi-k3.1-pro und kimi-k3.1-pro-highspeed verwendet. Bei Drittanbieter-Gateways kommen qualifizierte Varianten zum Einsatz, beispielsweise moonshot/kimi-k3.1-pro. Bestehende K3-Integrationen müssen die IDs ausdrücklich umstellen.
Ist die API-Nutzung in einer Kimi-Mitgliedschaft enthalten?
Nein. API-Gebühren werden getrennt von Kimi-Mitgliedschaften und Kimi-Code-Abos berechnet. Nutzer der Launch-Woche stellten fest, dass Abo-Kontingente für dieselbe Arbeit wesentlich restriktiver ausfielen als nutzungsbasiert bezahlte Token.
Lässt sich Reasoning deaktivieren?
Nein. Kimi K3.1 Pro nutzt immer Reasoning. low, high und max reduzieren lediglich den Umfang der Überlegung, wobei max der Standardwert ist. Für kurze Anfragen ohne Reasoning sollte ein anderes Modell genutzt werden.
Ist die API OpenAI-kompatibel?
Ja. Ein OpenAI-SDK-Client wird auf https://api.moonshot.ai/v1 oder die Base-URL eines Gateways gerichtet, dann wird die Modell-ID gesetzt und mit stream=True gestreamt. Temperatur 1.0 und top-p 0.95 sind im Quickstart fest vorgegeben. Stattdessen sollten reasoning_effort und max_completion_tokens angepasst werden.