 AIREITER
Wer diese Woche einen Checkpoint selbst hosten will, hat nur eine Wahl: MiniMax M3.1 Flash. Die offenen Gewichte lassen sich bereits herunterladen, während Moonshot die Gewichte für Kimi K3.1 Pro erst bis zum 4. November 2026 zugesagt hat. Von den beiden Modellen ist MiniMax damit derzeit das einzige, das sich direkt von Hugging Face beziehen lässt.
Auf Hugging Face ist bislang nur MiniMax verfügbar
MiniMax veröffentlichte die Gewichte für M3.1 Flash ungefähr am 22. oder 23. Oktober 2026 auf Hugging Face. Sie stehen unter der Lizenz minimax-community; laut Berichten zum Launch ist das Modell auch über ModelScope verfügbar (Cocoloop). Kimi K3.1 Pro ist laut offiziellem Tech-Blog von Kimi heute über Kimi.com, die Apps, Kimi Code und die Kimi API nutzbar. Die vollständigen Modellgewichte sollen bis zum 4. November 2026 folgen (kimi.com).
MiniMax M3.1 Flash und Kimi K3.1 Pro im direkten Vergleich
Die offenen Gewichte von MiniMax M3.1 Flash gehören zu einem nativ multimodalen MoE-Modell mit rund 428 Milliarden Gesamtparametern und 23 Milliarden aktiven Parametern pro Token. Es verarbeitet Text, Bilder und Video und erzeugt Text; das Kontextfenster reicht bis 1M Token (Launch-Beitrag von MiniMax). Kimi beschreibt K3.1 Pro offiziell als MoE der 3T-Klasse mit einem Kontextfenster von 1M Token (kimi.com). Die Angaben von 2.8T Gesamtparametern und 104B aktiven Parametern stammen aus der Launch-Berichterstattung (ArtificialWatch, ExplainX) und nicht aus einer eigenen Parameterangabe von Moonshot.
| Punkt | MiniMax M3.1 Flash | Kimi K3.1 Pro |
|---|---|---|
| Gesamt- / aktive Parameter | ca. 428B / 23B pro Token | 3T-Klasse; Launch-Berichte nennen 2.8T / 104B aktiv |
| Hugging-Face-Repository | MiniMaxAI/MiniMax-M3.1-Flash, verfügbar | Keines zum 24. Oktober 2026; erwartet bis 4. November |
| Downloadgröße | Rund 252 GB | Unbekannt; bei der Dichte von MiniMax (ca. 0.59 GB pro B Parameter) wäre ein 2.8T-Checkpoint in der TB-Klasse |
| Kontext | Bis zu 1M Token, abhängig vom Deployment | 1M Token |
| Eingaben / Ausgabe | Text, Bild, Video hinein; Text heraus | Multimodal, Textausgabe; genaue Modalitäten beim Self-Hosting unbestätigt |
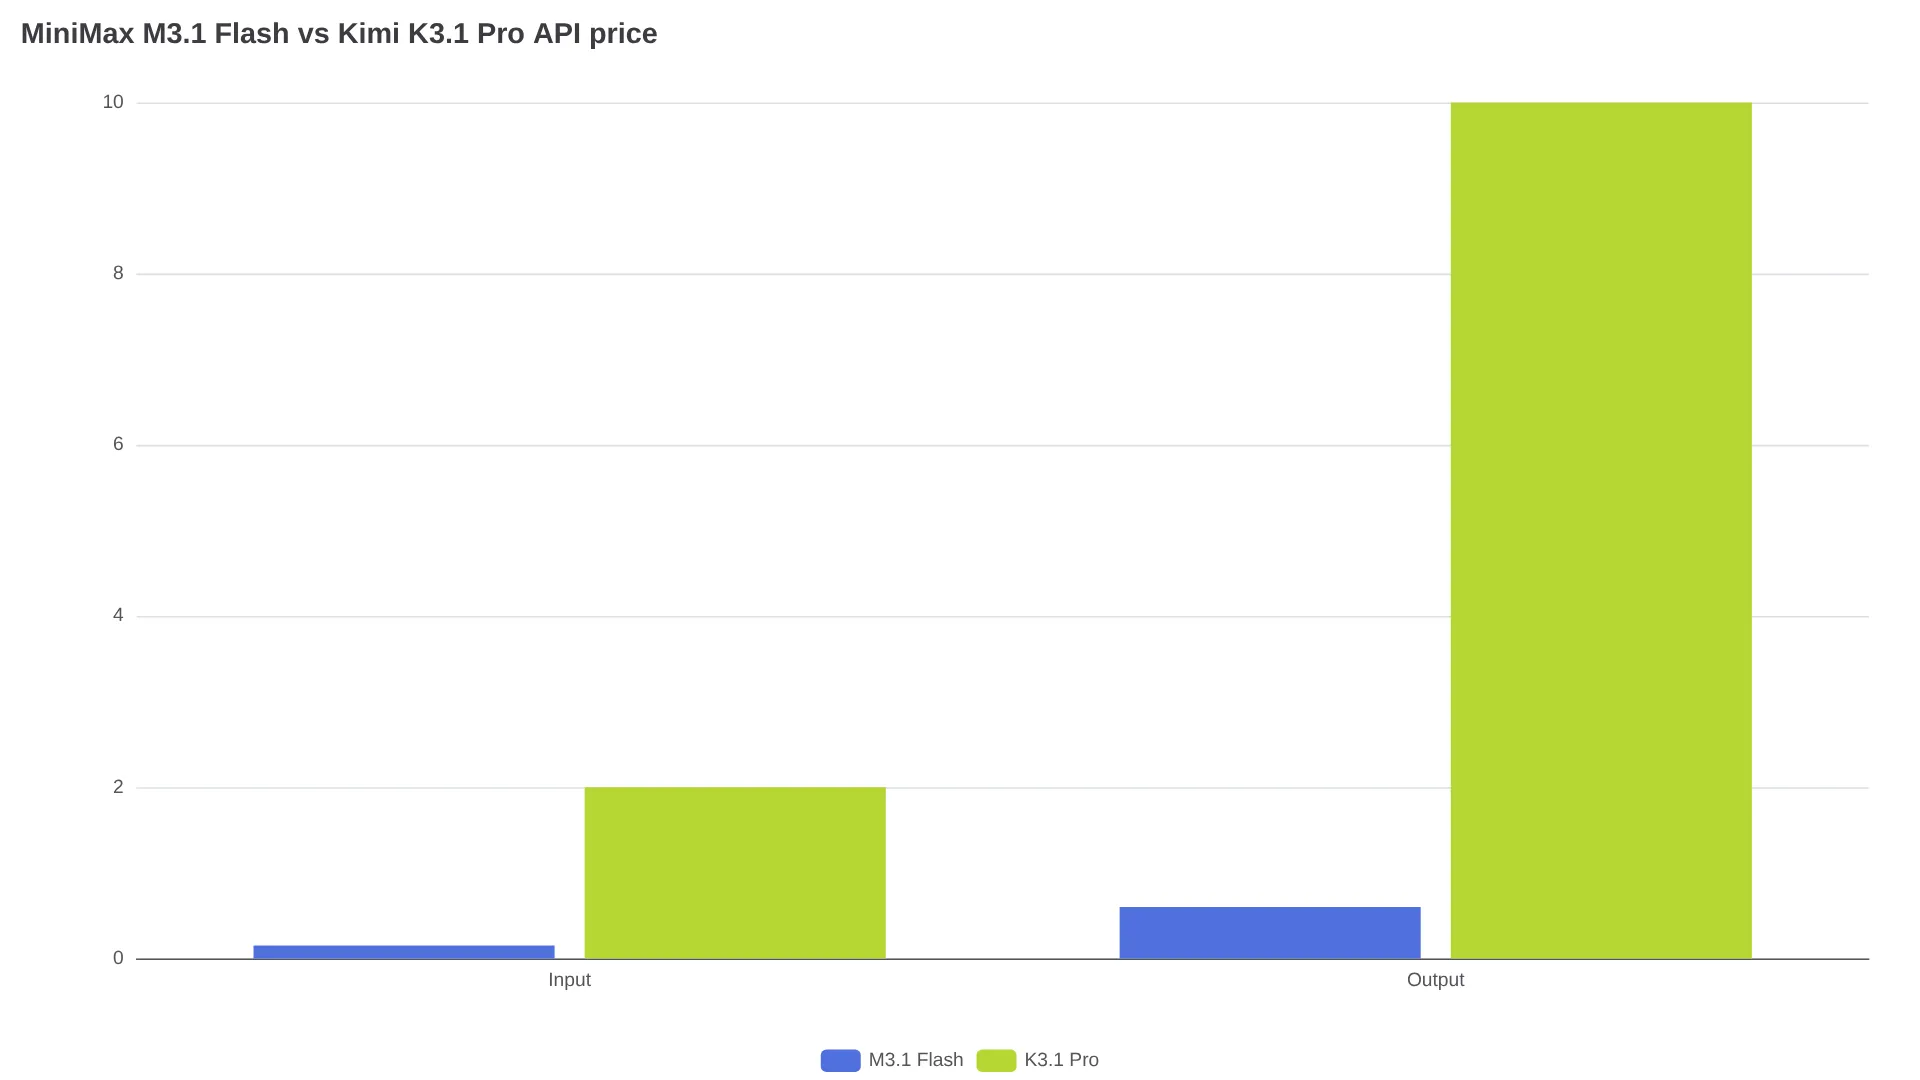
| Offizieller API-Preis | $0.15 Input / $0.60 Output / $0.015 Cache pro 1M Token (MiniMax) | Berichtet: $2 Input / $10 Output pro 1M Token (ArtificialWatch) |
| Serving-Rezepte | SGLang, vLLM, TokenSpeed; FlagOS für mehrere Chips | Noch nicht angekündigt; API-Modell-IDs kimi-k3.1-pro / kimi-k3.1-pro-highspeed (Kimi-Dokumentation) |
| Empfohlenes Sampling | Temperature 1.0, top-p 0.95; Reasoning low–max | Maximaler Reasoning-Aufwand, Temp 1.0, top-p 0.95 laut Kimis Benchmark-Konfiguration |
Der MiniMax-Checkpoint lässt sich mit dem offiziellen Befehl herunterladen:
hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-FlashVor Benchmarks sollten alle Dateien vorhanden sein, einschließlich DSpark-Draft-Head, Tokenizer und Konfigurationsdateien. MiniMax weist darauf hin, dass die Ergebnisse für die offiziellen Gewichte gelten; Quantisierungen von Drittanbietern können abweichen.
Bei den folgenden Benchmarks sollten alle Werte als Herstellerangaben gelten, sofern nicht ausdrücklich unabhängig gekennzeichnet:
| Benchmark | M3.1 Flash (Hersteller) | Vom Hersteller genannter Rivale |
|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | DeepSeek V4.1 Flash-1017: 60.5 |
| BankerToolBench | 76.2 | Opus 5: 76.2 (Gleichstand) |
| LOCA-Bench 256K | 60.3 | GPT-5.6 Sol: 60.0 |
| DeepSWE v1.1 | 73.7 | DeepSeek V4.1 Flash-1017: 77.0 |
| OSWorld 2.0 | 61.7 | Opus 5: 70.6 |
| Terminal-Bench 4.0 | 38.1 | Opus 5: 51.8 |
Eine zitierte unabhängige Momentaufnahme verortet M3.1 Flash mit 53.78 % im Mittelfeld, auf Platz 16 von 26, und sieht Schwächen bei Langzeit-Aufgaben (Vals). Kimis eigene Grafik sieht K3.1 Pro in 6 von 14 gezeigten Tests vorn, darunter Agents' Last Exam (43.2) und SWE Marathon (51.7); bei Terminal-Bench 4.0 liegt der Wert bei 65.7.
Was der Download mit 252 GB beim Hosting bedeutet
Das Repository umfasst rund 252 GB. Bei 4 Bit pro Gewicht belegen allein die 428B Parameter etwa 214 GB, noch ohne KV-Cache und Laufzeitpuffer. Für brauchbaren Kontext sollten daher mehrere GPUs der 80-GB-Klasse eingeplant werden. NVIDIA verweist für lokale Läufe auf eine DGX Station oder einen Cluster aus 4x DGX Spark 128 GB (X-Post). Self-Hoster auf X merken zudem an, dass ein 252-GB-Download plus diese Hardware-Hürde gewöhnliche Desktop-PCs ausschließt, während die API günstig bleibt (@bufcapy).
Vor dem Eigenbetrieb lohnt sich zunächst die API-Rechnung, denn die MiniMax API ist ungewöhnlich günstig. Bei $0.15 für Input und $0.60 für Output pro 1M Token kosten 10M Input- plus 2M Output-Token am Tag 10 × $0.15 + 2 × $0.60 = $2.70, also rund $81/Monat.
Die Break-even-Rechnung lautet: monatliche Clusterkosten geteilt durch API-Kosten pro Token. Bei $0.15 je 1M Input-Token entsprechen jeweils $150/Monat Miete 1B Input-Token; bei $0.60 je 1M Output-Token entsprechen $600/Monat 1B Output-Token. In die eigene Rechnung gehören Mietangebot und Engineering-Aufwand: Self-Hosting lohnt sich erst, wenn die monatliche API-Rechnung zu diesen Preisen darüber liegt oder wenn Vorgaben verlangen, dass die Gewichte innerhalb der eigenen Infrastruktur bleiben. Bei Kimi fällt der Unterschied noch stärker aus: Die berichteten API-Preise von $2/$10 pro 1M Token liegen beim Input etwa 13x und beim Output etwa 17x über MiniMax. Ein künftiger Checkpoint mit 2.8T Parametern müsste daher dauerhaft sehr hohen Durchsatz liefern, um Speicher in der TB-Klasse und einen Multi-Node-Cluster zu rechtfertigen.
Was beim Self-Hosting ab Tag eins funktioniert
Die Framework-Unterstützung zum Start ist vorhanden, aber nicht vollständig. In der Model Card stehen SGLang, vLLM und TokenSpeed sowie FlagOS für Deployments über mehrere Chips; für SGLang gibt es Docker-Images. Integrationen für Transformers, KTransformers, unsloth und ATOM befanden sich bei Veröffentlichung noch in Arbeit. Ein Deployer weist darauf hin, dass die Beispielkonfiguration für vLLM auf H100/H200 auf 256K Token statt der vollen 1M zielt, Videoeingabe deaktiviert und DSpark Speculative Decoding nicht einschaltet (@sancaksofttech). Der Download ist derselbe, doch nicht jedes Setup erschließt alle Funktionen.
Eine wiederkehrende Sorge auf r/LocalLLaMA: „Flash“ steht für die Inferenzökonomie, nicht für eine geringe Modellgröße:
With quantization can it fit on 256GB? Praying — u/BawbbySmith on r/LocalLLaMA
Die Lizenzfrage kommt vor der Hardware
M3.1 Flash bietet offene Gewichte, ist aber nicht Open Source. Die Datei LICENSE im Repository, gekennzeichnet als minimax-community (siehe LICENSE-Datei), erlaubt nicht kommerzielle Nutzung frei. Für kommerzielle Nutzung müssen „Built with MiniMax M3.1-Flash“ deutlich sichtbar angebracht und MiniMax einmalig benachrichtigt werden. Organisationen oder Produkte mit mehr als $20M Jahresumsatz benötigen vorher eine schriftliche Genehmigung; militärische Nutzung ist untersagt.
Für interne Tools ist diese Belastung gering, für kommerzielles Hosting kann sie jedoch zum Hindernis werden: Gerade dort sind Badge-Pflicht und Umsatzgrenze am schwierigsten zu erfüllen. Die Lizenz von Kimi bleibt bis zum Release der Gewichte am 4. November unbekannt. Moonshot hat im Tech-Blog bereits offengelegt, dass sich der offene Checkpoint vom API-Modell unterscheiden wird, weil cyberbezogene Trainingsdaten aus den offenen Gewichten entfernt wurden (kimi.com). Vor dem Aufbau sollten beide LICENSE-Dateien gelesen werden.
Welches Modell zu welchem Einsatz passt
| Ihre Situation | Empfehlung |
|---|---|
| Diese Woche Gewichte für lokale Evaluierung, Fine-Tuning-Basis oder Air-Gap-Deployment nötig | MiniMax M3.1 Flash — die einzige herunterladbare Option der beiden |
| Kostensensible Coding-Agents mit schwankender Last | MiniMax API für $0.15/$0.60 — Self-Hosting erst bei dauerhaft hohem Volumen |
| Spitzenleistung bei Coding über lange Aufgabenketten, Wartezeit ist möglich | Kimi K3.1 Pro API jetzt evaluieren; erst nach den Gewichten, der Lizenz und der realen Größe am 4. November über Self-Hosting entscheiden |
| Kommerzielles Hosted-Produkt | Attribution und die $20M-Genehmigungsschwelle von MiniMax zuerst rechtlich prüfen; Kimi lässt sich bis zur Veröffentlichung der Lizenz nicht beurteilen |
| Consumer-GPU oder einzelner Mac | Keine validierte Einzelgerät-Konfiguration genannt — API nutzen, sofern kein nicht unterstütztes Setup getestet werden soll |
FAQ
Wo gibt es den offiziellen Download der MiniMax M3.1 Flash Weights?
Das offizielle Repository heißt MiniMaxAI/MiniMax-M3.1-Flash und liegt auf Hugging Face; zusätzlich gibt es einen ModelScope-Mirror. Der Download erfolgt mit hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-Flash.
Gibt es ein offizielles Hugging-Face-Repository für Kimi K3.1 Pro?
Nein. Zum 24. Oktober 2026 existiert kein öffentliches Repository mit K3.1-Pro-Gewichten; Moonshots Tech-Blog sagt die vollständigen Gewichte bis zum 4. November 2026 zu.
Darf ich MiniMax M3.1 Flash kommerziell einsetzen?
Ja, unter Bedingungen: „Built with MiniMax M3.1-Flash“ muss angezeigt, MiniMax einmalig benachrichtigt und oberhalb von $20M Jahresumsatz eine vorherige schriftliche Genehmigung eingeholt werden. Militärische Nutzung ist verboten. Die LICENSE-Datei im Repository sollte gemeinsam mit der Rechtsberatung geprüft werden.
Läuft das Modell auf einer Consumer-GPU oder Apple Silicon?
Die zitierten Deployment-Hinweise enthalten kein validiertes Setup für eine einzelne Consumer-GPU. Schätzungen gehen von mehreren 80-GB-GPUs für quantisierte Gewichte plus KV-Cache aus. NVIDIA verweist auf eine DGX Station oder einen Cluster aus 4x DGX Spark 128 GB.
Funktioniert es heute mit vLLM oder SGLang?
Für beide gibt es Rezepte zum Launch, außerdem TokenSpeed und FlagOS für Multi-Chip-Läufe. Beispielkonfigurationen können den Kontext jedoch auf 256K begrenzen, Videoeingabe deaktivieren oder DSpark ausgeschaltet lassen — das aktuelle Rezept der Model Card sollte für die jeweilige Hardware geprüft werden.
Steht beim Self-Hosting der volle 1M-Kontext zur Verfügung?
Das beworbene Maximum liegt bei 1M Token, die praktisch nutzbare Länge hängt jedoch vom GPU-Speicher und der Serving-Konfiguration ab. Für Long-Context-Workloads sollte KV-Cache-Reserve explizit eingeplant werden.
Weiterführende Artikel: MiniMax M3.1 Flash Open Weights: Download, Run, Cost Guide, Kimi K3.1 Pro API Pricing Guide, Kimi K3 Open Weights