 AIREITER
Seit dem 23. Oktober 2026 sind die Open Weights von MiniMax M3.1 Flash verfügbar. Entscheidend ist weniger der Launch-Hype als die praktische Realität: Der herunterladbare 428B-Checkpoint ist für nahezu kein Single-GPU-System eine sinnvolle Option. Das Repository MiniMaxAI/MiniMax-M3.1-Flash umfasst rund 252 GB in 48 Shards und ist ohne Freigabe-Hürde zugänglich. Die MiniMax Community License knüpft die kommerzielle Nutzung jedoch weiterhin an Attribution, eine einmalige Mitteilung und eine vorherige Genehmigung bei mehr als $20M Jahresumsatz.
252 GB in einem Satz: Für wen sich der Checkpoint lohnt
MiniMax M3.1 Flash ist ein nativ multimodales Mixture-of-Experts-Modell mit rund 428 Milliarden Gesamtparametern, von denen pro Token etwa 23 Milliarden aktiviert werden. Es verarbeitet Text, Bilder und Videos, gibt Text aus und unterstützt Kontexte mit bis zu 1,000,000 Tokens. Zum Einsatz kommen durchgängig MiniMax Sparse Attention sowie ein mitgelieferter DSpark-Draft-Head für Speculative Decoding. Die Weights sind jetzt über Hugging Face und einen ModelScope-Mirror erhältlich. „Flash“ steht dabei für die Inferenzökonomie, nicht für eine geringe Modellgröße. Und „open weights“ ist nicht gleichbedeutend mit Open Source.
| Fakt | Bestätigter Wert |
|---|---|
| Gesamt- / aktive Parameter | ~428B insgesamt, ~23B pro Token |
| Kontextfenster | Bis zu 1,000,000 Tokens |
| Eingaben / Ausgabe | Text, Bild und Video hinein; Text heraus |
| Checkpoint-Größe | ~252 GB, 48 safetensors-Shards + DSpark-Draft-Head |
| Quantisierung | MXFP8-Konfiguration; NVFP4 auf dem gerouteten MoE-Pfad |
| Inferenz-Einstellungen | Temperatur 1.0, top-p 0.95, reasoning_effort low / medium / high / xhigh / max |
| Serving-Rezepte | SGLang, vLLM, TokenSpeed; FlagOS für Multi-Chip |
| API-Preis | $0.15 Input / $0.60 Output / $0.015 Cache pro 1M Tokens |
| Gemessene Kosten pro Aufgabe | ~$0.22 pro agentischer Aufgabe (Artificial Analysis via TPS Report) |
| Lizenz | MiniMax Community License; kommerzielle Nutzung an Bedingungen geknüpft |
Passend ist das Modell für Teams mit Multi-GPU-Infrastruktur oder für Agent-Workloads, bei denen die API für $0.15/$0.60 die aktuelle Rechnung bereits unterbietet. Nicht passend ist es für Laptops und einzelne Consumer-GPUs – ebenso wenig für kommerzielle Produkte, die die geforderte Attribution nicht führen können. Mein Fazit: Erst die API einsetzen; Self-Hosting erst dann, wenn Volumen oder Datenkontrolle die Hardware rechtfertigen.
Die offiziellen Weights herunterladen und prüfen
Der offizielle Checkpoint liegt auf Hugging Face unter MiniMaxAI/MiniMax-M3.1-Flash. Der Ankündigungspost von MiniMax vom 23. Oktober verweist sowohl auf Hugging Face als auch auf Downloads über ModelScope. Laut der Release-Analyse von alfw.ai beträgt der Download rund 252 GB und kommt ohne Download-Gate: 48 Weight-Shards, ein separater DSpark-Draft-Head sowie Tokenizer- und Konfigurationsdateien.
hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-Flash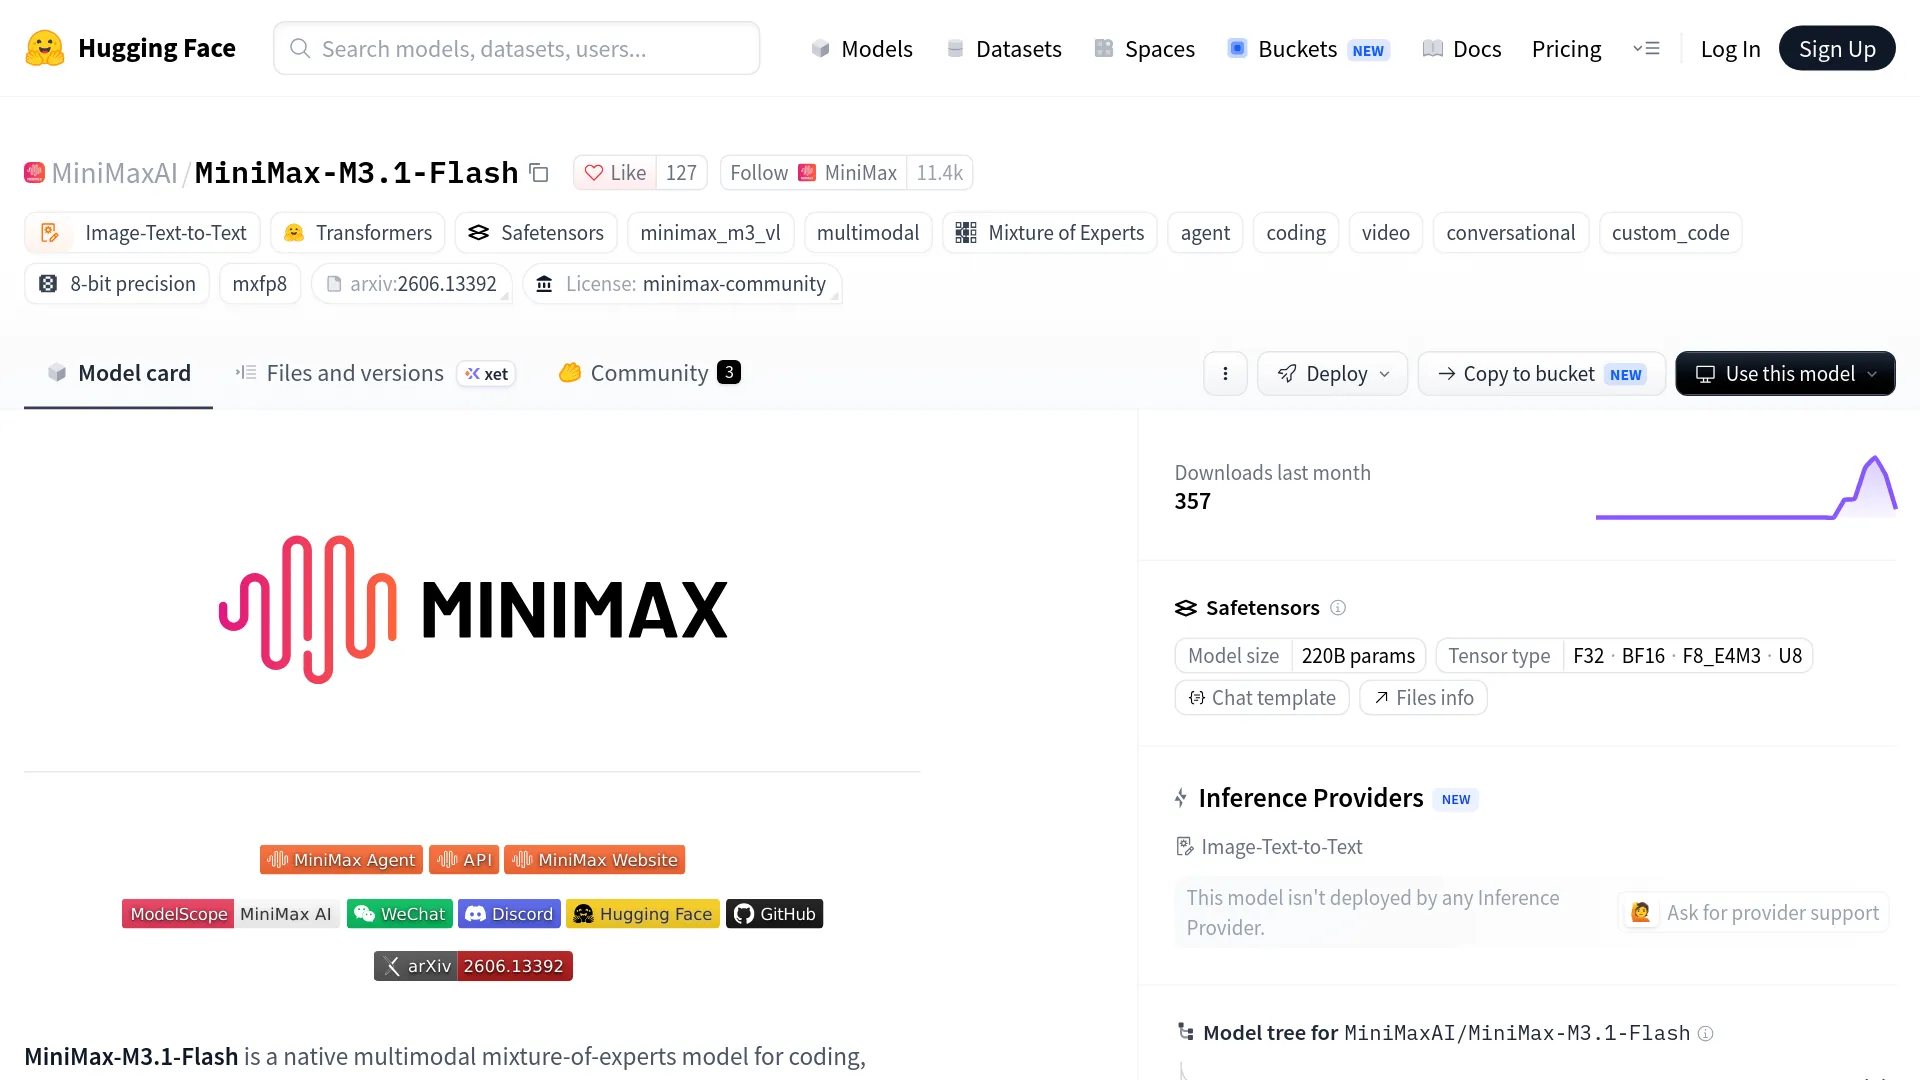
Bevor Hardware budgetiert wird, sollten auf der Repository-Seite drei Punkte geprüft werden. Erstens: Sind tatsächlich alle 48 Shards plus der Draft-Head vorhanden oder handelt es sich um einen unvollständigen Mirror? Zweitens: Steht im Lizenzfeld minimax-community und nicht MIT oder Apache? Veraltete Pre-Release-Hinweise auf Aggregator-Seiten sollte man ignorieren. Drittens gilt die Warnung der Model Card: Die veröffentlichten Scores beziehen sich auf die offiziellen Weights; Quantisierungen von Dritten können sich anders verhalten. EXL3-Versionen oder Repackages, die diese Woche kursieren, bleiben daher ungeprüft, solange sie ihren Basis-Commit nicht nennen.
Self-Hosting: Erst den Hardwarebedarf durchrechnen
Ein 428B-Modell wird nicht klein, nur weil pro Token lediglich 23B Parameter aktiviert werden. Genau hier liegen viele Diskussionen darüber, ob das Modell lokal läuft, daneben. Die aktiven Parameter bestimmen die Inferenzkosten pro Token; gespeichert und im Speicher gehalten werden müssen dagegen die Gesamtparameter. Bei BF16 ergeben 428 Milliarden Parameter mal 2 Byte rund 856 GB allein für die Weights. Eine generische 4-Bit-Darstellung läge bei ungefähr 214 GB. Die tatsächlichen 252 GB im Repository spiegeln das trainierte quantisierte Layout samt Tokenizer, Konfiguration und Draft-Head wider – noch ohne Runtime-Buffer und KV-Cache.
„MiniMax-M3.1-Flash open weights are now LIVE 🔥🔥 428B params, 23B active.“ — @MiaAI_lab, mit Verweis auf den Download von ~252 GB sowie ein TensorFold-Rezept und Arbeiten an einer EXL3-Quantisierung
Auch für Teams liegt die Hardware-Hürde hoch. @perry_weijie merkt an, dass persönliche Rechner es praktisch nicht ausführen können und Eigenaufbauten eher für Teams mit freien Karten taugen. Ein gemessener Day-0-Start, den ich gefunden habe, war TP4 auf 4x DGX Spark von @majewskizby: Gemeldet wurden etwa 39.7 tok/s beim Prosa-Decoding und 62.2 tok/s bei strukturiertem Decoding bei 262K Kontext, mit NVFP4/MXFP8-Pfaden und Triton Sparse Attention. Das ist ein Day-0-Messpunkt und keine Herstellerfolie – setzt aber immer noch vier gemeinsam arbeitende High-End-Nodes voraus.
Die realistischen Wege nach Aufwand sortiert:
- SGLang mit dem verlinkten Cookbook, einschließlich des Docker-Musters aus der Model Card (
--shm-size 32g, Port 30000, HF-Cache-Mount). - vLLM mit dem verlinkten Rezept; das Beispiel in der Card nutzt
vllm serveauf Port 8000. - TokenSpeed mit dem verlinkten Rezept für den auf Effizienz ausgerichteten Pfad.
- FlagOS für Multi-Chip-Deployments.
Zwei Stolperfallen treffen Nutzer bereits jetzt. Der Reasoning-Aufwand steht standardmäßig auf Maximum, was Kosten und Latenz erhöht, wenn die Einstellung low bis max unangetastet bleibt. Die unabhängigen Setup-Hinweise auf minimax-m31flash.org nennen außerdem die klassischen Fehler bei Agent-Integrationen: ein falsches Modellsuffix für langen Kontext, Umgebungsvariablen, die Konfigurationsdateien überschreiben, veraltete Mindestversionen von Codex und eingestellte Preview-Modellnamen. Integrationen für Transformers, KTransformers, unsloth und ATOM waren in der Card noch als in Arbeit gelistet; den Status sollte man prüfen, bevor man darauf plant. alfw.ai nennt angekündigte Kompatibilität mit 10 Chipherstellern und sechs Clouds. Das sind jedoch zunächst Kompatibilitätsankündigungen, bis das Modell im Provider-Katalog auftaucht, für den tatsächlich bezahlt wird.
API oder Self-Hosting? Die Entscheidung über Kosten pro Aufgabe
Reine Tokenpreise führen in die Irre, weil bei Agent-Workloads Reasoning-Tokens und Cache-Verhalten dominieren. Die einheitliche MiniMax-API kostet $0.15 pro Million Input-Tokens, $0.60 pro Million Output-Tokens und $0.015 für gecachte Inputs. Anders als bei MiniMax M3 gibt es laut minimax-m31flash.org keinen Preisaufschlag für langen Kontext; bei M3 verdoppelt sich der Preis ab 512K Input-Tokens. Artificial Analysis ermittelte im selben Suite-Vergleich etwa $0.22 pro Aufgabe für M3.1 Flash gegenüber $0.26 für DeepSeek V4.1 Flash 1017. Dabei standen 189M Output-Tokens 224M gegenüber – ein Kostenvorteil von rund 15% pro Aufgabe, der aus effizienterem Reasoning und nicht aus bloßen Preissenkungen resultiert.
| Weg | Geeignet für | Darauf achten |
|---|---|---|
MiniMax API (api.minimax.io, laut minimax-m31flash.org Anthropic-/OpenAI-kompatibel) | Coding-Agents, variable Last, 1M-Kontext-Arbeit ohne eigene Hardware | Standardmäßig maximaler Reasoning-Aufwand; Cache- und Service-Tier-Konfiguration bestimmen die tatsächliche Rechnung |
| M Plan-Abonnement (Go- / Explore- / Build-Tarife laut minimax-m31flash.org) | Planbare Nutzung als Coding-Assistent in MiniMax Code | Fensterbasierte Limits statt eines einfachen monatlichen Token-Kontingents; vor dem Budgetieren Dollarpreise prüfen |
| Self-Hosting (SGLang / vLLM / TokenSpeed, FlagOS Multi-Chip) | Hohe dauerhafte Auslastung, Anforderungen an Datenkontrolle, Basis für Fine-Tuning | 252-GB-Download, Multi-GPU-Speicher plus KV-Cache bei langem Kontext, keine verifizierte Mindestspezifikation |
Vor jedem Download lohnt sich die Rechnung für den eigenen Workload: Den monatlichen Input-/Output-Mix mit $0.15/$0.60 multiplizieren und die tatsächliche Cache-Hit-Rate einbeziehen. Das Ergebnis wird mit reservierten GPU-Kosten plus Engineering-Aufwand verglichen. Unterhalb eines dauerhaft hohen Volumens gewinnt bei dieser Rechnung meist die API. Self-Hosting kann sich rechnen, wenn die monatliche API-Rechnung die amortisierten Cluster-Kosten übersteigt oder die Weights die eigene Sicherheitsgrenze nicht verlassen dürfen.
Benchmarks: klar getrennt nach Messquelle
| Benchmark | M3.1 Flash | Bester Rivale in der zitierten Tabelle | Quelle |
|---|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | 60.5 DeepSeek V4.1 Flash-1017 | MiniMax Card (Anbieter) |
| BankerToolBench | 76.2 | 76.2 Opus 5 (Gleichstand) | MiniMax Card (Anbieter) |
| LOCA-Bench 256K | 60.3 | 60.0 GPT-5.6 Sol | MiniMax Card (Anbieter) |
| OSWorld 2.0 | 61.7 | 70.6 Opus 5 | MiniMax Card (Anbieter) |
| CyberGym | 82.2 | 84.5 GLM-5.3 | MiniMax Card (Anbieter) |
| DeepSWE v1.1 | 73.7 | 77.0 DeepSeek V4.1 Flash-1017 | MiniMax Card (Anbieter) |
| Vals Index | 53.78% (16 von 26) | MiMo V2.6 Flash 54.83% (zum Launch) | Vals AI (unabhängig) |
| Intelligence Index | 42 | 45 DeepSeek V4.1 Flash 1017 | Artificial Analysis via TPS Report (unabhängig) |
| LMArena WebDev | 1587.48 | geranktes Feld | VectorWire (einziger von 10 unabhängig verifizierter Wert) |
Die MiniMax Card dokumentiert die Harnesses je Benchmark – etwa BankerToolBench auf OpenCode 1.17.18 mit MiniMax-M2.7 als Judge oder CyberGym auf Claude Code 2.1.263 bei 1M Kontext. Das ist transparenter als die meisten Launch-Posts, die Scores bleiben aber Anbieterangaben. Die unabhängigen Einschätzungen fallen zurückhaltender aus: Vals AI sieht gegenüber M3 einen Sprung von 26.37 Punkten im Vibe Code Bench, weist aber auf Schwächen bei langfristigen Aufgaben hin: Terminal-Bench 25.25% und HLAB-Vals 7.50% im eigenen Harness. Artificial Analysis kombiniert eine starke Omniscience-Accuracy von 56% mit einer Halluzinationsrate von 93% in diesem Benchmark. VectorWire bewertet die Evidenz als zu dünn, um irgendeine Fähigkeit einzuordnen. Diese Halluzinationsrate ist ein klares Signal, für Retrieval, Compliance und kundenorientierte Antworten zusätzliche Verifikation einzuplanen.
Kommerzielle Nutzung: Was die Lizenz verlangt
Die Weights lassen sich herunterladen, doch die MiniMax Community License ist keine uneingeschränkte Open-Source-Lizenz. Die Lizenzgewährung ist primär auf nichtkommerzielle Nutzung zugeschnitten; kommerzielle Nutzung ist nur unter Bedingungen erlaubt. Produkte oder Dienste müssen gut sichtbar „Built with MiniMax M3.1-Flash“ ausweisen, der Nutzer muss MiniMax einmalig benachrichtigen, und bei mehr als $20M Jahresumsatz ist eine vorherige schriftliche Genehmigung von MiniMax erforderlich. Kommerzielle Nutzung ist breit genug definiert, um kostenpflichtigen gehosteten Zugriff, Modell-APIs, Fine-Tunes und modifizierte Derivate einzuschließen. Militärische Anwendungen sowie die absichtliche Erzeugung schädlicher, falscher oder irreführender Informationen sind untersagt. Die Lizenzanalyse von alfw.ai fand für dieses Modell keine territoriale Einschränkung. Diese Einschätzung stammt allerdings von einer Drittanalyse und nicht aus einer MiniMax-FAQ; vor einem Release sollte daher juristischer Rat eingeholt werden. Die Einordnung lautet: Open Weights, nicht Open Source.
FAQ
Sind die Weights von MiniMax M3.1 Flash tatsächlich herunterladbar?
Ja. MiniMaxAI/MiniMax-M3.1-Flash erschien am 23. Oktober 2026 auf Hugging Face, umfasst rund 252 GB an Dateien und benötigt keine Freigabe. Zusätzlich gibt es einen ModelScope-Mirror.
Wie lautet das offizielle Hugging-Face-Repository?
MiniMaxAI/MiniMax-M3.1-Flash: 48 safetensors-Shards, DSpark-Draft-Head, Tokenizer und Konfiguration, gekennzeichnet mit der Lizenz minimax-community. Der Download-Befehl lautet hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-Flash.
Darf ich M3.1 Flash kommerziell nutzen?
Unter Bedingungen. „Built with MiniMax M3.1-Flash“ muss angezeigt werden, es ist eine einmalige Mitteilung erforderlich, und oberhalb von $20M Jahresumsatz braucht es eine vorherige schriftliche Genehmigung. Fine-Tunes und gehostete APIs gelten als kommerzielle Nutzung.
Läuft das Modell auf einer Consumer-GPU oder Apple Silicon?
Nein. Hier wird keine validierte Bereitstellung auf einer einzelnen Consumer-GPU oder auf Apple Silicon genannt: Der vollständige Checkpoint ist ~252 GB groß, und die BF16-Rechnung ergibt rund 856 GB allein für die Weights. Das schließt übliche GPU-Speicherkonfigurationen aus. Zu erwarten sind Multi-GPU-Server oder ein Cloud-Provider; der hier zitierte Day-0-Lauf nutzte 4x DGX Spark.
Funktioniert es mit vLLM, SGLang oder TokenSpeed?
Ja, über die offiziellen Rezepte aus der Model Card. SGLang und vLLM sind die empfohlenen Wege, TokenSpeed ist das dritte Rezept. FlagOS deckt Multi-Chip-Deployments ab. Integrationen aus der Transformers-Familie waren beim Release noch in Arbeit.
Wie schlägt es sich gegen DeepSeek V4.1 Flash?
Die Kosten pro Aufgabe sind niedriger (~$0.22 gegenüber ~$0.26 in der AA-Suite), und in dieser Momentaufnahme liegen HLE sowie Omniscience-Accuracy höher. Beim aggregierten Intelligence Index liegt es jedoch zurück (42 gegenüber 45), ebenso bei DeepSWE (73.7 gegenüber 77.0 für den 1017-Build). Für kosteneffiziente Agent-Coding-Workloads lohnt sich ein Test mit einem Aufgabenbatch; wenn Intelligence Index und DeepSWE entscheidend sind, sollte DeepSeek auf den eigenen Aufgaben geprüft werden. Nächster Schritt: Einen bezahlten API-Aufgabenbatch ausführen, dabei den standardmäßigen maximalen Reasoning-Aufwand auf die gewünschte Einstellung setzen und danach entscheiden, ob sich der Download lohnt.