 AIREITER
Ein Coding Agent, der Dateien analysiert, Tests ausführt und seine Änderungen iterativ nachbessert, verbraucht pro gelöstem Issue schnell 50.000 bis 200.000 Token. Allein bei GPT-5.6 Sol kosten die Output-Token mit $30/M damit $1.50 bis $6 pro Aufgabe. DeepSeek V4 Pro verlangt dagegen $0.87/M Output-Token – rund 1/34 der Kosten. Allerdings wurde seine Zuverlässigkeit in mehrstufigen Agent-Workflows noch nicht so umfassend unabhängig evaluiert wie bei Claude oder GPT. Der folgende Vergleich ordnet sechs Modelle nach veröffentlichten Coding-Benchmarks, verifizierten API-Preisen, Kontextfenstern und ihrem passenden Agent-Einsatzgebiet ein.
Sechs LLMs für Coding Agents im Vergleich
Jedes Modell wird mit Benchmark-Werten aus offiziellen Quellen oder Leaderboards sowie im August 2026 verifizierten API-Preisen eingeordnet. Gibt es für das konkret bewertete Modell keinen veröffentlichten Wert, dient die nächstliegende Variante als klar gekennzeichnete Näherung.
1. Claude Opus 5 – maximale Qualität für anspruchsvolle Aufgaben
Claude Opus 5 setzt die Führungsrolle der Claude-Familie im offiziellen SWE-bench Verified-Leaderboard fort. Der Vorgänger Claude 4.5 Opus erreichte mit dem Harness mini-SWE-agent 76.8% – ein sinnvoller Anhaltspunkt für die erwartete Leistungsklasse von Opus 5. Eigene SWE-bench-Verified-Ergebnisse für Opus 5 sind allerdings noch nicht veröffentlicht. Opus 5 bietet ein Kontextfenster von 1 Million Token und maximal 128K Output-Token. Mit $5/M Input und $25/M Output ist es hier die teuerste etablierte Option. Wenn ein gescheitertes Refactoring über mehrere Dateien mehr Entwicklerzeit kostet als die Token, ist Opus 5 die richtige Wahl. Für große Mengen routinemäßiger Änderungen dagegen nicht.
2. GPT-5.6 Sol – stark bei terminalgetriebenen Aufgaben
GPT-5.6 Sol mit der Modell-ID gpt-5.6-sol kostet $5/M Input und $30/M Output und verfügt über ein Kontextfenster von 1.05 Millionen Token. Im von xAI veröffentlichten Benchmark-Vergleich führt GPT-5.6 Sol Max bei Terminal-Bench v3.0 mit 34.6% vor Grok 4.6 mit 26% sowie bei DeepSWE v1.1 mit 73%. Genau diese Benchmarks sind für terminalbasierte Agent-Schleifen besonders relevant. Der Nachteil: Mit $30/M Output ist Sol das teuerste Modell in diesem Vergleich. OpenAI nennt außerdem SWE-bench-Pro-Ergebnisse von 64.6% für Sol und 63.4% für Terra, die Mid-Tier-Variante. Das ist nützlich, wenn für weniger anspruchsvolle Aufgaben eine günstigere OpenAI-Option gesucht wird.
3. Grok 4.6 – das Preis-Leistungs-Modell für langlaufende Agents
Grok 4.6, veröffentlicht am 12. August 2026, wurde für langlaufende Agent-Workflows entwickelt. Laut xAIs Ankündigung zieht es im Artificial Analysis Intelligence Index mit GPT-5.6 Sol Max bei 61 gleich und liegt bei CursorBench v3.2 mit 69.9% gegenüber 67.2%, bei FrontierCode v1.1 mit 61.3% gegenüber 60.6% und bei APEX-Agents mit 57.5% gegenüber 56.7% vorn. Für $2/M Input und $6/M Output liefert es damit eine mit GPT-5.6 Sol Max vergleichbare Benchmark-Leistung zu ungefähr einem Fünftel der Output-Kosten. Die Schwäche liegt in der reinen Terminal-Ausführung: Bei Terminal-Bench v3.0 erreicht es 26% und liegt damit deutlich hinter Sol Max mit 34.6%. Ist der Agent-Workflow vor allem IDE-zentriert, etwa mit Cursor oder Grok Build, statt terminal-first, bietet Grok 4.6 in dieser Liste das beste Verhältnis aus Qualität und Preis. Eine „fast“-Variante verdoppelt die Preise für niedrigere Latenz auf $4/$12. Das Kontextfenster umfasst 500K Token.
4. DeepSeek V4 Pro – das günstige Arbeitstier
DeepSeek V4 Pro ist das günstigste per API verfügbare Modell der Frontier-Klasse: $0.435/M Input und $0.87/M Output, bei gecachtem Input sinkt der Preis auf $0.003625/M. Mit einem Kontextfenster von 1 Million Token und maximal 384K Output-Token eignet es sich auch für Aufgaben auf Repository-Ebene. Es gibt keinen veröffentlichten Multi-Step-Agent-Benchmark, der DeepSeek V4 Pro mit Claude oder GPT bei gleicher Harness-Tiefe vergleicht. Die Zuverlässigkeit bei Tool-Calls in längeren Sessions sollte daher vor dem Einsatz für komplexe Refactorings im eigenen Setup geprüft werden. Für Teams mit engem Budget oder als First-Pass-Modell in einem gerouteten Setup ist die Wirtschaftlichkeit überzeugend. Bei den schwierigsten Refactorings über mehrere Dateien, bei denen Zuverlässigkeit wichtiger ist als Token-Kosten, wird man voraussichtlich eskalieren müssen.
5. Gemini 3.1 Pro – für riesige Kontextfenster
Googles Gemini 3.1 Pro Preview kostet bei Prompts unter 200K Token $2/M Input und $12/M Output; oberhalb dieser Grenze steigen die Preise auf $4/$18. Seine besondere Stärke ist die Kontextkapazität: Mit 2 Millionen Token besitzt Gemini das größte Kontextfenster der hier aufgeführten Modelle. Das eignet sich für vollständige Repository-Analysen, bei denen eine gesamte Codebasis in einem Durchlauf geladen wird. Als Näherung für die erwartete Leistungsklasse von 3.1 Pro erreichte Gemini 3 Flash in einem Snapshot von Tembo aus Juni 2026 75.8% bei SWE-bench Verified – nur Claude 4.5 Opus lag davor. Die Konsistenz von Geminis Tool-Calling in längeren Agent-Schleifen wurde nicht mit derselben Tiefe wie bei Claude oder GPT evaluiert; vor dem Einsatz für mehrstufige Workflows sollte es daher im eigenen Harness getestet werden.
6. Kimi K3 – die Open-Weight-Option für Agents
Kimi K3 von Moonshot AI erreichte im selben Snapshot aus Juni 2026 70.8% bei SWE-bench Verified. Damit liegt es unter GLM-5 mit 72.8% und MiniMax M2.5 mit 75.8% unter den Open-Weight-Modellen. Als Open-Weight-Modell lässt es sich selbst hosten – relevant für Teams, deren Code das eigene Netzwerk nicht verlassen darf. Moonshots gehostete API bietet K3 ebenfalls an; die konkreten Preise hängen von der Deployment-Konfiguration ab. Für lokale Agent-Setups mit ausreichender GPU-Hardware ergibt K3 zusammen mit einem schlanken Harness wie OpenCode einen leistungsfähigen Coding Agent ohne API-Kosten pro Token.
API-Preise und Kosten pro gelöstem Issue
Token-Preise erzählen nur die halbe Geschichte. Entscheidend ist der Preis pro abgeschlossener Aufgabe: Wie viel kostet es, wenn ein Agent über seinen Workflow ein reales GitHub-Issue löst?
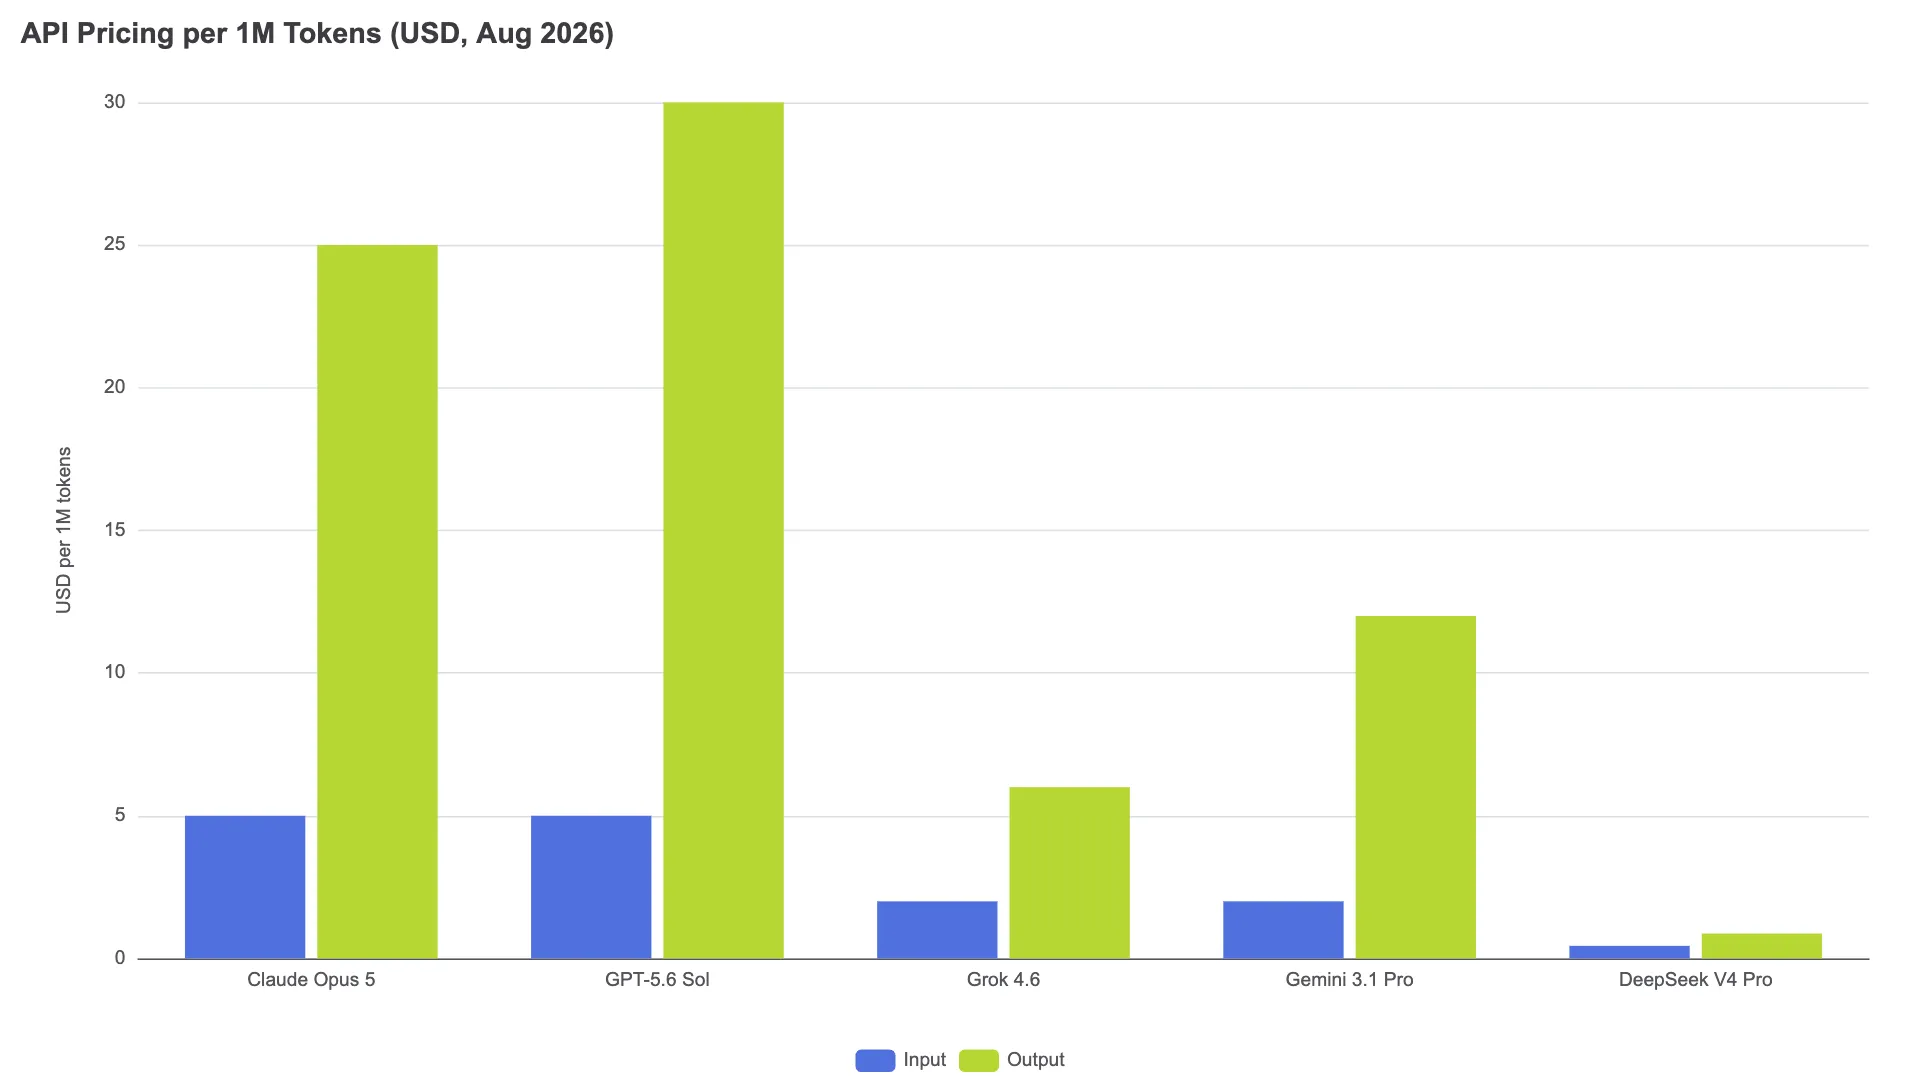
Eine typische Agent-Schleife aus Dateien lesen, planen, bearbeiten, Tests ausführen und Fehler beheben benötigt pro gelöstem Issue etwa 50K–200K Token. Output-Token machen dabei 30–50% aller Token aus. Diese Werte sind Branchenschätzungen aus Analysen von Agent-Schleifen durch Tembo und anderen Quellen; der tatsächliche Verbrauch hängt von der Größe des Repositories, der Länge der Test-Suite und der Effizienz des Harness ab. Mit dem Mittelwert von 125K Token insgesamt, also 75K Input und 50K Output, ergeben sich pro gelöstem Issue folgende Kosten:
| Modell | Input-Kosten | Output-Kosten | Gesamt pro Aufgabe |
|---|---|---|---|
| Claude Opus 5 | $0.375 | $1.25 | $1.63 |
| GPT-5.6 Sol | $0.375 | $1.50 | $1.88 |
| Grok 4.6 | $0.15 | $0.30 | $0.45 |
| Gemini 3.1 Pro | $0.15 | $0.60 | $0.75 |
| DeepSeek V4 Pro | $0.033 | $0.044 | $0.077 |
Kimi K3 fehlt in dieser Tabelle, weil die Kosten vollständig davon abhängen, ob Moonshots gehostete API genutzt wird oder das Modell auf eigenen GPUs läuft; es gibt keinen einzelnen Listenpreis für einen direkten Vergleich. Grok 4.6 trifft mit $0.45 einen attraktiven Sweet Spot: Im Artificial Analysis Intelligence Index erreicht es denselben Wert wie GPT-5.6 Sol Max, kostet pro Aufgabe aber nur ungefähr ein Viertel von Sol.
Diese Schätzungen berücksichtigen weder Wiederholungsversuche, Rabatte für gecachte Token, Tool-Call-Overhead noch Infrastruktur. Ein Modell, das pro Aufgabe mehr Retries oder menschliche Korrekturen benötigt, kann in der Praxis trotz niedrigem Token-Preis teurer sein. Deshalb kann Routing besser funktionieren als die Festlegung auf ein einzelnes Modell: Routinearbeit geht an DeepSeek oder Grok, schwierige Refactorings werden an Opus eskaliert.
Welches Modell zu welchem Coding-Agent-Workflow passt
Ein universell bestes Modell gibt es nicht. Entscheidend ist, welchen Agent-Job das Modell übernehmen soll.
Schnelle Schleifen und Routineänderungen. Für häufige Aufgaben mit geringem Risiko eignen sich Gemini 3.5 Flash ($1.50/$9 pro M Token) oder Claude Sonnet 5: Fehler erklären, kleine Funktionen ergänzen, Test-Stubs erstellen oder Dokumentation aktualisieren.
Tiefgreifende Refactorings und Architektur. Claude Opus 5 ist die Wahl bei Änderungen über mehrere Dateien, modulübergreifenden Abhängigkeiten oder Architekturentscheidungen, bei denen eine falsche Annahme Stunden an Debugging kostet. Ausschlaggebend sind vor allem die präzise Umsetzung von Anweisungen und die stabile Kohärenz über lange Sessions hinweg.
Langlaufende autonome Agents. Grok 4.6 wurde genau für diesen Anwendungsfall entwickelt. Laut xAIs Ankündigung lag der Entwicklungsschwerpunkt auf ausdauernden Agent-Trajektorien mit Selbstprüfungsverhalten. Mit $0.45 pro Aufgabe kann es länger arbeiten, ohne den Kostendruck zu erzeugen, den GPT-5.6 Sol mit $1.88 pro Aufgabe mitbringt. Bei terminallastigen Workflows ist GPT-5.6 Sol wegen seines Vorsprungs bei Terminal-Bench von 34.6% die sicherere Wahl.
Günstig und selbst gehostet. Für kostenbewusste Teams ist DeepSeek V4 Pro über die API mit $0.077 pro Aufgabe die Standardwahl. Organisationen, die ihren Code nicht an externe APIs senden dürfen, können ein Open-Weight-Modell wie Kimi K3 mit 70.8% SWE-bench Verified oder MiniMax M2.5 mit 75.8% selbst hosten. Bei SWE-bench Verified ist der Abstand zwischen Open-Weight-Modellen und den führenden Closed-Weight-Modellen auf wenige Prozentpunkte geschrumpft.
Der Harness kann das Modell ausbremsen
Der Harness eines Agents – etwa Claude Code, Codex CLI, Cursor oder ein Open-Source-Tool wie OpenCode – steuert vier Dinge, die das Modell selbst nicht kontrollieren kann: Kontextmanagement, also wann komprimiert und was behalten wird; Tool-Definitionen und Routing; Muster zur Fehlerbehebung; sowie Review- und Freigabeflüsse. Wie die Analyse von Tembo festhält, muss ein Benchmark-Wert unter einem kontrollierten Harness wie mini-SWE-agent nicht der tatsächlichen Lösungsrate in einem anders konfigurierten Setup entsprechen. Für Modellvergleiche sind Benchmarks mit identischem Harness daher aussagekräftiger als von Anbietern veröffentlichte Werte, die Verbesserungen des Modells und des Harness vermischen.
Bevor Modelle getauscht werden, sollte zuerst der Harness geprüft werden. Komprimiert der Agent seinen Kontext effektiv? Sind die Tool-Definitionen sauber? Und reagieren Fehler-Retries sinnvoll, statt in Schleifen zu geraten?
FAQ
Welches LLM ist für Coding Agents am günstigsten?
DeepSeek V4 Pro ist mit $0.435/M Input und $0.87/M Output die günstigste Frontier-Option und kostet pro gelöster Agent-Aufgabe ungefähr $0.08.
Wie teste ich Coding-Agent-Modelle auf meinem eigenen Repository?
Wähle 20–30 repräsentative Issues aus dem tatsächlichen Backlog aus – eine Mischung aus Bugfixes, Features und Refactorings. Lasse jedes Modell mit dem gewählten Harness dieselben Aufgaben bearbeiten. Erfasse drei Kennzahlen: Lösungsrate, also ob der Patch des Agents die Tests besteht; Token-Verbrauch pro Aufgabe; und Zeit bis zum Abschluss. Diese auf das eigene Repository zugeschnittene Evaluation ist aussagekräftiger als jeder öffentliche Benchmark.