 AIREITER
Für einen schnellen Einstieg ist die gehostete API mit 0,04 $ pro Million Input-Token kaum zu schlagen. Die neuen Open-Weight-Checkpoints machen jedoch auch lokale Inferenz realistisch – wobei zwischen dem 3B- und dem 600M-Modell ein deutlicher Qualitätsunterschied liegt.
Drei d1-Varianten, drei unterschiedliche Einsatzzwecke
Liquid AI bietet aktuell drei relevante Optionen: den proprietär gehosteten Dienst d1, das Open-Weight-Modell d1-3B und das experimentelle Open-Weight-Modell d1-omni-600M. Liquid AI hat nicht erklärt, dass das gehostete Modell mit einem der herunterladbaren Checkpoints identisch ist. Benchmarks und Latenzwerte sollten deshalb stets dem Modell zugeordnet bleiben, auf dem sie gemessen wurden.
| Option | Zugang und Preis | Eingaben | Veröffentlichter Kontext | Geeignet für |
|---|---|---|---|---|
Gehostetes d1 | Liquid API; 0,04 $ pro 1 Mio. Input-Token, keine Gebühren für Output-Token | Text und Bilder direkt über Liquid | 66K laut Vercel | Schnelle Integration, vernachlässigbare Inferenzkosten, kein Modellbetrieb |
d1-3B | Herunterladbare Weights; keine tokenbasierte Modellgebühr | Text, JSON und Bilder | 32.768 Token | Beste lokale Qualität, Vision, Evaluierung für den Produktiveinsatz |
d1-omni-600M | Herunterladbare experimentelle Weights; keine tokenbasierte Modellgebühr | Text plus Bild oder Text plus Audio | 16.384 Token | Kleiner Footprint, Experimente mit Sprachbefehlen, eingeschränkte Edge-Geräte |
Alle drei Modelle beantworten typisierte Fragen, statt Fließtext zu generieren. noul liefert eine Ja-Wahrscheinlichkeit, choice Wahrscheinlichkeiten für benannte Optionen und score eine wahrscheinlichkeitsgewichtete Position auf einer geordneten Skala. Damit eignen sie sich für Routing, Moderation, Prüfung, Guardrails und Scoring – nicht als Ersatz für ein Chat- oder Coding-Modell.
Die Empfehlung ist klar: Für einen Pilotversuch ist das gehostete d1 die beste Wahl. Wenn Daten lokal bleiben müssen oder die Latenz keinen Netzwerksprung enthalten soll, ist d1-3B die passende Option. d1-omni-600M bleibt ein Experiment, sofern nicht Audio oder der geringe Footprint die entscheidende Vorgabe sind.
API-Preis gegen lokale Kosten gerechnet
Die Liquid AI d1 API kostet 0,04 $ pro Million Input-Token. Output-Token werden nicht berechnet, weil der Dienst Entscheidungen und keinen generierten Text zurückgibt. 100 Millionen Input-Token kosten vor möglichen Gateway-Gebühren 4 $, eine Milliarde Input-Token 40 $.
Bei 0,04 $ pro Million Token lohnt sich Self-Hosting allein wegen der Inferenzkosten selten. Lokales Deployment ist vor allem für Datenschutz, Offline-Nutzung, Latenz direkt auf dem Gerät, Anpassungen oder dauerhaft hohe Auslastung sinnvoll.
Für die beiden offenen Checkpoints gibt es keinen offiziellen gehosteten Tokenpreis. Ihre Hugging-Face-Seiten zeigten zum Testzeitpunkt keinen Inference Provider. Der Preis des gehosteten d1 darf daher nicht als Preis für d1-3B oder d1-omni-600M ausgegeben werden.
Auch Bilder werden beim gehosteten Dienst als Input abgerechnet. Liquid AI nennt 1,5 Token pro 32×32-Pixel-Patch; ein Bild mit 1024×1024 Pixeln entspricht damit vor dem Fragetext 1.536 Token. Bei 0,04 $/M kostet allein der Bildanteil rund 0,00006144 $; jede Frage gilt als eigener Prompt und enthält das jeweils zugehörige Bild.
Open Weight heißt weder uneingeschränkt noch kostenlos
Beide Repositories nutzen die Lizenz lfm1.0 von Liquid AI, nicht Apache 2.0 oder MIT. Laut den allgemeinen Preisbedingungen von Liquid AI sind die herunterladbaren Modelle für kommerzielle Nutzung kostenlos, solange der Jahresumsatz des Unternehmens unter 10 Millionen $ liegt. Größere Unternehmen sollten die aktuellen kommerziellen Bedingungen prüfen, statt aus dem Begriff „Open Weight“ eine Nutzungserlaubnis abzuleiten.
Bei der lokalen Budgetplanung gehören Anschaffung von GPU oder Gerät, ungenutzte Kapazität, Monitoring, Updates und Personalzeit dazu. Die Hosted-Rechnung ist variabel und sehr klein, lokale Kosten sind überwiegend fix.
d1-3B liefert Qualität, omni spart Platz
In der offiziellen Ankündigung zu Open d1 nennt Liquid AI im Decision Index v0.2.1 einen Wert von 48,57 für d1-3B und 15,95 für d1-omni-600M. Liquid AI hat beide Modelle mit dem offiziellen Scorer ausgeführt; die Resultate waren jedoch keine offiziellen Leaderboard-Einreichungen.
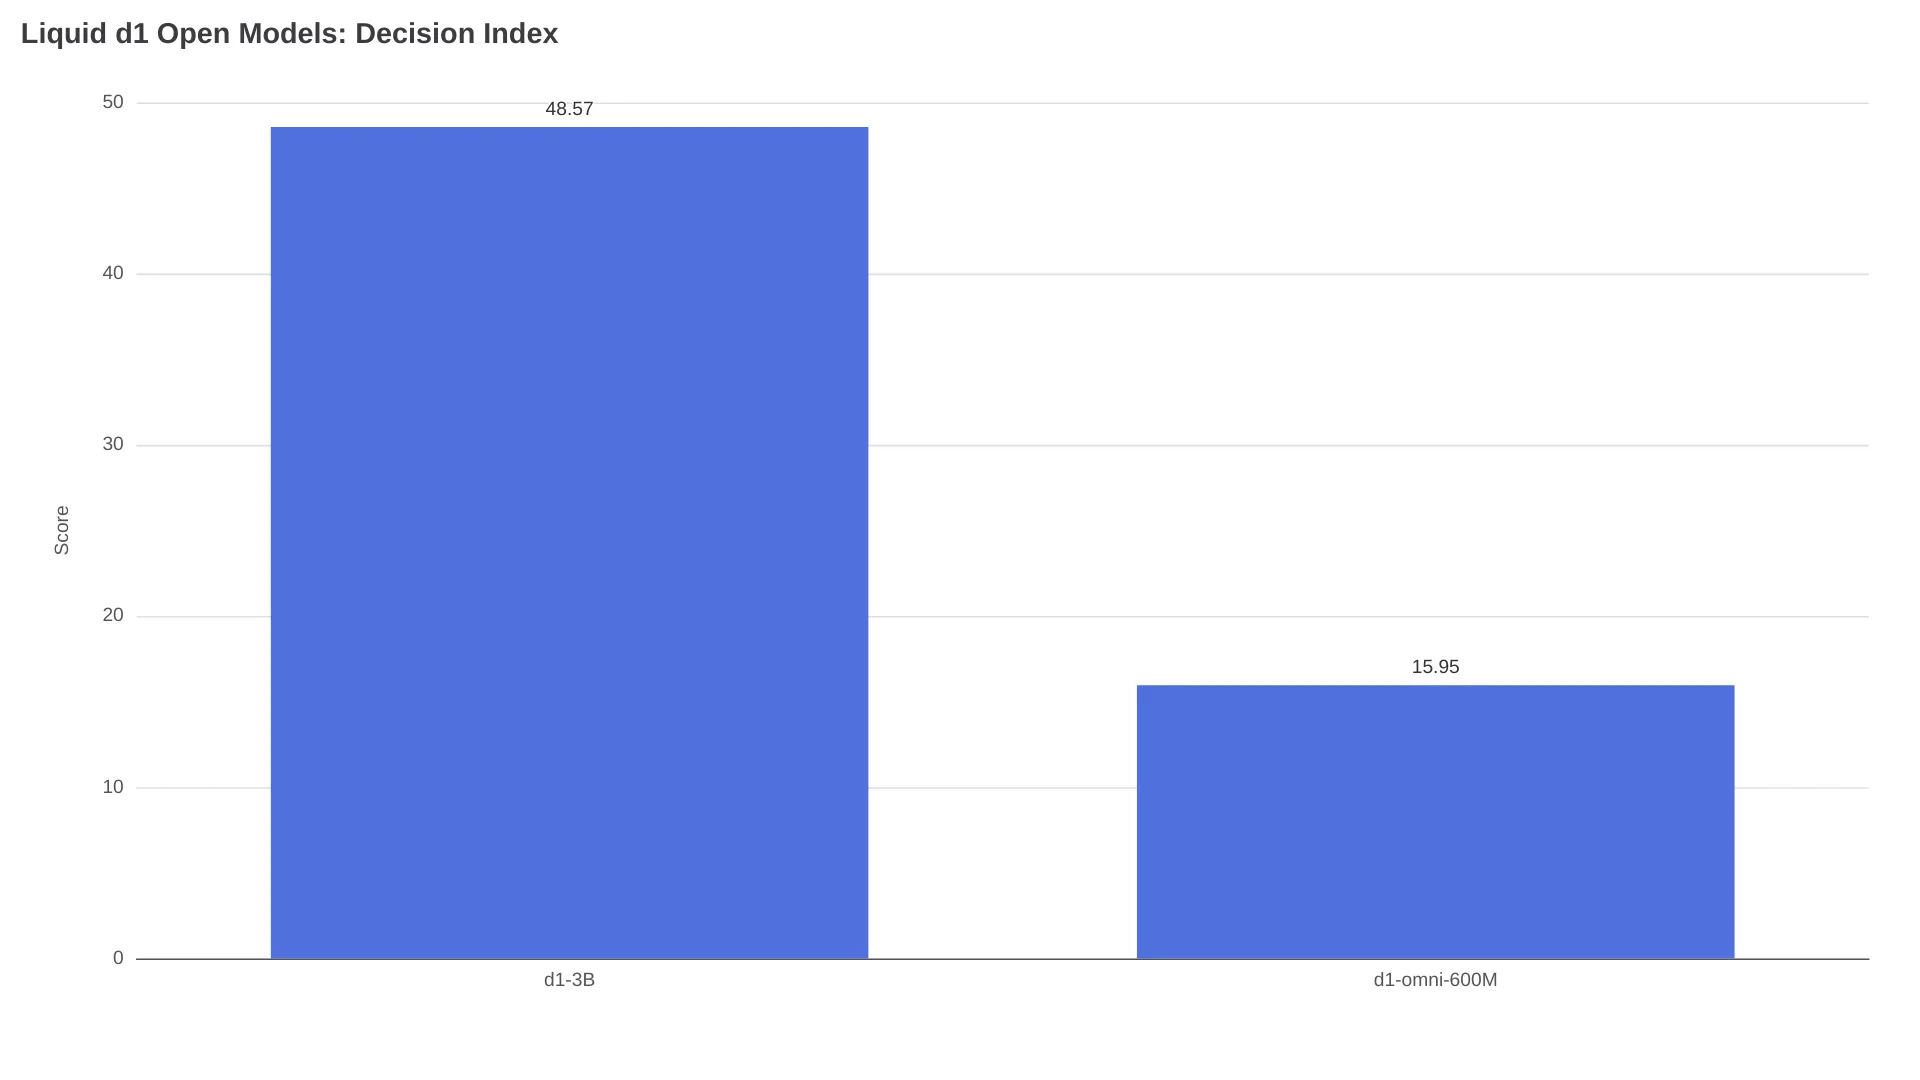
Das kleinere Modell ist nicht durchgehend schwach. Über sieben öffentliche Text-Benchmarks berichtet Liquid AI Mittelwerte von 82,9 für d1-3B und 78,4 für d1-omni-600M. Omni lag bei Civil Comments (95,8 gegenüber 93,0) und PAWS-X (79,5 gegenüber 76,9) vorn, während 3B die übrigen fünf aufgeführten Aufgaben gewann. Der wesentlich größere Abstand im Decision Index zeigt: Einige starke Klassifikationsbereiche machen den 600M-Checkpoint nicht zu einem allgemeinen Ersatz für 3B.
| Spezifikation | d1-3B | d1-omni-600M |
|---|---|---|
| Detaillierte Parameterzahl | 3,12B | 587M |
| Repository-/Weight-Footprint in voller Präzision | 6,27 GB Repository; 6,25 GB Weights | F32-Modell, etwa 0,6B Parameter |
| Kontext | 32.768 | 16.384, modalitätsübergreifend geteilt |
| Textbudget bei Bildern | Innerhalb des Modellkontexts | Status- und Fragetext mit Bildern auf 896 Token begrenzt |
| Audio | Nein | Ein Mono-Clip mit 16 kHz, bis zu 30 Sekunden |
| Bild + Audio gleichzeitig | Nicht anwendbar | Nicht unterstützt; löst ValueError aus |
| Offizielle Geschwindigkeitstabelle | Ja | Nein; früher Research-Release |
Die Model Card von d1-omni-600M erklärt, dass das Modell in Float32 trainiert wurde. Float16 bewahrte die Top-Antwort bei 243 Text-, 214 Bild- und 416 Audio-Zeilen, während bfloat16 die Top-Antwort bei 0,8 % der Textzeilen und 1,7 % der Audiozeilen veränderte. Der Datentyp ist damit eine Variable für die Validierung und nicht bloß ein Optimierungsschalter.
Lokales Deployment: schnell eingerichtet, aufwendig validiert
Beide Model Cards stellen system_one für einen einzelnen Status und system_one_batch für gebündelte Anfragen bereit. Der kürzeste Weg zu d1-3B führt über Transformers 5.14 oder neuer, PyTorch, TorchVision, Pillow und den vom Repository bereitgestellten Custom Code.
- Die dokumentierten Abhängigkeiten installieren:
pip install "transformers>=5.14" torch torchvision pillow- Das Modell mit aktiviertem Remote-Code aus dem Repository laden:
import torch
from transformers import AutoModel

model_id = "LiquidAI/d1-3B"
device = "cuda" if torch.cuda.is_available() else "cpu"
dtype = torch.bfloat16 if device == "cuda" else torch.float32

model = AutoModel.from_pretrained(
    model_id,
    trust_remote_code=True,
    torch_dtype=dtype,
).to(device)- Benannte Entscheidungen statt eines Chat-Prompts übergeben:
questions = {
    "queue": {
        "type": "choice",
        "instructions": "Which team should handle this ticket?",
        "criteria": {
            "billing": "Charges, invoices, and refunds",
            "technical": "Application or website faults",
            "fraud": "Suspected unauthorized use",
        },
    }
}

result = model.system_one(
    "I was charged twice this month; refund one charge.",
    questions,
)
print(result["answers"]["queue"])
trust_remote_code=True bedeutet, dass Python-Code aus dem Repository im Serving-Prozess ausgeführt wird. Für den Produktiveinsatz sollte ein geprüfter Commit fest gepinnt werden, statt einen sich verändernden Branch zu laden. Das d1-3B-Repository verweist außerdem auf Quantisierungen für mit llama.cpp, Ollama und LM Studio kompatible Runtimes. Ein quantisiertes Community-Artefakt ist gegenüber den offiziellen BF16-Weights eine eigenständige Entscheidung zu Supply Chain und Genauigkeit.
Die Model Card von d1-3B nennt für warme Aufrufe 8 ms für eine Frage auf einer RTX 4090, 30 ms auf einem Apple M5 Pro und 50 ms auf einem Jetson Orin Nano. Ein Status mit 3,4K Token benötigte auf denselben Geräten 102 ms, 640 ms beziehungsweise 1.640 ms. Die GPU-Werte sind Mediane aus 20 Durchläufen; das 8-ms-Ergebnis auf der 4090 nutzte kompilierte CUDA Graphs. Bei einer neuen Eingabeform fallen Kompilierungs- oder Kernel-Selection-Overhead an.
Für d1-omni-600M gibt es keine offizielle Geschwindigkeitstabelle. Ein Browser-Port berichtete von ungefähr 180 ms pro Kommentar für vier Entscheidungen:
„I didn't test it against other machines yet, just my MBP M4 Pro.“ — u/FinancialAd1961 auf Reddit
Dieses Einzelgeräte-Ergebnis belegt die Browser-Tauglichkeit, nicht jedoch die Performance über verschiedene Browser, GPUs, Quantisierungen oder Batch-Größen hinweg.
Die API ist einfacher – die Modellidentität bleibt entscheidend
Der direkte Hosted-Zugang verwendet das Modell d1 unter https://api.liquid.ai/decisions/v1/systemone. Vercel nutzt liquid/d1; dort sind ein Kontext von 66K und derselbe Input-Preis von 0,04 $/M angegeben. In seiner Ankündigung vom 5. Oktober schrieb Liquid, dass Vercel und OpenRouter zu diesem Zeitpunkt nur Text unterstützten, während die direkte Liquid API Bilder akzeptierte.
Die offenen Checkpoints nutzen lokale Python-Methoden mit denselben Entscheidungskonzepten. Ähnliche Schnittstellen belegen jedoch keine Verhaltensgleichheit. Ihre Wahrscheinlichkeiten können so weit abweichen, dass ein Fall eine Automatisierungsschwelle überschreitet oder unterschreitet. Für jeden ausgewerteten Pfad sollten deshalb die exakte Modell-ID, Revision, der Datentyp, die Wahrscheinlichkeit und die Schwelle festgehalten werden.
Eine Migration sollte daher vier Schritte umfassen:
- Ein gelabeltes Set aus der tatsächlichen Produktionsverteilung erstellen, einschließlich mehrdeutiger und kostspieliger Fehlerfälle.
- Dieselben Statuswerte, dasselbe Frageschema und dieselben Kriterien durch jeden Kandidaten laufen lassen.
- Schwellenwerte anhand der Kosten von False Positives und False Negatives auswählen, nicht anhand eines globalen Benchmark-Scores.
- Den Gewinner im Shadow-Betrieb testen, bevor destruktive, finanzielle, zugriffssteuernde oder sicherheitsrelevante Aktionen erlaubt werden.
Welches Liquid d1 ist die richtige Wahl?
Für die meisten Teams ist die gehostete API die Standardempfehlung. Ihr Tokenpreis ist zu niedrig, um für einen kleinen Pilotversuch ein lokales Serving-Projekt zu rechtfertigen. Außerdem entfallen Treiber-, Quantisierungs-, Warm-up- und Kapazitätsaufwand.
| Anforderung | Wahl | Grund |
|---|---|---|
| Schnellster Weg in die Produktion | Gehostetes d1 | Managed Endpoint und klar ausgewiesene Input-Preise |
| Daten dürfen Gerät oder Netzwerk nicht verlassen | d1-3B | Stärkster offener Checkpoint und lokale Ausführung |
| Beste veröffentlichte Entscheidungsqualität eines Open Models | d1-3B | 48,57 im Decision Index gegenüber 15,95 |
| Klassifikation von Sprachbefehlen | d1-omni-600M | Die einzige Option hier mit Audio, begrenzt auf 30 Sekunden |
| Kleinster experimenteller Footprint | d1-omni-600M | 587M Parameter, aber keine offizielle Latenztabelle |
| Offene Erklärungen oder generierte Aktionen | Keines davon | Nach der Entscheidungsstufe ein generatives Modell ergänzen |
Wählen Sie d1-3B statt omni, sofern nicht der 600M-Footprint oder der Audio-Pfad unverzichtbar ist. Eine fünfmal geringere Parameterzahl ist attraktiv, hebt aber weder den Abstand von 32,62 Punkten im Decision Index noch den experimentellen Status von omni auf.
FAQ zu Liquid AI d1
Ist Liquid AI d1 kostenlos?
Der gehostete Dienst d1 kostet 0,04 $ pro Million Input-Token; Output-Token werden nicht berechnet. Die offenen Checkpoints lassen sich ohne tokenbasierte Gebühr herunterladen, allerdings gelten weiterhin die kommerziellen Bedingungen von LFM 1.0 und die Kosten für lokale Rechenleistung.
Sind d1-3B und d1-omni-600M das Modell der gehosteten d1 API?
Liquid AI hat keinen der beiden Checkpoints als identisch mit dem gehosteten d1 dokumentiert. Sie sollten als verwandte Produkte mit separaten Modell-IDs, Kontextfenstern, Benchmarks und Deployment-Pfaden behandelt werden.
Kann ich Liquid d1 mit Ollama ausführen?
Die d1-3B-Modellseite verlinkt Quantisierungen für llama.cpp, Ollama, LM Studio und kompatible Anwendungen. Prüfen Sie Quantizer, Quellrevision, Unterstützung der Decision API und Genauigkeit, bevor Sie den offiziellen Transformers-Pfad ersetzen.
Unterstützt d1-3B Audio?
Nein. d1-3B akzeptiert Text, JSON und Bilder. d1-omni-600M akzeptiert Text plus Bilder oder Text plus einen Audio-Clip mit bis zu 30 Sekunden, kann jedoch Bilder und Audio nicht in derselben Anfrage verarbeiten.
Wie viel VRAM benötigt lokales d1?
Liquid veröffentlicht für d1-3B eine BF16-Weight-Datei mit 6,25 GB, nennt aber keinen universellen VRAM-Bedarf. Runtime-Overhead, Zustand des Bild-Encoders, Kontextlänge, Batch-Größe, Präzision und Quantisierung verändern den Gesamtbedarf; die vorgesehene Konfiguration sollte gemessen werden, statt die Dateigröße mit dem Spitzenwert des VRAM gleichzusetzen.
Unabhängig vom gewählten Weg sollten Wahrscheinlichkeitsschwellen mit gelabelten Produktionsdaten validiert werden, bevor folgenreiche Entscheidungen automatisiert werden.
Weiterführend: Der Test der gehosteten Liquid AI d1 API behandelt den direkten Endpoint, die Bildabrechnung und den typisierten Request-Vertrag ausführlicher.