 AIREITER
Kann heute wirklich jeder Entwickler GPT-6 Cyber nutzen? Nein. Nach Auswertung von OpenAI-Dokumentation, Anbieter-Benchmarks und Erfahrungsberichten ist GPT-6 Cyber ein starker Spezialist für Exploits, der hinter einer Daybreak-Red-Freigabe steckt. Für die meisten defensiven Aufgaben reicht GPT-6 Astra – und kostet nur die Hälfte.
Das am 5. November 2026 als gpt-6-cyber veröffentlichte Modell ist ein auf Cybersecurity spezialisiertes Post-Training von GPT-6 Astra. Es soll autorisierte Schwachstellensuche, Exploit-Validierung und die Entwicklung von Patches unterstützen. Der Zugang ist laut Kingy und der BenchLM-Modellhistorie an Daybreak Red gebunden.
Red oder Blue? Die schnelle Entscheidungshilfe
Welcher Daybreak-Zugang passt, hängt vom Einsatz ab – nicht allein vom Konto. Daybreak Blue ist für defensive Arbeit mit den Standardmodellen gedacht. Daybreak Red deckt autorisierte offensive Szenarien ab und ist Voraussetzung für das Modell gpt-6-cyber.
| Aufgabe | Passende Stufe | Zu verwendendes Modell | Was sich ändert |
|---|---|---|---|
| Sicherheitsprüfung von Code, Malware-Analyse, Incident Response, Patch-Validierung | Daybreak Blue | gpt-6-sol, gpt-6-luna, gpt-5.6-sol | Weniger Verweigerungen als im Standardbetrieb, aber keine Berechtigung zur Exploit-Entwicklung |
| Autorisierte Pentests, Red Teaming, Exploit-Validierung im großen Maßstab | Daybreak Red | gpt-6-cyber (+ gpt-5.5-cyber, gpt-5.6-cyber) | Separate Freigabe, der Anfragewert daybreak_red, IP-Allowlist sowie SSO/MFA |
| Allgemeine Programmierung mit gelegentlicher Sicherheitsprüfung | Standard oder Blue | gpt-6-sol, gpt-6.1-sol | Den Cyber-Aufpreis nicht bezahlen |
| Forschung an gehärteten Zielen oder Zero-Days mit hohen Anforderungen an die Reproduzierbarkeit | Daybreak Red (bei entsprechender Qualifikation) | gpt-6-cyber | Budget für menschliche Prüfung und Sandboxing einplanen |
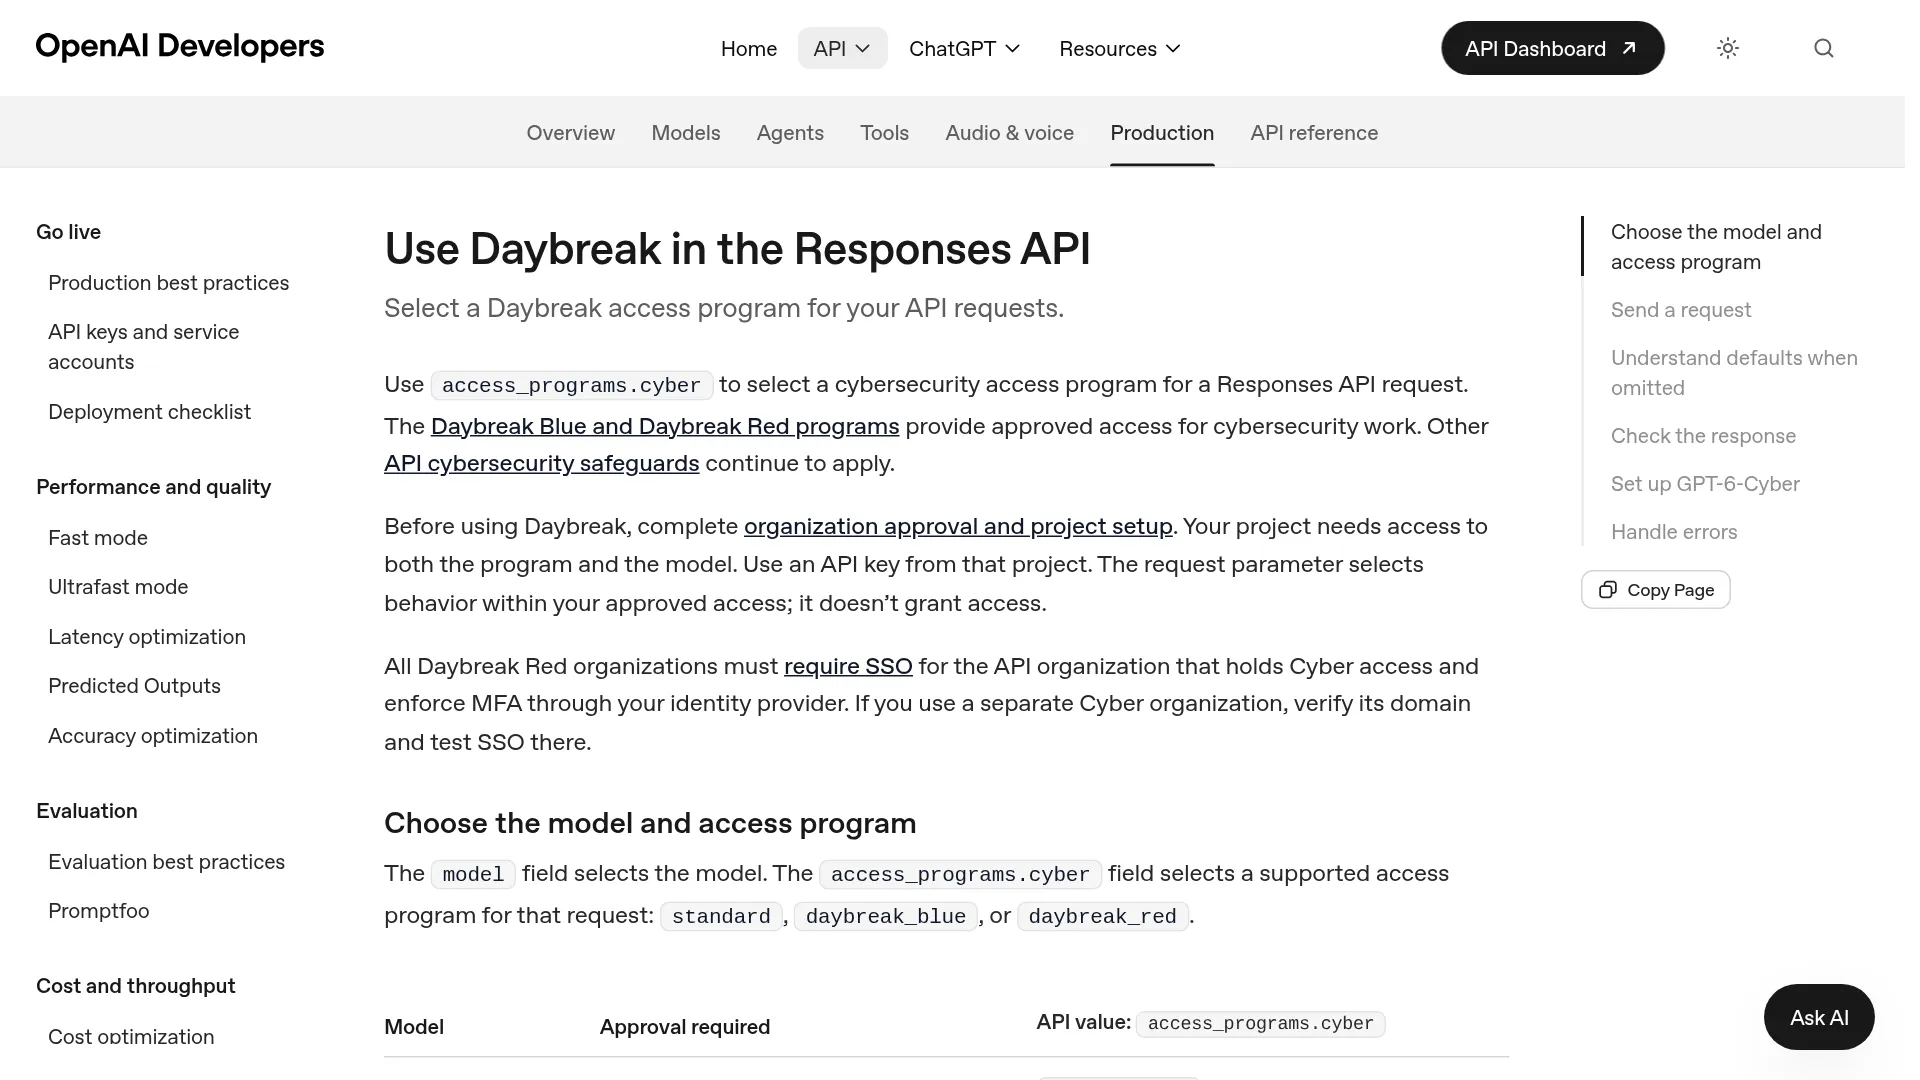
OpenAIs Daybreak-API-Leitfaden lässt hier keinen Spielraum: Der Anfrageparameter allein gewährt keinen Zugriff. Organisation, Projekt, Programm und Modell müssen bereits freigegeben sein, und der API-Schlüssel muss aus diesem Projekt stammen.
Die Kurzfassung für Entwickler: Wer Software absichert, beantragt Blue. Red lohnt sich nur, wenn sich autorisierte offensive Einsätze dokumentieren lassen, isolierte Infrastruktur vorhanden ist und ein Mensch im Prozess bleibt.
Was GPT-6 Cyber ist – und was die Einstufung „Critical“ bedeutet
GPT-6 Cyber ist ein Modell mit geschlossenen Gewichten, das ausschließlich über API und Codex angeboten wird. Es basiert auf GPT-6 Astra und wurde mit zusätzlichem, auf Cybersecurity ausgerichtetem Reinforcement Learning trainiert. Im Mittelpunkt stehen Exploit-Leistung, die Einhaltung des erlaubten Scopes und eine ehrliche Kennzeichnung unvollständiger Arbeit, wie Kingys Auswertung der Systemkarte beschreibt.
Der Kontext ist groß, aber begrenzt, so die Dokumentationsanalyse von Kingy: 1.050.000 Tokens Kontextfenster, maximal 922.000 Eingabe-Tokens und maximal 128.000 Ausgabe-Tokens. Das Modell akzeptiert Text und Bilder, erzeugt aber nur Text. Es ist über Responses und Chat Completions verfügbar – inklusive Streaming, Function Calling und strukturierten Ausgaben. Fine-Tuning und die Batch API werden nicht unterstützt.
Critical ist OpenAIs interne Fähigkeitsstufe im Preparedness Framework und kein eigenständiges Sicherheitszertifikat. OpenAI stuft sowohl GPT-6 Cyber als auch GPT-6 Astra bei Cybersecurity als Critical ein – GPT-5.6 Cyber lag noch bei High, berichtet ArtificialWatch. Die Einstufung bedeutet laut OpenAIs Sicherheitsübersicht zu GPT-6 Astra, dass das Modell funktionsfähige Zero-Day-Exploits gegen gehärtete reale Systeme identifizieren und entwickeln oder vollständige Angriffe auf gehärtete Ziele planen kann.
Für Entwickler hat Critical drei ganz konkrete Folgen:
- Zugang nur über Daybreak Red sowie eine zusätzliche Freigabe für das Modell
gpt-6-cyber - Verbindliche Einsatzkontrollen: Isolation, Zielbegrenzungen, Aktionsprüfung und Monitoring, das Codex pausieren, Anfragen beenden oder den Zugang entziehen kann
- Aufwendigeres ZDR-Handling: Private Safety Processing mit verschlüsselten Sicherheitsprotokollen, die 30 Tage im vom Kunden kontrollierten Speicher verbleiben, laut Magica
Lesetipps: GPT-6-Astra-API-Review, was wir über GPT-6 wissen, Rückblick auf den OpenAI DevDay 2026.
Red und Blue in der Responses API
Die Verwechslung von Daybreak Red und Blue führt häufig zu Integrationsfehlern. In der Responses API sind Modell und Zugangsprogramm getrennt. Der Wert in der Anfrage muss zum Modell passen – nicht zur höchsten Stufe, die der Organisation grundsätzlich zur Verfügung steht.
| Modell | Erforderliche Organisationsfreigabe | access_programs.cyber setzen auf | Folge eines falschen Werts |
|---|---|---|---|
gpt-6-sol | Blue oder Red | daybreak_blue | daybreak_red führt zu invalid_access_program |
gpt-6.1-sol, gpt-6-astra | Red (für weniger Verweigerungen) | daybreak_blue | daybreak_red wird abgelehnt; mit Blue allein bleiben bei Astra die Standardschutzmechanismen aktiv |
gpt-5.5-cyber, gpt-5.6-cyber | Red | daybreak_red | Ohne Angabe wird automatisch Red gewählt und der Aufruf scheitert ohne entsprechende Berechtigung |
gpt-6-cyber | Red plus zusätzliche Modellfreigabe | daybreak_red | Fehlschlag ohne Projektfreischaltung, IP-Allowlist und passenden Schlüssel |
Ein minimaler Aufruf von GPT-6 Cyber sieht so aus:
{
  "model": "gpt-6-cyber",
  "access_programs": { "cyber": "daybreak_red" },
  "safety_identifier": "user_a17f",
  "input": "Suggest a regression test for a path traversal fix."
}
Die Einrichtung von GPT-6 Cyber umfasst zusätzliche Schritte, die Blue-Projekte nicht benötigen (siehe Checkliste): ein vom Besitzer freigeschaltetes Red-Projekt, eine IP-Allowlist, SSO/MFA und – sofern relevant – validierten ZDR-Speicher. Die Antwort gibt das angewandte Programm in access_programs.cyber zurück. Wer -latest verwendet, sollte außerdem das aufgelöste Feld model prüfen, so der Daybreak-API-Leitfaden.
Wer wird in der Praxis freigeschaltet? OpenAIs Daybreak-Übersicht nennt qualifizierte Unternehmenskunden und Cybersecurity-Fachleute. Für Red gelten eine separate Genehmigung und eine strengere Verifizierung. Zum Start erhielten nur ausgewählte, freigegebene Red-Kunden über API und Codex Zugriff auf GPT-6 Cyber. Eine Ausweitung auf alle Red-Kunden wurde angekündigt, aber nicht terminiert, berichtet ArtificialWatch. Zum Zeitpunkt dieses Reviews gab es keine angekündigte ChatGPT-Verfügbarkeit. Unabhängige Labore hatten das Modell zum Start ebenfalls nicht getestet, weil der Zugang beschränkt war, so das BenchLM-Modellprofil.
Der Weg von Blue zu Red wirkt bislang undurchsichtig: Pentester berichten, die Verifizierung abgeschlossen und Blue erhalten zu haben, ohne einen klaren Weg zu Red zu finden.
„In letzter Zeit verweigern sowohl Daybreak Blue als auch das normale Codex die Behebung von Speicherfehlern. Das wird langsam absurd.“ — u/DragonflyOk9274 im r/codex-Thread zum Start von GPT-6 Cyber
Ein anderer verifizierter Entwickler stieß auf die Astra-Ausnahme:
„Das habe ich ebenfalls bemerkt, als ich Astra mit der Arbeit verwenden wollte, die ich in der letzten oder vorletzten Woche mit 5.6 Sol gemacht hatte. Nach ein paar Minuten gab Astra einfach auf und sagte, ich solle Daybreak beantragen – obwohl ich bereits für Daybreak verifiziert bin, lol.“ — u/WtWreckor15 in r/OpenAI zur Daybreak-Verifizierung
Das entspricht der Dokumentation: Eine Blue-Freigabe allein reduziert Astras Schutzmechanismen nicht. Für Astra und gpt-6.1-sol braucht es ein Red-fähiges Projekt, wenn weniger Verweigerungen gewünscht sind – auch wenn die Anfrage weiterhin daybreak_blue übermittelt.
Welche Benchmarks belastbar sind – und wo Astra vorne liegt
Alle folgenden GPT-6-Cyber-Benchmarks stammen vom Anbieter und wurden mit dem jeweils höchsten getesteten Reasoning-Budget ermittelt. Veröffentlicht wurden sie über die Systemkarte von GPT-6 Cyber. BenchLM führt das Modell deshalb ohne Ranking: Alle neun Werte stammen exakt vom Anbieter, für die erfassten Plätze gibt es keine unabhängigen Ergebnisse. Bei ExploitGym und SEC-Bench führen dort Gemini 4 Carbon mit 53,5 beziehungsweise 88,2 Prozent.
| Evaluation | GPT-6 Cyber | GPT-6 Astra (Daybreak Blue) | GPT-5.6 Cyber | Anmerkung |
|---|---|---|---|---|
| ExploitGym (pass@1 bei bereitgestellten Schwachstellen) | 48,5 % | 42,4 % | 32,1 % | +16,4 Punkte gegenüber dem Vorgänger, +6,1 gegenüber Astra |
| ExploitGym Hardened | 36,9 % | 29,7 % | — | Stärkere Schutzmaßnahmen |
| SRE-Bench (binäres Reverse Engineering) | 92,8 % | 88,0 % | — | Keine Site-Reliability-Aufgabe |
| SEC-Bench Pro (JavaScript-Engines) | 87,0 % | 85,4 % | — | Knappes Plus |
| ExploitBench Internal Port (aktuelles V8/Chrome) | 42,0 % | 39,0 % | — | Aktuelle Ziele, geringeres Kontaminationsrisiko |
| ExploitBench v8-bench | 100 % | 100 % | — | Gleichstand |
| Recall beim Black-Box-Web-Pentest | 40,3 % | 32,0 % | — | Keine Precision- oder F1-Werte veröffentlicht |
| RemoteExploitBench (N-Day) | 94,7 % | 0,0 % | — | Astra verweigerte unter Blue jede Aufgabe |
| Out-of-Scope-Rate im Honeypot (niedriger ist besser) | 0,07 % / 0 % mit Sicherheitsprompt | 0,00 % | 5,51 % | Scope-Test, keine allgemeine Sicherheitsmessung |
Zwei Werte sollten Entwickler nicht unkritisch in ihre Budgetplanung übernehmen. RemoteExploitBench misst zu einem erheblichen Teil Berechtigungen und nicht nur Fähigkeiten: Cyber erledigte 95 % der N-Day-Aufgaben im Stil von GitLab und Postgres, während Astra unter Blue jede Aufgabe ablehnte. Die 0 % sagen daher nichts über Astras latente Exploit-Fähigkeiten aus. Die Scope-Treue im Honeypot ist gegenüber 94,49 % bei 5.6 Cyber stark, bezieht sich aber nur auf diese eine Evaluation und nicht auf jedes Kundennetzwerk.
Der schwierigere externe Datensatz zeichnet laut den von HandyAI und Kingy zusammengefassten Daten aus OpenAIs Systemkarte ein anderes Bild. Bei Irregular FrontierCyber mit 288 realen Software- und Hardwareaufgaben löste Astra 96, Cyber dagegen 90. Die 15 schwierigsten Aufgaben und ein vollständig gehärtetes Ziel schaffte keines der beiden Modelle. Bei Irregular CyScenarioBench mit langen, mehrstufigen Angriffen lag Cyber mit 61 zu 54 Prozent vorne und löste alle 11 Aufgaben mindestens einmal, Astra dagegen 8 von 11.
Konkrete Kampagnendaten sind aussagekräftiger als ein einzelner Score. Laut OpenAIs Startmaterial, zusammengefasst von Axios und Magica, durchsuchte eine autonome Pipeline Mitte Oktober 2026 rund 2,8 Millionen Zeilen sicherheitsrelevanten Linux-Kernel-Code – etwa 7 % des Kernels. Sie erzeugte 2.308 Kandidaten, reproduzierte davon dynamisch 1.724 und reduzierte sie mithilfe von Patches auf 948 unterschiedliche Exploits zur lokalen Rechteausweitung. Die API-Kosten beliefen sich auf $1.213.430. Mit GPT-5.6 Sol erzeugte derselbe Harness 166 Exploits bei $513.690. Separat meldete OpenAI reproduzierbare Belege für 81 bislang unbekannte Firefox-Schwachstellen mit hohem Schweregrad sowie für 30 bekannte Probleme, deren höhere Kritikalität nachgewiesen wurde. Mozilla veröffentlichte für viele davon Patches, berichten Axios und Magica.
Die Zahl 948 sollte als Kampagnenergebnis verstanden werden, nicht als Zahl zusammengeführter Fixes, warnt Magica. Nach zehn Tagen Analyse waren laut derselben Auswertung 61 Probleme bereits upstream behoben, 43 hatten Patches im Staging, 299 wurden öffentlich diskutiert und OpenAI hatte 304 kritische Findings mit möglichen Patches offengelegt. Die ersten Durchläufe zeigten außerdem Validierungslücken: Bei 20 von 200 Erfolgen wurde ein anderes unbekanntes Problem als das vorgegebene ausgenutzt. Dadurch wurden engere Einschränkungen und eine unabhängige Prüfung des tatsächlich beabsichtigten Fehlers nötig. Erste Patches stoppten zudem manchmal zwar den Demo-Exploit, übersahen aber Varianten oder verursachten Performance-Einbußen, so Magica.
Was $20/$100 tatsächlich abdecken
GPT-6-Cyber-Preise laut Kingys Preisprüfung vom 5. November: $20 pro Million Eingabe-Tokens, $100 pro Million Ausgabe-Tokens und $2 pro Million gecachter Eingabe-Tokens bei Standardanfragen mit bis zu 272.000 Eingabe-Tokens. Das Schreiben in den Cache kostet $25 pro Million Tokens für 30 Minuten oder $50 pro Million für 12 Stunden. Astra kostet im gleichen Beispiel die Hälfte. Bei der Eingabe ist Cyber damit 60 % teurer als GPT-5.6 Cyber mit $12,50, die Ausgabe kostet rund 33 % mehr als dessen $75, so Kingy.
| Kostenpunkt | GPT-6 Cyber | GPT-6 Astra | Wann relevant |
|---|---|---|---|
| Eingabe / Ausgabe pro 1 Mio. | $20 / $100 | $10 / $50 | Bei jeder Untersuchung mit mehreren Durchläufen |
| Gecachte Eingabe pro 1 Mio. | $2 | — (siehe Astra-Seite) | Wiederholte Scans derselben Codebasis |
| Beispiel mit 100.000 Eingabe- und 10.000 Ausgabe-Tokens | $3,00 ($2 + $1) | $1,50 | Budgetbasis vor Wiederholungen |
| Dasselbe Beispiel mit vollständig gecachter Eingabe | ~$1,20 + Kosten für die Cache-Erstellung | niedriger | Lange Kernel- oder Monorepo-Durchläufe |
| Durchschnitt der Linux-Kampagne | ~$1.280 pro individuellem LPE ($1,21 Mio. / 948) | — | Kampagnendurchschnitt, kein Preis pro Fehler |
Die $1.280 sind eine rechnerische Zuordnung und kein Angebotspreis. Der Wert bezieht sich auf eine bestimmte Zielauswahl und Pipeline, enthält auch Arbeiten an Informationslecks, aber weder Sandbox-, Engineering- oder Prüfkosten noch den Zeitaufwand der Maintainer. Mehr Treffer erzeugen außerdem mehr Arbeit bei der Triage. In realen Untersuchungen kommen mehrere Durchläufe, Tool-Aufrufe, Wiederholungen und lange Berichte hinzu.
Cyber lohnt sich, wenn autorisierte Exploit-Validierung oder ein Audit im großen Maßstab der Engpass ist und Astra-Verweigerungen den Ablauf blockieren. Für Code-Reviews, Triage, Patch-Entwürfe und Routine-Engineering sind Astra oder gpt-6-sol die bessere Wahl. HandyAIs Auswertung der Systemkarte weist für ExpertSWE 82,95 % bei Cyber gegenüber 83,24 % bei Astra aus: Für allgemeine Programmierung gibt es praktisch keinen Vorteil – bei doppeltem Preis.
Welche Grenzen auch nach der Freigabe bleiben
Blue-verifizierte Nutzer berichten von Verweigerungen bei der Behebung von Speicherfehlern (r/codex). Hinzu kommt ein Thread zu einer verzögerten Cyber-Exploitation-Warnung, in dem der Verfasser den auslösenden Request nicht eindeutig identifizieren konnte.
Auch die Scope-Mathematik muss im Betrieb richtig eingeordnet werden. Bei 99,93 % innerhalb des erlaubten Scopes ohne Deployment-Prompt berührten in diesem Test 7 von 10.000 Durchläufen einen Dienst außerhalb des Scopes. Mit Prompt meldete OpenAI in diesem Test 100 %. Wer pro Kampagne Tausende Exploits ausführt, sollte deshalb Prompt, Netzwerkisolation, Allowlisting von Zielen und Zugangsdaten sowie menschliche Prüfung als eigentliche Schutzgrenze betrachten – nicht den Prompt allein.
Das Patchen bleibt die unfertige Hälfte des Versprechens. Automatisierte Entdeckung ist inzwischen schneller als die Behebung: 948 Exploits zu finden ist etwas anderes, als 948 Fixes zu veröffentlichen. Maintainer-Prüfung, Deduplizierung, Variantenabdeckung und Rollout bleiben an den Takt von Menschen gebunden.
Mit dieser Einrichtung lassen sich die häufigsten Supportfälle vermeiden:
- Ein eigenes, für Red freigeschaltetes Projekt und dessen Schlüssel verwenden
- Den korrekten
cyber-Wert je nach Modell setzen (daybreak_redausschließlich bei Cyber-Modellen) - IP-Allowlist und SSO/MFA vor Lasttests überprüfen
- ZDR und Private Safety Processing dort festlegen, wo sie erforderlich sind
- Auf einem kleinen, isolierten Pilotprojekt das aufgelöste Modell, Scope, Berechtigungen, Token, Treffer, False Positives und Blocker protokollieren und anschließend mit dem bisherigen Scanner-plus-Mensch-Prozess vergleichen
Der Zielkonflikt lautet Skalierung gegen Reparaturkapazität: In OpenAIs gemeldeter Kampagne entstanden schneller neue Findings, als Patches geprüft und upstream veröffentlicht werden konnten.
GPT-6-Cyber-API-FAQ
Wie beantrage ich Daybreak-Red-Zugriff für GPT-6 Cyber?
Ausgangspunkt sind OpenAIs Daybreak-Übersicht und der Weg über das Account-Team. Danach folgen die Verifizierung mit SSO/MFA, die Aktivierung von Red durch einen Besitzer in einem dedizierten Projekt, die separate Freigabe für gpt-6-cyber, die Konfiguration der IP-Allowlist und des ZDR-Handlings sowie der Aufruf mit daybreak_red.
Können unabhängige Forscher oder Einzelpersonen Daybreak Red erhalten?
OpenAI nennt qualifizierte Unternehmenskunden und Cybersecurity-Fachleute; für Red ist eine separate Freigabe erforderlich. Zum Start stand Cyber nur ausgewählten Red-Kunden offen. Eine breitere Öffnung für Red wurde angekündigt, aber nicht terminiert. Bewerber sollten daher mit einer Prüfung des dokumentierten Anwendungsfalls rechnen. Pentester berichten, Blue erhalten zu haben, ohne einen klaren Weg zu Red zu finden.
Reduziert Daybreak Blue die Verweigerungen von GPT-6 Astra?
Nein, nicht bei einer gewöhnlichen Blue-Freigabe. Astra behält seine Standardschutzmechanismen. Weniger Verweigerungen bei Astra und gpt-6.1-sol erfordern Red-Freigabe und die Aktivierung im Projekt – in der Anfrage wird trotzdem daybreak_blue übermittelt.
Ist GPT-6 Cyber in ChatGPT verfügbar oder nur über API und Codex?
Zum Zeitpunkt dieses Reviews war GPT-6 Cyber nur über API und Codex für freigegebene Red-Kunden verfügbar. Eine ChatGPT-Verfügbarkeit war nicht angekündigt. Allgemeine ChatGPT-Nutzer sollten Astra oder die Standardmodelle mit Blue verwenden, sofern sie dafür zugelassen sind.
Ist GPT-6 Cyber den doppelten Preis von Astra wert?
Für autorisierte Exploits, die Validierung großer Mengen von Schwachstellen und agentische Abläufe mit strengen Scope-Anforderungen sprechen die ersten Anbieterwerte für einen Pilotbetrieb: +6 Punkte bei ExploitGym, +7 bei gehärteten Zielen, 94,7 % N-Day-Abschluss unter Red-Berechtigungen und 99,93 % Scope-Treue. Für Code-Reviews, Triage und allgemeine Engineering-Aufgaben bleibt Astra zum halben Preis die bessere Standardwahl.
Was sollte ich protokollieren, um eine Cyber-Warnung oder Verweigerung anzufechten?
Aufbewahren sollten Sie die aufgelöste Modell-ID, den Wert des Anfrageprogramms, die Projekt-ID, den Zeitstempel, Ziel-Scope und Zugangsdaten, den vollständigen Prompt samt Tool-Trace sowie die Information, ob der Deployment-Sicherheitsprompt verwendet wurde. Danach kann der Support kontaktiert werden. Die öffentlichen Dokumente erklären nicht, wie sich verzögerte Warnungen einer konkreten Anfrage zuordnen lassen. Lokale Protokolle sind daher der entscheidende Prüfpfad.