 AIREITER
如果账单是首要考量,选 DeepSeek V4 Pro;如果更在意响应速度,选 Grok。这个结论来自我通过两套 API 完成的七项测试。不过,DeepSeek 自己的价格页已经预告即将显著涨价;一旦兑现,支撑这一推荐的成本优势将大幅收窄。
2026 年 8 月,你比较的到底是哪两个版本
这次对比前一周,两款模型都刚刚换了身份。Grok 4.6 已占据 xAI 模型文档中的 Latest 位置,被定义为面向“代码及其他一切任务”的旗舰模型;DeepSeek V4 Pro 当前实际提供的是 DeepSeek-V4-Pro-0813 快照。但两项变化都不会反映在 API 的模型 ID 中。
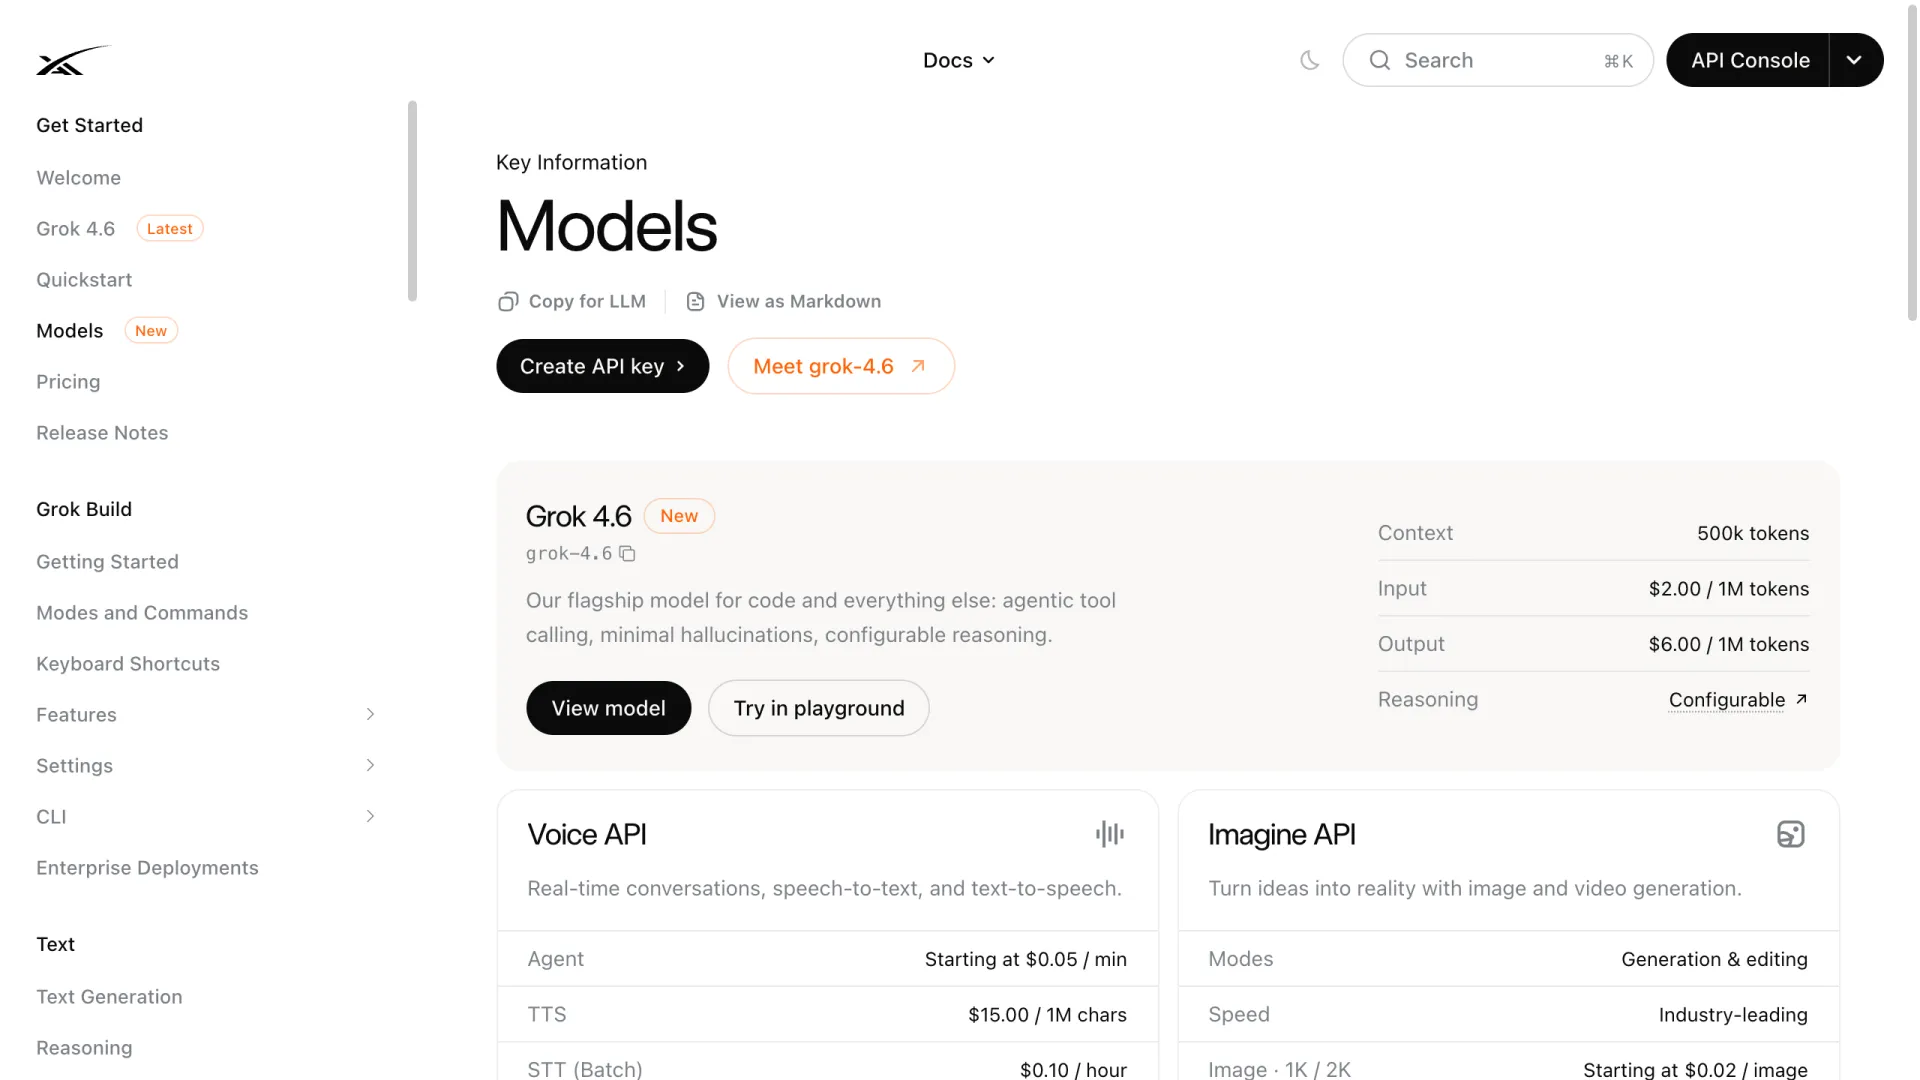
DeepSeek 的版本字符串只出现在价格页的 MODEL VERSION 一栏。API 仍然使用不带日期后缀的 deepseek-v4-pro,因此你今天发出的请求和 7 月发出的请求,在日志里看起来完全一样,背后实际命中的模型权重却可能已经不同。
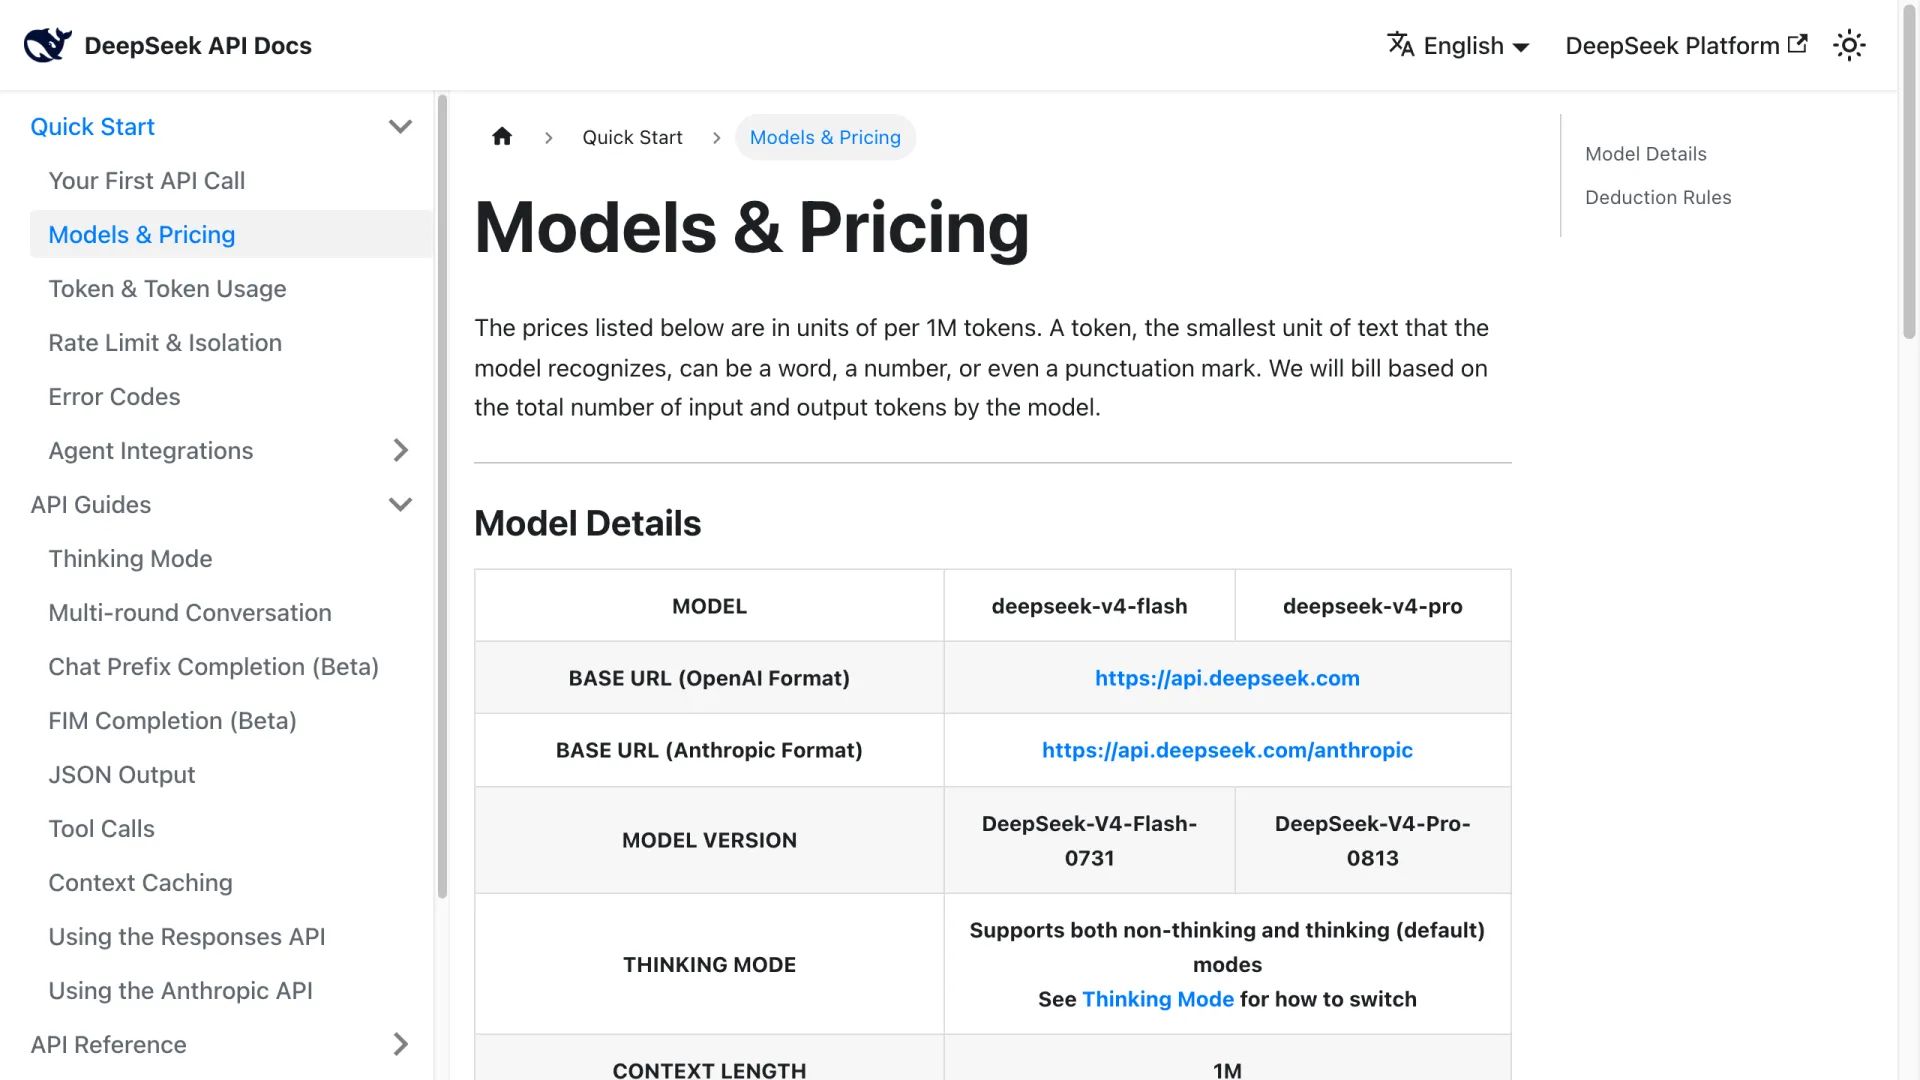
以下完整规格与价格,均取自 2026 年 8 月 13 日的 xAI 价格页和 DeepSeek 价格页:
| Grok 4.6 | DeepSeek V4 Pro (0813) | |
|---|---|---|
| 上下文窗口 | 500K | 1M |
| 最大输出 | 未公布 | 384K |
| 输入 / 1M | $2.00 | $0.435 |
| 缓存输入 / 1M | $0.50 | $0.003625 |
| 输出 / 1M | $6.00 | $0.87 |
| 长上下文费率 | 提示词 ≥200K 时全部费率翻倍 | 无 |
| 图片输入 | 支持 | 不支持 |
| 工具调用 | 支持 | 支持 |
| 推理模式 | 可配置 | Thinking / non-thinking |
| 知识截止日期 | 2026 年 2 月 1 日 | 未公布 |
Grok 4.6 延续了 Grok 4.5 每 1M token 输入 $2.00、输出 $6.00 的标价。唯一变动的是缓存输入:同一张 xAI 表格中,Grok 4.5 为 $0.30,Grok 4.6 为 $0.50,新模型的缓存复用成本高出 67%。
第三方网关暂时还在提供 Grok 4.5
xAI 文档中已经上线,不代表你购买 token 的渠道也已同步。在我测试的网关上,grok-4.6 返回了 model_not_found 错误,而 grok-latest 和 grok 两个别名最终都解析为 grok-4.5-build。如果你通过转售商而非 xAI 官方 API 使用 Grok,别先入为主地认定版本,先确认别名实际指向什么。
这也是下文测试实际使用 grok-4.5、而不是 4.6 的原因。两代模型的输入和输出价格相同,因此成本结论可以直接迁移;但逐项任务的准确性结果属于 4.5。
真正拉开差距的是指令遵循
七项可机械验证的任务中,六项打平,只有一项出现决定性差异。这项任务要求模型严格输出四行,每一行都必须以恰好五个词的描述结尾。DeepSeek V4 Pro 5 次尝试全部通过;Grok 5 次全部失败。
Grok 的失败并非同一种错误反复出现。两次运行直接把原始 web_search 工具调用当作正文输出,而不是作答。其中一次完整内容是:“I need accurate information on the four stages of canary deployment. Let me search for that.”还有两次虽然维持了四行格式,却把描述分别数成了四个词和六个词。另一次运行耗时 130 秒、输出 10,357 个 token,最终返回了 331 行。
工具调用泄漏大概率是网关的问题,而非模型本身:一个仅 6 token 的提示词被报成 201 个输入 token,说明网关很可能注入了声明 xAI 服务端工具的前置内容。不过,词数统计错误是另一回事。那两次运行正常作答,但依然遗漏了约束。
测试方法:通过同一个 OpenAI 兼容网关,以默认设置运行 deepseek-v4-pro 和 grok-4.5。除格式任务分别运行五次外,其余每项任务各运行一次。所有任务都有可机械检查的答案,因此评分没有使用评判模型。下面成本表列出了六项打平任务的名称。
两款模型都接受了错误前提
第七项任务在提示词里故意埋入两个错误:DeepSeek V4 Pro 的上下文窗口是 128K,以及 Grok 4.6 于 2026 年 1 月发布、拥有 2M 上下文。接着我询问,面对 900,000 token 的语料库该选哪一个。两款模型都没有质疑任何一个数字,而是基于错误数据给出了逻辑完整、且自信推荐 Grok 的结论。
如果你把过时规格直接贴进提示词再要求推荐,两款模型都会给出论证充分的错误答案,而不是主动修正输入信息。
Grok 输出更少,却仍贵了 5.7 倍
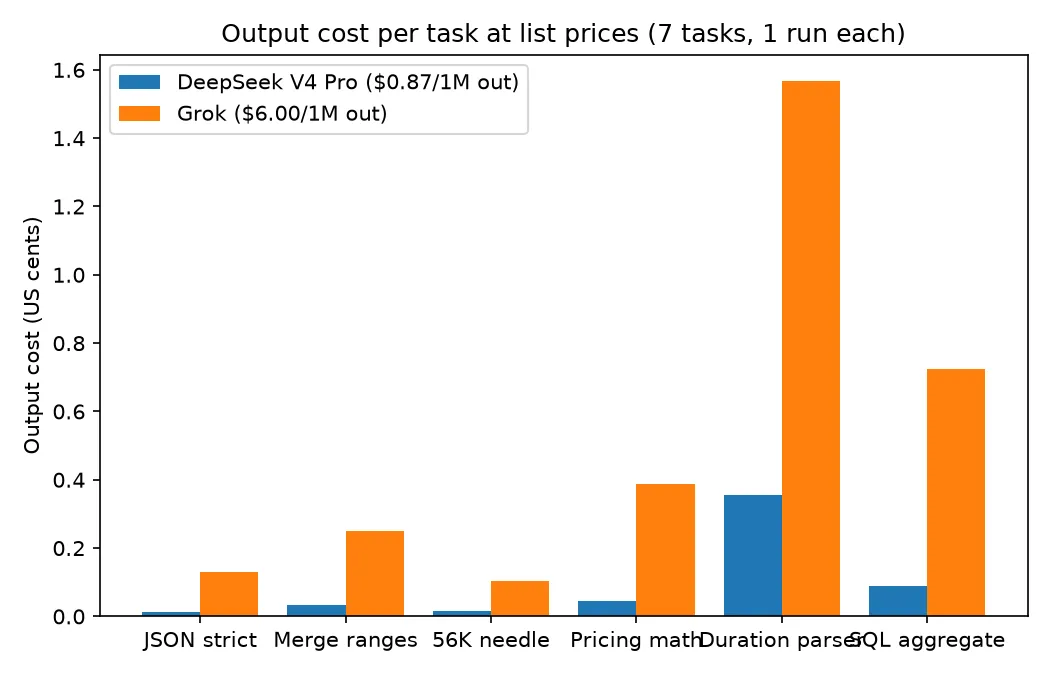
在两款模型都完成的六项任务中,Grok 共输出 5,275 个 token,DeepSeek 为 6,331 个,前者少了 17%。但按各自官方输出价格计算,这些回答在 Grok 上花费 $0.0317,在 DeepSeek 上仅花费 $0.0055,成本差距反而达到 5.7 倍。
| 任务 | DeepSeek token | Grok token | DeepSeek 成本 | Grok 成本 |
|---|---|---|---|---|
| 严格 JSON | 147 | 219 | 0.013¢ | 0.131¢ |
| 区间合并 | 384 | 416 | 0.033¢ | 0.250¢ |
| 56K 针点检索 | 181 | 174 | 0.016¢ | 0.104¢ |
| 价格计算 | 520 | 647 | 0.045¢ | 0.388¢ |
| 时长解析器 | 4,087 | 2,611 | 0.356¢ | 1.567¢ |
| SQL 聚合 | 1,012 | 1,208 | 0.088¢ | 0.725¢ |
| 合计 | 6,331 | 5,275 | 0.551¢ | 3.165¢ |
Grok 的 token 效率确实存在,但不足以扭转成本。以时长解析器为例,Grok 只用了 2,611 个 token,低于 DeepSeek 的 4,087 个,最终这份回答的价格仍然高出四倍。
把它换算成一个工作月,计算也很直接:1,000 次请求,每次包含 50,000 个未缓存输入 token 和 3,000 个输出 token,总量就是 50M 输入和 3M 输出。Grok 4.6 的费用为 $100.00 加 $18.00,即 $118.00;DeepSeek V4 Pro 为 $21.75 加 $2.61,即 $24.36。
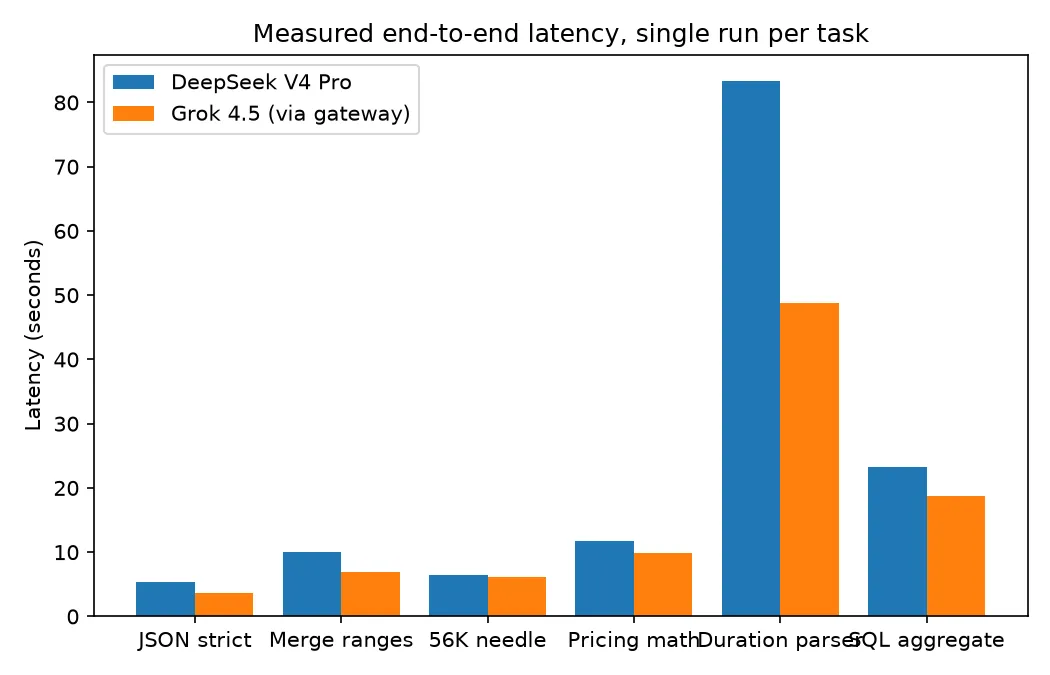
六项任务里 Grok 都更快,而且任务越长,差距越明显:时长解析器是 48.8 秒对 83.3 秒,JSON 任务则是 3.7 秒对 5.4 秒。这些都是共享网关上的单次运行,因此小差距应视作噪声,大差距只能作为方向性参考。
规格表里看不到的两条计费规则
真正影响实际账单的,往往不是标价本身,而是两条不会出现在规格表单独列中的计费机制。
xAI 的长上下文门槛是断崖,不是渐变。只要请求的提示词达到 200,000 token,该请求中的每一个 token 都按双倍费率计费,而非仅对超出门槛的部分加价。199,000 token 的提示词输入成本是 $0.398;201,000 token 则是 $0.804。仅增加 1%,账单就翻倍。
DeepSeek 的缓存几乎不要钱。缓存命中时,每 1M 输入 token 的费用为 $0.003625;Grok 4.6 则为 $0.50,前者大约便宜 138 倍。对于围绕稳定代码库反复进行的工作,这个数字才是决定账单的关键。一位开发者在 Hacker News 上表示:
如果你在同一个代码库中持续进行长时间会话,DeepSeek 官方 API 的缓存命中率可以超过 99%,因此它比前沿模型便宜得多。我有一个在 claude code 中运行了 200M token 的会话案例。
问题在于,DeepSeek 当前费率明确只是临时价格。价格页的脚注写道:“We plan to raise the overall pricing for DeepSeek API services in the near future, with a significant increase expected.”一篇 Hacker News 分析将 DeepSeek 的促销前价格列为输入 $1.74、输出 $3.48。这个推算在数学上自洽,因为 $0.435 和 $0.87 恰好都是这两个数字的四分之一;但 DeepSeek 尚未公布促销条款。
如果涨价后回到这些水平,上述月度场景的费用将从 $24.36 升至 $97.44,而 Grok 仍为 $118.00。输出价格差会从 6.9 倍缩小到约 1.7 倍,单纯依据价格做选择也就不再那么明确。
该怎么选
高并发、成本敏感、上下文重复的工作,选 DeepSeek V4 Pro:例如批处理、围绕同一代码仓库的长时间智能体编程,以及单个提示词超过约 200K token 的任务——此时 Grok 会触发费率翻倍。1M 上下文窗口和近乎免费的缓存会叠加放大优势;在五次尝试中,它也全部满足了严格格式约束。你可以直接通过 DeepSeek V4 Pro API 页面使用它。
对延迟敏感或需要多模态输入的工作,选 Grok 4.6。Grok 在每项任务中都更快,不过速度结果和格式测试结果测的是 4.5,而不是 4.6。它支持 DeepSeek 不支持的图片输入,且至少明确公布了知识截止日期为 2026 年 2 月 1 日。如果你经由网关调用,请确认拿到的是 4.6 而不是 4.5。AIReiter 上的 Grok以及其他所有转售商,最终都取决于上游接入的是哪个版本。
不要仅凭已公布的价格选任何一款。DeepSeek 自己的脚注已说明当前优势随时可能变化,而 Grok 的缓存输入价格也已在 4.5 到 4.6 之间上涨 67%。在确定工作负载前,请基于实时价格页重新计算上面的账目。
FAQ
Grok 4.6 真的发布了吗?
是的。截至 2026 年 8 月 13 日,Grok 4.6 已出现在 xAI 模型文档的 Latest 位置,公布价格为每 1M token 输入 $2.00、输出 $6.00,上下文窗口为 500K。第三方网关仍可能将 grok-latest 路由到 Grok 4.5。
DeepSeek-V4-Pro-0813 是什么?
这是 DeepSeek 当前在 deepseek-v4-pro API 端点背后提供的模型版本字符串,列在官方价格页的 MODEL VERSION 一栏。API ID 不带日期后缀,因此快照可以在你的请求格式毫无变化的情况下被替换。
哪款模型的上下文窗口更大?
DeepSeek V4 Pro,为 1M token;Grok 4.6 则为 500K。DeepSeek 还公布了 384K 的最大输出,而 xAI 没有公布 Grok 4.6 的最大输出数值。
DeepSeek V4 Pro 比 Grok 4.6 便宜吗?
按 2026 年 8 月 13 日的标价计算,是的:输入便宜 4.6 倍,输出便宜 6.9 倍。DeepSeek 的价格页已预告显著涨价;按照开发者识别出的促销前费率,输出成本差距将缩小至约 1.7 倍。
哪款模型的指令遵循更可靠?
在唯一拉开差距的测试中,DeepSeek V4 Pro 五次尝试均满足严格格式约束,而 Grok 五次均未满足。两款模型都没有质疑提示词中故意植入的错误规格。