 AIREITER
同一组提示词下,GPT-5.6 Luna 和 DeepSeek V4 Pro 在我们的 API 测试中都拿到了 3/3 的正确结果,单看能力很可能不足以帮你做决定。真正拉开差距的是价格结构和延迟;而且 DeepSeek 官方定价页已经明确提示,API 服务价格近期将有显著上涨。以下是我们于 2026 年 8 月 10 日测得的数据,以及不同场景下的选择建议。
相同提示词实测:两款 API 都答对了什么
2026 年 8 月 10 日,我们通过同一套 API 流程,分别以默认设置向 GPT-5.6 Luna 和 DeepSeek V4 Pro 发送了三项完全相同的任务:一道故意要求极简回复的 Python 修复题(“只回复修正后的函数”)、一道答案唯一的三月台卡车调度推理题(答案为 10:10),以及一项包含可空字段的严格 JSON 提取任务。两款模型全部答对。
| 任务 | GPT-5.6 Luna | DeepSeek V4 Pro |
|---|---|---|
Python merge_intervals 缺陷修复 | 正确(修复 max()),10.7 秒 | 正确(修复 max()),16.1 秒 |
| 月台调度推理 | 正确(10:10),8.0 秒 | 正确(10:10),27.2 秒 |
| 严格 JSON 提取 | 合法,完全符合 schema,3.0 秒 | 合法,完全符合 schema,7.6 秒 |
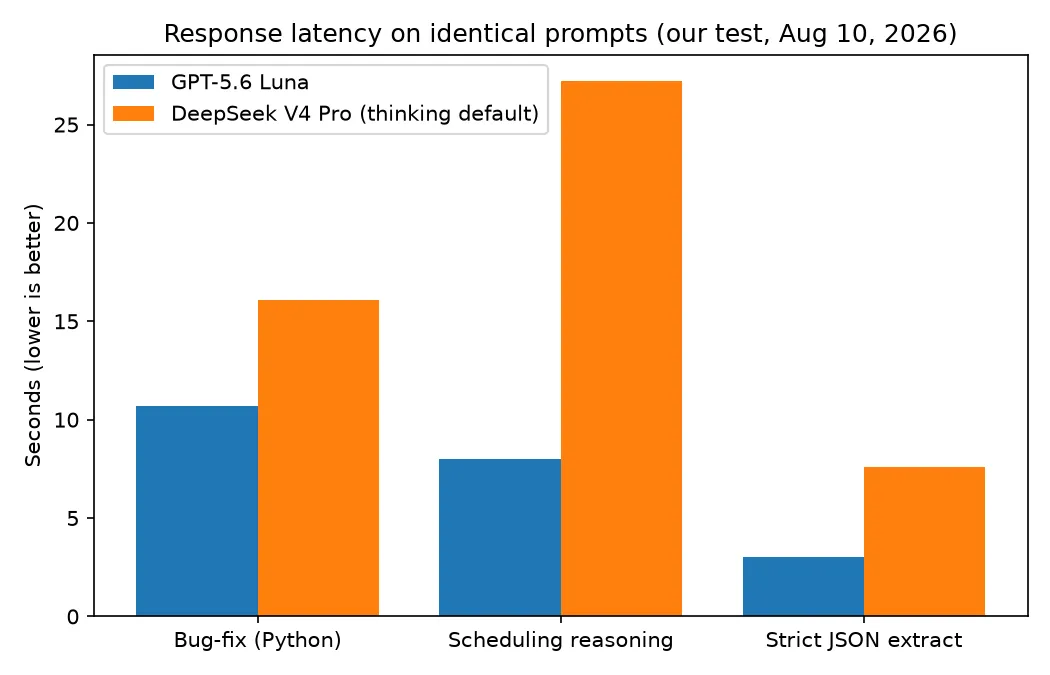
这里有两点限制和两项细节值得注意。这只是三项任务的抽样测试,不是完整基准测试。V4 Pro 默认开启思考模式,这基本解释了它在本轮测试中 2–3 倍的延迟差距;每次请求都可以关闭该模式,但高难度推理能力会有所损失。指令遵循方面,Luna 按要求只返回了函数本身,V4 Pro 则额外套了一层 Markdown 代码围栏。在聊天窗口里这无伤大雅,但在自动化流程中会多出一步解析。为检查稳定性,我们把调度题又跑了一次,两款模型仍都回答 10:10。
官方价格核验:DeepSeek 已预告涨价
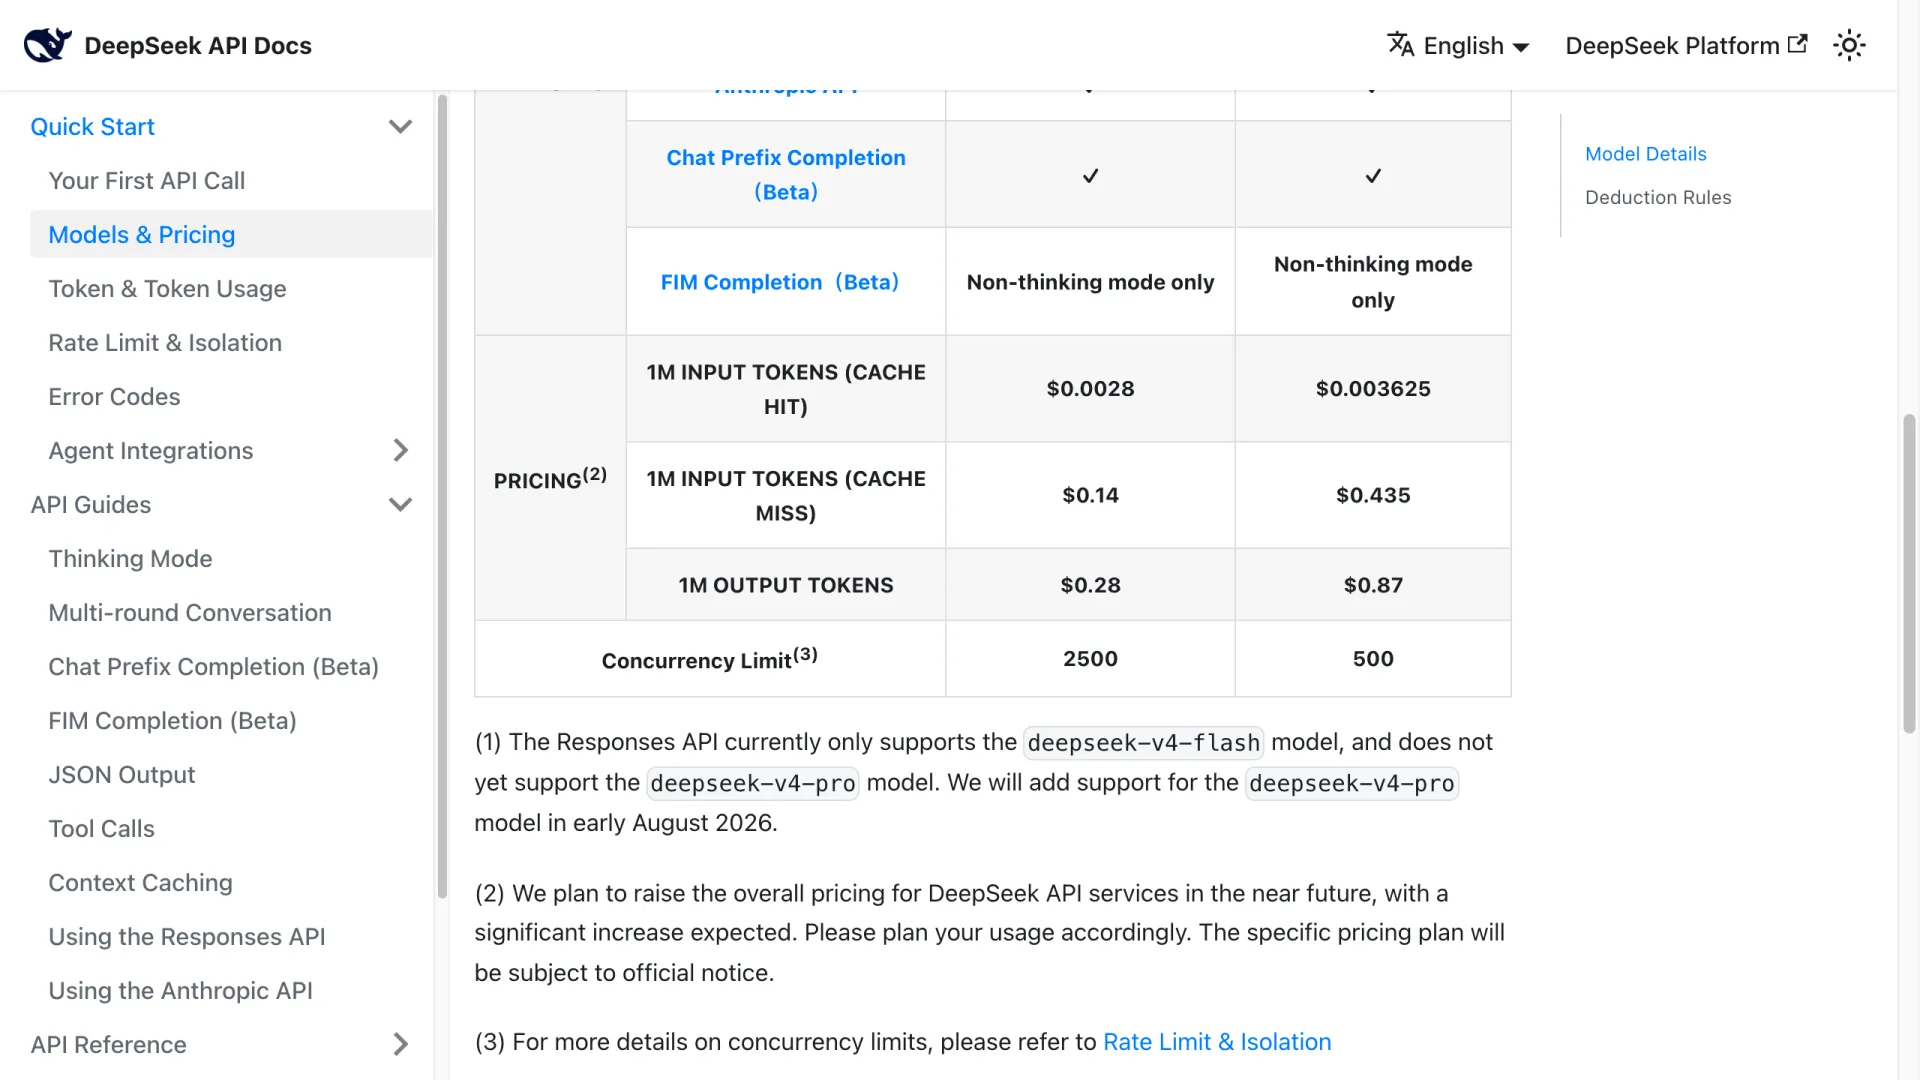
我们于 2026 年 8 月 10 日核对了两家厂商的官方页面:GPT-5.6 Luna 的价格为每百万输入 token $0.20、缓存输入 $0.02、输出 $1.20(OpenAI 模型页面);DeepSeek V4 Pro 的缓存未命中输入为每百万 token $0.435、缓存命中输入 $0.003625、输出 $0.87(DeepSeek 定价页面)。
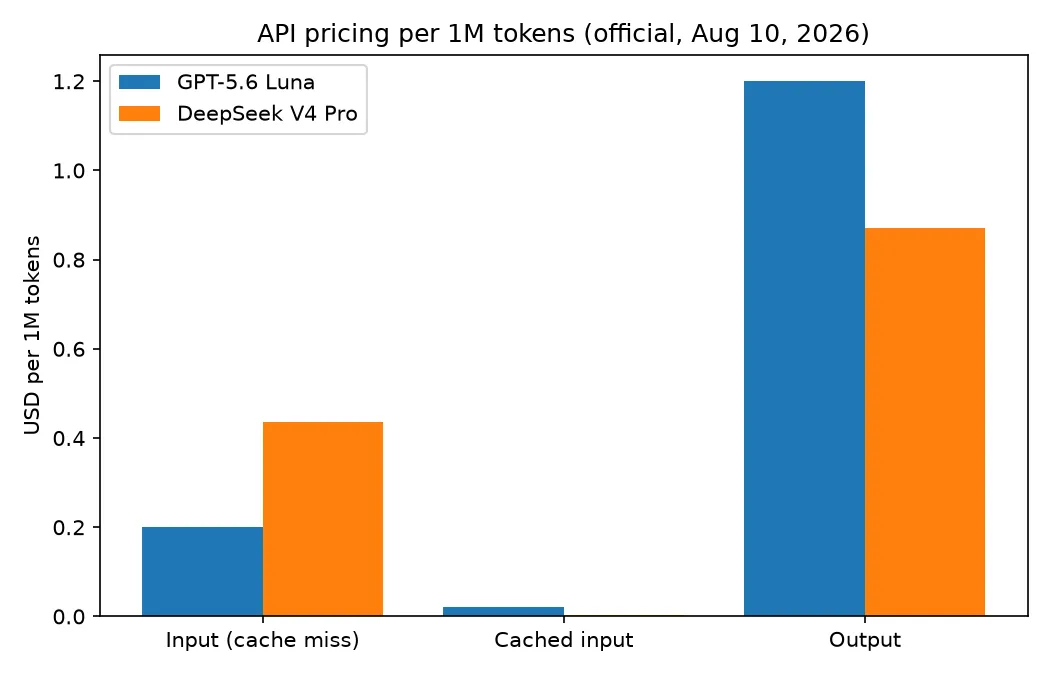
因此,不能简单说哪一款“更便宜”:Luna 的非缓存输入便宜 54%;V4 Pro 的输出便宜 27%;而 V4 Pro 的缓存命中价格比 Luna 低 5.5 倍。最终成本取决于你的 token 构成:
- 交互式聊天(每次调用 1K 输入 + 500 输出):Luna 为 $0.0008,V4 Pro 为 $0.00087,基本可以视为持平。
- 代码仓库审查(50K 全新输入 + 3K 输出):Luna 为 $0.0136,V4 Pro 为 $0.0244,Luna 便宜 44%。
- Agent 循环(每轮 200K 缓存输入 + 20K 全新输入 + 10K 输出):Luna 为 $0.020,V4 Pro 为 $0.018。此时 V4 Pro 更划算,而且缓存轮次越多,优势越明显。
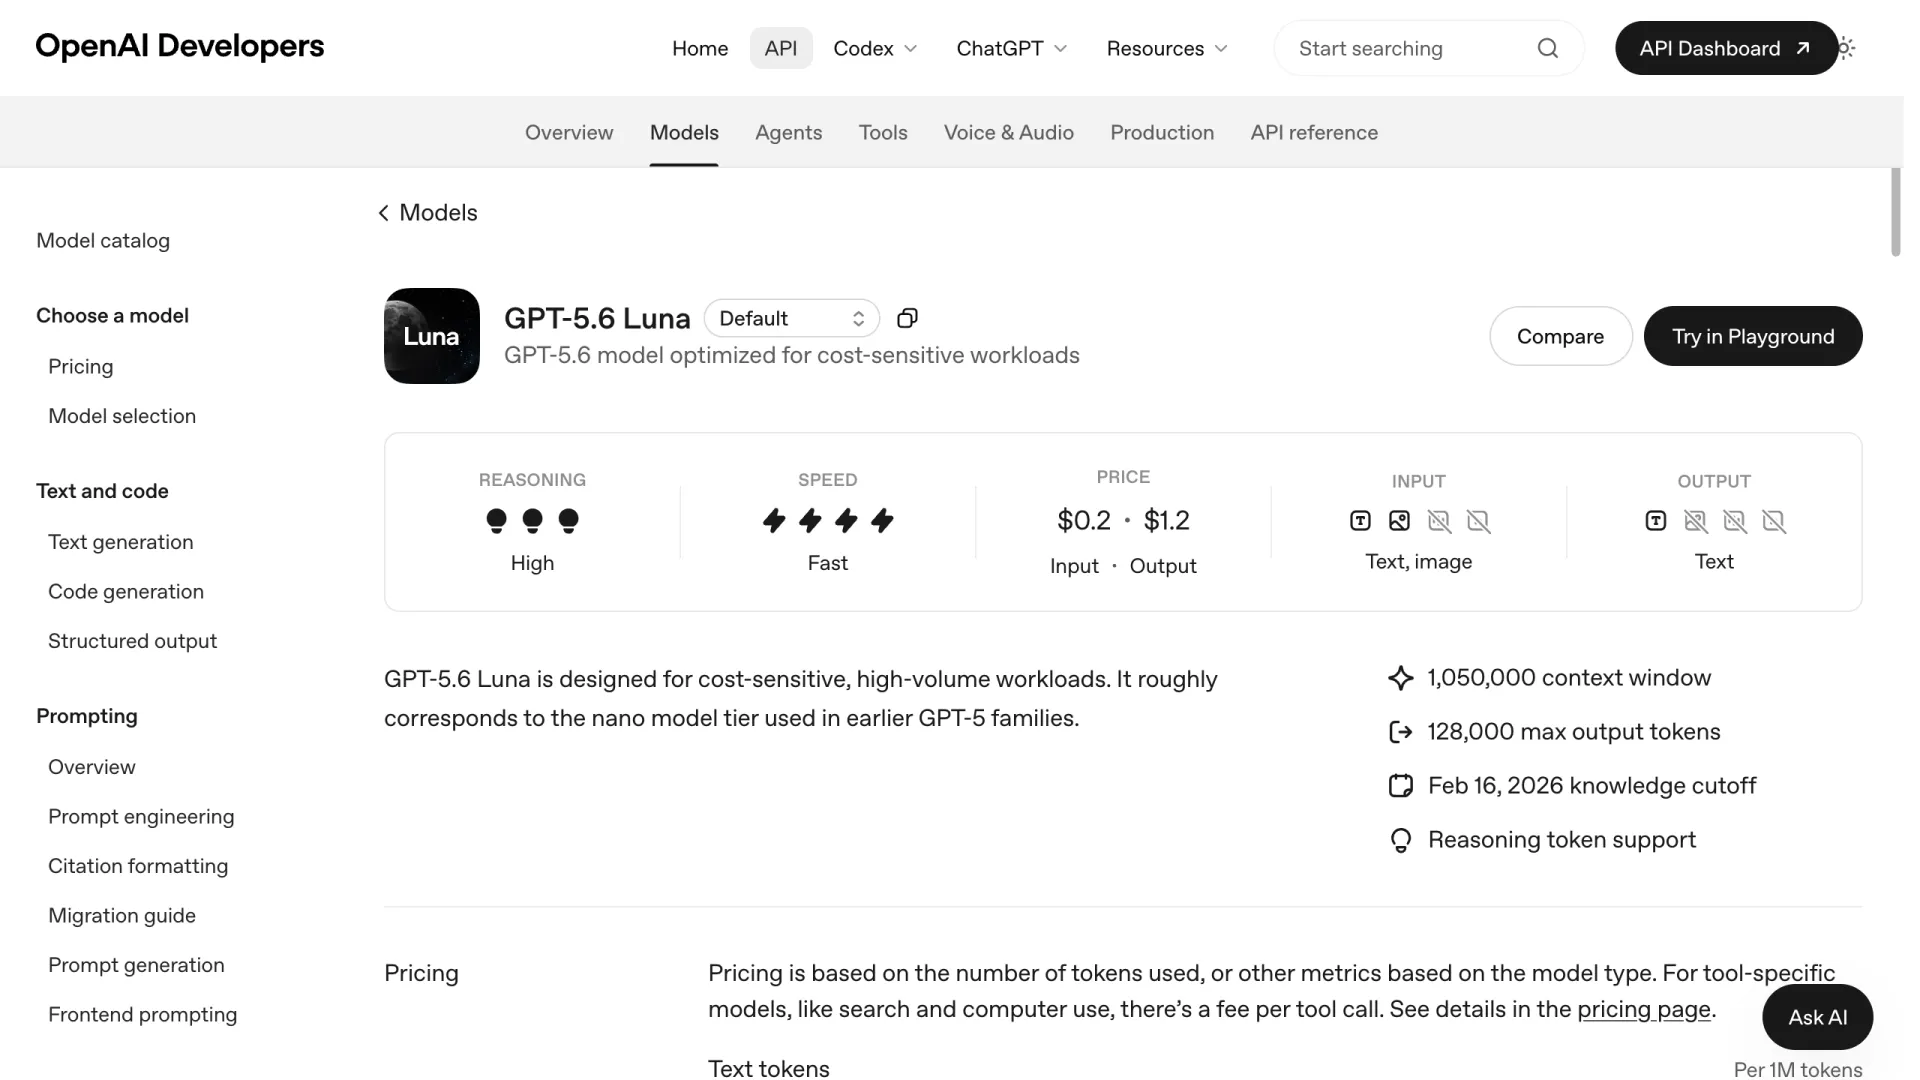
还有一项事实会影响这套成本计算的有效期。DeepSeek 定价页的脚注 2 写道:“我们计划在近期上调 DeepSeek API 服务的整体定价,预计涨幅较大。”目前没有给出日期或具体幅度。但如果你选择 V4 Pro 的核心理由是价格,这条官方预告意味着它存在明确的价格不确定性。Luna 的定价走势则相反:它伴随着 OpenAI 在 8 月下调 GPT-5.6 价格一同推出。
缓存成本:V4 Pro 的主场
DeepSeek V4 Pro 的缓存输入为每百万 token $0.003625,Luna 则是 $0.02,二者相差 5.5 倍。对于每一轮都要重复读取一大段不变前缀的 Agent 工作负载,这一差距会成为总成本的决定因素。已有开发者注意到了这一点:
DeepSeek v4 Pro & MiMo v2.5 Pro ... 对于 Agent 驱动的工作来说便宜得惊人,因为它们的缓存输入价格极低($0.0036/mtok)。Luna 的缓存输入价格……定价页写的是 $0.02/mtok,贵了 5 倍。— Hacker News 评论者,发表于 GPT-5.6 发布讨论帖
还要把 Luna 的缓存写入附加费算进去:缓存写入按非缓存输入价格的 1.25 倍计费(见 OpenAI 模型页面);输入超过 272K token 的请求,整次请求都会按 2 倍输入、1.5 倍输出计费。如果你的 Agent 上下文经常超过 272K token,Luna 的实际价格大致会翻倍,而这恰好也是 V4 Pro 缓存优势最强的场景。
建模成本前,先查官方文档
调研过程中,我们发现第三方发布的两款模型数据并不一致:V4 Pro 的每百万输入 token 价格从 $0.435 到 $1.74 不等,Luna 的上下文窗口也被写成过 400K 到 1.05M 的各种版本。核查只需不到一分钟:定价只看上方链接的两份官方页面;确认模型版本字符串是否正确(当前 API 提供的是 DeepSeek-V4-Pro,Flash 固定为 -0731);再确认所谓“输入价格”指的是缓存命中还是缓存未命中。对 V4 Pro 来说,两者相差 120 倍。
决定适配场景的关键规格
除了价格,还有四项规格差异会直接影响选型:输出上限、模态能力、开放性和 API 能力。两款模型都宣称拥有约 1M 的上下文窗口(Luna 为 1,050,000 token,V4 Pro 为 1M),因此上下文本身并不能区分二者。
| 规格(核验于 2026 年 8 月 10 日) | GPT-5.6 Luna | DeepSeek V4 Pro |
|---|---|---|
| 上下文窗口 | 1,050,000 | 1M |
| 最大输出 token | 128K | 384K |
| 输入模态 | 文本 + 图片 | 仅文本 |
| 推理控制 | Effort 档位(low→max) | 思考开启(默认)/ 关闭 |
| 开放权重 | 否 | 是(可自行托管) |
| Responses API | 是 | 尚未支持(官方信息:2026 年 8 月初) |
| 并发限制 | 取决于使用层级 | 500 |
| 知识截止日期 | 2026 年 2 月 16 日 | 定价页未说明 |
V4 Pro 的 384K 输出上限是 Luna 128K 的 3 倍。这对单次生成整套代码库、长篇翻译或批量结构化提取尤其重要,因为分块处理会引入额外的失败点。Luna 的图片输入则解决了另一类问题,DeepSeek 用户也会主动提到这一短板:
我唯一真正的抱怨是它们不能处理图片,这限制了它们自主调试某些问题的能力。— Hacker News 评论者,谈及用 DeepSeek 做个人项目
开放权重则让结论倒向另一边:V4 Pro 可以下载并自行托管,因此面对数据驻留要求时,它是这里唯一的选择。不过,这种规模的模型需要严肃的多 GPU 服务硬件,不是一个周末拿单台工作站就能完成的项目。
基准成绩更受推理档位影响,而非模型本身
公开的 GPT-5.6 Luna 与 DeepSeek V4 Pro 跑分,胜负可能会随着双方使用的 Effort 档位而反转。同一对模型在某个追踪站上得到 33.3 对 44.3,V4 Pro 胜出,但该测试让 Luna 使用 low effort、V4 Pro 使用 max;在让两者都运行 max 的 Artificial Analysis 中,则是 52 对 45,Luna 胜出。两份数据都没错,测量的只是不同配置。
延迟数据也有同样的陷阱。Artificial Analysis 给出的 Luna max effort 首个回答 token 时间是 132 秒:在 max effort 下,Luna 会先思考大约两分钟再开始回答。我们的默认设置测试中,Luna 在 3–10.7 秒内完成响应。两个数字都是真实的,但只有其中一个接近你的生产配置。开始输出之后,Luna 的吞吐量明显更高:202 token/s,对比 78 token/s(Artificial Analysis)。
推理模式甚至能显著改变同一模型的单项分数:V4 Pro 在 max thinking 下的 GPQA Diamond 得分为 90.1%,关闭思考后则为 72.9%。在共同使用 max effort 的基准中,Luna 在 SWE-Bench Pro 上以 62.7% 对 55.4% 领先,两者在 BrowseComp 上接近打平(83.3 对 83.4)。在相信任何榜单前,先问三个问题:使用了什么 Effort 档位?延迟是否包含思考时间?基准版本是否一致?例如,某追踪站给出的 Terminal-Bench 84.7 对 67.9 差距,比较的是 v2.1 和 v2.0。
到底该选哪一个?
面向用户的产品,选择 GPT-5.6 Luna:在我们的默认设置测试中,它三项任务都快了 2–3 倍,非缓存输入价格约为 V4 Pro 的一半,并且支持图片输入。缓存占比高的 Agent 循环、需要超过 128K token 输出的任务,或必须部署在自有硬件上的场景,则选择 DeepSeek V4 Pro;但做长期承诺时,应把官方涨价预告纳入成本测算。通过 GPT-5.6 Luna 和 DeepSeek V4 Pro,两者只需切换一个 endpoint 就能调用,因此在正式押注前,最好先用自己的业务负载复跑这三组提示词。
| 你的工作负载 | 推荐选择 | 决定性因素 |
|---|---|---|
| 聊天机器人、面向用户的应用 | Luna | 我们的测试延迟为 3.0–10.7 秒,对比 7.6–27.2 秒;202 对 78 tok/s |
| 高量级全新输入处理 | Luna | 每 1M 非缓存输入为 $0.20,对比 $0.435 |
| 基于稳定上下文的 Agent 循环 | V4 Pro | 每 1M 缓存输入为 $0.003625,对比 $0.02 |
| 单次超长输出 | V4 Pro | 最大输出 384K,对比 128K |
| 视觉任务(截图、作为图片的 PDF) | Luna | V4 Pro 仅支持文本 |
| 自行托管 / 数据驻留 | V4 Pro | 开放权重;Luna 仅提供 API |
| 延续至 2027 年的预算确定性 | Luna | DeepSeek 官方已发布涨价通知 |
常见问题
GPT-5.6 Luna 和 DeepSeek V4 Pro 哪个更便宜?
没有绝对答案。Luna 的非缓存输入便宜 54%(每 1M token 为 $0.20,对比 $0.435);V4 Pro 的缓存输入便宜 5.5 倍($0.003625,对比 $0.02),输出也便宜 27%($0.87,对比 $1.20)。重缓存的 Agent 使用 V4 Pro 成本更低;以全新输入为主的工作负载则是 Luna 更划算。
两款模型都支持 1M token 上下文窗口吗?
是。Luna 提供 1,050,000 token,V4 Pro 提供 1M。需要注意的是,Luna 输入超过 272K token 的请求,整次请求会按 2 倍输入和 1.5 倍输出计费。
DeepSeek V4 Pro 是开源的吗?可以自行托管吗?
可以。V4 Pro 提供开放权重,可以自行托管;不同于仅提供 API 的 Luna。但应按多 GPU 推理服务来规划硬件,而不是指望单台工作站即可运行。
GPT-5.6 Luna 支持图片输入吗?
支持,Luna 接受文本和图片输入。DeepSeek V4 Pro 仅支持文本。其用户也将缺少视觉支持视为自主调试工作流中的主要限制。
两款模型的最大输出 token 分别是多少?
DeepSeek V4 Pro 单次响应最多可输出 384K token;GPT-5.6 Luna 上限为 128K。对于一次性生成长文档或大型代码文件,V4 Pro 的上限高出 3 倍。
延伸阅读
- DeepSeek V4 Pro vs GPT-5.6 Sol:同一款 DeepSeek 旗舰模型,对比 OpenAI 中端型号
- GPT-5.6 Luna 评测:跳出本次对比,从产品本身了解 Luna
- DeepSeek V4 Flash vs V4 Pro:如果 V4 Pro 的定价风险让你考虑降档