 AIREITER
DeepSeek 于 2026 年 8 月 13 日正式发布 V4 Pro GA,公布了完整基准测试成绩、采用 MIT 许可的开放权重,并加入三档推理强度。对 API 用户来说,最需要关注的是价格:官方定价页面确认,高峰/非高峰计费将于 2026 年 8 月 16 日 16:00 UTC 开始。届时,V4 Pro 输出 token 的价格将从每百万 $0.87 上涨至非高峰 $1.98、高峰 $3.96。
这次发布了什么:V4-Pro-0813、基准测试和开放权重
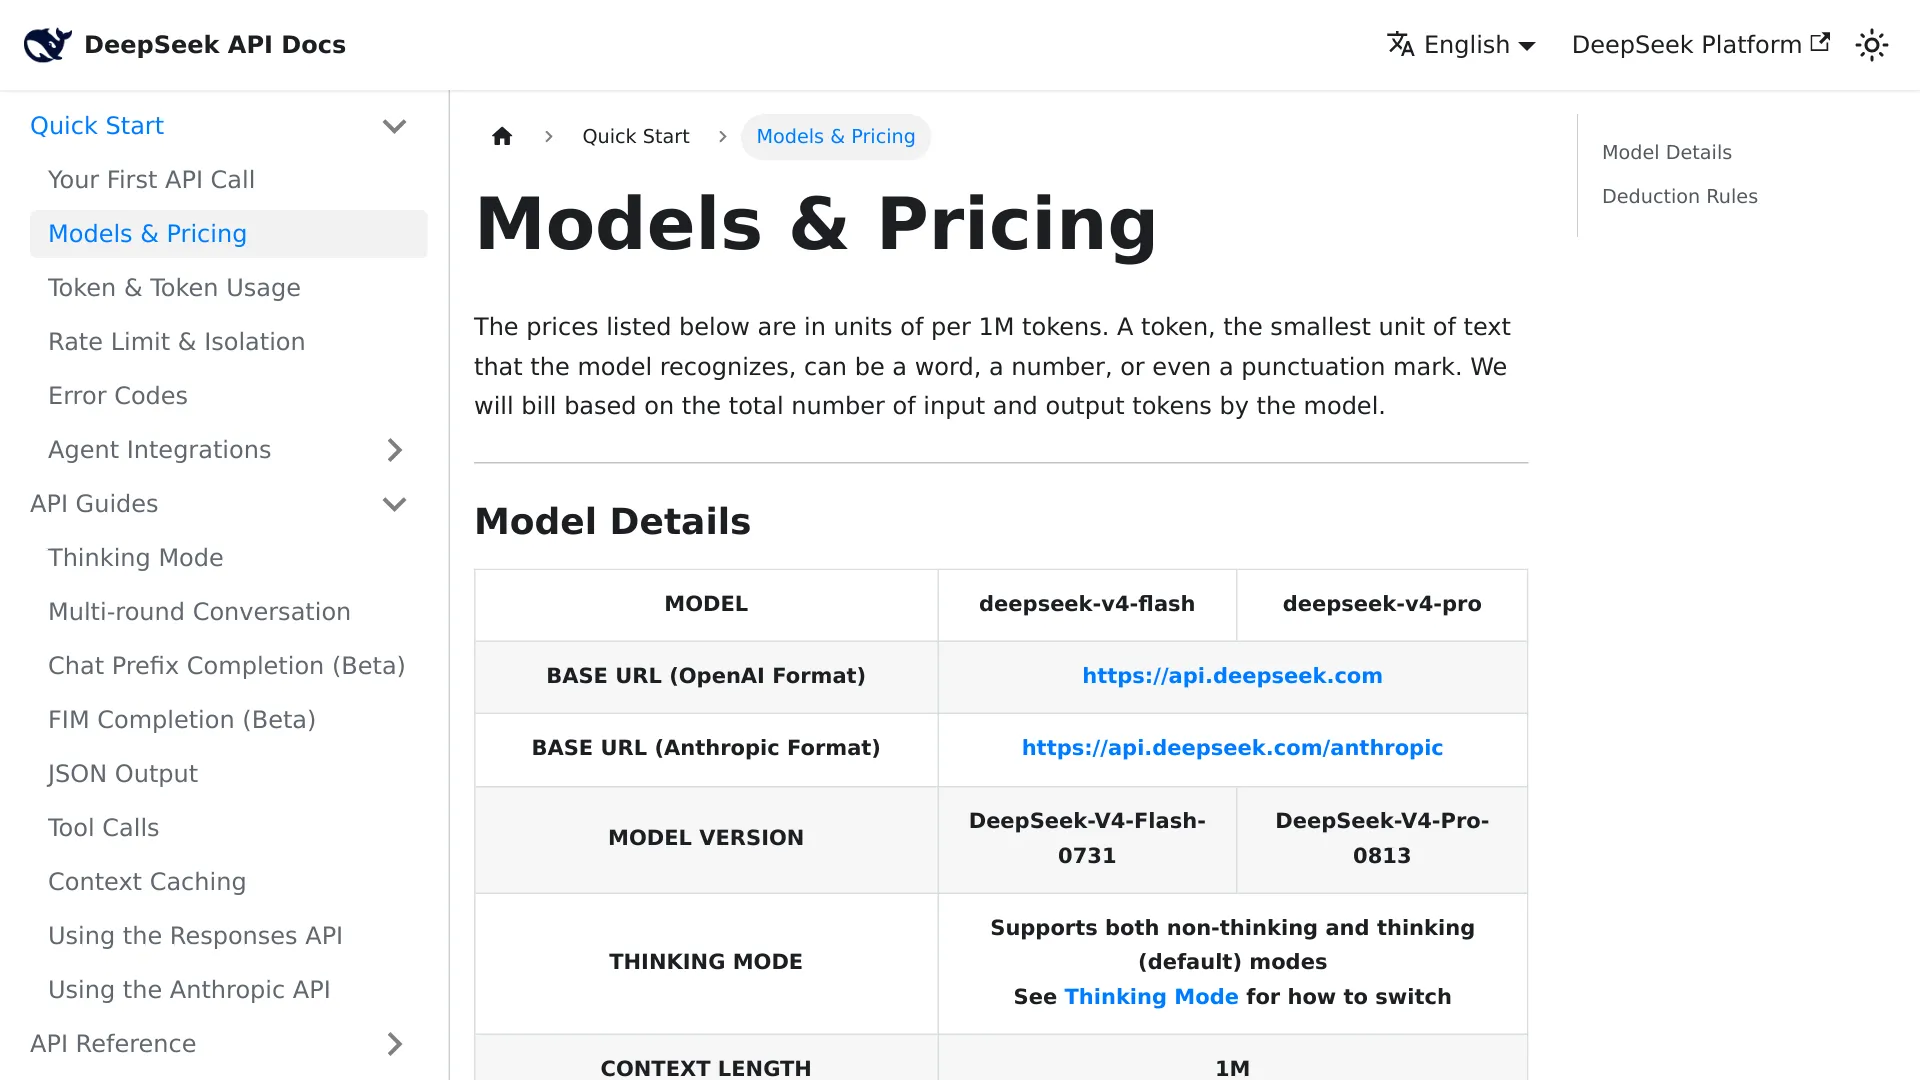
deepseek-v4-pro 这个 API 别名现在对应的是 DeepSeek-V4-Pro-0813,可通过 DeepSeek 应用、网页和 API 使用。DeepSeek 于 8 月 13 日宣布正式发布,称相比 4 月 24 日的预览版,新版本的 Agent 能力得到“显著增强”。
架构与规格:
| 项目 | DeepSeek-V4-Pro-0813 |
|---|---|
| 公布的模型规模 | 1.7T 参数(模型卡;预览版为 1.6T) |
| 上下文长度 | 100 万 token |
| 最大输出 | 384K token |
| 思考模式 | 非思考和思考(默认开启思考) |
| 推理强度 | low、high、max |
| 新增解码模块 | DSpark 投机解码(7 个投机 token) |
| API 兼容性 | OpenAI ChatCompletions、Responses API、Anthropic API、Codex |
| 并发限制 | 500 |
| 许可证 | MIT |
模型卡建议在 Agent 场景下使用 temperature = 1.0 和 top_p = 0.95;当推理强度设为 high 或 max 时,最大输出长度为 384K token。
官方 GA 基准测试成绩
DeepSeek 在模型卡中公布了 10 组基准测试对比。代码 Agent 测试使用 DeepSeek Harness minimal 模式,并将推理强度设为 max。最后两项 DSBench 是 DeepSeek 的内部测试集。以下成绩全部来自该模型卡。
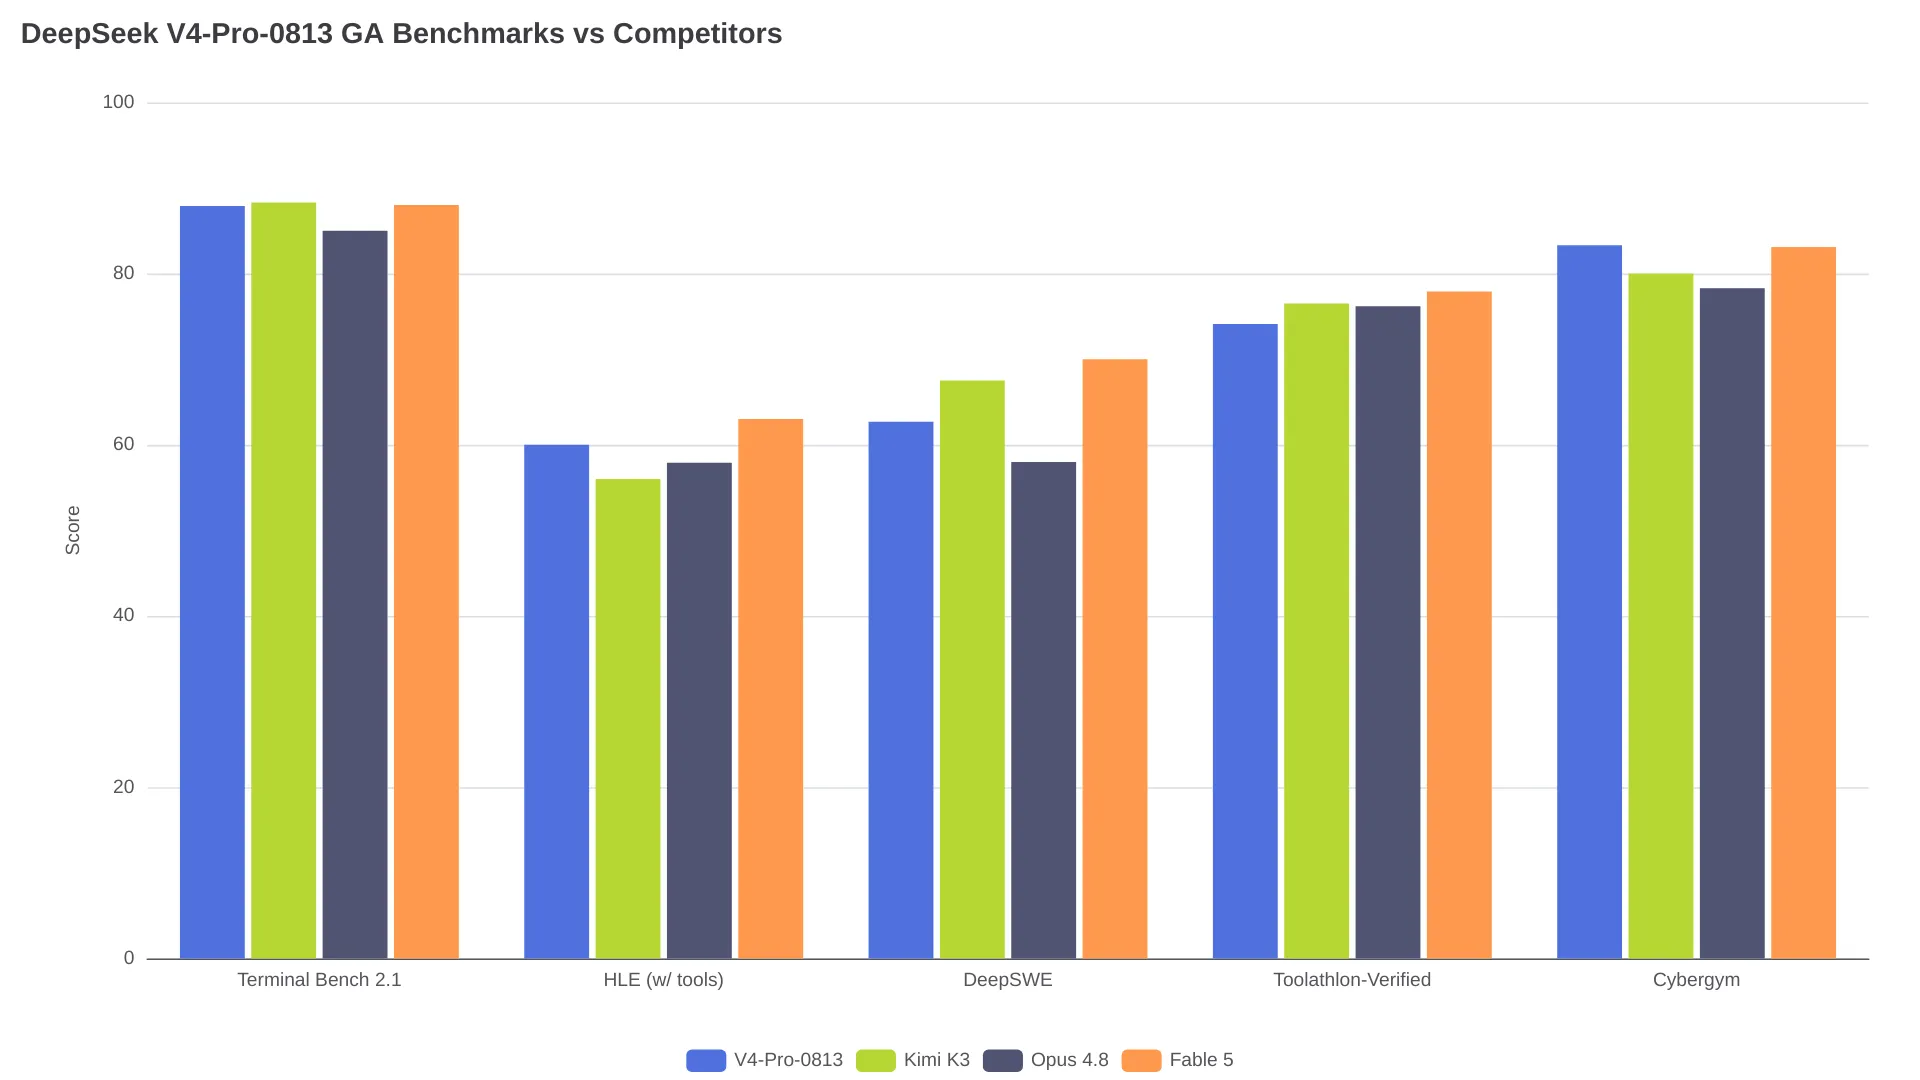
| 基准测试 | Pro-0813 | Flash-0731 | Pro Preview | Kimi K3 | Opus 4.8 | Fable 5 |
|---|---|---|---|---|---|---|
| HLE(无工具 / 使用工具) | 42.7 / 60.0 | 37.8 / 51.5 | 37.7 / 48.2 | 43.5 / 56.0 | 49.8 / 57.9 | 53.3 / 63.0 |
| Terminal Bench 2.1 | 87.9 | 82.7 | 72.1 | 88.3 | 85.0 | 88.0 |
| DeepSWE | 62.7 | 54.4 | 12.8 | 67.5 | 58.0 | 70.0 |
| Toolathlon-Verified | 74.1 | 70.3 | 55.9 | 76.5 | 76.2 | 77.9 |
| Cybergym | 83.3 | 76.7 | 52.7 | 80.0 | 78.3 | 83.1 |
| NL2Repo | 61.5 | 54.2 | 38.5 | — | 69.7 | — |
| Agents' Last Exam | 25.7 | 25.2 | 16.5 | 27.6 | 25.7 | — |
| AutomationBench(Public) | 31.8 | 25.1 | 12.8 | 30.8 | 27.2 | 29.1 |
| DSBench-FullStack(内部) | 71.1 | 68.7 | 41.8 | 73.7 | 71.6 | 77.2 |
| DSBench-Hard(内部) | 67.2 | 59.6 | 31.1 | 63.0 | 71.7 | 68.3 |
GA 版本相较预览版的提升非常明显:DeepSWE 从 12.8 提升至 62.7,AutomationBench 则从 12.8 提升至 31.8。与其他模型相比,Pro-0813 在带工具的 HLE 中领先,得分为 60.0,高于 Kimi K3 的 56.0 和 Opus 4.8 的 57.9;但在 DeepSWE、Terminal Bench 和 Toolathlon-Verified 上落后于 Kimi K3 与 Fable 5。需要注意的是,两个 DSBench 项目属于厂商内部测试,不应与独立维护的基准测试等量齐观。
开放权重
0813 权重已上传至 Hugging Face,采用 MIT 许可证,并提供 vLLM 和 SGLang 部署路径。模型卡还给出了 vLLM 服务示例,使用 DSpark 投机解码、FP8 KV cache,以及单个 4x GB300 节点。
“总体上具备与当前最强闭源模型相当的竞争力。”——DeepSeek V4-Pro 模型卡,Hugging Face
完整价格表:8 月 16 日前后分别怎么收费
定价页面同时列出了当前统一价格和将于 2026 年 8 月 16 日 16:00 UTC 生效的高峰/非高峰价格。高峰时段为01:00–04:00 UTC 和 06:00–10:00 UTC(北京时间 09:00–12:00 和 14:00–18:00),其余时间均为非高峰。非高峰价格正好是高峰价格的一半。
DeepSeek V4 Pro(DeepSeek-V4-Pro-0813)
| 计费项目 | 当前统一价格 | 非高峰(8 月 16 日起) | 高峰(8 月 16 日起) | 高峰涨幅 |
|---|---|---|---|---|
| 输入,命中缓存 | $0.003625/M | $0.022/M | $0.044/M | +1,114% |
| 输入,未命中缓存 | $0.435/M | $0.66/M | $1.32/M | +203% |
| 输出 | $0.87/M | $1.98/M | $3.96/M | +355% |
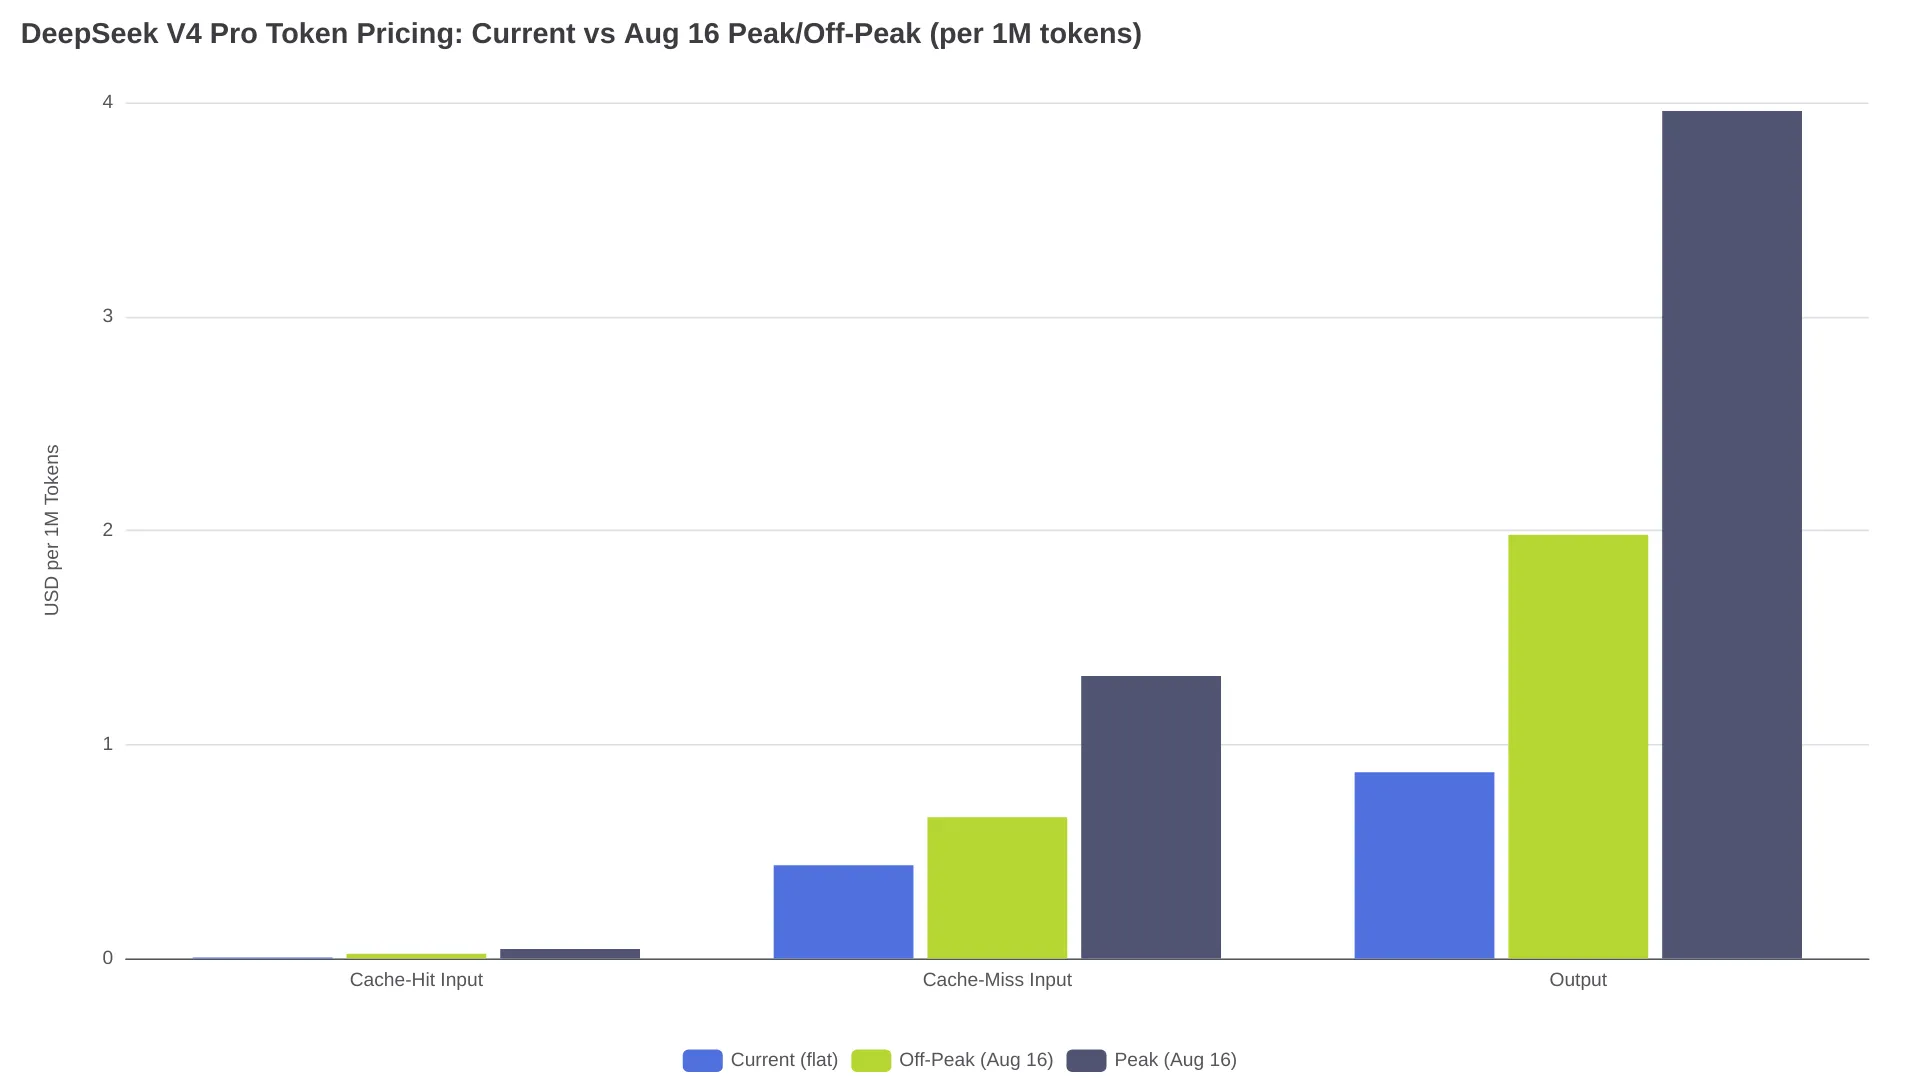
高峰时段的输出价格将上涨至原来的 4.6 倍。对生产环境中的 Agent 工作流来说,更大的变化来自缓存命中价格:此前 $0.003625/M 的价格大约只有未命中缓存价格的 1/120;8 月 16 日后,无论哪个时段,两者的价差比例都会降至 30 倍(非高峰为 0.022 对 0.66,高峰为 0.044 对 1.32),而缓存命中的绝对成本将上涨 6 到 12 倍。
DeepSeek V4 Flash(DeepSeek-V4-Flash-0731)
| 计费项目 | 当前统一价格 | 非高峰(8 月 16 日起) | 高峰(8 月 16 日起) | 高峰涨幅 |
|---|---|---|---|---|
| 输入,命中缓存 | $0.0028/M | $0.007/M | $0.014/M | +400% |
| 输入,未命中缓存 | $0.14/M | $0.22/M | $0.44/M | +214% |
| 输出 | $0.28/M | $0.66/M | $1.32/M | +371% |
并发限制为:2,500 个并发请求,是 Pro 配额的 5 倍。
不同时区的高峰时段
| 时区 | 高峰时段 1 | 高峰时段 2 |
|---|---|---|
| 北京时间(UTC+8) | 09:00–12:00 | 14:00–18:00 |
| 伦敦(UTC+1) | 02:00–05:00 | 07:00–11:00 |
| 纽约(UTC-4) | 21:00–00:00(前一天) | 02:00–06:00 |
| 旧金山(UTC-7) | 18:00–21:00 | 23:00–03:00 |
对美国团队来说,高峰时段主要落在夜间和晚间;而对中国及东亚地区的团队来说,高峰时段基本覆盖正常工作时间。
实际要花多少钱:每天 10,000 次调用的 Pro 成本
假设一个生产环境 Agent 每次调用都发送 50K token 的缓存前缀,并生成 2K token 的响应。
| 成本项目 | 当前统一价格 | 非高峰 | 高峰 |
|---|---|---|---|
| 缓存命中输入(500M token) | $1.81 | $11.00 | $22.00 |
| 输出(20M token) | $17.40 | $39.60 | $79.20 |
| 每日合计 | $19.21 | $50.60 | $101.20 |
| 30 天合计 | $576 | $1,518 | $3,036 |
真实工作负载通常会混合高峰和非高峰调用,因此最终成本会落在上述区间内。同样的工作负载如果使用 Flash,当前统一价格下每天为 $7.00,非高峰约为 $16.70,高峰约为 $33.40。Flash 高峰价格(每天 $33.40)高于 Pro 当前统一价格(每天 $19.21),但 Flash 非高峰价格(每天 $16.70)更低。
迁移要点:模型 ID、推理控制与版本固定
旧端点退役与替换 ID
4 月 24 日的预览版公告称,deepseek-chat 和 deepseek-reasoner 将于“2026 年 7 月 24 日 15:59(UTC 时间)之后完全退役且无法访问”。代码中仍引用这些字符串的项目需要及时更新。
| 旧端点 | 实际路由 | 替换方案 |
|---|---|---|
deepseek-chat | V4 Flash,非思考模式 | deepseek-v4-flash |
deepseek-reasoner | V4 Flash,思考模式 | deepseek-v4-flash(思考模式)或 deepseek-v4-pro |
不少团队以为 deepseek-reasoner 提供的是 Pro 级推理能力,实际上它路由到的是思考模式下的 Flash。迁移至 deepseek-v4-pro 后,输出质量会发生变化,费用也会更高。
// Before (retired — fails)
{"model": "deepseek-reasoner", "messages": [...]}

// After
{"model": "deepseek-v4-pro", "messages": [...]}
基础 URL 仍为 https://api.deepseek.com,其他请求结构无需调整。
推理强度怎么选
V4-Pro-0813 提供三档推理强度:简单任务使用 low,日常 Agent 工作使用 high,复杂问题使用 max。思考模式默认开启,思考 token 也会计入输出费用。比如一个提示词触发了 3,000 个思考 token,之后生成 200 个回答 token,那么在高峰价格下,计费量就是 3,200 个输出 token,每次调用费用为 $0.0127;如果只计算 200 个回答 token,则为 $0.0008。对于不需要长链路思考的简单任务,DeepSeek 指定使用 low,避免付出额外成本却没有获得相应价值。
固定模型版本
deepseek-v4-pro 这个别名指向当前版本,未来 DeepSeek 发布新版本时可能随之更新。要保证生产环境行为可复现,应确认服务商是否支持带日期的模型 ID。部分第三方网关提供固定版本路由,但在用于生产前,务必从服务商文档中确认每条路由实际提供的版本。
API 协议兼容性
两款模型都支持 OpenAI ChatCompletions 和 Anthropic API 格式。Anthropic 端点为 https://api.deepseek.com/anthropic。Responses API 和 Codex 兼容性是 GA 版本新增的能力。如果迁移后遇到错误,建议分别测试两种协议路径。
涨价之后选 Pro 还是 Flash?
V4-Pro-0813 在公布的 10 项指标上全部超过 V4-Flash-0731,但领先幅度会随任务复杂度而变化:
| 基准测试 | Pro 0813 | Flash 0731 | 差距 |
|---|---|---|---|
| Terminal Bench 2.1 | 87.9 | 82.7 | 5.2 分 |
| DeepSWE | 62.7 | 54.4 | 8.3 分 |
| AutomationBench | 31.8 | 25.1 | 6.7 分 |
| Cybergym | 83.3 | 76.7 | 6.6 分 |
适合选择 V4 Pro 的情况:
- Agent 循环会反复发送稳定且较大的前缀。虽然基础价格上调,缓存命中仍能节省成本
- 需要更大参数规模来处理复杂推理、多步工具调用或大规模代码生成
- 工作负载可以接受 500 个并发请求的限制
适合选择 V4 Flash 的情况:
- 任务简单、调用量大,或对延迟敏感
- 扇出型工作负载需要 2,500 个并发请求的限制
- 模型质量差异不足以抵消高出 3 倍的输出价格
如果想看更完整的模型对比,可以阅读我们的 DeepSeek V4 Flash vs Pro 对比。不想管理 API key、只想直接试用模型,则可以访问 V4 Pro 聊天页面或 V4 Flash 聊天页面。
常见问题
V4-Pro-0813 的权重可以自行部署吗?
可以。权重采用 MIT 许可证,已发布在 Hugging Face,并提供 vLLM 和 SGLang 部署路径(部署细节请参阅上文“开放权重”部分)。
GA 版本发布后,应该从 V4 Flash 切换到 V4 Pro 吗?
对大多数注重成本的工作负载来说,Flash 仍然更划算。在各项基准测试中,Flash 落后 Pro 的幅度从 0.5 分(Agents' Last Exam)到 8.5 分(带工具的 HLE)不等,而输出价格低 3 倍。如果工作负载需要完整参数规模来完成复杂的多步推理或大规模代码生成,再考虑切换到 Pro。
如何降低涨价带来的影响?
可以从三个方面入手:将批处理任务和可延迟的 Agent 调度到非高峰时段(01:00–04:00 和 06:00–10:00 UTC);保持提示词前缀稳定,尽可能提高缓存命中率;将简单任务路由到 Flash,或在 Pro 上使用 low 推理强度。
高峰/非高峰价格也适用于 DeepSeek 应用和网站吗?
官方定价页面只说明了 API token 计费。页面列出的时间表适用于直接 API 调用;网关服务商可能会直接转嫁这套价格、加收溢价,或采用单独的费率。当前详情请以定价页面为准。