 AIREITER
从 2026 年 8 月 20 日起,Anthropic 的 Claude Skills API、computer use 和 Files API 全部结束 Beta、进入正式可用阶段。Beta 请求头不再需要,computer use 一次模型调用可连续执行多项操作,还新增了 browser use 工具。不过,GA 并没有解决一个关键问题:Skill 是否执行,依然由 Claude 自己判断。因此,版本锁定和激活机制的设计,仍然需要开发者负责。
8 月 20 日 GA 到底更新了什么
如果你此前已经接入 Beta,现有集成在迁移期间仍可继续使用。根据 Anthropic 的发布文章,这次上线带来了几项实质性调整:
- 不必再处理 Beta 请求头。当前Skills 指南只列出两个前提:拥有 Claude API key,并在请求中启用 code execution。过去教程里要求的 Beta headers,已经从文档中移除。
- 单轮可执行多项操作。更新后的 computer use 工具可在一次模型调用中连续完成点击、输入、按键和截图,不再局限于每次一个动作。Anthropic 的 @ClaudeDevs 表示,早期访问客户的单项任务往返次数减少了20–40%。
- 新增 browser use 工具。它会结合截图和页面结构定位元素,让 Agent 按具体字段或按钮操作,而不是依赖像素坐标,适合保险申报等网页门户场景。
- Files API 容量与限流提升。每个组织可使用 1 TB 存储空间,速率限制提高到原来的 5 倍。根据 @ClaudeDevs 的讨论串,达到 500 RPM;文件还支持自动过期。
- 合规覆盖范围扩大。computer use 现在可在 Anthropic BAA 下用于受 HIPAA 监管的工作负载。
- 云平台支持扩展。Skills API 和 Files API 也已通过 Microsoft Foundry 上线。更新后的 computer use 与 browser use 工具则标注为即将登陆 Vertex AI,但尚未公布日期。
三个 API 如何串成一条工作流
Anthropic 用理赔 Agent 展示了完整流程:先通过 Files API 按文件 ID 获取受理材料,再由 Skills API 套用申报流程,接着利用 browser use 填写保险公司的门户网站,最后把确认结果重新保存为文件。文件只需上传一次,后续请求引用 file_id 即可,不必每次都重新传输。
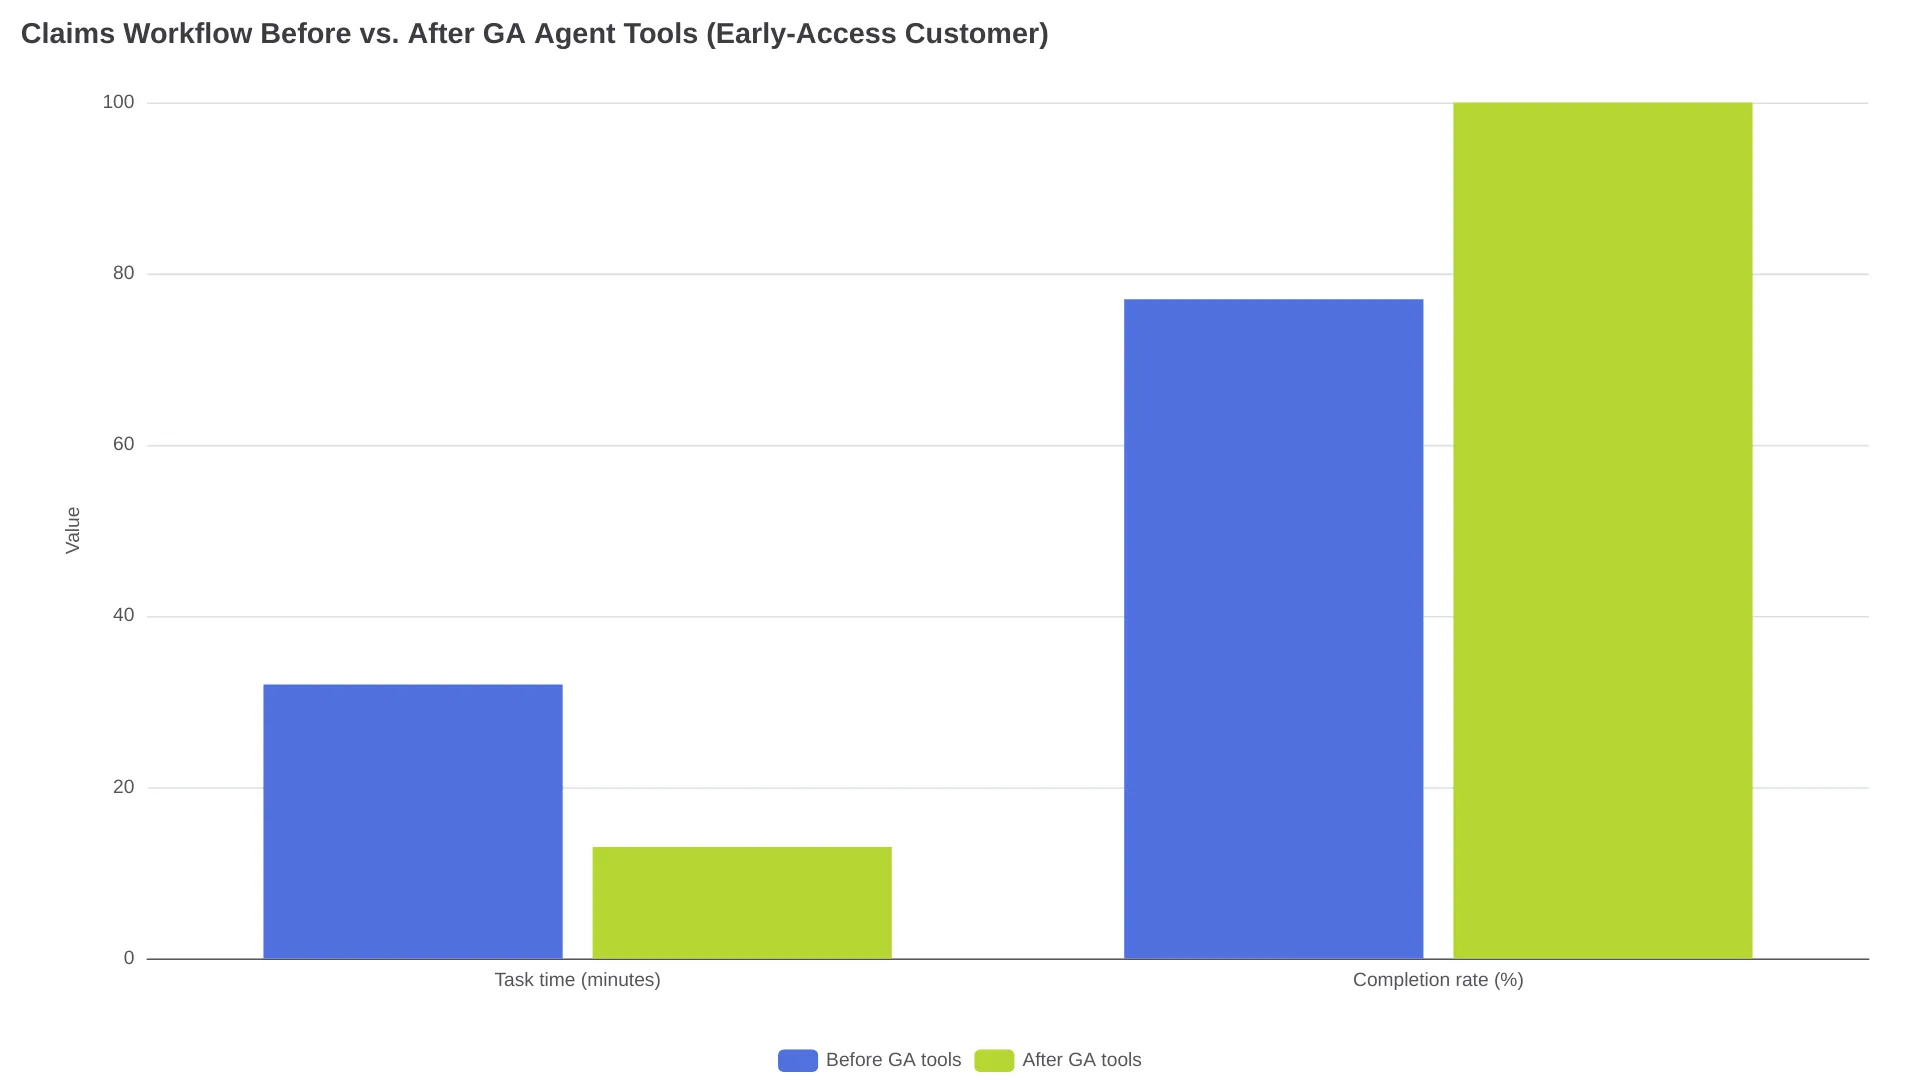
本次发布带来的两组效果数据均来自供应商侧。在发布文章中,研究工程师 Davide Locatelli 表示,耗时最长的理赔流程从 32 分钟缩短至 13 分钟,完成率达到 100%。此外,Asteroid 联合创始人 David Mlčoch 在早期访问阶段测试了医疗健康领域的 computer-use 流程:
“模型调用减少 32-52%,单项任务成本降低 25-32%,所有工作流的完成率均达到 100%,此前为 77%。”—— @MlcochDavid
如何在 Messages API 中调用 Claude Skills API
给请求挂载 Skill,只需要添加一个参数:在 Messages API 请求中加入 container 对象,并在其中提供 skills 数组。数组中的每项包含 type(anthropic 或 custom)、skill_id,以及可选的 version。
根据官方 Skills 指南,围绕这个参数还需要注意以下机制:
- 必须启用 code execution,且模型需要支持该能力。指南示例使用
claude-opus-5、code_execution_20250825工具类型和max_tokens=4096。 - 单个请求最多可附带 20 个 Skill。
- Skill 在 Anthropic 的 code-execution sandbox 中运行:没有网络访问权限,不能在运行时安装软件包。除非跨轮次复用返回的
container.id,否则每个请求都会创建新的容器;每次响应均会包含expires_at。 - Skill 文件不需要自行托管,Anthropic 会在容器中执行它们。
response = client.messages.create(
    model="claude-opus-5",
    max_tokens=4096,
    tools=[{"type": "code_execution_20250825"}],
    container={
        "skills": [
            {"type": "anthropic", "skill_id": "xlsx", "version": "20251013"},
            {"type": "custom", "skill_id": "skill_01...", "version": "skver_01..."},
        ]
    },
    messages=[{"role": "user", "content": "Build the Q3 revenue summary"}],
)
输入文档的路径则相反:先通过 Files API 上传,再在 container 的 upload 区块中引用。请求本身仍是标准的 Anthropic Messages API 格式,因此既可使用直连 key,也可接入 Anthropic 兼容中转服务,例如 AIReiter's Claude API。
内置 Skill 使用简短易读的 ID,例如 pptx、xlsx、docx、pdf;版本号可使用类似 20251013 的日期格式,或 latest。自定义 Skill 则会获得以 skill_01... 开头、限定在工作区范围内的 ID。
发布自定义 Skill:最容易被规则拦下的地方
自定义 Skill 本质上是一个目录,根目录中的 SKILL.md 需要包含 YAML frontmatter,即 name 和 description;同级目录中还可以放置脚本和参考文件。一个可用的最小文件大致如下:
---
name: eu-claims-filing
description: Use when filing or amending EU insurance claims. Loads the
  carrier-specific submission procedure, required fields, and rejection
  codes before filling any portal form.
---

# EU claims filing procedure
1. Pull the intake document by file_id ...
上传时可以提交 ZIP 压缩包,也可以逐个上传文件,Python SDK 提供了 files_from_dir。不过,在 Skill 真正运行之前,Anthropic 就会按Skills 指南执行以下硬性校验:
| 规则 | 限制 |
|---|---|
name | ≤64 个字符;仅允许小写字母、数字和连字符;anthropic 与 claude 为保留字 |
description | 1–1,024 个字符,不能为空,不允许 XML 标签 |
display_name(可选) | ≤255 个字符 |
| 包体大小 | 解压后小于 30 MB |
| 每次请求的 Skill 数量 | 20 |
| 每个组织的工作区数量 | 默认 100 个 |
同一份指南指出,管理操作可通过 ant CLI 或其背后的 API endpoint 完成。从文件到固定版本的流程如下:
ant skills create ./eu-claims-filing   # returns skill_01...
ant skills:versions create skill_01... # returns skver_01... — pin this in production团队第一次使用时,通常会被两个行为打个措手不及:新版本是完整快照,必须重新上传整套文件,未重新上传的文件不会自动保留;而删除一个 Skill,会同时删除它的所有版本。
上线前检查清单:锁版本、隔离工作区、稳定缓存
生产环境最常见的坑集中在可变版本、工作区级权限和缓存失效上。Skills 指南对这三点都有明确说明。
- 固定版本号。如果使用
latest,或完全不填版本号,那么任何拥有工作区访问权限的人上传新版本后,已部署 Agent 的执行内容会立即变化。生产环境应固定使用skver_...ID,latest留给持续开发阶段。 - 将工作区视为租户边界。同一工作区内的每个 API key,都可以读取、调用和删除其中所有自定义 Skill。隔离边界是工作区,而不是用户或会话。多租户应用应为每个租户使用一个工作区,同时要留意默认只有 100 个工作区的上限。
- 保持 Skill 列表稳定以利用缓存。修改 Skill 列表,包括改变顺序,都会改变 system prompt 前缀并导致 prompt cache 失效。固定自定义版本同样能保护此前缀,因为重新上传的
latest版本若更新了 description,前缀也会被改写。按 token 计费时,请求之间不断变化的 Skill 列表,会悄悄吃掉缓存命中带来的成本节省。 - 处理
pause_turn。运行时间较长的 Skill 会返回stop_reason: "pause_turn"。要继续执行,需要在后续请求中重新发送返回的 content;也可以修改对话以中断流程。 - 明确数据保留策略。Agent Skills 不适用于零数据保留安排。Skill 定义和执行数据遵循 Anthropic 的标准数据保留政策。启用 Compliance API 后,Activity Feed 会记录 Skill 及 Skill 版本的创建和删除操作,但仅记录从启用后开始的事件。
- 捕获正确的异常。调用时应处理
anthropic.BadRequestError,并把 Skill 相关失败与其他无效请求错误区分开来。 - 不要挂载闲置 Skill。文档对此说得很直接:附带未使用的 Skill 会影响性能。
GA 也无法替你解决的 Skill 激活问题
GA 升级的是 Skill 周边基础设施,不是 Claude 选择 Skill 的逻辑。用户讨论中反复出现的疑问是:Skill 更像由条件触发的流程,而不是另一层始终生效的 system prompt。
“我对 Claude Skills 的问题在于,它们并不是真正的技能。没有任何东西强制 Claude 一定要使用它们。Claude 会按自己的想法做事……它们只是 md 文件。”—— @Yampeleg,发表于 GA 前;调用机制至今未变
关于 Skill 是否真的有效的 r/ClaudeAI 讨论串,总结出了几条实操方向:
“userstyle 会在每一轮前置加入,但 Skill 只有在 Claude 根据 description 判断需要调用时才会触发。”—— u/samxu01
“Skill 必须有简洁、清晰的 metadata description,并且聚焦于 Claude 正在执行的动作。”—— u/Chadum
从这些讨论中,可以归纳出四条规则:
- description 应围绕触发短语和具体动作来写,而不是定义某种人格。
- 把步骤、检查项、规则和工具选择写进正文。u/MartinMystikJonas 的测试标准是:“如果 Skill 定义了 Agent 应执行的步骤、应检查的内容、应遵循的规则和应使用的工具,那么它就是有用的。”
- 根据 u/Actual_Committee4670 的建议,应将 Claude 原生表现不佳的事项编码进 Skill。
- 必须始终生效的要求,应写入 system prompt 或 CLAUDE.md——正如上文 u/samxu01 所说,它们会在每一轮前置加入;Hook 则更适合提交前等生命周期节点。
常见问题速览
Skills API 还需要 Beta headers 吗?
不需要。自 2026 年 8 月 20 日 GA 以来,前提条件是 Claude API key 和已启用的 code execution,当前文档中没有 Beta header 要求。
Skill 会占用我的上下文窗口吗?
一开始只会占用其 metadata。根据Skills 指南,Claude 会先获取每个 Skill 的 frontmatter,将文件复制到容器中,只有任务需要时才加载完整指令。这也是文档警告不要附带未使用 Skill 的原因。
Skill 和 MCP 有什么区别?
Skill 是一组在 Claude 沙箱中运行的指令和脚本,不具备网络访问能力;MCP 则负责将 Claude 接入实时的外部系统。这是 Anthropic 在其Skills 概览中给出的区分。理赔工作流可以同时使用两者:MCP server 连接保单数据库,Skill 则承载申报流程。
同一个 SKILL.md 能在 Claude.ai、Claude Code 和 API 中运行吗?
SKILL.md 格式是通用的,但不同产品入口的交付方式不同:API 使用上传到工作区的 Skill;Claude Code 使用 .claude/skills 目录;Claude.ai app 则按套餐级别提供上传能力。
Skills API 支持零数据保留吗?
不支持。Agent Skills 被排除在零数据保留安排之外,Skill 定义和执行数据遵循标准数据保留政策。
不同需求该选哪种机制
关键在于它应该在什么时机被调用:
| 需求 | 适用机制 |
|---|---|
| 在特定任务触发时执行的专业流程,例如“提交理赔时遵循这些步骤” | Skill |
| 每一轮对话都必须遵守的规则 | System prompt(API)/ CLAUDE.md(Claude Code) |
| 生命周期中的某个节点要执行的动作,例如工具运行后、提交前 | Hook |
| 连接实时外部系统 | MCP server |
| 一次性的任务要求 | 普通 prompt |
8 月 20 日让 Skill 机制具备了生产可用性,但并没有让上表中的各种机制变得可以互相替代。
延伸阅读:Claude API 各模型和 token 的价格,以及在 Claude Code 中录制 Claude skill。