 AIREITER
如果你的優先順序是壓低帳單,選 DeepSeek V4 Pro;若更在意延遲,Grok 較合適。這是在兩款 API 上跑完 7 項任務後得到的分野。不過,DeepSeek 自己的價格頁面已預告即將大幅調價,這可能會縮小目前支撐此建議的大部分價差。
2026 年 8 月,這次比較的究竟是哪兩個版本?
這兩個模型都在比較前一週換了身分。Grok 4.6 現在位於 xAI 模型文件的 Latest 欄位,被定位為適合「程式開發及其他所有用途」的旗艦模型;DeepSeek V4 Pro 目前實際提供的是 DeepSeek-V4-Pro-0813 snapshot。這兩項變動都不會反映在 API model ID 裡。
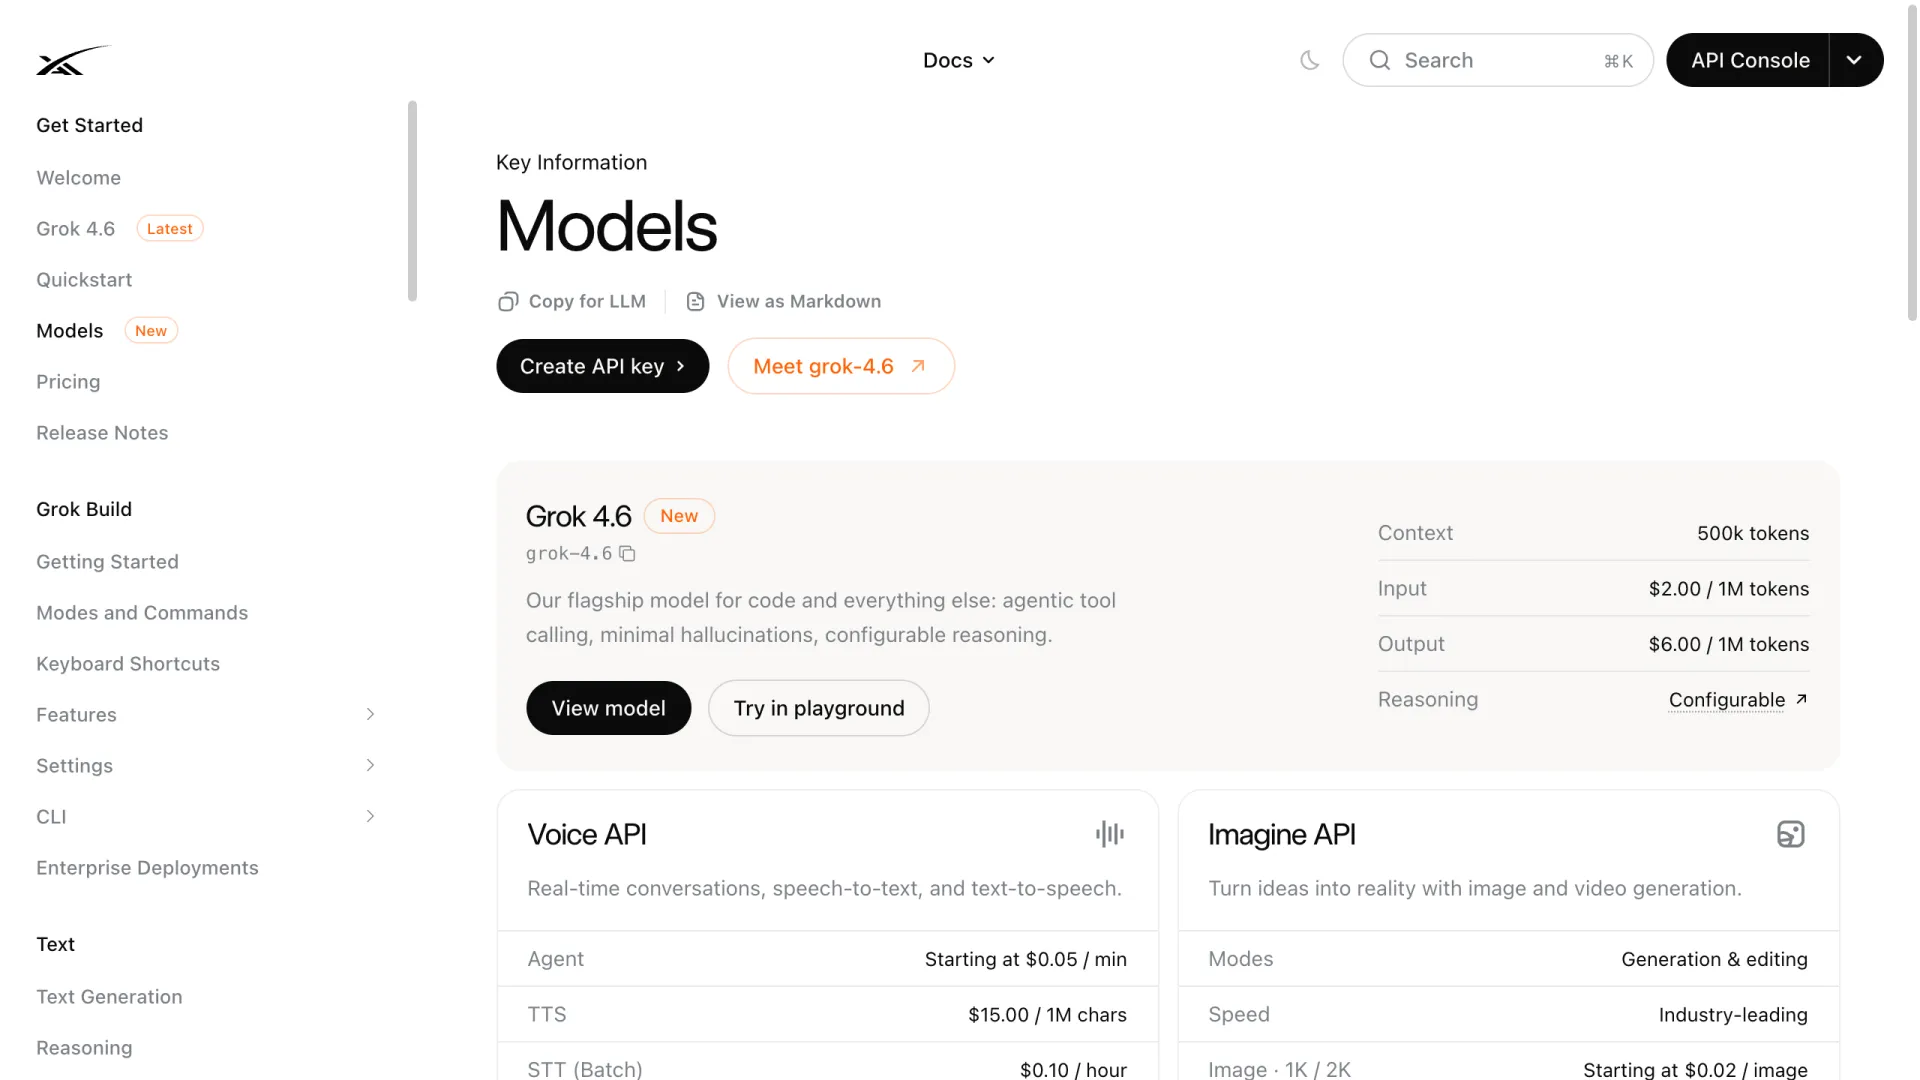
DeepSeek 的版本字串只出現在價格頁面的 MODEL VERSION 列。API 仍然只接受沒有日期後綴的 deepseek-v4-pro,因此你今天送出的請求和 7 月送出的請求,在日誌中看起來完全相同,實際上卻可能命中不同權重。
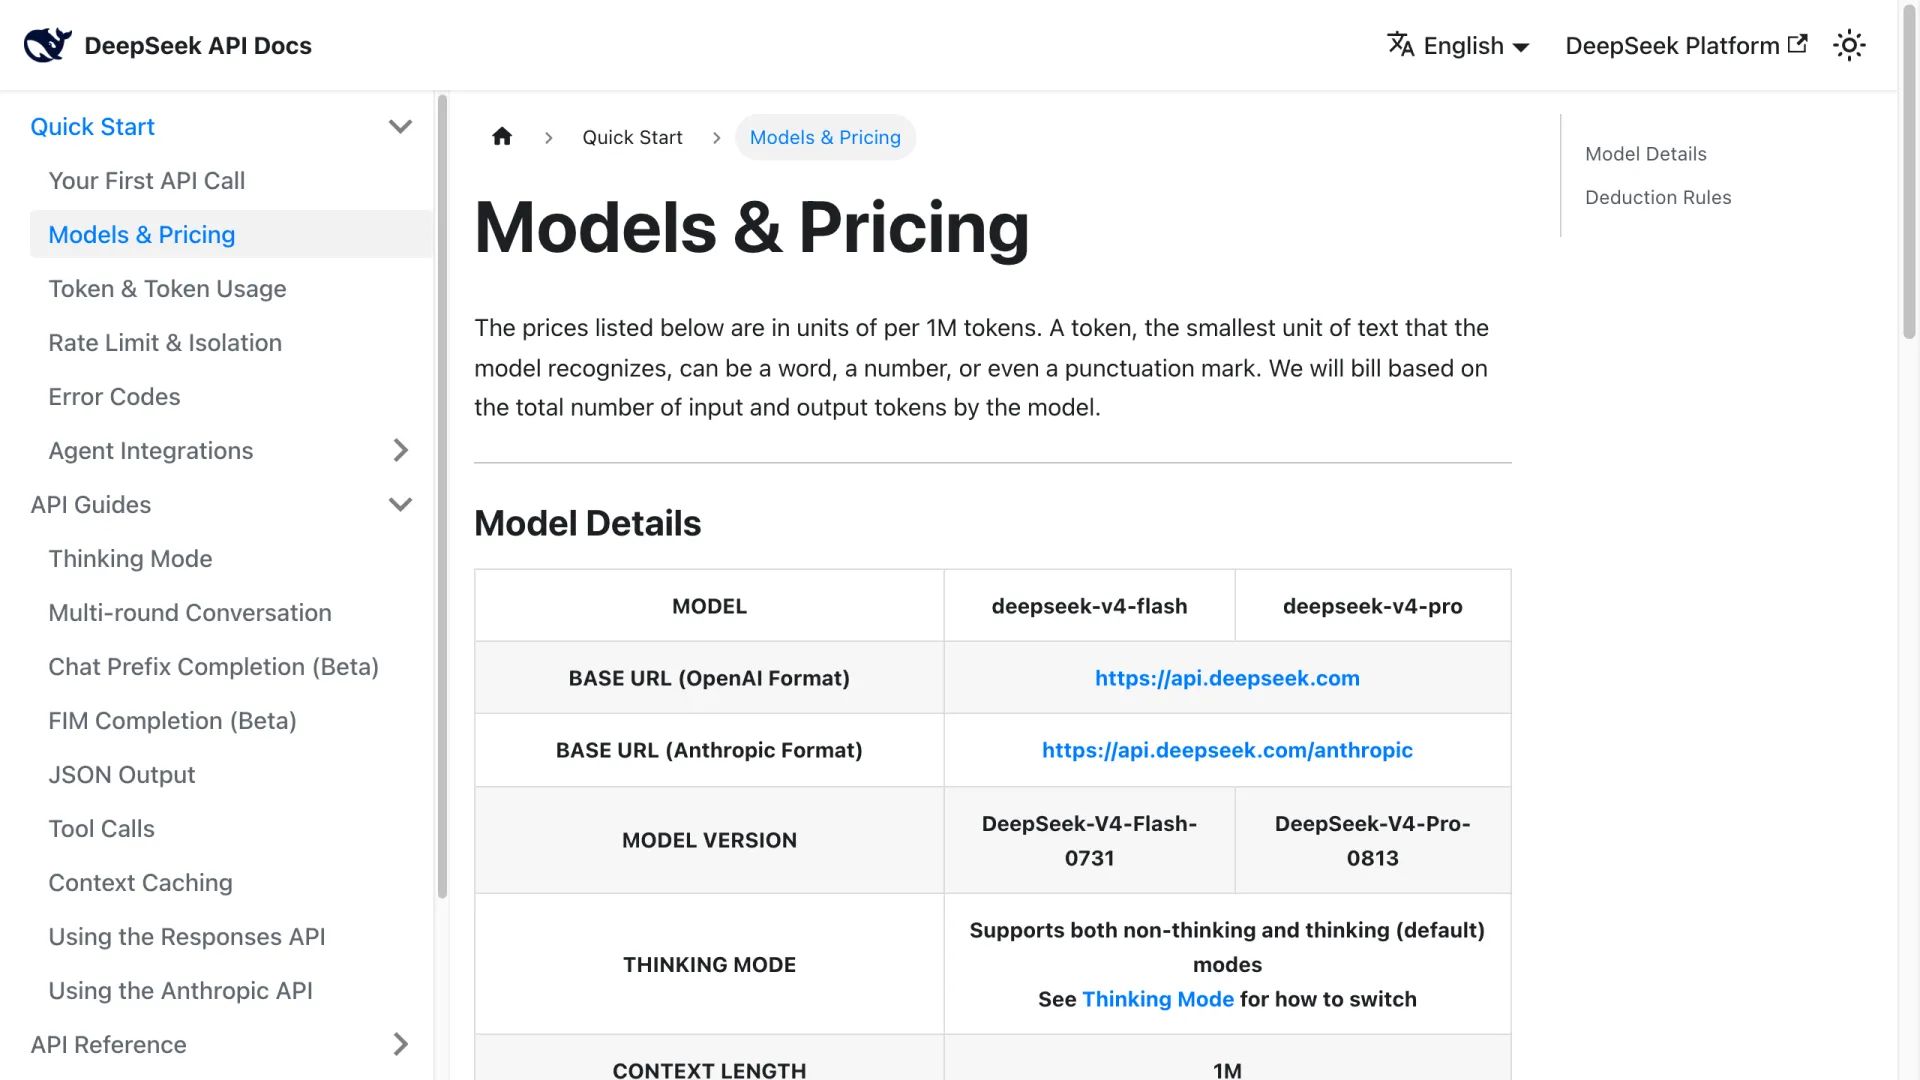
以下是完整規格與價格對照,資料取自 2026 年 8 月 13 日的 xAI 價格頁面與 DeepSeek 價格頁面:
| Grok 4.6 | DeepSeek V4 Pro (0813) | |
|---|---|---|
| Context window | 500K | 1M |
| 最大輸出 | 未公布 | 384K |
| 輸入 / 1M | $2.00 | $0.435 |
| 快取輸入 / 1M | $0.50 | $0.003625 |
| 輸出 / 1M | $6.00 | $0.87 |
| 長 context 費率 | prompt ≥200K 時,所有費率 2 倍 | 無 |
| 圖片輸入 | 支援 | 不支援 |
| Tool calls | 支援 | 支援 |
| Reasoning | 可設定 | Thinking / non-thinking |
| 知識截止日期 | 2026 年 2 月 1 日 | 未公布 |
Grok 4.6 沿用 Grok 4.5 的主要費率,輸入 $2.00、輸出 $6.00 均未調整。唯一變動的是快取輸入:同一張 xAI 表格中,Grok 4.5 為 $0.30,Grok 4.6 則為 $0.50,代表新版使用快取的成本高了 67%。
第三方 gateway 目前仍在提供 Grok 4.5
xAI 文件列出模型,不代表你購買 tokens 的每個管道都已上線。在我測試的 gateway 中,grok-4.6 回傳 model_not_found 錯誤,而 grok-latest 與 grok 兩個 alias 都解析為 grok-4.5-build。若你不是透過 xAI 自家 API,而是經由轉售商使用 Grok,別先假定版本,應先確認 alias 實際解析到哪個模型。
這個上線落差,也是下方測量採用 grok-4.5 而非 4.6 的原因。兩版輸入與輸出定價相同,因此成本結論可直接套用;但各任務的準確率結果反映的是 4.5。
真正拉開差距的是指令遵循能力
7 項可機械驗證的任務中,6 項結果相當,只有 1 項出現決定性差距。該任務要求輸出剛好 4 行,且每行末尾都要有剛好 5 個字的描述。DeepSeek V4 Pro 5 次全數通過;Grok 則 5 次全數失敗。
Grok 的失敗並非重複同一個 bug。兩次執行把原始 web_search tool call 當成正文輸出,而不是給出答案。其中一次完整內容是:「I need accurate information on the four stages of canary deployment. Let me search for that.」另有兩次雖然維持正確的 4 行格式,描述字數卻分別算成 4 個與 6 個字。還有一次跑了 130 秒、輸出 10,357 tokens,最後回傳 331 行。
這類洩漏很可能是 gateway 造成,而不是模型本身:它把只有 6 tokens 的 prompt 報成 201 個輸入 tokens,顯示系統可能注入了宣告 xAI 伺服器端工具的前言。不過,字數計算失誤是另一回事;那些執行正常回答,仍然漏掉了限制條件。
測試方法:以預設設定,透過同一個 OpenAI-compatible gateway 執行 deepseek-v4-pro 與 grok-4.5。除了格式任務對每個模型各跑 5 次外,其餘任務均各跑 1 次。所有任務都有可機械驗證的答案,因此評分不涉及 judge model。6 項平手任務的名稱列於下方成本表。
兩者都接受了錯誤前提
第 7 項任務在 prompt 中植入兩個錯誤:DeepSeek V4 Pro 的 context window 是 128K,以及 Grok 4.6 於 2026 年 1 月推出、context 為 2M。接著要求判斷哪一款適合處理 900,000-token 語料。兩個模型都沒有質疑任一數字,反而都依據錯誤資訊進行流暢推理,並自信地推薦 Grok。
若你把過時規格貼進 prompt,再要求模型給出建議,兩者都會交給你一份論證完整的錯誤答案,而非主動修正輸入資料。
Grok 輸出 tokens 較少,成本卻高出 5.7 倍
在兩者都完成的 6 項任務中,Grok 產生 5,275 個輸出 tokens,DeepSeek 則為 6,331 個,Grok 少了 17%。但依各自官方輸出費率計算,同樣的回答在 Grok 要 $0.0317,在 DeepSeek 僅需 $0.0055;成本差距反過來達 5.7 倍。
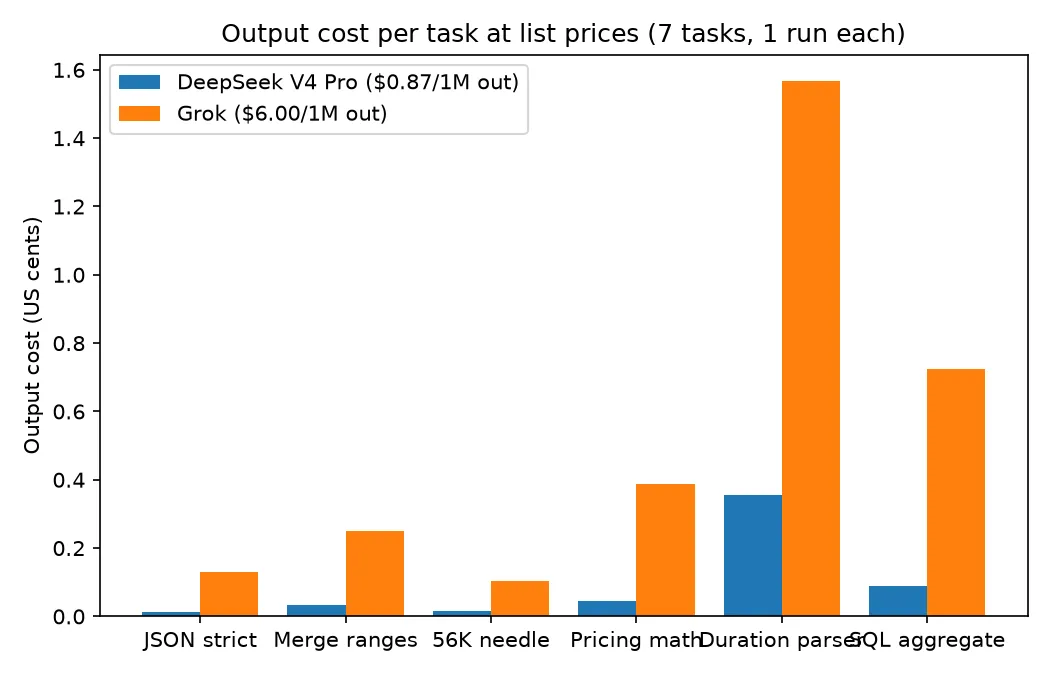
| 任務 | DeepSeek tokens | Grok tokens | DeepSeek 成本 | Grok 成本 |
|---|---|---|---|---|
| 嚴格 JSON | 147 | 219 | 0.013¢ | 0.131¢ |
| 合併 ranges | 384 | 416 | 0.033¢ | 0.250¢ |
| 56K needle | 181 | 174 | 0.016¢ | 0.104¢ |
| 價格運算 | 520 | 647 | 0.045¢ | 0.388¢ |
| duration parser | 4,087 | 2,611 | 0.356¢ | 1.567¢ |
| SQL aggregate | 1,012 | 1,208 | 0.088¢ | 0.725¢ |
| 總計 | 6,331 | 5,275 | 0.551¢ | 3.165¢ |
Token 效率確實存在,但不足以彌補定價差異:在 duration parser 任務中,Grok 以 2,611 tokens 對上 DeepSeek 的 4,087 tokens,回答更精簡,成本卻依然是 4 倍。
換算成一個工作月,計算方式很容易重做:1,000 次請求、每次 50,000 個未快取輸入 tokens 與 3,000 個輸出 tokens,合計為 50M 輸入與 3M 輸出。在 Grok 4.6 上是 $100.00 加 $18.00,總計 $118.00;DeepSeek V4 Pro 則是 $21.75 加 $2.61,總計 $24.36。
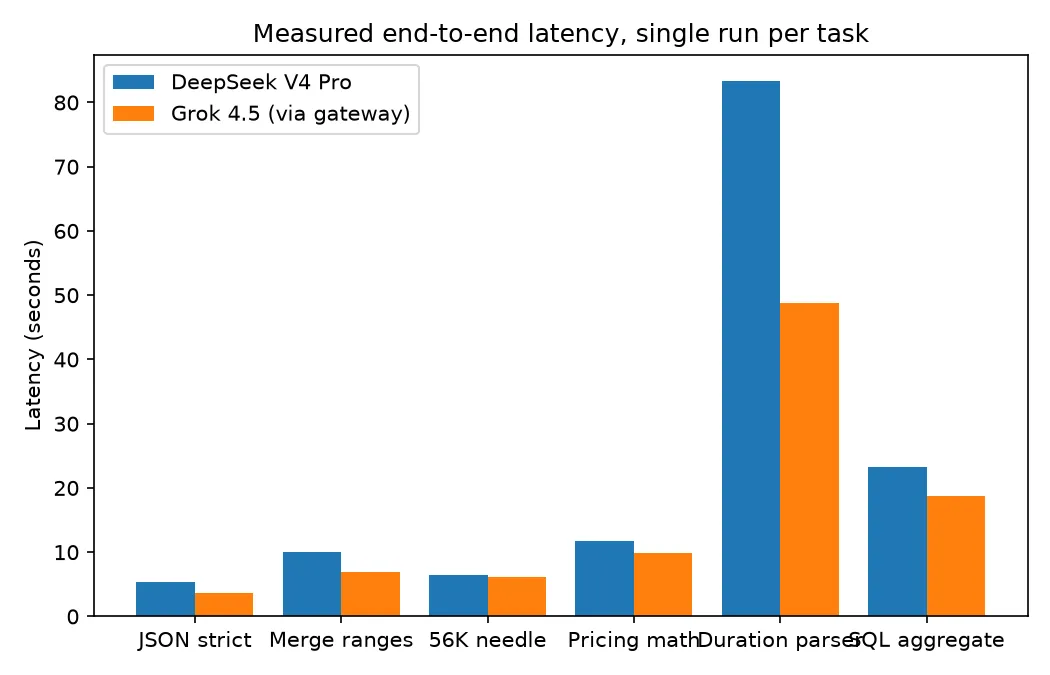
Grok 在全部 6 項任務都更快,而且任務愈長,差距愈明顯:duration parser 為 48.8 秒對 83.3 秒,JSON 任務則為 3.7 秒對 5.4 秒。這是在共享 gateway 上各跑一次的結果,小幅差異應視為雜訊,大幅差異則可作為方向性參考。
規格表看不到、卻最影響帳單的兩條規則
實際帳單更常由兩種計費機制決定,而不是表面上的單價;這兩項也都不會以欄位出現在規格表中。
xAI 的長 context 門檻是斷崖,不是漸進式加價。只要請求的 prompt 達到 200,000 tokens,該請求中的每一個 token 都按雙倍費率計算,而不只是超過門檻的部分。199,000-token 的 prompt 輸入成本是 $0.398;201,000-token 的 prompt 則是 $0.804。只多 1%,帳單便翻倍。
DeepSeek 的快取幾乎不用錢。快取命中每 1M 輸入 tokens 僅需 $0.003625,對比 Grok 4.6 的 $0.50,約便宜 138 倍。若是在穩定 codebase 上反覆工作,這個數字才是真正決定帳單的因素。Hacker News 上一位開發者表示:
如果你在同一個 codebase 上持續進行長時間 session,DeepSeek 官方 API 的 cache hit rate 可超過 99%,因此比 frontier models 便宜得多。我有一個在 claude code 中跑到 200M token session 的案例。
但 DeepSeek 的費率明確是暫時的。價格頁面有一則註腳:「We plan to raise the overall pricing for DeepSeek API services in the near future, with a significant increase expected.」一篇 Hacker News 分析推算,DeepSeek 的促銷前價格為輸入 $1.74、輸出 $3.48。這個推算在算術上自洽,因為 $0.435 與 $0.87 正好是上述金額的四分之一,但 DeepSeek 尚未公布促銷條款。
若漲價落在那些水準,上述月用量情境的費用將從 $24.36 升至 $97.44,對比 Grok 的 $118.00。輸出價格差距會從 6.9 倍收斂至約 1.7 倍,若純粹以價格做決策,答案就不再明顯。
該怎麼選?
高用量、重視成本、且 context 會反覆使用的工作,選 DeepSeek V4 Pro:例如批次處理、在同一個 repository 進行長時間 agentic coding session,或任何每個 prompt 超過約 200K tokens 的工作,因為 Grok 的門檻會使費率翻倍。1M context window 與近乎免費的快取會帶來疊加優勢,而它在 5 次測試中都遵守了精確格式限制。你可直接從 DeepSeek V4 Pro API page 使用。
延遲敏感或需要多模態能力的工作,選 Grok 4.6。Grok 在每一項任務都更快,但延遲與格式結果是以 4.5 而非 4.6 測得。它支援圖片輸入,DeepSeek 則不支援;此外,它至少公布了知識截止日期為 2026 年 2 月 1 日。若透過 gateway 路由,請確認取得的是 4.6 而非 4.5。Grok on AIReiter 與其他轉售商一樣,都取決於上游接上的版本。
別根據已公布的價格就直接選其中一款。DeepSeek 自己的註腳已說明目前優勢隨時可能改變,而 Grok 的快取輸入費率也已從 4.5 到 4.6 上漲 67%。在將工作負載正式交付前,請依即時價格頁面重算上述數字。
常見問題
Grok 4.6 真的已經推出了嗎?
是。截至 2026 年 8 月 13 日,Grok 4.6 已在 xAI 模型文件的 Latest 位置列出,公布定價為每 1M tokens 輸入 $2.00、輸出 $6.00,context window 為 500K。不過,第三方 gateway 仍可能將 grok-latest 路由至 Grok 4.5。
DeepSeek-V4-Pro-0813 是什麼?
它是 DeepSeek 目前在 deepseek-v4-pro API endpoint 背後提供的模型版本字串,列在官方價格頁面的 MODEL VERSION 一列。API ID 本身沒有日期後綴,因此 snapshot 可以更換,請求本身卻不會有任何變化。
哪個模型的 context window 較大?
DeepSeek V4 Pro 較大,為 1M tokens,Grok 4.6 則為 500K。DeepSeek 也公布最大輸出為 384K;xAI 並未公布 Grok 4.6 的最大輸出數字。
DeepSeek V4 Pro 比 Grok 4.6 便宜嗎?
以 2026 年 8 月 13 日的牌價來看,是:輸入便宜 4.6 倍,輸出便宜 6.9 倍。不過,DeepSeek 價格頁面已警告將大幅調價;若採用開發者辨識出的促銷前費率,輸出價差將降至約 1.7 倍。
哪一款的指令遵循更可靠?
在唯一拉開差距的測試中,DeepSeek V4 Pro 在 5 次嘗試中全數遵守精確格式限制,Grok 則 5 次全數未達成。兩個模型也都未能質疑 prompt 中植入的錯誤規格。