 AIREITER
若你正在 GPT-5.6 Luna 與 DeepSeek V4 Pro 之間做 API 選型,模型能力本身可能不是最後的分水嶺。我們以完全相同的提示詞測試,兩者都是 3 題全對;真正拉開差距的,是延遲表現與計價方式。尤其 DeepSeek 官方定價頁已明確提醒,API 價格近期將有顯著調漲。以下是我們在 2026 年 8 月 10 日實測與核對到的結果,以及各種工作負載的選擇建議。
相同提示詞實測:兩款 API 都答對,但速度差很大
我們在 2026 年 8 月 10 日,透過同一套 API 管線,以預設設定向 GPT-5.6 Luna 與 DeepSeek V4 Pro 各送出三項相同任務:一個刻意要求極簡回覆的 Python 除錯題,指示為「只回傳修正後的函式」;一道只有一個正確答案(10:10)的三月台卡車排程題;以及包含可為 null 欄位的嚴格 JSON 擷取題。兩款模型全數答對。
| 任務 | GPT-5.6 Luna | DeepSeek V4 Pro |
|---|---|---|
Python merge_intervals 除錯 | 正確(修正 max()),10.7 秒 | 正確(修正 max()),16.1 秒 |
| 月台排程推理 | 正確(10:10),8.0 秒 | 正確(10:10),27.2 秒 |
| 嚴格 JSON 擷取 | 有效,完全符合 schema,3.0 秒 | 有效,完全符合 schema,7.6 秒 |
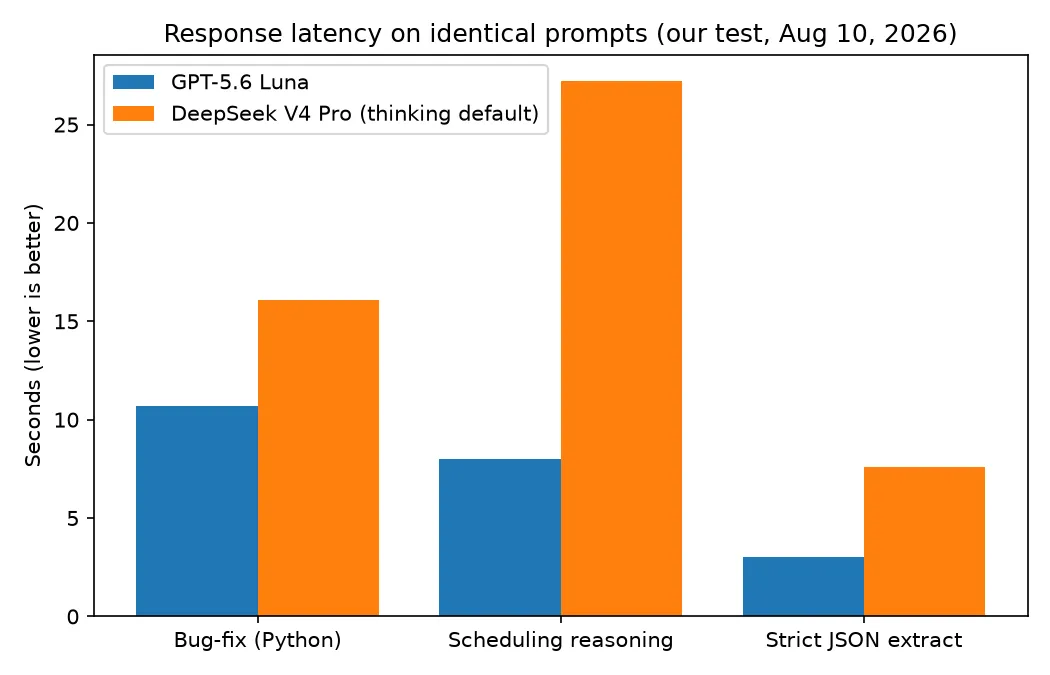
這份測試有兩點前提,也有兩個值得留意的細節。首先,這只是三項任務的抽測,不是完整基準測試。其次,V4 Pro 預設啟用 thinking mode,這大致解釋了本次 2~3 倍的延遲差距;每次請求都能關閉此模式,但較難的推理任務可能因此受影響。至於指令遵循,Luna 如要求般只回傳函式本身,V4 Pro 則額外加上 Markdown 程式碼區塊。在聊天視窗裡這無傷大雅,放進自動化管線則多了一道解析程序。我們也額外重跑一次排程題確認穩定性,兩者依然都回答 10:10。
官方價格核對:DeepSeek 已預告即將調漲
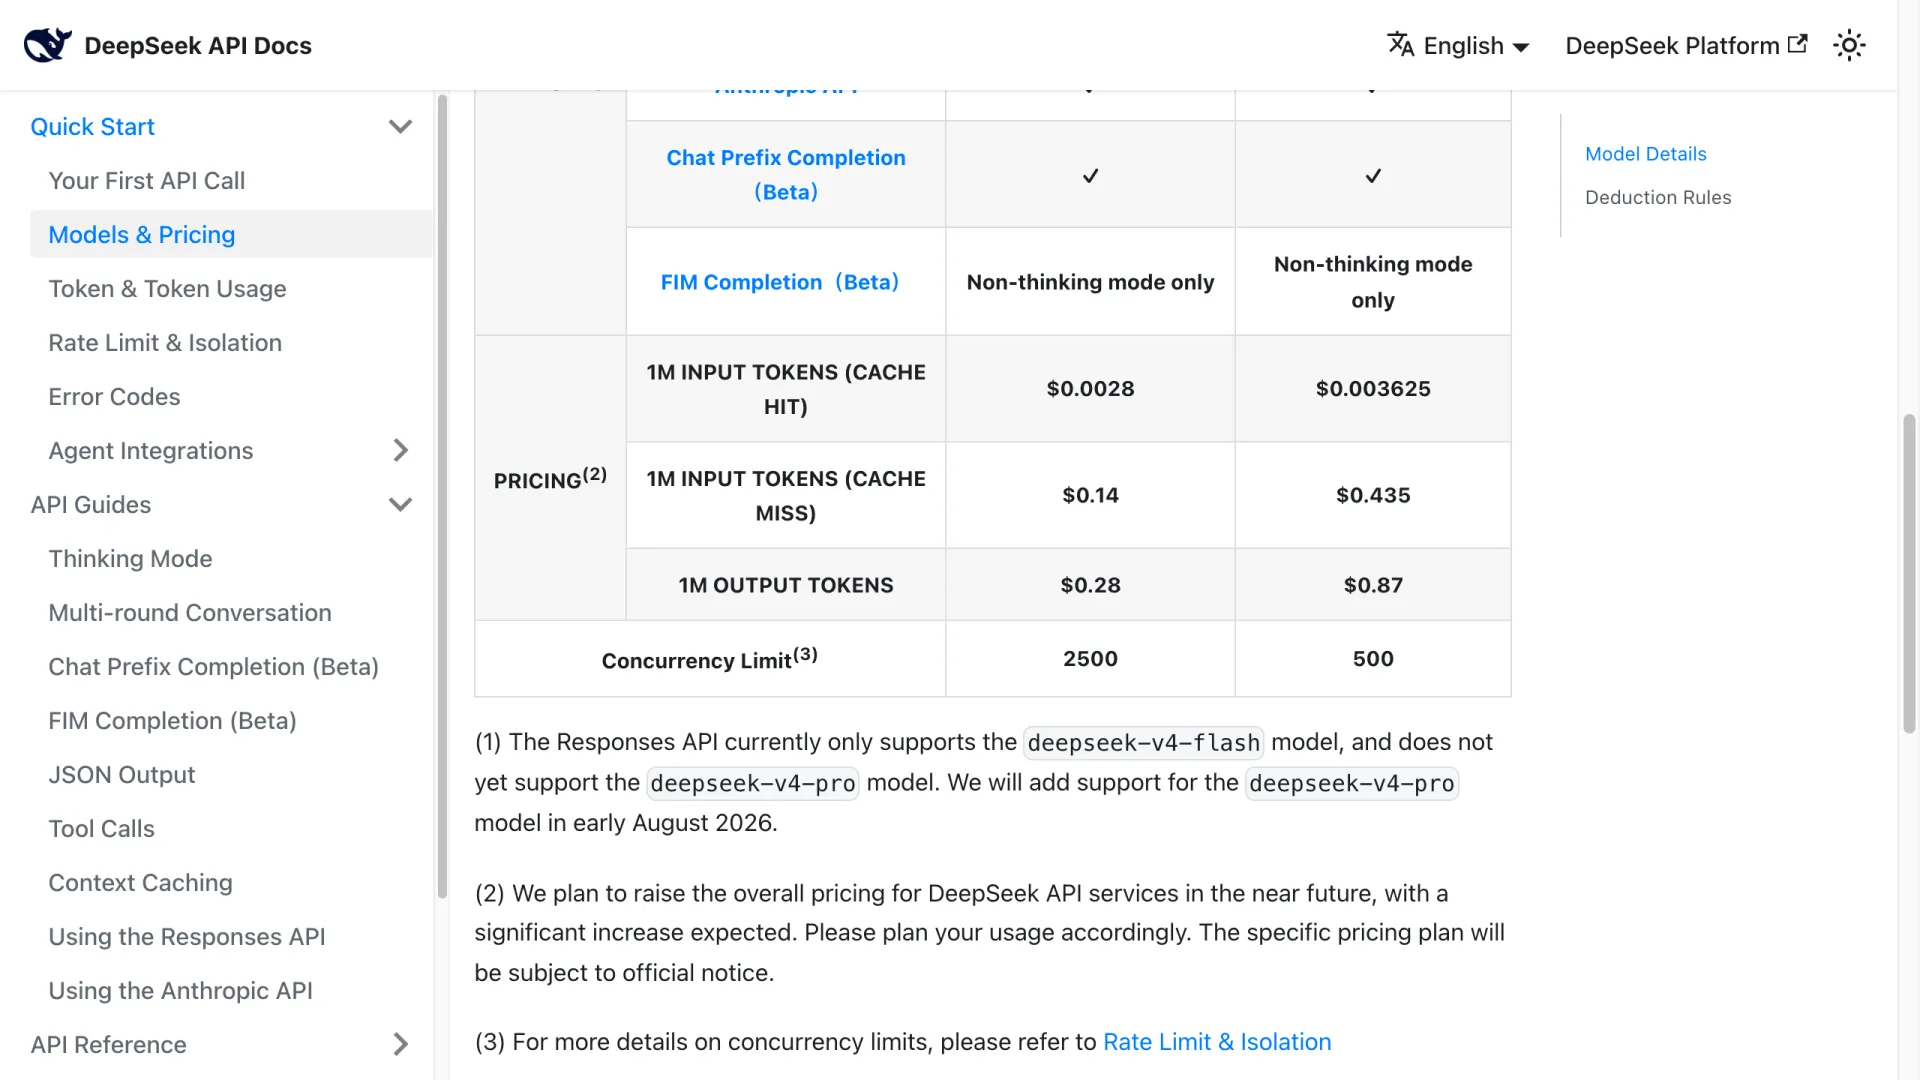
我們在 2026 年 8 月 10 日核對兩家官方頁面後確認:GPT-5.6 Luna 的價格為每百萬 input tokens $0.20、快取 input $0.02、output $1.20(OpenAI model page);DeepSeek V4 Pro 的 cache miss input 為 $0.435、cache hit input 為 $0.003625、output 為 $0.87(DeepSeek pricing page)。
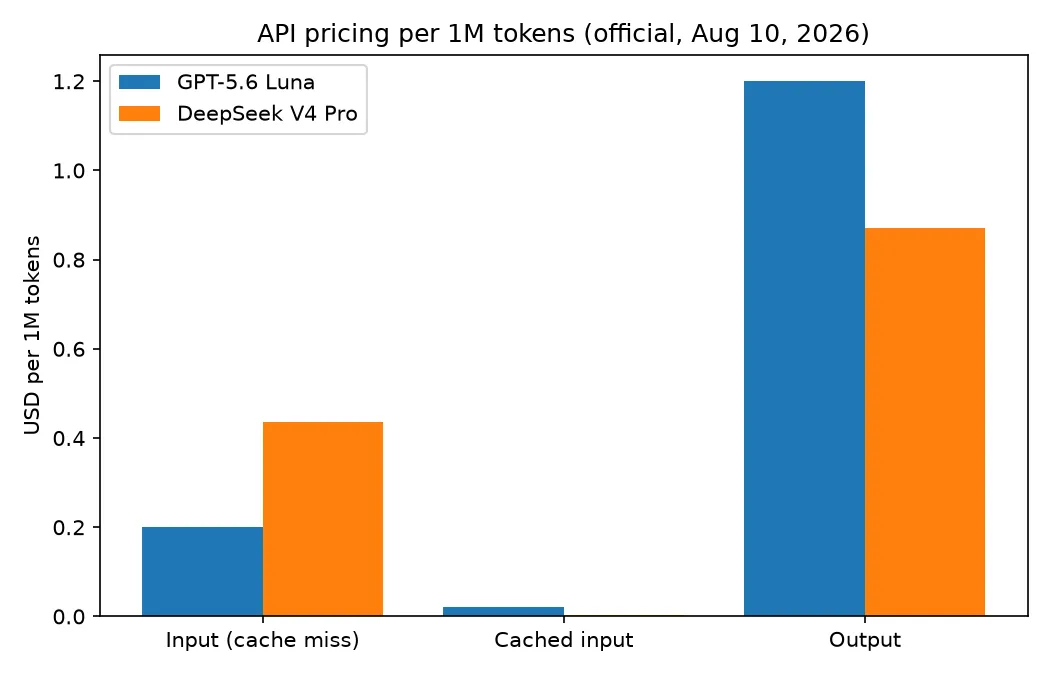
因此,很難直接說哪一款「全面更便宜」。Luna 的未快取輸入便宜 54%;V4 Pro 的輸出便宜 27%;而 V4 Pro 的快取命中成本則是 Luna 的 1/5.5。實際花費取決於你的 token 組成:
- 互動式聊天(每次呼叫 1K input + 500 output):Luna 為 $0.0008,V4 Pro 為 $0.00087,幾乎可視為平手。
- 程式庫審查(50K 全新 input + 3K output):Luna 為 $0.0136,V4 Pro 為 $0.0244,Luna 便宜 44%。
- Agent 迴圈(每輪 200K 快取 input + 20K 全新 input + 10K output):Luna 為 $0.020,V4 Pro 為 $0.018。這類情境下 V4 Pro 領先,而且快取輪次越多,優勢越明顯。
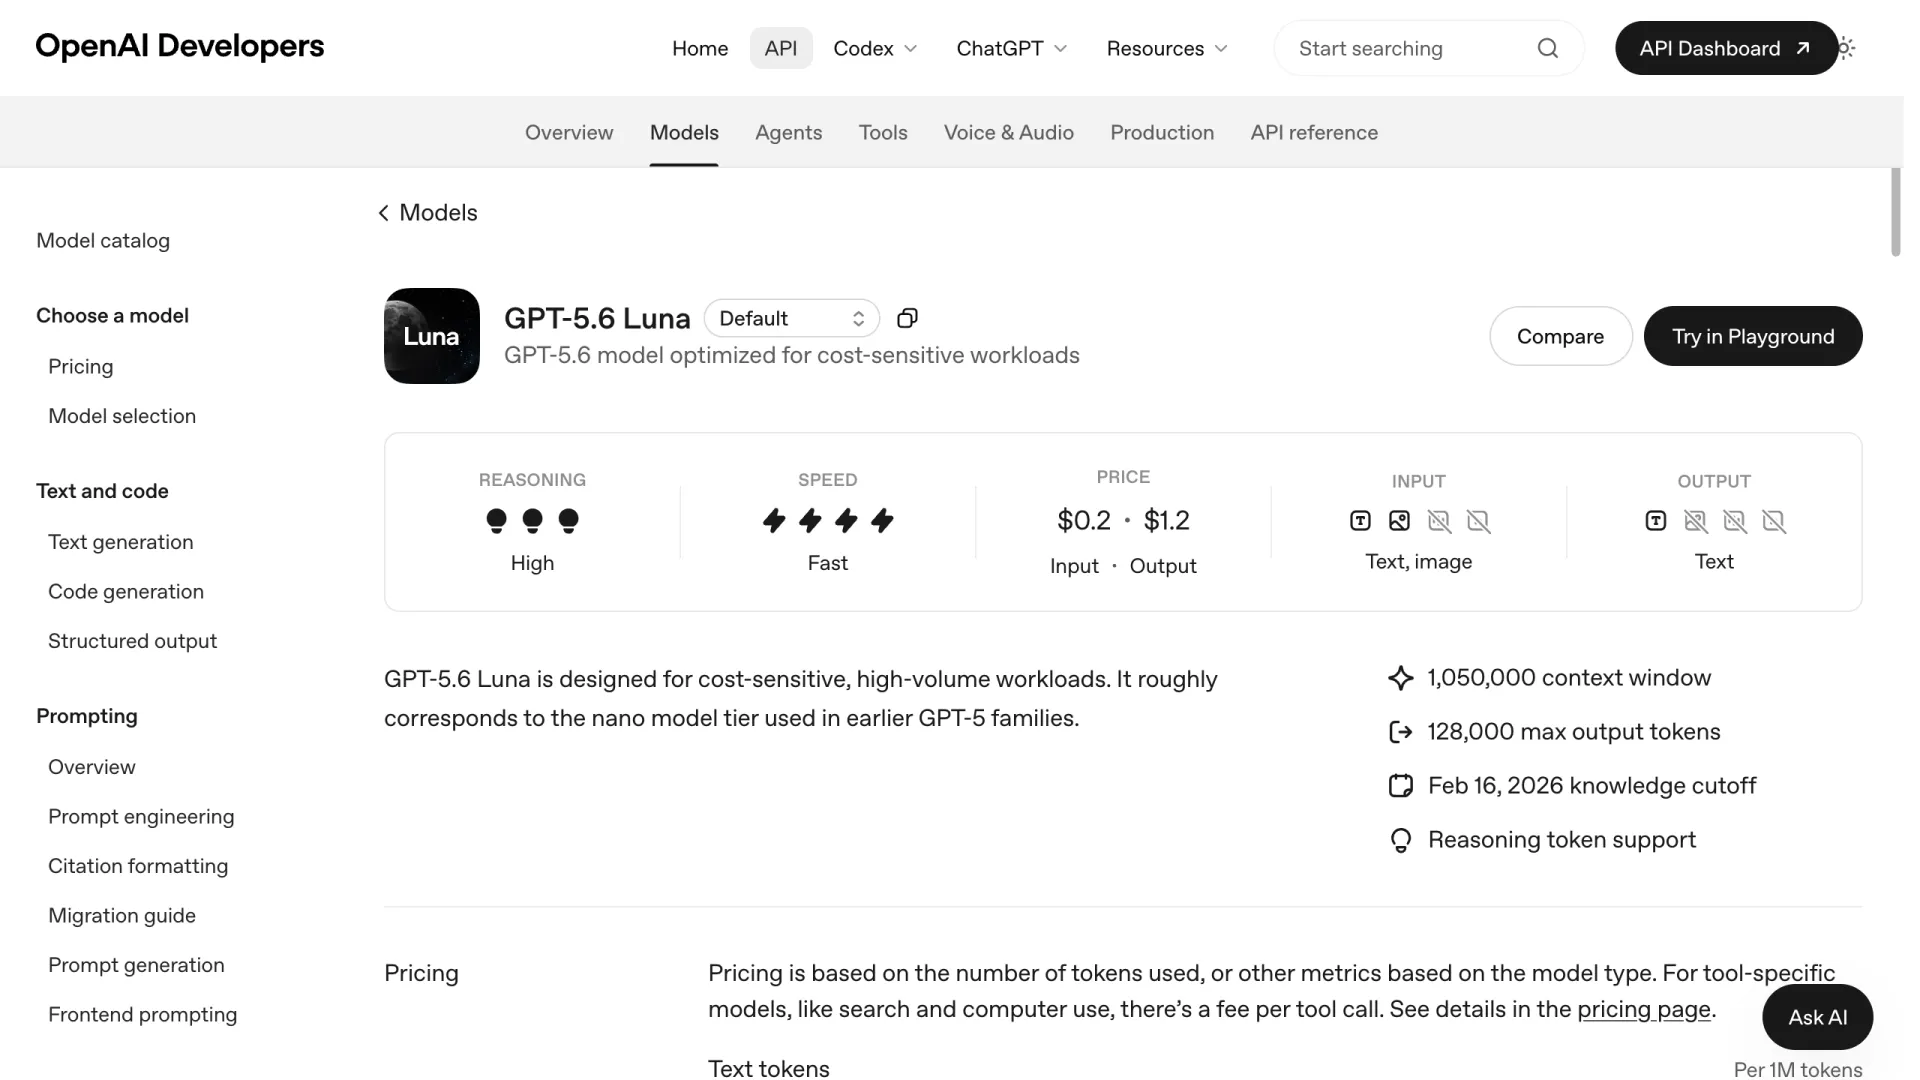
不過,還有一項資訊會影響這筆成本計算能維持多久。DeepSeek 定價頁的註腳 2 寫道:「We plan to raise the overall pricing for DeepSeek API services in the near future, with a significant increase expected.」目前沒有日期,也沒有漲幅數字;但若選擇 V4 Pro 的主要理由是價格,官方已經給出了有效期限警訊。Luna 的定價趨勢則剛好相反:它是在 OpenAI's August GPT-5.6 price cut 同期推出。
快取成本是 V4 Pro 的主場
DeepSeek V4 Pro 的快取 input 為每百萬 tokens $0.003625,Luna 則是 $0.02,兩者相差 5.5 倍。對 Agent 類工作負載來說,這個差距尤其關鍵,因為每一輪通常都會重新讀取一大段未變動的長前綴內容。已有開發者注意到這點:
DeepSeek v4 Pro & MiMo v2.5 Pro ... are insanely cheap for agent-driven work due to their super low cached-input prices ($0.0036/mtok). For Luna, the cached-input price ... the pricing page puts it at $0.02/mtok, & that's 5x more expensive. — Hacker News commenter, 在 GPT-5.6 發表討論串中
另外也別忽略 Luna 的 cache write 加價:cache write 會以未快取 input 單價的 1.25 倍計費(OpenAI model page);若提示詞 input 超過 272K tokens,整筆請求的 input 會以 2 倍、output 以 1.5 倍計費。若你的 Agent context 經常超過 272K tokens,Luna 的實際成本大致會翻倍,而這正是 V4 Pro 快取優勢最顯著的場景。
成本試算前,先回到官方文件確認價格
研究這次比較時,我們發現第三方網站列出的 V4 Pro input 價格,從每百萬 tokens $0.435 到 $1.74 都有;Luna 的 context window 也被標成從 400K 到 1.05M 不等。要避免算錯,花不到一分鐘做三件事:只以本文上方連結的兩個官方頁面確認定價;核對模型版本字串,目前 API 提供的是 DeepSeek-V4-Pro,Flash 則固定為 -0731;最後確認你看到的「input price」是 cache hit 還是 cache miss,V4 Pro 的兩者相差 120 倍。
真正影響選型的規格差異
除了價格,還有四項規格會直接影響適用情境:最大輸出量、多模態能力、開放權重,以及 API 介面。兩者都標示約 1M 的 context window,Luna 為 1,050,000 tokens,V4 Pro 為 1M,因此 context 長度本身不是主要分界點。
| 規格(2026 年 8 月 10 日核對) | GPT-5.6 Luna | DeepSeek V4 Pro |
|---|---|---|
| Context window | 1,050,000 | 1M |
| 最大 output tokens | 128K | 384K |
| 輸入模態 | 文字 + 圖片 | 僅文字 |
| 推理控制 | Effort levels(low→max) | Thinking 開啟(預設)/關閉 |
| 開放權重 | 否 | 是(可自行部署) |
| Responses API | 有 | 尚未提供(官方資訊:2026 年 8 月初) |
| 併發限制 | 依 usage tier 而定 | 500 |
| 知識截止日期 | 2026 年 2 月 16 日 | 定價頁未說明 |
V4 Pro 的最大輸出量為 384K,是 Luna 128K 的 3 倍。對單次生成整個程式碼庫、長篇翻譯,或大量結構化資料擷取等工作而言,這可減少分段處理所帶來的失敗風險。Luna 的圖片輸入則在另一類場景更重要,DeepSeek 使用者也會主動提到這個限制:
My only real complaint is that they can't do images, which limits their ability to autonomously debug some kinds of issues. — Hacker News commenter, 談到以 DeepSeek 處理個人專案時
開放權重則讓情勢反轉。V4 Pro 可下載並自行部署,若有資料落地要求,這是兩者之中唯一可選的方案;但也要認清,部署這種規模的模型需要嚴肅的多 GPU 硬體配置,並不是一個週末能完成的專案。
Benchmark 的差異,往往比模型本身更受 effort mode 影響
公開的 GPT-5.6 Luna 與 DeepSeek V4 Pro 分數,勝負可能因雙方採用的 effort mode 而對調。例如,某個追蹤網站以 Luna 的 low effort 對上 V4 Pro 的 max effort,結果為 33.3 比 44.3,由 V4 Pro 勝出;Artificial Analysis則讓兩者都以 max 測試,結果為 52 比 45,Luna 領先。兩者都沒有錯,只是在測不同設定。
延遲數字也有相同陷阱。Artificial Analysis 報告 Luna 在 max effort 下的首個答案 token 時間為 132 秒;這代表在 max effort 時,Luna 會先思考約兩分鐘才開始回答。我們以預設設定測試時,Luna 則在 3~10.7 秒內回覆。兩組數字都是真的,但只有其中一組接近你的正式環境設定。進入輸出階段後,Luna 的吞吐量明顯更高:202 tokens/s,對上 78(Artificial Analysis)。
Effort mode 對單一模型的分數影響也很大:V4 Pro 在 max thinking 下,GPQA Diamond 得分為 90.1%,關閉 thinking 後則為 72.9%。在雙方都使用 max effort 的共享 benchmark 中,Luna 在 SWE-Bench Pro 以 62.7% 領先 V4 Pro 的 55.4%;BrowseComp 則近乎平手,為 83.3 對 83.4。看任何排行榜前,先問三件事:測試跑的是哪個 effort mode、延遲是否包含 thinking 時間,以及 benchmark 版本是否相同。例如某追蹤網站列出的 Terminal-Bench 84.7 對 67.9,其實比較的是 v2.1 與 v2.0。
該選 GPT-5.6 Luna 還是 DeepSeek V4 Pro?
做面向使用者的產品,選 GPT-5.6 Luna:在我們的預設設定測試中,它在三項任務都快了 2~3 倍,未快取 input 成本約是 V4 Pro 的一半,也支援圖片輸入。若是高度依賴快取的 Agent 迴圈、需要超過 128K tokens 的輸出,或必須部署在自家硬體,則選 DeepSeek V4 Pro;但若是長期承諾,務必把官方的漲價警告算進成本。兩者只差一次 endpoint 切換,你可以透過 GPT-5.6 Luna 與 DeepSeek V4 Pro,先拿本文三項提示詞在自己的工作負載上重跑,再做決定。
| 你的工作負載 | 建議選擇 | 關鍵依據 |
|---|---|---|
| 聊天機器人、面向使用者的應用 | Luna | 本次測試延遲為 3.0~10.7 秒,對上 7.6~27.2 秒;吞吐量為 202 對 78 tok/s |
| 高量全新 input 處理 | Luna | 每 1M 未快取 input 為 $0.20,對上 $0.435 |
| 在穩定 context 上反覆運作的 Agent 迴圈 | V4 Pro | 每 1M 快取 input 為 $0.003625,對上 $0.02 |
| 單次長篇輸出 | V4 Pro | 最大 output 為 384K,對上 128K |
| 視覺輸入(截圖、以圖片形式處理的 PDF) | Luna | V4 Pro 僅支援文字 |
| 自行部署/資料落地 | V4 Pro | 開放權重;Luna 僅提供 API |
| 延續至 2027 年的預算確定性 | Luna | DeepSeek 官方已發布價格調漲通知 |
常見問題
GPT-5.6 Luna 和 DeepSeek V4 Pro,哪一款比較便宜?
沒有一款在所有情況下都更便宜。Luna 的未快取 input 便宜 54%(每 1M tokens 為 $0.20,對上 $0.435);V4 Pro 的快取 input 便宜 5.5 倍($0.003625,對上 $0.02),output 也便宜 27%($0.87,對上 $1.20)。高快取比例的 Agent 使用 V4 Pro 較省;以全新 input 為主的工作負載則是 Luna 較省。
兩款模型都支援 1M-token context window 嗎?
是。Luna 提供 1,050,000 tokens,V4 Pro 提供 1M。但請注意,Luna 的 input 超過 272K tokens 時,整筆請求會以 2 倍 input 與 1.5 倍 output 計費。
DeepSeek V4 Pro 是開源模型嗎?可以自行部署嗎?
可以。V4 Pro 提供開放權重,可自行部署;不同於僅有 API 的 Luna。不過,請規畫多 GPU 的推論硬體,而非預期以單一工作站就能順利部署。
GPT-5.6 Luna 支援圖片輸入嗎?
支援。Luna 可接受文字與圖片輸入;DeepSeek V4 Pro 僅支援文字。DeepSeek 使用者也將缺乏視覺支援視為自主除錯工作流程中的主要限制。
兩款模型各自的最大 output tokens 是多少?
DeepSeek V4 Pro 單次回覆最高可輸出 384K tokens;GPT-5.6 Luna 上限則是 128K。若要單次生成長文件或大型程式碼檔,V4 Pro 的上限高出 3 倍。
延伸閱讀
- DeepSeek V4 Pro vs GPT-5.6 Sol:同一款 DeepSeek 旗艦模型對上 OpenAI 中階產品
- GPT-5.6 Luna review:跳脫這次對決,從 Luna 本身的角度深入了解
- DeepSeek V4 Flash vs V4 Pro:若 V4 Pro 的價格風險讓你考慮降一級,這篇可供參考