 AIREITER
真正的預設選擇,取決於你的工作負載。對大多數有明確邊界、且輸出量較大的工作,Claude Opus 5 是更穩妥的起點;至於長時間運作的代理,以及需要重複使用異常龐大上下文的情境,則可以測試 Claude Fable 5.1。Fable 5.1 的主要省成本之處在於快取讀取,而不是較低的輸入或輸出單價。
比較 Fable 5.1 與 Opus 5,先從工作負載開始
對多數團隊來說,應先從 Opus 5 開始;遇到需要更多推理的任務,再提高它的 effort 設定,只有經過驗證的高難度案例才交給 Fable 5.1。Anthropic 的 Fable 5.1 文件也給出大致相同的方向:大多數工作負載先使用 Opus 5,只有在提高 Opus 5 的 effort 後仍無法達到要求時,才轉向 Fable 5.1。
| 如果你的主要限制是…… | 建議先從……開始 | 原因 |
|---|---|---|
| 短請求或有明確邊界的請求 | Opus 5 | 它的輸入與輸出價格都是 Fable 5.1 的一半。 |
| 輸出量較大的正式環境流量 | Opus 5 | Fable 較低的快取讀取價格,無法降低生成 token 的成本。 |
| 規格明確的多檔案程式設計 | Opus 5 | 較低的成本,讓重試與提高 effort 更容易負擔。 |
| 長時間運作、會使用工具的代理 | Fable 5.1—先做評估 | 在 Anthropic 公布的代理與工具使用比較中,Fable 都處於領先。 |
| 跨多輪反覆重用的大型上下文 | Fable 5.1—先建立成本模型 | 它的快取讀取價格是 Opus 5 的一半。 |
| 對備援高度敏感的正式環境路由器 | 先用 Opus 5 | Fable 5.1 改變了思考區塊與對話歷史的處理方式。 |
真正要比較的是:在合適的 effort 與成本下使用 Opus 5,對上在合適的上下文結構與可靠性門檻下使用 Fable 5.1。
Fable 5.1 與 Opus 5,實際差異在哪裡?
Claude Fable 5.1 是 Anthropic 面向高要求推理與長期代理工作的高階模型;Claude Opus 5 則定位為成本較低、適合嚴肅程式設計、代理與專業工作的模型。兩者都具備 1-million-token 上下文視窗,以及 128,000-token 的最大輸出,因此 Fable 的優勢並不是公開規格中的上下文更大,而是更偏向長時間、長流程的執行。
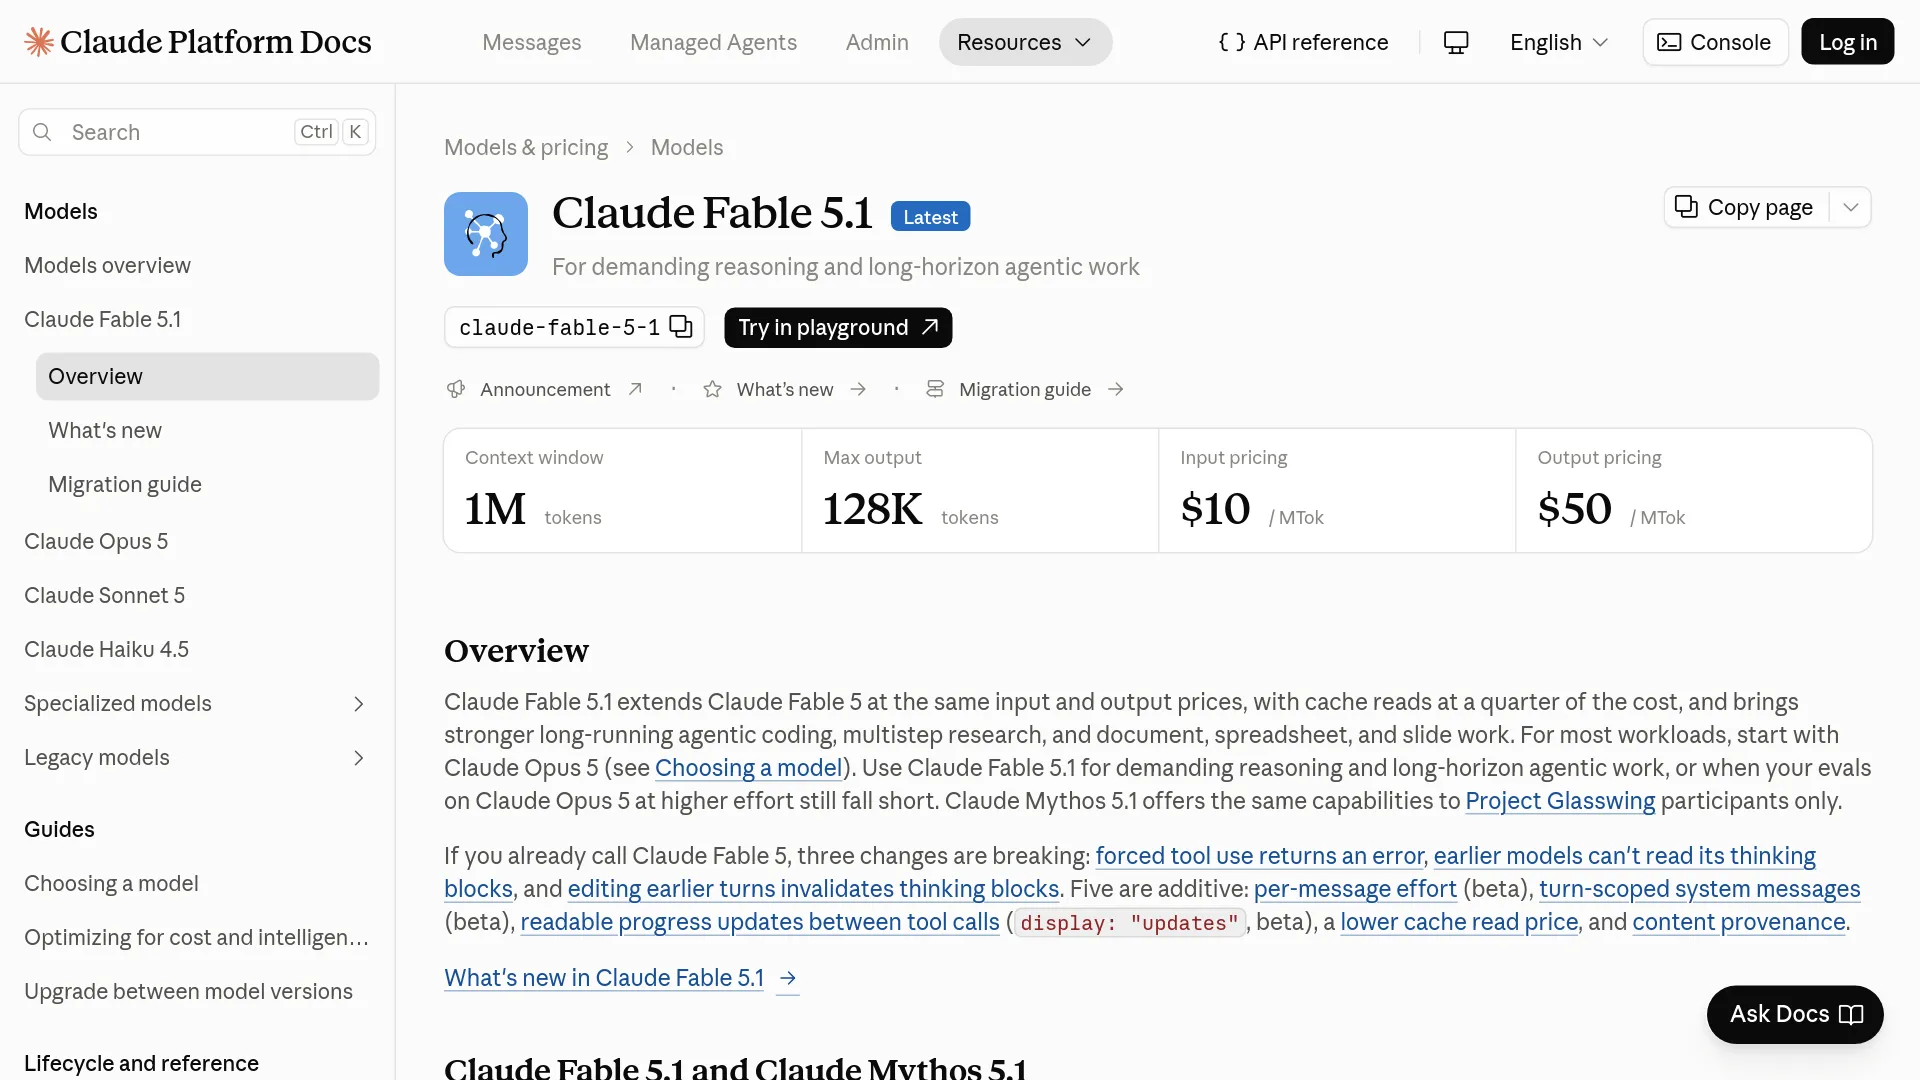
| 規格 | Claude Fable 5.1 | Claude Opus 5 |
|---|---|---|
| API 模型 ID | claude-fable-5-1 | claude-opus-5 |
| 上下文視窗 | 1 million tokens | 1 million tokens |
| 最大輸出 | 128,000 tokens | 128,000 tokens |
| 輸入模態 | 文字與圖片 | 文字與圖片 |
| 輸出模態 | 文字 | 文字 |
| 思考能力 | 自適應、始終開啟 | 可控制 effort 的推理 |
| Effort 控制 | low、medium、high、xhigh、max | 可設定的 effort 等級 |
| Anthropic 的定位 | 高要求推理與長時間代理 | 大多數工作負載與嚴肅程式設計 |
| 發布狀態 | 現行/最新;於 September 1, 2026 發布 | 現行 Opus 模型;於 July 24, 2026 發布 |
如需確認部署專用的模型 ID 與可用性,請參閱 Fable 5.1 模型頁面與 Claude Opus 5 產品頁面。
Fable 5.1 的基準測試成績亮眼,但不能一概而論
Anthropic 公布的基準測試表顯示,在兩個模型都有數據的每一個項目中,Fable 5.1 都領先 Opus 5。不過,這些結果來自供應商自行執行的測試,因此它們能作為發布評估的參考證據,卻不能視為正式環境的保證。
| Anthropic 評估項目 | Fable 5.1 | Opus 5 | Fable 5.1 領先幅度 |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 29.0% | 23.6 points |
| Terminal-Bench 4.0 | 55.8% | 52.3% | 3.5 points |
| GDPval-AA v2 | 1,853 Elo | 1,824 Elo | 29 Elo |
| OSWorld 2.0, strict | 41.7% | 39.6% | 2.1 points |
| Humanity’s Last Exam, with tools | 65.0% | 63.6% | 1.4 points |
| AutomationBench | 31.4% | 26.9% | 4.5 points |
| CursorBench 3.2.0 | 73.4% | 70.0% | 3.4 points |
Anthropic 表示,測試已啟用正式環境防護措施,部分介入可能導致得分為零,或將工作轉交給備援模型。Anthropic 也指出,在 Terminal-Bench-Science 0.1 中,每個模型的標準誤差約為 3.5–4.5 個百分點。因此,23.6 個百分點的差距,比 Humanity’s Last Exam 上 1.4 個百分點的差異更值得重視。
第三方 CodeRabbit 評估針對包含 105 個已知問題點的 45 項任務進行測試,結果顯示 Fable 5.1 的召回率為 61.0%、精確率為 37.3%;Opus 5 則是召回率 55.2%、精確率 39.3%。兩者都產生了 166 則已處理的評論,但作者提醒,兩組測試的設定並不相同。
「Fable 5.1 是專門型的審查模型。」— CodeRabbit 對其評估結果的描述(CodeRabbit)
API 定價,才是實際比較的關鍵
未快取的輸入與輸出,Fable 5.1 的價格是 Opus 5 的兩倍;但它的快取讀取價格只有 Opus 5 的一半。這使長時間、重複性高的代理工作階段可能出現成本交叉點,但不代表每個 Fable 5.1 請求都更便宜。
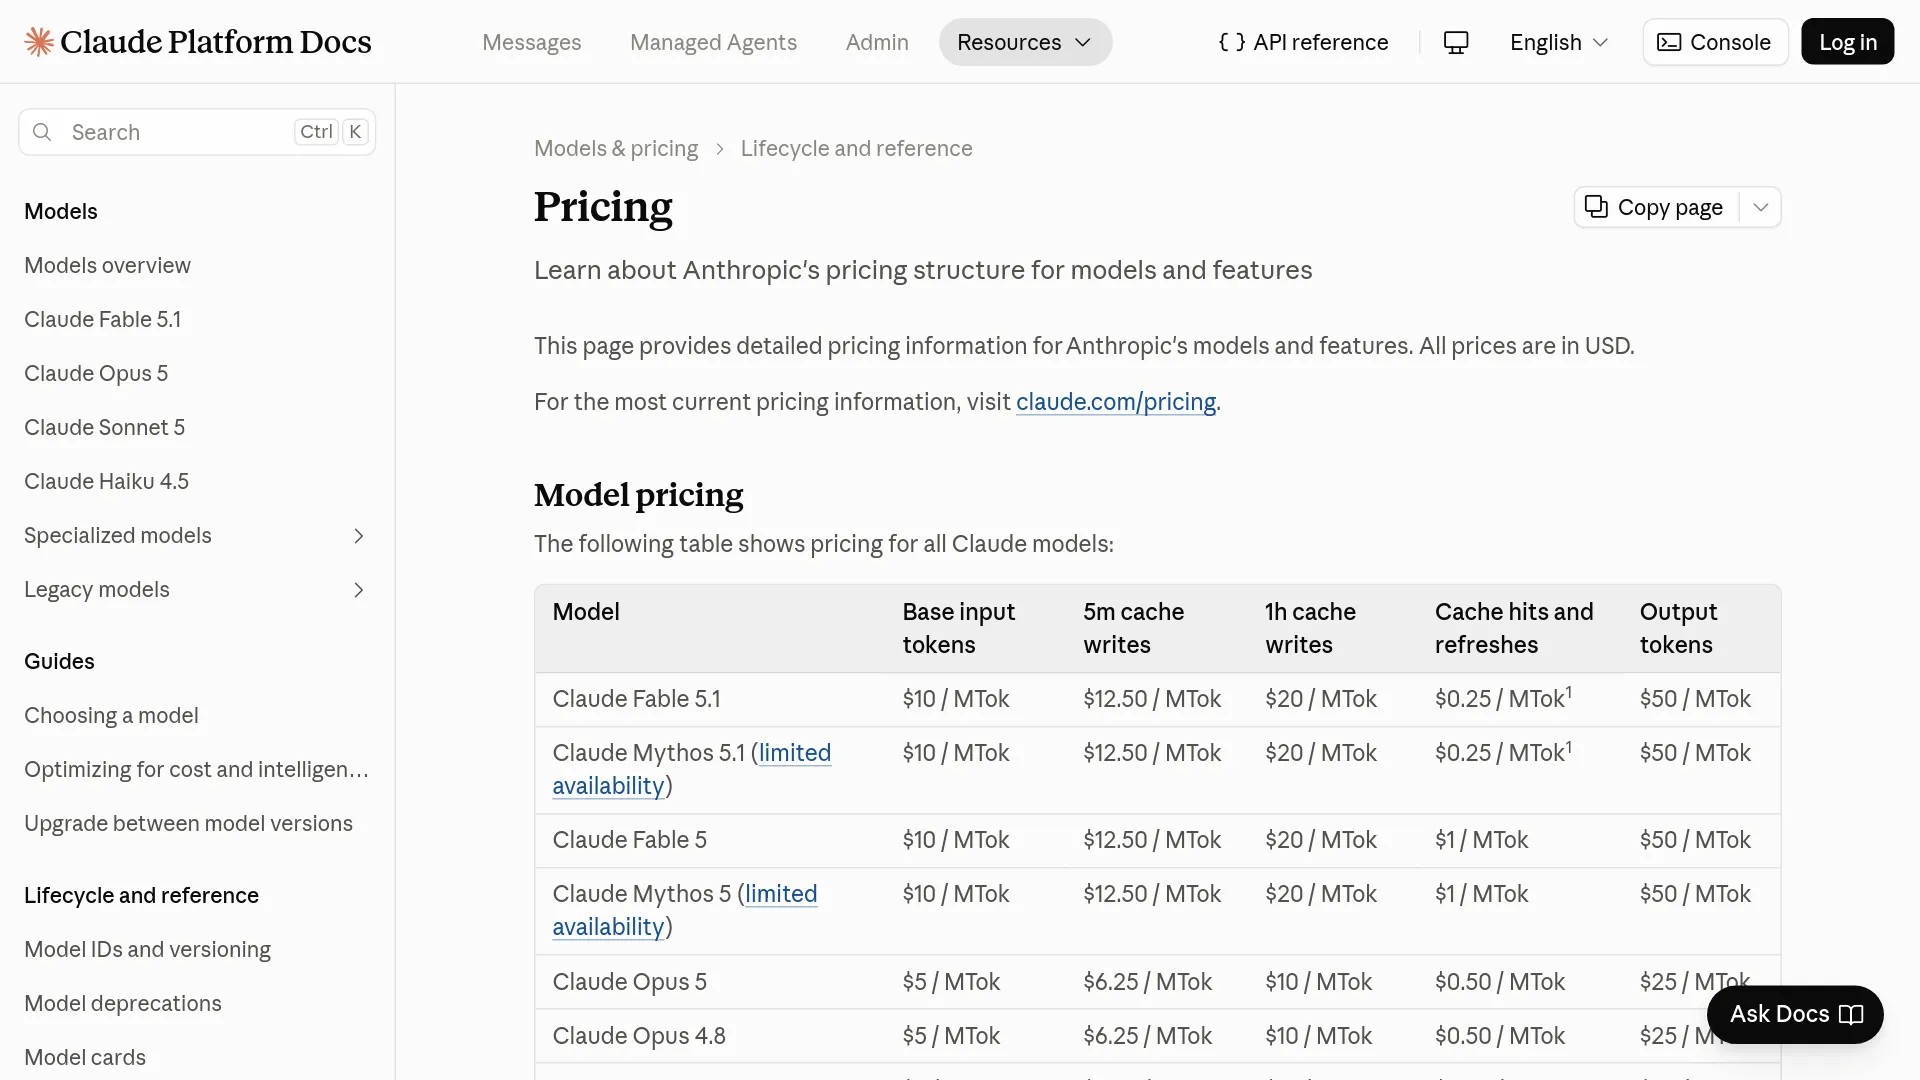
以下價格取自 Anthropic 目前的 API 定價文件,單位為每百萬 token 的美元價格。
| 計費項目 | Claude Fable 5.1 | Claude Opus 5 |
|---|---|---|
| 基本輸入 | $10.00 | $5.00 |
| 5 分鐘快取寫入 | $12.50 | $6.25 |
| 1 小時快取寫入 | $20.00 | $10.00 |
| 快取讀取 | $0.25 | $0.50 |
| 輸出 | $50.00 | $25.00 |
| 批次輸入/輸出 | $5.00 / $25.00 | $2.50 / $12.50 |
Fable 5.1 的輸入與輸出價格,與 Fable 5 相比沒有變化。真正帶來宣稱節省的,是快取讀取價格:每百萬 token 為 $0.25,低於 Fable 5 的 $1.00。Anthropic 估計,一般工作負載的成本約可降低 25%,高度代理化的工作負載最多約可降低 45%;但這些都是工作負載估算,不是適用所有情境的統一折扣。
用每輪請求的方式計算,取捨會更清楚。令 C 代表快取上下文、I 代表新的輸入、O 代表輸出,三者單位都是百萬 token。在忽略快取寫入費用的情況下,Fable 5.1 的成本是 10I + 0.25C + 50O;Opus 5 則是 5I + 0.50C + 25O。
只有在以下條件成立時,Fable 較便宜的快取讀取價格,才足以抵銷較高的新輸入與輸出價格:
0.25C > 5I + 25O
假設新的提示詞有 2,000 個 token,回應有 1,000 個 token,則 I = 0.002、O = 0.001。在只計算讀取費用的情況下,快取上下文必須超過約 140,000 tokens,成本才會偏向 Fable。若把快取寫入費用也算進去,交叉點還會更遠。
這也是為什麼短篇擷取、分類、改寫,以及一次性的程式設計請求,不應僅為了價格就升級到 Fable 5.1。這些情境通常沒有多少可重複使用的前綴可供折扣,而且每個生成 token 的價格都是 Opus 5 的兩倍。
兩個模型分別適合哪些實際工作流程?
實際上的分界,在於有明確邊界的執行與長時間持續的工作。任務規格清楚或輸出量較大時,Opus 5 更容易證明其合理性;當代理需要維持計畫、反覆使用工具、從失敗中恢復,並在多輪對話中攜帶大型上下文時,Fable 5.1 才更值得關注。
程式設計代理:看完成了多少工作,不要只看基準測試排名
對一般儲存庫工作而言,Opus 5 是較適合先測試的選項,例如範圍明確的錯誤修正、重構、程式碼審查,以及能透過較低成本進行重試或提高 effort 的任務。若是多檔案變更、系統遷移、系統層級除錯,或非同步程式設計工作階段,且後期失敗的代價高於較慢的回應速度,Fable 5.1 就值得進行試點。
社群回饋反映出兩種不同的操作風險。在一篇大型 r/ClaudeCode 討論中,使用者 u/CyCoCyCo 寫道:
「我唯一成功的方法,就是讓它先產生目標提示詞,再讓整個流程端到端執行。」— Reddit 使用者 u/CyCoCyCo
這反映的是提示詞與工作流程方面的抱怨,不能據此證明 Opus 5 對所有程式碼庫都會失敗。同一討論中也有其他使用者提到,在較長、上下文密集的任務裡遇到問題,包括指令逐漸偏離,以及修正一個問題後又引入新缺陷。
Fable 5.1 面臨的抱怨則不同:在一篇發布討論中,有使用者反映 token 或配額消耗速度異常快。這是個人經驗,不能用來證明所有訂閱方案都有相同限制;不過,這確實說明試點期間應追蹤用量,不能只看輸出品質來評估模型。
一個合理的程式設計代理試點,應記錄以下項目:
- 不需人工介入便完成的任務數量。
- 模型回報成功後重新開啟的錯誤,或後續出現的回歸問題。
- 輸入、快取輸入與輸出 token 的總量。
- 實際耗時與工具呼叫次數。
- 人工修正時間,以及後期執行失敗所產生的成本。
研究與文件密集型工作:Fable 的理由更充分
如果工作涉及非常龐大的文件集合、反覆的工具呼叫、視覺化圖表、多步驟研究,或需要經過多輪修改仍能交付的成果,Fable 5.1 是更值得優先測試的候選模型。Anthropic 特別將它定位於文件、試算表、投影片、圖表、表格,以及長時間執行的研究工作。
Opus 5 具備相同的 1-million-token 上下文容量,Anthropic 也表示它能處理複雜文件與成熟的代理。如果工作只是一次性分析,而且會產生大量輸出,Opus 較低的價格可能比 Fable 的快取優勢更重要。在把 Fable 的基準測試領先視為正式環境需求之前,先用具代表性的樣本進行測試。
電腦操作與商業自動化:測試完整工作軌跡
在 Anthropic 的 OSWorld 與 AutomationBench 項目中,Fable 5.1 領先 Opus 5;但這類任務衡量的是一連串操作,而不是單一答案。對瀏覽器或商業流程代理來說,應評估模型是否能抵達正確的最終狀態、需要恢復的頻率,以及一次操作失敗是否會讓後續流程全部失效。
真正該看的單位是每個完成結果的成本,而不只是每百萬 token 的價格。若某個模型能避免長流程中的反覆重試,即使單價較高,整體仍可能更划算;如果模型在抵達最終狀態前就耗盡使用配額,則不然。
切換模型前,團隊應先檢查這些整合細節
Fable 5.1 的遷移文件說明了強制工具使用、思考區塊與對話歷史驗證方面的變更。若團隊使用自有訊息路由器,應在更換預設模型前完成測試。
| 變更 | 可能發生的情況 | 遷移動作 |
|---|---|---|
| 強制工具使用 | tool_choice: {"type":"any"}或指定工具的選擇可能回傳 HTTP 400。 | 搭配清楚的工具指示使用 auto,或在適當情況下改用結構化輸出。 |
| 思考區塊的可攜性 | 較早的模型無法讀取 Fable 5.1 的思考區塊;備援回合可能會丟棄這些區塊。 | 檢查模型切換與備援路徑。 |
| 編輯對話內容 | 修改先前的訊息、系統提示詞或工具清單,可能使後續思考區塊失效。 | 將歷史視為只能追加,或使用受支援的回合範圍控制項。 |
| 思考設定 | Fable 5.1 使用自適應思考,無法以與 Opus 5 相同的方式停用思考。 | 透過 effort 設定控制支出,並重新測試 token 用量。 |
在混合模型路由器中,備援細節尤其重要。Fable 5.1 的請求可能會帶著原有的推理上下文繼續執行,但切換至 Opus 5 時,備援模型無法讀取 Fable 5.1 的思考區塊。如果路由器在沒有提示的情況下丟棄這些區塊,備援模型可能需要重新規劃,進而增加延遲與 token 用量。成功路徑與失敗路徑都要使用接近正式環境的歷史紀錄進行測試。
小規模評估,比大型模型宣稱更有參考價值
兩個模型應使用相同的提示詞、工具、上下文、effort 政策與驗收測試;否則最後比較的可能是測試框架,而不是模型本身。
- 有界任務組:執行範圍明確的錯誤修正、資料擷取、結構化寫作與程式碼審查,並追蹤有效輸出、修正時間與成本。
- 長時間任務組:執行多檔案功能開發、遷移、研究任務或瀏覽器工作流程,並追蹤最終狀態是否成功、恢復情況、回歸問題與實際耗時。
- 高快取使用量任務組:重複使用穩定的系統提示詞、工具組,以及儲存庫或文件前綴,並追蹤快取命中率與總帳單,包括快取寫入與輸出費用。
先讓 Opus 5 使用你實際會部署的 effort 等級,再測試提高 Opus 5 的 effort,之後才把任務交給 Fable 5.1。對 Fable 至少測試 medium 與 high;不要假設同一個 effort 名稱在不同模型間代表完全相同的行為。Anthropic 表示,effort 設定會控制深度與成本之間的取捨;第三方測試則發現,提高推理程度並不會自動改善整體程式碼審查結果。
Fable 5.1 與 Opus 5 常見問題
哪個模型更適合程式設計?
在 Anthropic 公布的 Terminal-Bench 與 CursorBench 結果中,Fable 5.1 領先 Opus 5;但對大多數範圍明確、重視成本的程式設計工作,Opus 5 是較適合先測試的起點。應使用具代表性的程式碼庫進行評估,確認 Fable 較高的完成品質是否足以抵銷它的價格與延遲。
Fable 5.1 值得付兩倍 API 價格嗎?
不能預設如此。它的輸入與輸出價格是 Opus 5 的兩倍,快取讀取價格則只有一半;只有在工作負載會反覆重用大型上下文,且輸出量相對較少時,Fable 才在成本上顯得更有吸引力。
Fable 5.1 的上下文視窗比較大嗎?
不是。Anthropic 為兩個模型都列出 1-million-token 上下文視窗與 128,000-token 最大輸出。Fable 的差異在於它定位為更適合長時間推理與代理流程,而不是擁有更大的公開上下文視窗。
切換前,應該先提高 Opus 5 的 effort 嗎?
是。Anthropic 的模型指南建議,在轉向 Fable 5.1 前,先評估提高 effort 後的 Opus 5。應比較增加的 token 成本與品質改善幅度,而不是讓每個請求都以最高 effort 執行。
從 Fable 5.1 備援切換到 Opus 5,安全嗎?
可以建立這樣的備援機制,但不要假設對話狀態能直接攜帶。較早的模型無法讀取 Fable 5.1 的思考區塊,而 Fable 5.1 的歷史驗證也可能暴露出會修改先前回合的路由器問題;請使用實際的工具結構與訊息歷史測試備援流程。
開發者可以在哪裡使用 Fable 5.1 與 Opus 5?
Anthropic 將兩個模型都列入 Claude 方案,開發者也能透過其平台與雲端市集整合來使用。不同供應商提供的確切模型 ID 與可用性可能有所差異,因此請在 Fable 5.1 文件或 Opus 5 產品頁面中確認部署專用識別碼。
實際選擇應該是路由規則,而不是永久升級
| 決策情境 | 使用 Opus 5 | 使用 Fable 5.1 |
|---|---|---|
| 混合流量的預設模型 | 是 | 只有評估後才使用 |
| 短篇一次性請求 | 是 | 沒有價格上的理由 |
| 輸出量大的生成工作 | 是 | 通常不要 |
| 大型快取前綴 | 仔細比較 | 可能具備成本優勢 |
| 長時間自主程式設計 | 先進行試點 | 強力候選 |
| 嚴格限定範圍的重構 | 通常使用 | Opus 未通過驗收測試時再考慮 |
| 瀏覽器或多步驟自動化 | 先進行試點 | 基準測試表現強 |
| 自訂備援路由器 | 較簡單的基準方案 | 需要進行遷移測試 |
把 Opus 5 留作基準,在相同的有界任務與長時間任務集合上測試兩個模型,只有當 Fable 5.1 能改善每美元完成的工作量時,才將任務路由過去。
如需模型專屬的成本細節,請參閱 Claude Fable 5.1 API 定價;如需更完整的模型參考,請參閱 Claude Opus 5。