Qwen4 Max API теперь работает по модели pay-as-you-go, а не только в рамках предварительного Token Plan. Цена составляет $1.50 за 1M входных и $4.50 за 1M выходных токенов, а размер контекстного окна достигает 1M токенов. Для новых интеграций используйте qwen4-max: модель qwen4-max-preview отключат 25 ноября 2026 года.
Qwen4-Max API вкратце: общий доступ с 16 ноября 2026 года
Alibaba открыла общий доступ к Qwen4-Max 16 ноября 2026 года. Модель доступна в Alibaba Cloud Model Studio под именем qwen4-max — после предварительного запуска, начавшегося 11 ноября и доступного только по Token Plan. О запуске сообщил аккаунт @Alibaba_Qwen: Qwen4-Max построена на новой MoE-архитектуре, поддерживает нативное зрение и контекстное окно на 1M токенов. API уже работает в QwenCloud. Документация QwenCloud повторяет Model Studio для международного доступа; выбирайте endpoint Model Studio, соответствующий вашему региону (документация QwenCloud).
| Параметр | Qwen4-Max (qwen4-max) |
|---|---|
| Статус | Общий доступ с 16 ноября 2026 года; preview qwen4-max-preview работает с 11 по 25 ноября 2026 года, после чего будет отключена |
| Ввод / вывод | $1.50 / $4.50 за 1M токенов (международный Singapore) |
| Чтение кэша | $0.075 за 1M токенов |
| Другие регионы | $1.413 / $4.24 за 1M токенов в США (Virginia), Frankfurt, Tokyo и Hong Kong |
| Контекст | 1M токенов; максимальный входной объём — 991K токенов |
| Максимальный вывод | 131,072 токена без thinking; 262,144 токена на thinking и ответ вместе |
| Входные форматы | Текст, изображения, видео |
| Возможности API | Совместимость с OpenAI и Anthropic; вызов инструментов, структурированный JSON-вывод, веб-поиск, кэширование, пакетная обработка и дообучение |
| Регионы | Singapore, US (Virginia), Frankfurt, Tokyo, Hong Kong, Beijing; пакетные задания — только Beijing |
| Пробный доступ | Новые аккаунты Singapore получают 1M бесплатных токенов на 90 дней |
Указанные цены и лимиты взяты из документации Alibaba Cloud Model Studio, опубликованной по состоянию на 16 ноября 2026 года (цены и документация QwenCloud). Например, запрос на 100K входных и 10K выходных токенов в Singapore обойдётся примерно в $0.15 + $0.045 = $0.195.
Что изменилось по сравнению с Qwen3.8-Max
Согласно данным Artificial Analysis, которые приводит Qwen, показатель Intelligence Index у Qwen4-Max равен 43. Это на 9 пунктов выше, чем у Qwen3.8-Max (xhigh), и на 3 пункта ниже, чем у Kimi K3.1 Pro. Средняя стоимость одной задачи составляет $3.27 — примерно треть от показателя Qwen3.8-Max, а число выходных токенов уменьшилось на 39%.
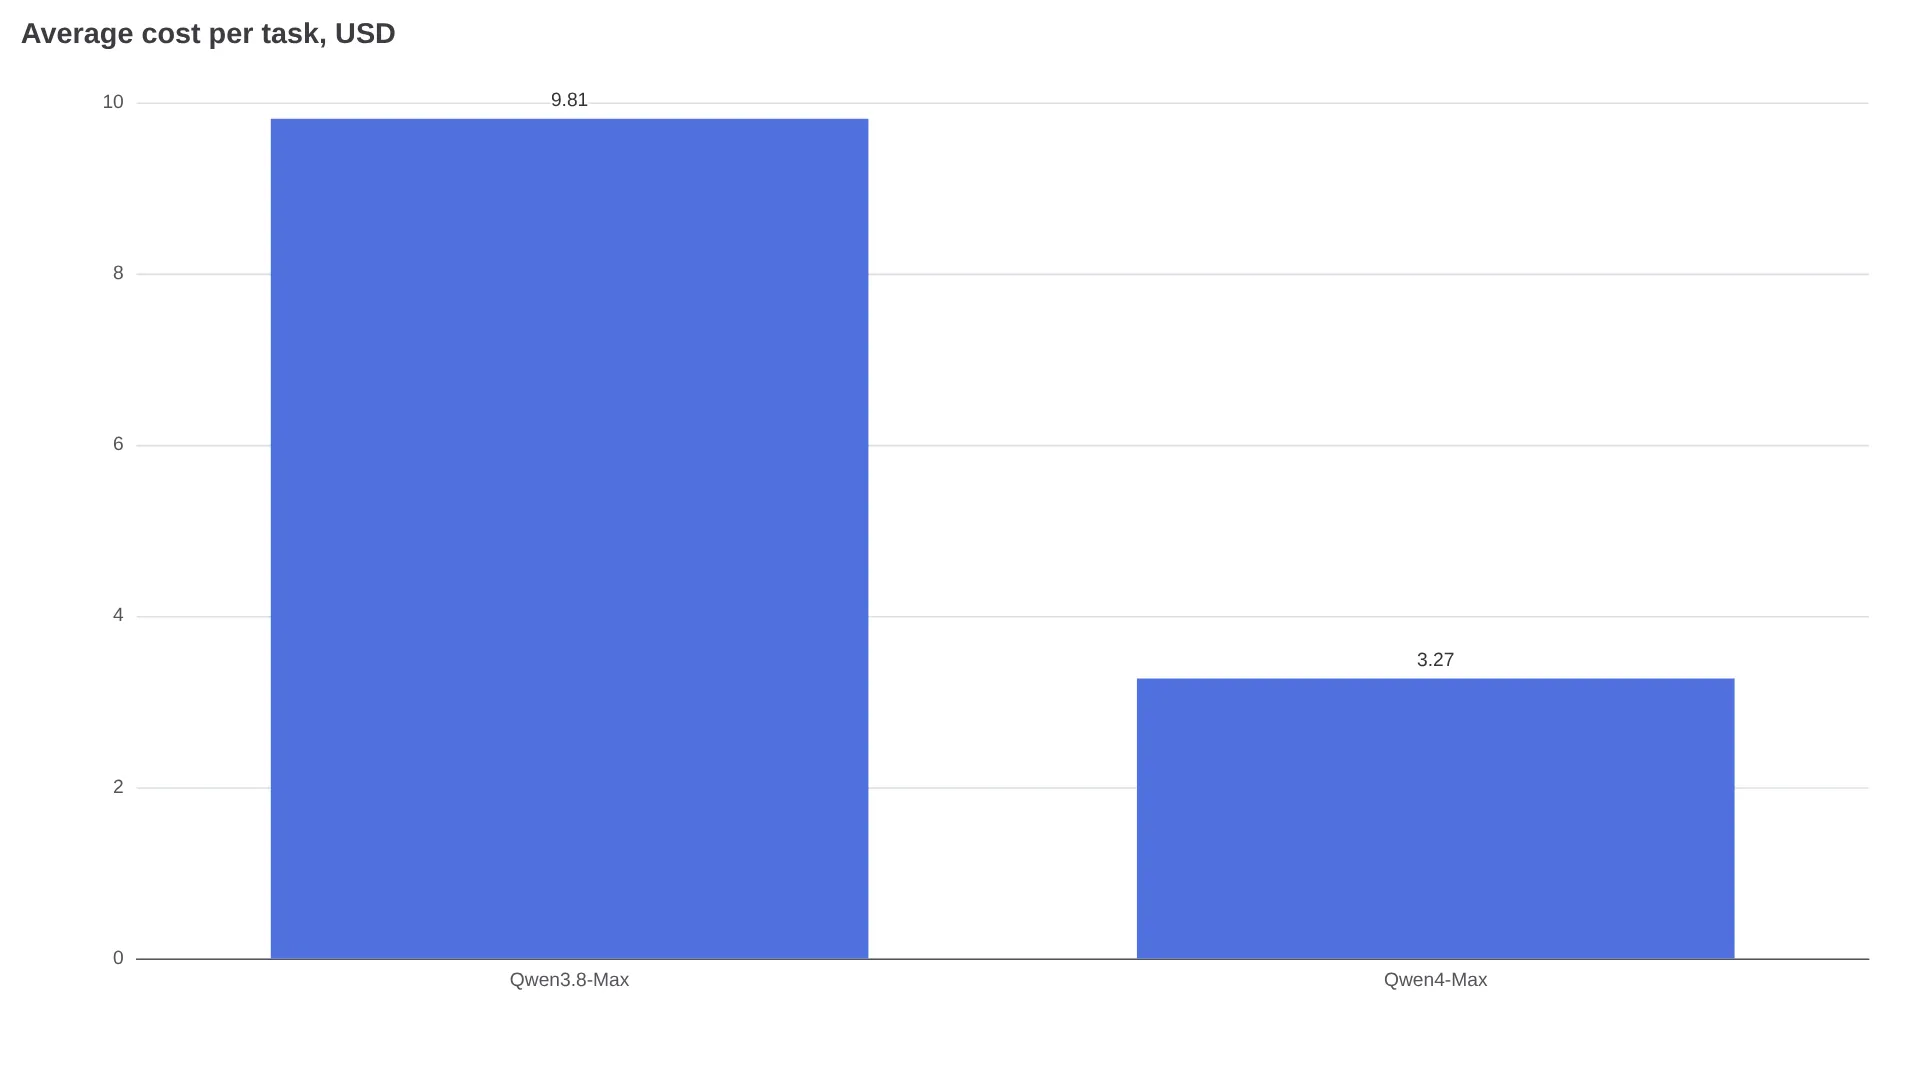
Экономия складывается из двух факторов: более низкой цены токенов из таблицы выше и меньшего количества токенов на задачу — во внутреннем тестировании Qwen их было до примерно 50% меньше. Особенно заметен эффект при работе с контекстом на 1M токенов и повторным использованием кэша: неявное чтение кэша стоит $0.075 за 1M токенов, что, по заявлению компании, на 70% дешевле кэша Qwen3.8-Max.
В основе Qwen4-Max лежит MoE-архитектура с нативной поддержкой зрения: 2.4T параметров всего, 71B активных параметров и 328B параметров N-gram embedding. Хотя в блоге Qwen приведены оценки Artificial Analysis, AI First Look и AICoder отмечают, что на 16 ноября полные таблицы бенчмарков и публичные позиции в рейтинге AA ещё не были опубликованы.
О предшественнице: цены Qwen3.8-Max API и сравнение Qwen3.8-Max и Kimi K3.
Характеристики и лимиты, которые влияют на итоговый счёт
Громкий заголовок про контекст на 1M токенов — не единственное, на что стоит смотреть. В реальной работе важнее три ограничения.
Контекст не равен доступному входу. Размер окна составляет 1M токенов, но QwenCloud указывает максимальный входной объём в 991K токенов. Оставляйте запас и отдельно проверяйте поиск информации в середине контекста, особенно в задачах с интенсивным использованием retrieval.
Вывод и thinking делят общий бюджет. Без thinking максимальный вывод составляет 131,072 токена. При включённом thinking на рассуждения и ответ вместе выделяется 262,144 токена, поэтому сложное рассуждение может оставить меньше места для финального ответа. В preview на thinking и ответ приходилось 393,216 токенов, согласно обзору характеристик preview от XenoSpectrum. Поэтому не переносите лимиты preview в продакшен без повторной проверки.
Настройки thinking тоже изменились. Thinking включён по умолчанию. В GA-версии используется уровень high; также доступны low и xhigh. В preview по умолчанию применялся xhigh — это указано в таблице характеристик AI First Look. Если ответы приходят слишком медленно, сначала попробуйте снизить reasoning_effort до low.
Мультимодальный ввод поддерживает текст, изображения и видео. В preview для видео действовали ограничения: до 2 часов, 2 GB и 64 видео на запрос, согласно обзору XenoSpectrum. Это лимиты отправки, а не гарантия качества понимания. Длинные ролики лучше проверить на собственных файлах.
Для контроля расходов используйте структурированный JSON-вывод, чтобы ограничить лишний текст, и повторно применяйте длинный контекст через чтение кэша ($0.075 за 1M токенов в Singapore). В заметках AICoder о запуске также указано явное создание кэша на пять минут по цене $1.875 за 1M токенов там, где эта функция поддерживается.
Как вызвать qwen4-max через OpenAI SDK
Model Studio поддерживает форматы OpenAI Chat Completions, Responses и Anthropic Messages API, согласно документации моделей Alibaba Cloud. Для pay-as-you-go используйте qwen4-max; модель qwen4-max-preview доступна только по Token Plan.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("QWEN_API_KEY"),
    # Singapore/international endpoint:
    base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1",
    # China/Beijing endpoint: https://dashscope.aliyuncs.com/compatible-mode/v1
)

resp = client.chat.completions.create(
    model="qwen4-max",
    messages=[
        {"role": "user", "content": "Summarize this release in 3 bullets."}
    ],
    extra_body={"reasoning_effort": "high"},
)
print(resp.choices[0].message.content)
Ключ и endpoint должны относиться к одному и тому же региону Model Studio. Для структурированного ответа можно запросить response_format={"type": "json_object"} или JSON Schema, если функция доступна в вашем регионе. Большие JSON-ответы обязательно валидируйте.
Pay-as-you-go, Token Plan или чат-приложения: что выбрать
| Вариант | Для чего подходит | Главное ограничение |
|---|---|---|
Model Studio pay-as-you-go (qwen4-max) | Приложения, бэкенды и пакетная обработка | Оплата за токены; проверьте региональные endpoint и ключ |
Token Plan (qwen4-max-preview) | Интерактивная разработка в Claude Code, Cline, Cursor и OpenCode | Только интерактивное использование; нельзя применять в продакшен-автоматизации, пакетных скриптах или встраивать в бэкенд; только регион Singapore; завершение 25 ноября 2026 года в 24:00 UTC+8 |
| Qwen Chat, QwenWork, QwenStudio, Qoder | Проверка промптов, работа с документами и агентная разработка в IDE без настройки ключей | Доступность и условия списания кредитов отображаются в приложении; это не API-контракт |
Token Plan — это месячный пул кредитов для интерактивной разработки. В обзоре Token Plan от Apidog указаны индивидуальные уровни: от Lite за $3 event / $8 list с 20,000 кредитов до Pro за $43 event / $51 list с 200,000 кредитов. Ключи начинаются с sb-sp-. Передача ключей другим пользователям, фоновые задания и встраивание ключа в опубликованный бэкенд нарушают условия использования. Для быстрых проверок промптов Apidog и XenoSpectrum также перечисляют Qwen Chat, QwenWork, QwenStudio и Qoder как варианты тестирования. Доступность отображается в приложении и зависит от аккаунта.
Перейти на новую схему нужно до 25 ноября 2026 года:
- Замените имя модели
qwen4-max-previewнаqwen4-max. - Перейдите с базового URL и ключа Token Plan на pay-as-you-go ключ Model Studio и региональный endpoint.
- Повторно проверьте настройки thinking:
xhighнужно заменить наhighпо умолчанию. - Заново измерьте доступный объём вывода: общий лимит preview составлял 393K, а в GA действуют лимиты 131K/262K.
Что показывают первые тесты: быстрый старт с нуля, но неравномерная работа агентов
Небольшая выборка тестов, собранная AI First Look, показывает успешную сборку проектов по одному промпту. В одном из примеров модель прошла 20 из 20 скрытых тестов примерно за 2.5 минуты против 17 минут у Qwen3.8-Max. Однако в том же обзоре игровой тест Qwen4-Max завершила быстрее, но по общей оценке она всё равно заняла второе место.
При генерации кода постоянно получаю такие ошибки.
— @bijanbowen, публикация (первое впечатление реального пользователя, 16 ноября 2026 года; скриншот повторяющихся ошибок при генерации кода)
В ранней подборке отзывов китайскоязычных тестировщиков (@weconomypistis) цену и стоимость задачи назвали главным преимуществом Qwen4-Max. При этом в терминальных сценариях и работе с агентами модель, по отзывам, уступала Kimi: ответы были медленнее.
FAQ
Qwen4-Max распространяется с открытыми весами?
Нет. По состоянию на 16 ноября Qwen4-Max доступна только как хостed-модель, а её веса не опубликованы — это отмечено в трекере AI First Look. Qwen заявляет, что позже выпустит меньшие модели семейства Qwen4 с открытыми весами, согласно анонсу Qwen4-Max. Даты, размеры моделей и лицензия пока не объявлены.